Тема
Модуль 03 · Керування роєм: строї та топології
Оглядова лекція: як група апаратів утримує задану геометрію, що для цього вимірює окремий агент і де класичні закони впираються в межу, за якою починається навчання.
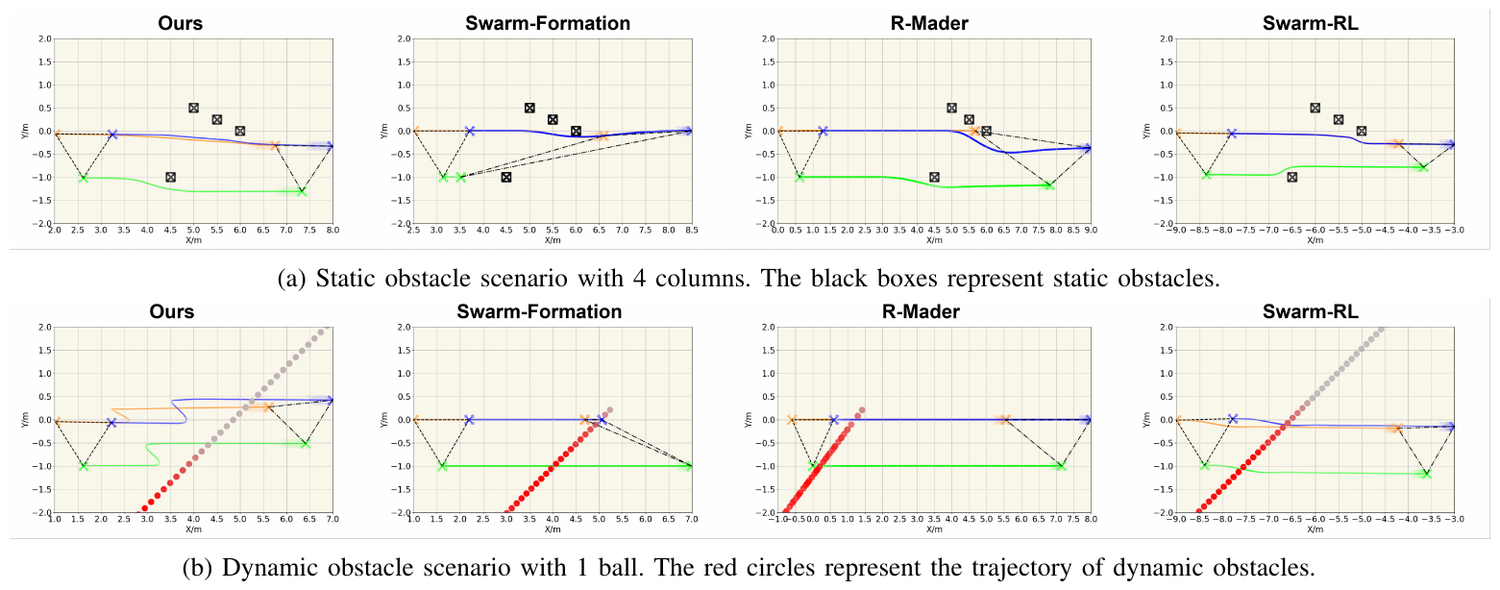
Керування строєм з обходом перешкод: порівняння чотирьох алгоритмів
Зміст лекції
Лекція йде від простих локальних правил до точної мови строїв і до меж, за якими класичні закони перестають працювати.
| Частина | Про що |
|---|---|
| 1. Локальні правила руху | Boids, потенціальні поля |
| 2. Стрій і топологія | що агент вимірює, як затримка ламає узгодження |
| 3. Метрики й межі класики | форма строю, безпечна дистанція, чого класика не вміє |
Частина 1 дає інтуїцію, частина 2 — точну мову, частина 3 показує, де інтуїція обманює і навіщо взагалі навчати політику.
Результати навчання
Після лекції ви зможете:
- назвати три правила Boids і пояснити, за що відповідає кожне;
- пояснити принцип потенціальних полів і назвати їхню головну ваду;
- класифікувати задачу строю за вимірюваною величиною і сказати, що при цьому лишається невизначеним;
- пояснити результат досліду із затримкою: чому швидкість збирання й терпимість до затримки задають різні величини;
- обрати метрику похибки строю під мету задачі й пояснити, коли наївна метрика вводить в оману;
- назвати межі класичних законів, які мотивують перехід до навчання.
Частина 1 · Локальні правила руху
Найпростіші закони групового руху не потребують ані спільних координат, ані центру. Агент дивиться лише на сусідів у радіусі й додає кілька векторів.
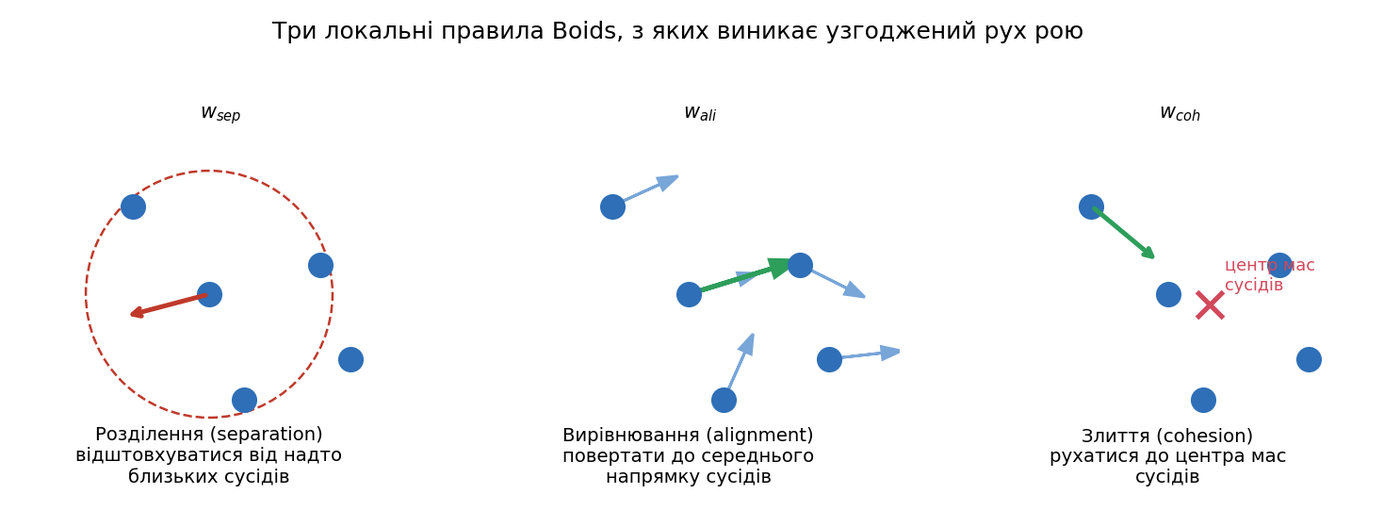
Три правила Boids: розділення, вирівнювання, згуртування
Boids: три правила, з яких виникає рій
Модель Рейнольдса 1987 року показала: узгоджений рух зграї не потребує ані лідера, ані плану. Досить, щоб кожен агент додавав три вектори, дивлячись лише на сусідів у своєму радіусі.
| Правило | Що робить агент | Радіус дії |
|---|---|---|
| Розділення | відштовхується від надто близьких сусідів | найменший |
| Вирівнювання | підлаштовує свою швидкість під середню швидкість сусідів | середній |
| Злиття | рухається до центру мас сусідів | найбільший |
У спрощеному вигляді бажану поправку до руху складають із трьох внесків. Три вектори не задають швидкість наново — вони її підправляють на кожному кроці:
Ваги
У типових реалізаціях розділення діє на менших відстанях, ніж злиття; у віджеті нижче саме так. Переплутавши ці радіуси, рій зазвичай або злипається в купку, або розсипається.
Узгоджений рух тут не програмується, а виникає: жодне з трьох правил не містить поняття «стрій», але група починає рухатися як ціле. Це і є емерджентність, з якої почався Модуль 01. Міряють її параметром порядку — модулем середньої одиничної швидкості: одиниця означає, що всі летять паралельно, нуль — що напрямки взаємно компенсуються (і хаос, і дві рівні зустрічні групи дають нуль). Саме це число показує віджет унизу картки.
Джерело моделі: Reynolds C. W., Flocks, Herds and Schools: A Distributed Behavioral Model, SIGGRAPH 1987.
Рій за правилами Рейнольдса
Три ваги — і вся поведінка. Лінія означає, що апарати бачать одне одного, тобто в цей момент вони сусіди у графі рою.
Виставте розділення в нуль — апарати злипнуться в точку, і параметр порядку підскочить до одиниці, хоча рій фізично зруйнований. Це показує, навіщо поряд із порядком завжди міряють мінімальну дистанцію між апаратами.
Потенціальні поля: рух до цілі з обходом перешкод
Другий класичний закон трактує простір як силове поле: ціль притягує, перешкоди відштовхують, агент рухається за сумарним вектором.
Другий доданок відштовхує. Тут
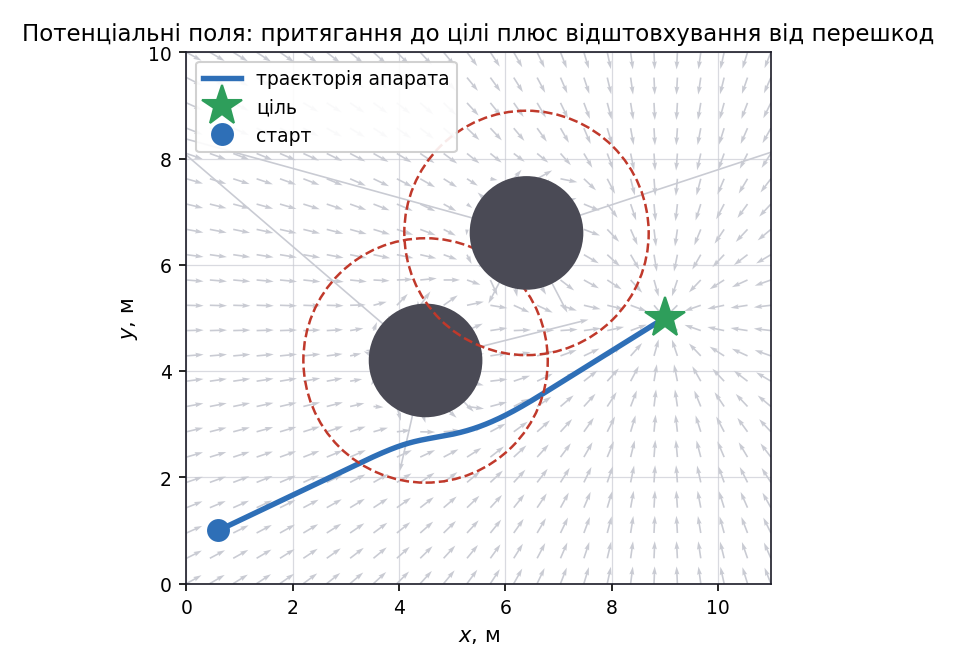
Карта векторів потенціального поля і траєкторія навколо двох перешкод
Метод майже безкоштовний обчислювально, працює з будь-якою кількістю перешкод і не потребує планувальника — тому його досі використовують як нижній рівень обходу.
Головна вада: локальні мінімуми. Якщо притягання й відштовхування зрівноважуються, агент зупиняється, не дійшовши до цілі. Класичний випадок — перешкода строго між агентом і ціллю. Гарантії досягнення цілі метод не дає взагалі.
Це повернеться в Модулі 10: потенціальні поля беруть за базову лінію, з якою порівнюють навчену політику обходу перешкод.
Частина 2 · Стрій і топологія
Від інтуїтивних правил переходимо до точної мови: що саме агент вимірює, які вимоги це накладає на зв'язок і чому щільніша мережа не завжди краща.
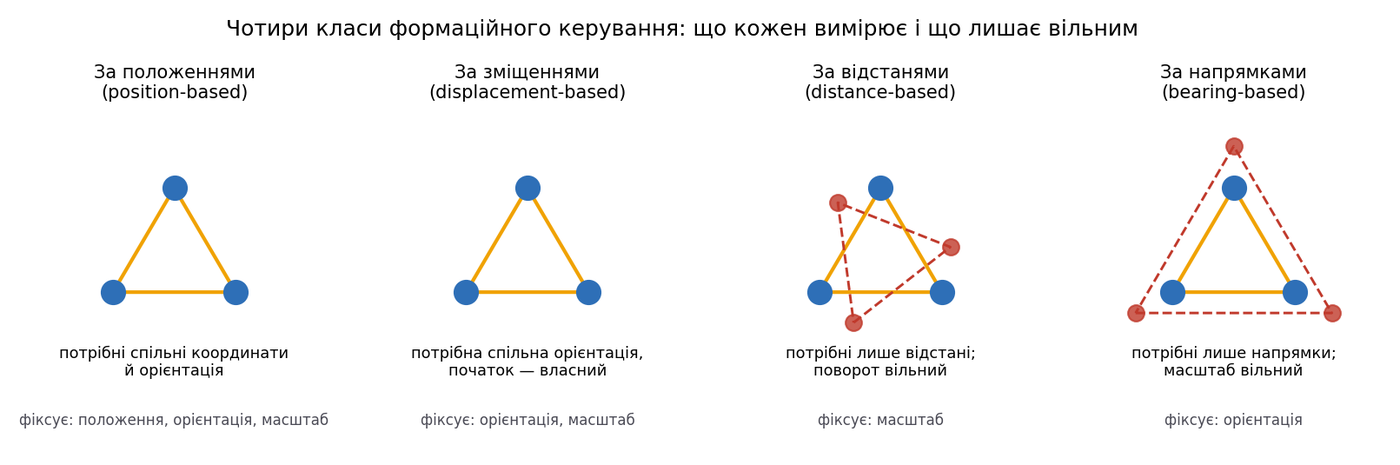
Чотири класи формаційного керування і що кожен лишає вільним
Чотири класи формаційного керування
Строгу класифікацію будують за однією ознакою — що саме агент вимірює. Чим менше він вимірює, тим слабші вимоги до інфраструктури, але тим слабші й гарантії.
| Клас | Агент вимірює | Потрібно | Стрій визначений з точністю до |
|---|---|---|---|
| position | власну позицію | спільна система координат (GPS/RTK, зовнішній трекінг) | нічого |
| displacement | відносні положення | вирівняна орієнтація, зв'язний граф | перенесення |
| distance | відстані | лише дальність (UWB), жорсткий каркас | перенесення й обертання |
| bearing | напрямки на сусіда | камера чи пеленгатор, спільний орієнтир | перенесення й масштабу |
Displacement — робоча точка для рою в приміщенні: не потрібен GPS, достатньо спільного курсового репера. Distance і bearing дешевші за сенсорикою. Bearing за достатнього набору напрямків задає стрій із точністю до перенесення й масштабу. У distance складніше: правильні відстані ще не означають єдино можливої збірки — форма може зафіксуватися дзеркальною.
Сам закон для displacement — це протокол консенсусу з Модуля 02, до якого додали бажані зсуви:
Тут
Агент тягнеться не до позиції сусіда, а до позиції сусіда мінус потрібна різниця. Якщо всі бажані зсуви нульові, рій просто збирається в точку — це вихідний консенсус.
У лабораторній 4 ви побачите обидва типи величин: у векторі спостереження є і відносні положення сусідів, і власний вектор до цілі. Перше робить поведінку однаковою в будь-якій точці кімнати, друге прив'язує рій до місцевості.
Leader–follower: чим платять за просту реалізацію
Найпоширеніша архітектура строю: є лідер, кожен ведений утримує заданий зсув відносно нього. Писати тут майже нічого — звідси й популярність.
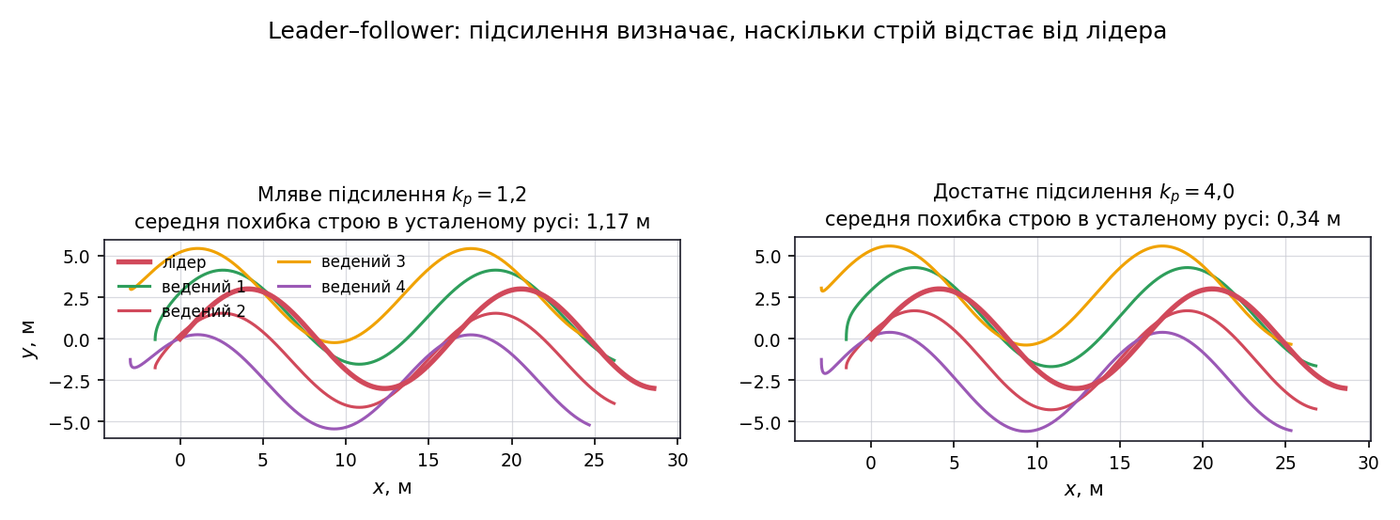
Траєкторії лідера й відомого для двох наборів коефіцієнтів
У показаному досліді спрощені апарати доганяють свої місця за лідером, і змінюється один коефіцієнт. Мляве підсилення дає середнє відхилення від свого місця 1,17 м (усереднено за останні секунди руху), достатнє — 0,34 м, утричі менше. Занадто різке налаштування в цій моделі не перевіряли; на реальному апараті воно впирається в запас тяги й підсилює шум вимірювань.
Слабке місце архітектури видно одразу: усе тримається на одному апараті. Без механізму заміни лідера група втрачає джерело завдання руху. Друге слабке місце не таке очевидне, і воно на наступній картці.
Колона: чому хвіст хитає сильніше за голову
Вибудуємо апарати в колону, де кожен дивиться лише на попереднього. Лідер робить маневр — і подивімося, що дістанеться шостому.
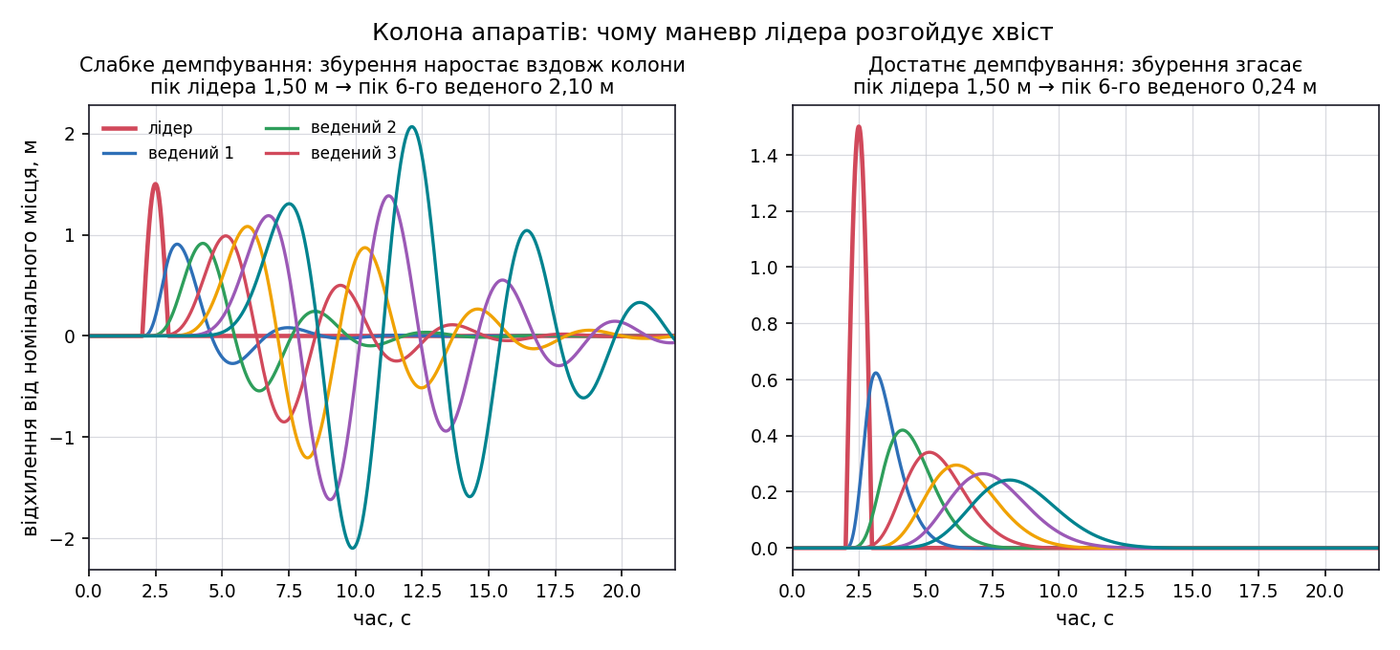
Підсилення збурення вздовж колони із семи апаратів
На обох панелях колона однакова: кожен бачить лише попереднього. Різні тільки налаштування регулятора. Зліва збурення наростає вздовж колони: лідер відхилився на 1,50 м, шостий ведений — уже на 2,10 м, бо кожен повторює помилку попереднього й додає власну. Справа те саме збурення згасає: до шостого доходить 0,24 м.
Що звідси випливає, а що ні. Дослід показує, що передавання по ланцюжку може підсилювати збурення й що налаштування це змінює. Він не показує, що довга колона погана за будь-яких коефіцієнтів: права панель — та сама колона, і в ній усе гаразд.
Практичний висновок обережніший: перевіряти треба реакцію всієї групи, а не одного апарата. Добра поведінка одного апарата ще не гарантує доброї поведінки всієї колони. Окремо існує відома конструктивна міра — транслювати стан лідера всім одразу замість передавання ланцюжком; цей дослід її не перевіряв.
Щільніший граф гірше терпить затримки
Досі ми припускали, що агент бачить свіжий стан сусіда. У реальному каналі він бачить стан, застарілий на затримку
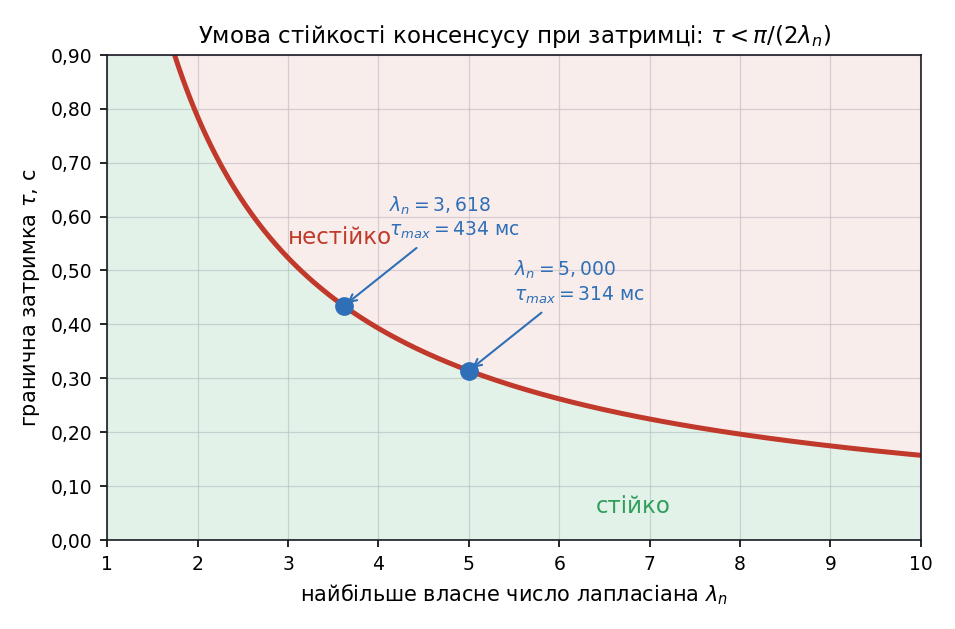
Межа стійкості консенсусу за наявності затримки в каналі
Швидкість збирання задає
Це різні числа, і саме тому «більше зв'язків» не означає «краще». Формулу беремо як готовий результат — звідки береться
Межа виведена для конкретної моделі: затримується весь сигнал узгодження, ваги одиничні, динаміка агента найпростіша. Якщо агент бачить свіжим власний стан і застарілим лише стан сусідів — це вже інша модель з іншою межею.
| Топологія | Гранична затримка | Радіоканал 0,35 с | ||
|---|---|---|---|---|
| Ланцюг | 0,382 | 3,618 | 0,434 | працює |
| Кільце | 1,382 | 3,618 | 0,434 | працює |
| Зірка | 1,000 | 5,000 | 0,314 | нестійкий |
| Повний | 5,000 | 5,000 | 0,314 | нестійкий |
За затримки 0,35 с повний граф і зірка вже нестійкі, а «гірші» ланцюг і кільце ще працюють.
Прочитайте таблицю уважно — вона складніша за гасло «щільніше гірше». Ланцюг і кільце мають однакову межу затримки, хоча в кільця на ребро більше: додаткове ребро тут прискорило збирання задарма. А зірка з чотирма ребрами програє кільцю з п'ятьма. Отже, межу задає не кількість ребер, а
Застерога: числа справедливі для цього досліду — однакова стала затримка в усіх каналах, одиничні ваги, проста динаміка агента. За інших припущень межі зміняться; лишається якісний висновок, що швидкість і терпимість до затримки задають різні величини.
Затримка в каналі: щільніший граф ламається першим
Той самий протокол консенсусу, але сусіди повідомляють свій стан із запізненням τ. Оберіть топологію й ведіть повзунок.
5ребер у графі
3.62найбільше власне число λmax
0.434 сгранична затримка π / (2λmax)
стійкийстан за поточної τ
Повзунок стоїть на 0,35 с — це значення з таблиці лекції. Реальна затримка залежить від обладнання й протоколу, тут вона параметр досліду. Переключайте топології: ланцюг і кільце ще працюють, а зірка й повний граф уже розходяться. Причому зірка має рівно стільки ж ребер, скільки ланцюг, — справа не в їх кількості, а в тому, що вони роблять із λmax. Швидкість збіжності задає λ₂, а стійкість до запізнення — λmax, і додавання ребер піднімає обидва. Повний граф виграє у швидкості 13,1 раза, але допустима затримка падає на 28 %. Це прямо суперечить інтуїції «більше зв'язків — краще».
Частина 3 · Метрики й межі класики
Залишилося двоє питань: як чесно виміряти, що стрій тримається, і чому цього всього не досить.
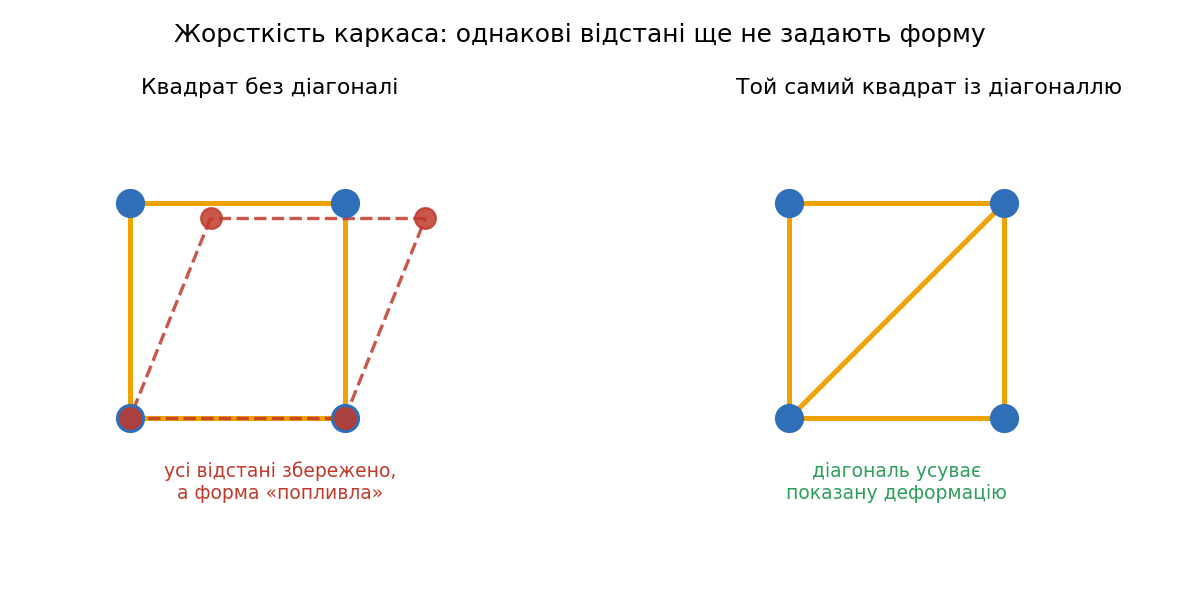
Жорсткий і нежорсткий каркаси строю
Жорсткість каркаса: коли строю бракує в'язей
Distance-підхід знімає вимогу спільного компаса, але створює власну проблему: набір правильних відстаней може не задавати форму однозначно. Каркас жорсткий, якщо єдині рухи, що зберігають усі задані відстані, — це рухи строю як цілого. Квадрат із чотирьох стрижнів без діагоналі складається в ромб, хоча всі чотири довжини правильні; діагональ робить його жорстким.
Практичний наслідок: зв'язність може зберегтися там, де жорсткість уже втрачена. Рій лишається повністю зв'язаним, усі повідомлення доходять, кожна утримувана відстань витримана точно — а форма все одно пливе, бо деформація йде саме тим напрямком, у якому всі задані відстані зберігаються. Бортовий контролер при цьому бачить нульову похибку.
Виявити це можна двома способами: рахувати жорсткість каркаса для поточного набору живих каналів або міряти форму строю цілком, а не окремі відстані, — цим і займається наступна картка. Практичне правило: після втрати каналу перевіряти не лише «граф цілий?», а й «в'язей ще досить?».
Код: похибка строю з факторизацією
Найочевидніша метрика похибки строю — середньоквадратичне відхилення від бажаних позицій:
Саме її рахує функція rmse_naive нижче. Вона не помилкова: вона чесно міряє відхилення від заданих позицій. Проблема в іншому — для оцінювання самої форми вона не годиться, якщо задача дозволяє строю зсунутися чи повернутися. Тоді метрика має спершу прибрати те перетворення, яке закон керування і не мав фіксувати: для displacement це перенесення, для distance — ще й обертання. Дві інші функції саме це й роблять.
Алгоритм суміщення (rmse_rigid) беріть як готову функцію — розбирати SVD не потрібно. Ідея в трьох словах: виміряти → сумістити → виміряти знову.
python
import numpy as np

def rmse_naive(P, Pstar):
    return np.sqrt(np.mean(np.sum((P - Pstar)**2, axis=1)))

def rmse_translation(P, Pstar):
    """Факторизація за перенесенням: центруємо обидві конфігурації."""
    return rmse_naive(P - P.mean(0), Pstar - Pstar.mean(0))

def rmse_rigid(P, Pstar):
    """Факторизація за перенесенням і обертанням — алгоритм Кабша."""
    A = P - P.mean(0); B = Pstar - Pstar.mean(0)
    U, _, Vt = np.linalg.svd(A.T @ B)
    d = np.sign(np.linalg.det(U @ Vt))        # заборонити відображення
    R = U @ np.diag([1.0, d]) @ Vt
return rmse_naive(A, B @ R.T)Передбачте перед запуском: що покаже наївна метрика для строю ідеальної форми, який просто зсунувся на 13 м убік.
Результат коду: наївна метрика міряє не те
Шість апаратів у трикутній ґратці зі стороною 20 м, похибка форми — гаусів шум
text
ситуація                                 наївний   +перенос   +поворот
ідеальна форма, зсув (12, 5) м            13.000      0.000      0.000
той самий зсув плюс похибка форми         12.943      0.320      0.319
без зсуву, лише похибка форми              0.353      0.320      0.319
зсув + поворот 25° + похибка форми 15.169 7.918 0.319Другий рядок — головний. Наївна метрика показує 12,94 м, факторизована — 0,32 м: у цьому прикладі похибку форми завищено в 40 разів (це число цього досліду, а не універсальний коефіцієнт). Порівняйте перший рядок із другим: наївне число майже не змінилося, хоча у другому додано реальну похибку форми. Воно міряє переважно зсув центра мас і на форму майже не реагує.
Останній рядок показує, що для distance-строю замало факторизації лише за перенесенням: 7,92 м проти правильних 0,32 м.
Головна засторога: факторизувати можна лише те, що справді неістотне для цієї задачі. Якщо рій має втримувати задану точку над місцевістю, зсув — це і є провал місії, і метрика, яка його прибирає, покаже успіх там, де його немає.
Мінімальна дистанція як метрика безпеки
Похибка форми нічого не каже про зіткнення. Друга обов'язкова метрика — мінімальна відстань між будь-якою парою апаратів за весь епізод, а не середня і не наприкінці.
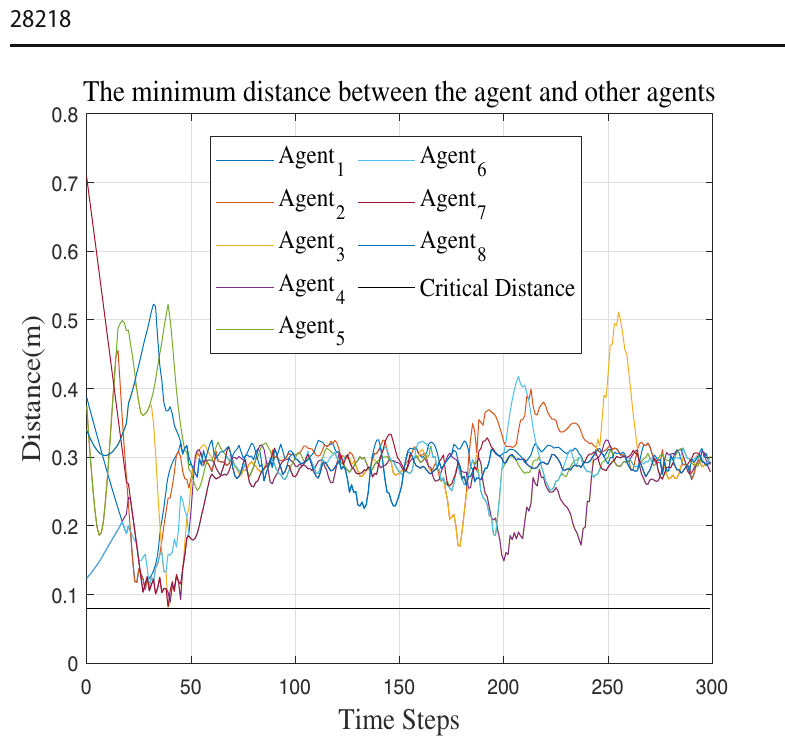
Мінімальна відстань між вісьмома апаратами в часі
Два мінімуми тут не випадкові. На графіку показано внутрішній: у кожен момент беремо найближчу пару апаратів. Підсумкове число — мінімум цієї кривої за весь епізод. Дрібниця для лабораторної: рахують по збережених кроках симуляції, тому дуже коротке зближення між кроками можна й не побачити. Поріг задають наперед як мінімально допустиму відстань між центрами апаратів — він більший за їхні габарити, бо має вміщувати ще й похибку оцінювання позиції та збурення від сусіднього гвинта. Крива має лежати вище цього порога весь час. Провал нижче не обов'язково означає зіткнення, але означає, що запас витрачено і далі покладатися доводиться на випадок. Хороший стрій не гарантує безпечних дистанцій: це дві незалежні вимоги, і міряти їх треба окремо. Джерело: Reinforcement learning for multi-agent formation navigation with scalability.
Типові непорозуміння
| Звучить так | Насправді |
|---|---|
| «Boids — це алгоритм утримання строю» | У трьох правилах немає жодної згадки про форму. Вони можуть дати узгоджений рух, але заданої геометрії не тримають |
| «Потенціальні поля доведуть до цілі» | Можуть зупинитися там, де притягання й відштовхування компенсують одне одного. Гарантії досягнення цілі метод не дає |
| «Щільніша мережа гірша, ми ж це довели» | Ні, довели інше: швидкість і терпимість до затримки задають різні власні числа. Кільце має на ребро більше за ланцюг і терпить таку саму затримку |
| «Похибка строю мала — отже все добре» | Спершу перевірте, що саме міряє метрика. І окремо перевірте дві інші речі: чи не порушено безпечні дистанції й чи виконано мету місії |
| «У leader–follower немає ціни за простоту» | Ціна є: єдине джерело завдання руху. А накопичення збурень — можливий ризик передавання ланцюжком, і залежить він від налаштування |
Висновки: межі класичних законів
- Те, що агент вимірює, визначає, що він узагалі може втримати. Чим бідніший сенсор, тим більше лишається невизначеним — і тим жорсткіші вимоги до графа зв'язків.
- На результат впливають і структура зв'язків, і налаштування. Це видно з трьох різних місць лекції: колона, затримки, жорсткість. Питання «хто на кого дивиться» не менш важливе за питання «які коефіцієнти», і перевіряти треба обидва.
- Метрику треба вибирати під мету задачі, а безпеку міряти окремо — мінімальною дистанцією. Інакше звіт покаже успіх там, де його немає.
Чого класичні закони не дають: кожен виводиться під наперед відому постановку й гарантії має лише в її межах. Потенціальні поля можуть зупинитися, не дійшовши до цілі; distance-закон має лише локальні гарантії. Щойно задача виходить за межі припущень, закон доводиться переглядати — і саме там, де вивести його важко, політику навчають.
Зворотне теж правда, і про це варто сказати прямо: навчання не знімає фізичних меж. Затримка каналу, дальність зв'язку й запас тяги лишаються тими самими. І не всі класичні закони обмежені: Boids працює з будь-якою кількістю апаратів без жодного перенавчання.
Перехід до Модуля 04
Класичні закони цього модуля виводяться вручну під наперед відому постановку: геометрію задачі, кількість апаратів, характер перешкод. У межах цих припущень вони працюють і дають гарантії; поза ними — потребують перегляду.
Модуль 04 · Навчання з підкріпленням: основи переходить до альтернативного способу отримати керуючу політику: не вивести її, а навчити на взаємодії із середовищем. Класичні закони при цьому нікуди не зникають — вони стають базовою лінією для порівняння і джерелом функцій винагороди для формаційних задач.
Література та ресурси
- Reynolds C. W. Flocks, Herds and Schools: A Distributed Behavioral Model. SIGGRAPH, 1987, 25–34. DOI 10.1145/37401.37406
- Olfati-Saber R., Murray R. M. Consensus Problems in Networks of Agents with Switching Topology and Time-Delays. IEEE TAC, 2004, 49(9), 1520–1533. DOI 10.1109/TAC.2004.834113 — розділ III, розділ V, теореми 8 і 10.
- Seiler P., Pant A., Hedrick K. Disturbance Propagation in Vehicle Strings. IEEE TAC, 2004, 49(10), 1835–1841 — теореми 1–3 (інтегральне обмеження, необмежене зростання підсилення, симетричне керування).
- Oh K.-K., Park M.-C., Ahn H.-S. A survey of multi-agent formation control. Automatica, 2015, 53, 424–440. DOI 10.1016/j.automatica.2014.10.022
- Zhao S., Zelazo D. Bearing Rigidity Theory and its Applications. arXiv:1803.05505
- Laman G. On graphs and rigidity of plane skeletal structures. Journal of Engineering Mathematics, 1970, 4, 331–340.
- Xie Y. та ін. Multi-UAV Formation Control with Static and Dynamic Obstacle Avoidance via Reinforcement Learning. arXiv:2410.18495
- Quan Quan. Introduction to Multicopter Design and Control. Springer, 2017 — гл. 11 (каскад керування, ПІД, розподіл керування).
- Практика: PettingZoo — багатоагентні середовища · Crazyswarm2 · NetworkX