Тема
Модуль 08 · Багатоагентне навчання для роїв БПЛА
Як навчають політику, яку виконує кожен апарат рою: інваріантні кодувальники сусідів, централізоване навчання з децентралізованим виконанням, декомпозиція цінності та межі, за якими навчання поступається класиці.
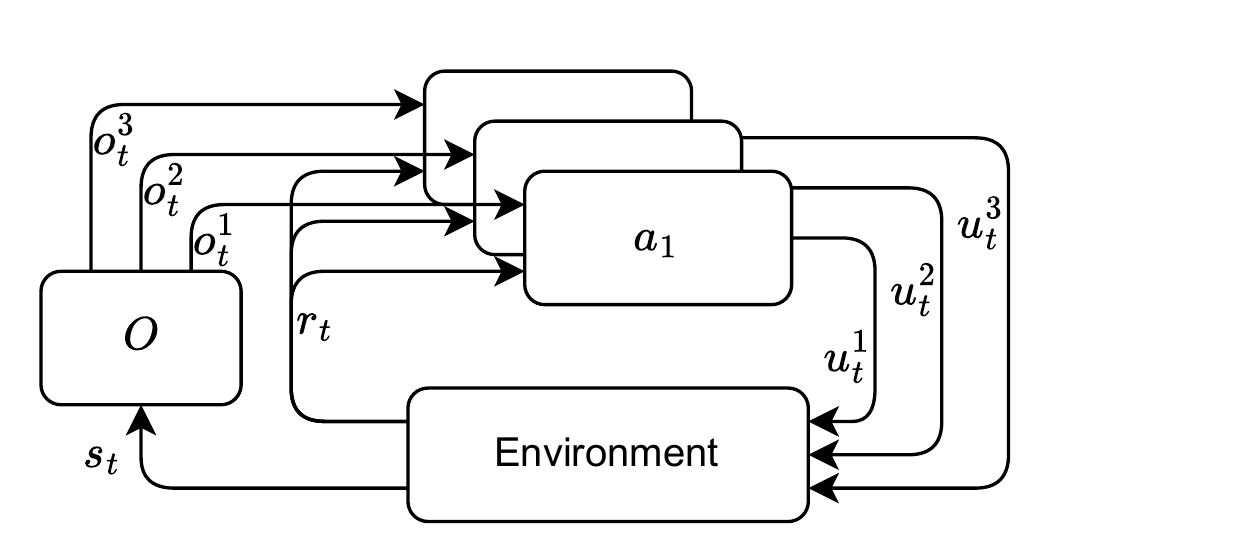
Децентралізований POMDP: три агенти у спільному середовищі
Зміст лекції
| Частина | Про що |
|---|---|
| 1. Чому рій — не | дві вимоги інваріантності, mean embeddings, увага |
| 2. CTDE на практиці | що бачить критик під час навчання і що політика в польоті |
| 3. Якірна робота | рій квадрокоптерів end-to-end: постановка, винагорода, масштабування |
| 4. Декомпозиція цінності | VDN, QMIX, parameter sharing |
| 5. Межі навчання | класичні методи, ORCA, бар'єрні функції, симулятори й залізо |
Модуль 06 працював з одним апаратом, Модуль 05 дав багатоагентні моделі. Тут вони з'єднуються, і з'являється головне питання: як зробити політику незалежною від кількості та порядку сусідів.
Результати навчання
Після лекції ви зможете:
- сформулювати дві вимоги інваріантності до політики рою й пояснити, чому склеювання спостережень їх порушує;
- побудувати усереднене вкладення сусідів і пояснити, чому ділять на
; - пояснити схему CTDE і сказати, що саме бачить критик, а що політика;
- спроєктувати змішану винагороду й показати на числах, чому чисто спільна не працює;
- записати умову IGM і відрізнити VDN від QMIX;
- назвати умову коректності parameter sharing;
- обрати метод уникнення зіткнень за наявними гарантіями, а не за модою.
Частина 1 · Рій — це не
Політика в рої має задовольняти дві властивості, яких немає в одноагентній задачі.
- Інваріантність до перестановки: перенумерація сусідів не змінює дії.
- Інваріантність до розміру рою: та сама політика працює й для 8, і для 100 апаратів.
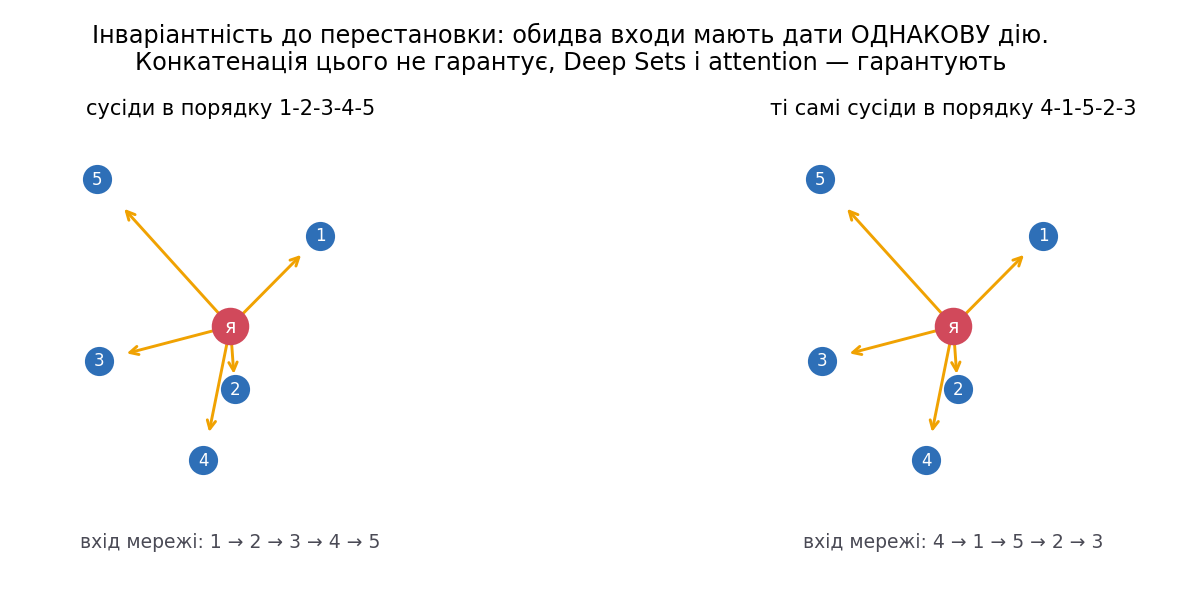
Інваріантність до перестановки: інший порядок сусідів має дати ту саму дію
Обидві задовольняються, якщо політика бачить не список сусідів, а статистику їхнього розподілу.
Усереднене вкладення сусідів
| Позначення | Значення |
|---|---|
| множина сусідів апарата | |
| відносне спостереження сусіда | |
| відображення в простір ознак, спільне для всіх сусідів | |
| вектор сталої довжини, який подають політиці |
Архітектурний прийом описаний у Zaheer та ін., Deep Sets, arXiv:1703.06114.
Ділення на
| Спосіб агрегації | Плюси | Мінуси |
|---|---|---|
| Склеювання (concatenation) | тривіально | ламається на перестановці й на зміні |
| Усереднення (Deep Sets) | інваріантне до порядку й до | усі сусіди однаково важливі |
| Увага (attention) | найближчий і найнебезпечніший отримує більшу вагу | дорожче, але вміщується навіть у STM32 |
Код: перевірка обох інваріантностей
python
import numpy as np
rng = np.random.default_rng(7)

def phi(o, W):
    """Спільний для всіх сусідів кодувальник: маленька мережа з tanh."""
    return np.tanh(o @ W)

def concat_encoder(obs, W):
    """Склеювання: вектор фіксованої довжини, порядок має значення."""
    return (obs.reshape(-1) @ W[:obs.size])

def deep_sets(obs, W):
    """Mean embedding: усереднення по сусідах."""
    return phi(obs, W).mean(axis=0)

K, D = 4, 6                      # 4 сусіди, по 6 чисел на кожного
obs = rng.normal(0, 1, (K, D))   # відносні положення й швидкості
perm = [3, 0, 2, 1] # та сама сцена, інший порядок сусідівРезультат: різниця рівно нуль
text
максимальна різниця виходу при перестановці сусідів:
  склеювання (MLP) : 2.4332
  Deep Sets        : 0.0000
  attention        : 0.0000

розмір входу політики при зміні кількості сусідів K:
  K= 4: склеювання ->  24 числа (мережу треба перебудувати); Deep Sets -> 8 чисел
  K= 6: склеювання ->  36 чисел (мережу треба перебудувати); Deep Sets -> 8 чисел
  K=12: склеювання ->  72 числа (мережу треба перебудувати); Deep Sets -> 8 чисел
K=32: склеювання -> 192 числа (мережу треба перебудувати); Deep Sets -> 8 чиселЦе не «майже нуль» і не результат навчання — це структурна властивість операції усереднення. Мережа зі склеюванням має ту саму ємність і той самий бюджет навчання, але мусить витрачати їх на вивчення симетрії, яку Deep Sets отримує безкоштовно.
Частина 2 · Централізоване навчання, децентралізоване виконання
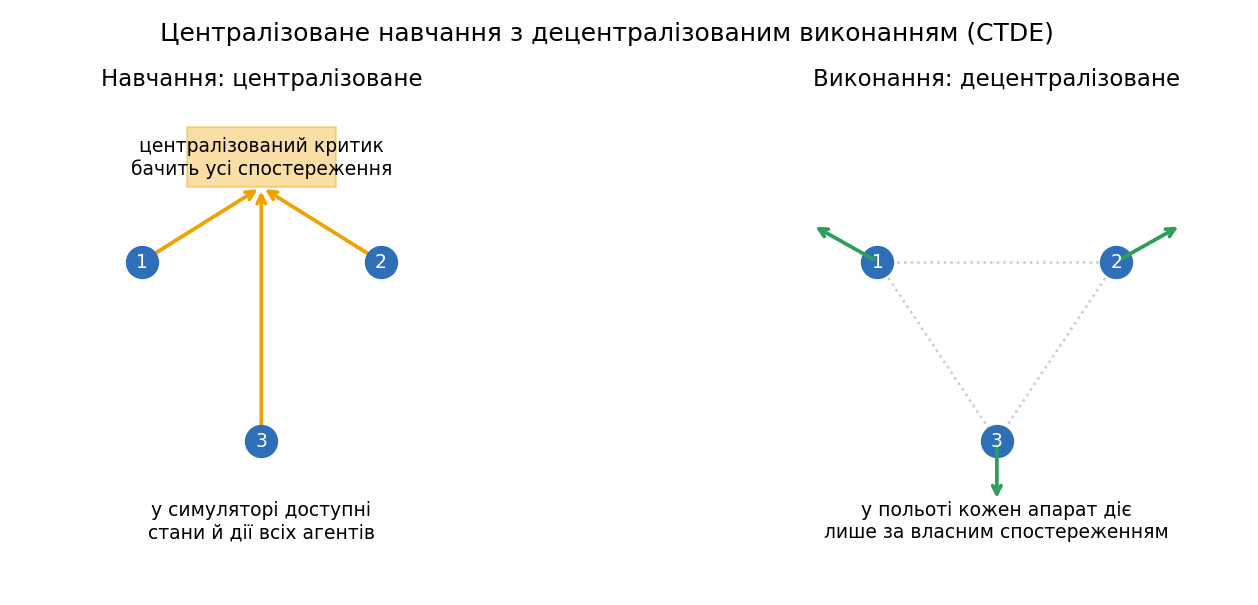
Централізоване навчання з децентралізованим виконанням
| Етап | Що доступно | Де виконується |
|---|---|---|
| Навчання | стани й дії всіх агентів, повна карта сцени | симулятор, офлайн |
| Виконання | лише власне спостереження й | борт апарата, у польоті |
Схема знімає нестаціонарність на етапі навчання, не порушуючи вимоги розподіленого виконання. Критик бачить усе, тому для нього середовище стаціонарне; політика бачить лише локальне, тому її можна запустити на борту.
Архітектура централізованого критика
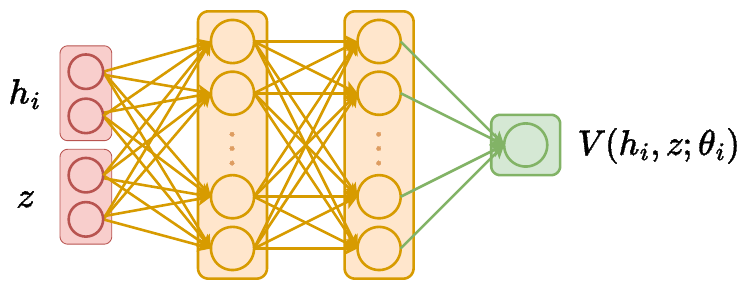
Архітектура централізованого критика для агента i
Критик приймає спостереження й дії всіх агентів і видає оцінку цінності для агента
Централізований критик цінності дій
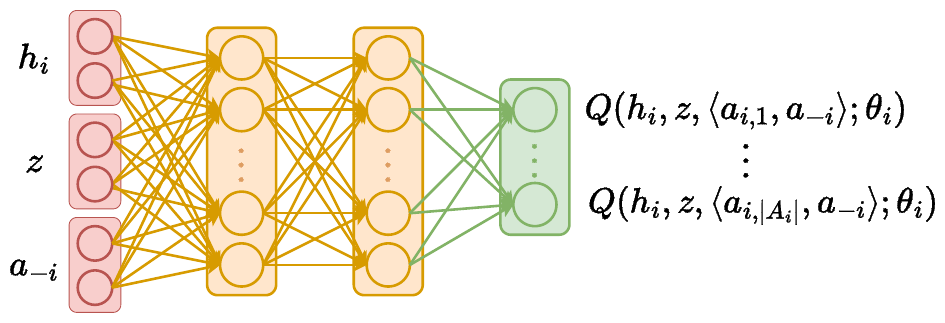
Архітектура централізованого критика цінності дій
Варіант із функцією цінності дій використовують у MADDPG: критик оцінює пару «спільний стан — спільна дія», що дозволяє коректно рахувати градієнт детермінованої політики кожного агента.
Різниця з попереднім розділом принципова: критик стану
Винагорода рою: що спільне, а що особисте
Рій обстежує майданчик, і на кроці 1200 разом відкрив 8 нових клітинок. Спільна винагорода за це: +8 кожному.
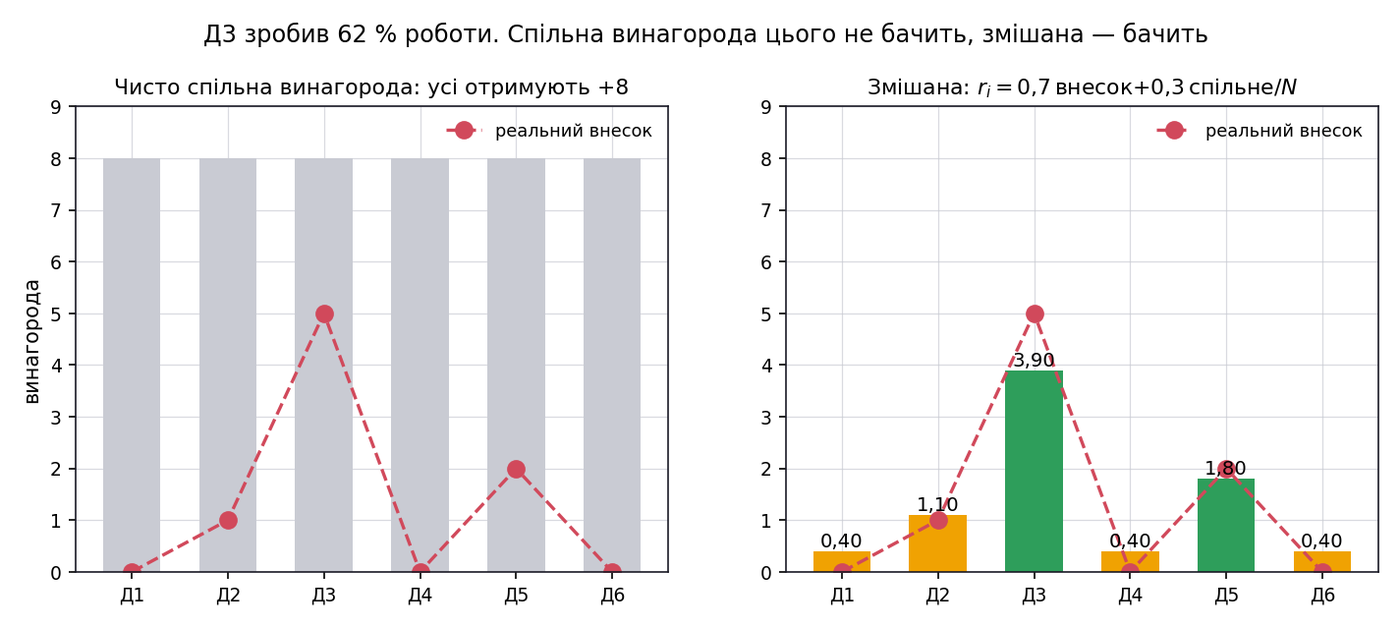
Спільна винагорода приховує внесок, змішана — показує
| Дрон | Нових клітинок | Чисто спільна | Змішана |
|---|---|---|---|
| Д3 | 5 | +8 | +3,90 |
| Д5 | 2 | +8 | +1,80 |
| Д2 | 1 | +8 | +1,10 |
| Д1, Д4, Д6 | 0 | +8 | +0,40 |
Дрон Д3 зробив 62 % усієї роботи й при чисто спільній винагороді отримав рівно стільки ж, скільки Д4, який просто висів. Через мільйон кроків усі шість вивчать поведінку найдешевшу, а не найкориснішу.
Змішана винагорода дає майже десятикратну різницю між «працював» і «висів», а спільна частка 0,3 зберігає стимул допомагати сусідові.
Частина 3 · Якірна робота: рій квадрокоптерів end-to-end
Кожен апарат летить до власної цілі, утримує стрій і уникає зіткнень із сусідами. Політика працює наскрізно: від сенсорів одразу до тяг моторів, без проміжного планувальника траєкторії.
| Складова | Що саме | Розмірність |
|---|---|---|
| Власний стан | положення відносно цілі (3), лінійна швидкість (3), кутова швидкість (3), матриця повороту (9) | 18 |
| Сусіди | відносне положення й швидкість | 6 на сусіда, разом |
| Разом на вході | 54 | |
| Дія | тяги чотирьох моторів, неперервні | 4 |
Навчання — PPO із self-play: усі апарати виконують одну політику, яка вчиться проти власних копій. Симулятор відтворює динаміку Crazyflie 2.0 з лагом моторів, шумом тяги й шумом сенсорів. Обсяг — близько 15 місяців модельованого польоту менш ніж за 19 годин.
Джерело: Batra та ін., Decentralized Control of Quadrotor Swarms with End-to-end Deep RL, CoRL 2021.
Функція винагороди: шість членів
| Член | Зміст | Вага |
|---|---|---|
| відстань до власної цілі | ||
| подія зіткнення, розріджений штраф | ||
| наближення до сусіда, щільний штраф | ||
| кутова швидкість — гасить рискання | ||
| сумарна тяга — економія енергії | ||
| утримання горизонту |
Два спостереження. Розріджений штраф за зіткнення сам по собі не вчить уникати зіткнень: сигнал приходить надто пізно й рідко, тому поряд обов'язково стоїть щільний штраф близькості. Порівнювати коефіцієнти 10,0 і 5,0 навпростець не можна: перший множиться на
Абляція кодувальників сусідів
Три архітектури навчали в однакових умовах:
| Кодувальник | Інваріантність | Досягнення цілі | Уникнення зіткнень |
|---|---|---|---|
| Конкатенація (MLP) | немає | прийнятне | не вчиться уникати зіткнень |
| Deep Sets | повна | добре | добре |
| Attention | повна, з ваговими коефіцієнтами | найкраще | найкраще |
Це саме той випадок, коли архітектурне обмеження, закладене явно, дає більше, ніж додаткові дані.
Практичне застереження: для бортового виконання attention у цій роботі виявився надто дорогим, тому в реальних польотах використано компактніший Deep Sets. Вмістити attention на борт вдалося лише наступній ітерації.
Масштабування: навчили на восьми, полетіли сто двадцять вісім
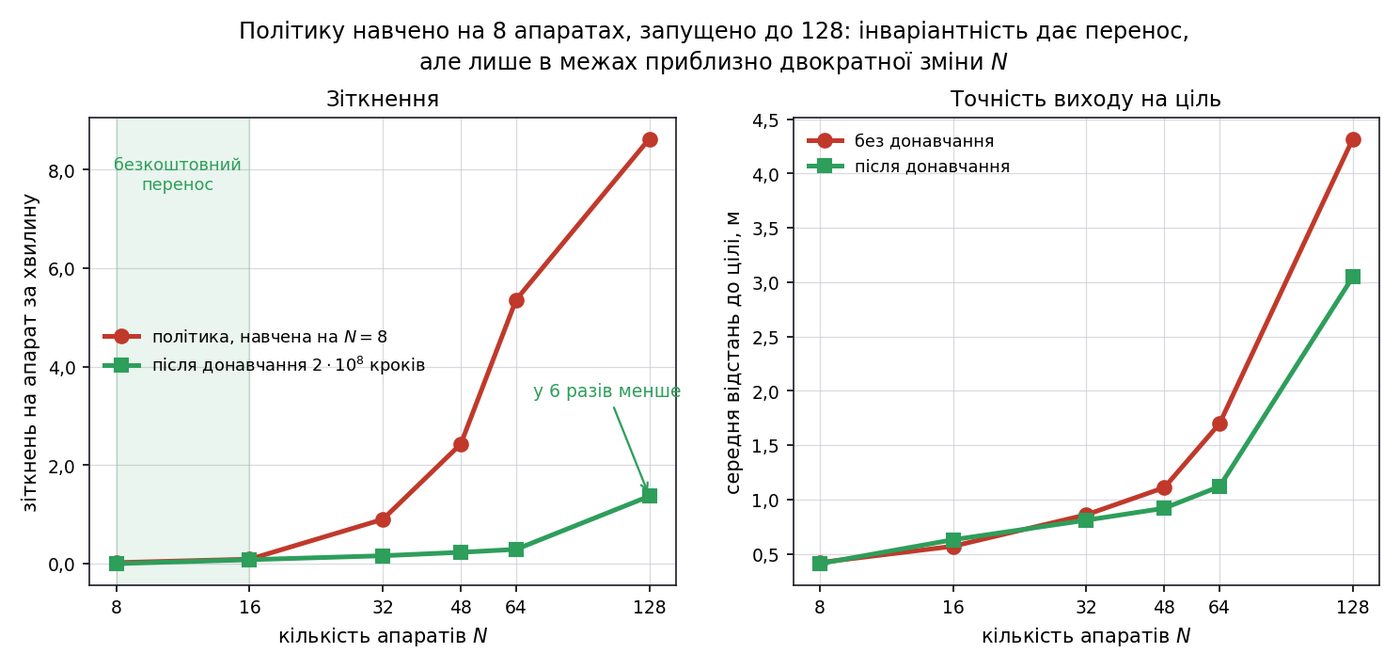
Зіткнення й точність виходу на ціль зі зростанням рою від 8 до 128
| Зіткнень / апарат / хв | Відстань до цілі, м | Після донавчання | Відстань після | |
|---|---|---|---|---|
| 8 | 0,02 | 0,42 | 0,00 | 0,41 |
| 16 | 0,09 | 0,57 | 0,08 | 0,63 |
| 32 | 0,90 | 0,86 | 0,16 | 0,81 |
| 64 | 5,36 | 1,70 | 0,29 | 1,12 |
| 128 | 8,63 | 4,32 | 1,37 | 3,05 |
До 16 апаратів політика переноситься практично без втрат. Далі якість деградує нелінійно: при 128 апаратах щільність рою така, що поле сусідів перестає бути схожим на все бачене під час навчання. Донавчання на
Практичний висновок: інваріантність дає безкоштовний перенос у межах приблизно двократної зміни
Перенесення політики на більший рій
Політику навчали на восьми апаратах. Ведіть повзунок праворуч і дивіться, де безкоштовний перенос закінчується.
0.02зіткнень на апарат за хвилину
×1гірше, ніж на восьми
0.5дотиків за місію 3 хв усім роєм
такперенос без втрат
До шістнадцяти апаратів політика переноситься майже без втрат — це приблизно двократна зміна N. Далі деградація нелінійна: на 128 апаратах зіткнень у чотириста разів більше, ніж на навчальному розмірі. Донавчання на 2·10⁸ кроків знижує їх приблизно вшестеро, але до рівня восьми не повертає. Практичне правило: безкоштовний перенос живе в межах подвоєння рою.
Політика на борту: скільки треба обчислень
Головна перевага наскрізної політики виявляється не в симуляції, а на борту. Зменшена мережа з кодувальниками Deep Sets на 16 і 8 нейронів має близько
| Показник | Нейромережева політика | Класична схема Вороного + ПІД |
|---|---|---|
| Максимальна швидкість | 4 м/с | 1 м/с |
| Максимальне прискорення | 7 м/с² | 3 м/с² |
| Форма траєкторій | тривимірні, апарати розходяться по висоті | переважно двовимірні, довші |
| Обчислення | одна мережа ≈ | побудова діаграми Вороного щокроку |
| Реальні польоти | до 8 Crazyflie 2.0, перенос без донавчання | — |
Чотирикратний виграш у швидкості пояснюється не «розумнішим» плануванням, а тим, що політика керує тягами безпосередньо й може використати весь запас динаміки апарата, тоді як каскад «планувальник — ПІД» змушений залишати запас на кожному рівні.
Та сама кімната, але заставлена перешкодами
| Показник | Значення |
|---|---|
| Ширина щілини, крізь яку проходить апарат | 0,15 м при радіусі апарата 0,05 м |
| Максимальна конфігурація в симуляції | 32 апарати при щільності перешкод 80 % |
| Реальні польоти | 8 Crazyflie 2.1 при щільності 20 %, перенос без донавчання |
| Порівняння | перевершує навчувані базові методи, зіставно з класичним планувальником при істотно меншому часі обчислень |
Це число варто читати правильно: апарат має діаметр 0,10 м, тож щілина 0,15 м дає запас лише в півтора раза, а не втричі. Політика справді керує апаратом у режимі, де похибка в кілька сантиметрів фатальна.
Що переноситься з цієї пари робіт як метод: інваріантні кодувальники для всього, чого може бути змінна кількість; щільний штраф поряд із розрідженим; curriculum за складністю сцени; окремий буфер для рідкісних подій.
Порядок curriculum важливіший за сам curriculum
Навчання йде у два етапи. Спершу на спрощеній задачі — три дрони, трикутний стрій, три рухомі перешкоди — випадковим пошуком підбирають ваги груп винагороди. Знайдені ваги фіксують, і на другому етапі проганяють curriculum за складністю сцени.
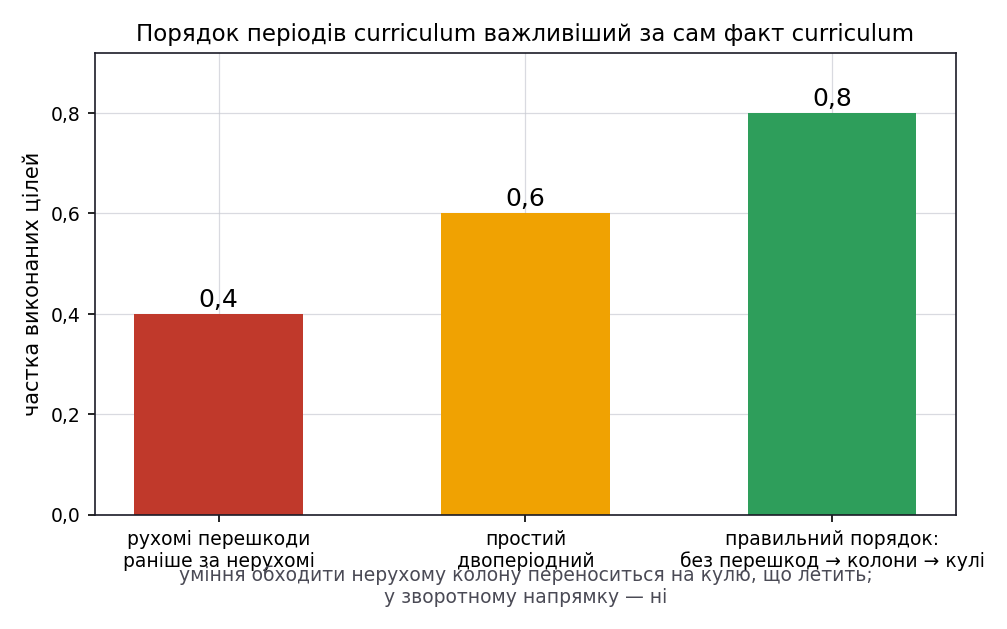
Вплив порядку curriculum на частку досягнутих цілей
| Період | Сцена | Кроків середовища |
|---|---|---|
| 1 | без перешкод | 15 млн |
| 2 | 10 статичних колон | 150 млн |
| 3 | 10 колон і 2 рухомі кулі | 150 млн |
| Разом | 315 млн |
Уміння обходити нерухому колону переноситься на кулю, що летить; у зворотному напрямку — ні.
Стрій і обхід перешкод одним навчанням
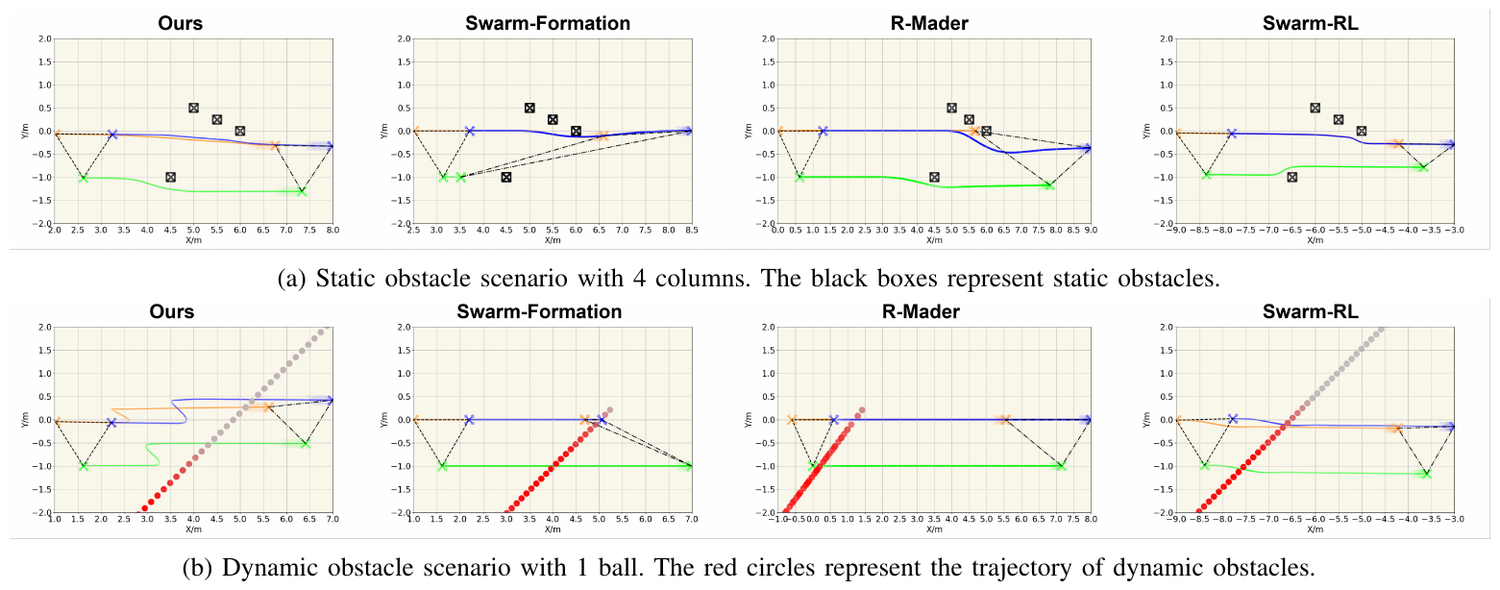
Керування строєм з обходом перешкод: порівняння чотирьох алгоритмів
Ця сама сцена з Модуля 03 — тепер із боку навченої політики. Дивитися треба на три речі: чи відновився стрій після обходу, чи не порушено мінімальну дистанцію, скільки додаткового шляху коштував маневр.
Мінімальна дистанція як критерій відмови
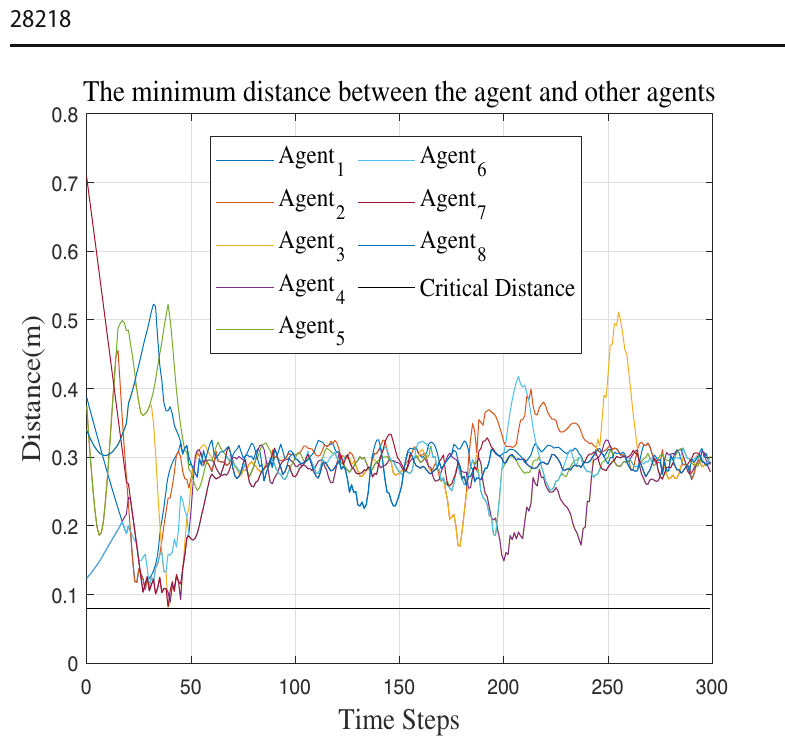
Мінімальна відстань між вісьмома апаратами в часі
Крива мінімальної відстані має завжди лежати вище радіуса безпеки. Провал нижче — це відмова, навіть якщо середня похибка строю виглядає прийнятною.
Саме тому в наборі метрик рою мінімальна дистанція йде окремим рядком і ніколи не усереднюється за епізодом: усереднення ховає рівно той момент, заради якого метрику й вимірюють.
Частина 4 · Декомпозиція цінності
Централізована функція цінності дій має вихід на кожну спільну дію, а їх експоненційно багато. Декомпозиція розкладає її на індивідуальні утилітності.
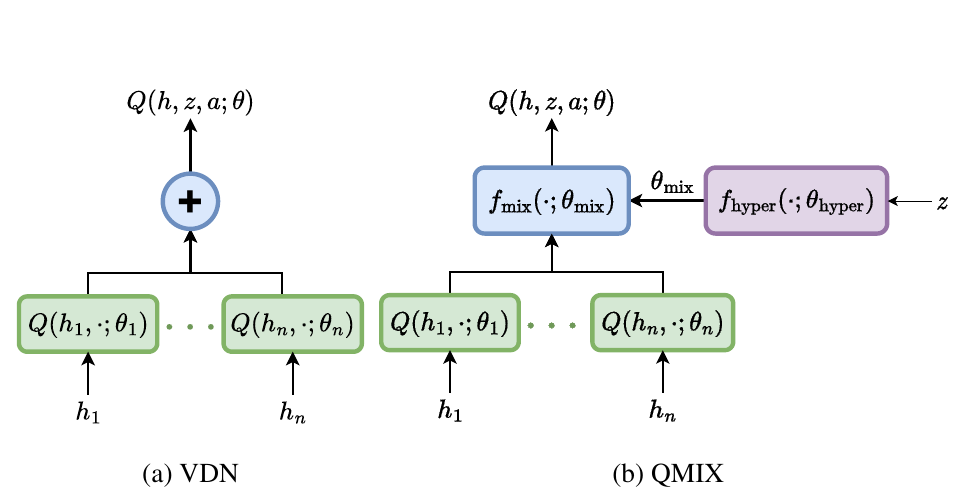
Архітектура мереж VDN і QMIX
Умова коректності називається IGM (individual-global-max): максимум централізованої оцінки має досягатися тоді й лише тоді, коли максимізовано кожну індивідуальну утилітність. Тільки за неї децентралізоване виконання дає той самий результат, що й централізоване.
VDN: лінійна декомпозиція
Будь-яка сума задовольняє IGM: максимум суми досягається тоді й лише тоді, коли максимальний кожен доданок. Метод уведений у Sunehag та ін., arXiv:1706.05296. Звідси обчислювальний виграш — максимум по спільній дії розпадається на
| Апаратів | Виходів у централізованої | Виходів після декомпозиції |
|---|---|---|
| 2 | 25 | 10 |
| 5 | 3 125 | 25 |
| 10 | 9 765 625 | 50 |
Навчають VDN так само, як DQN, але наскрізно: втрата рахується для суми утилітностей, градієнт проходить крізь суму в кожну індивідуальну мережу. У задачі покриття це означає, що апарат, який завис на місці, отримає власну утилітність, яка не зросте від бездіяльності.
QMIX: монотонна декомпозиція
Лінійність VDN нереалістична там, де внесок апарата залежить від того, що роблять інші: у вузькому коридорі користь від просування вперед визначається тим, чи звільнив прохід сусід. QMIX послаблює вимогу. Робота, що ввела метод, — Rashid та ін., arXiv:1803.11485.
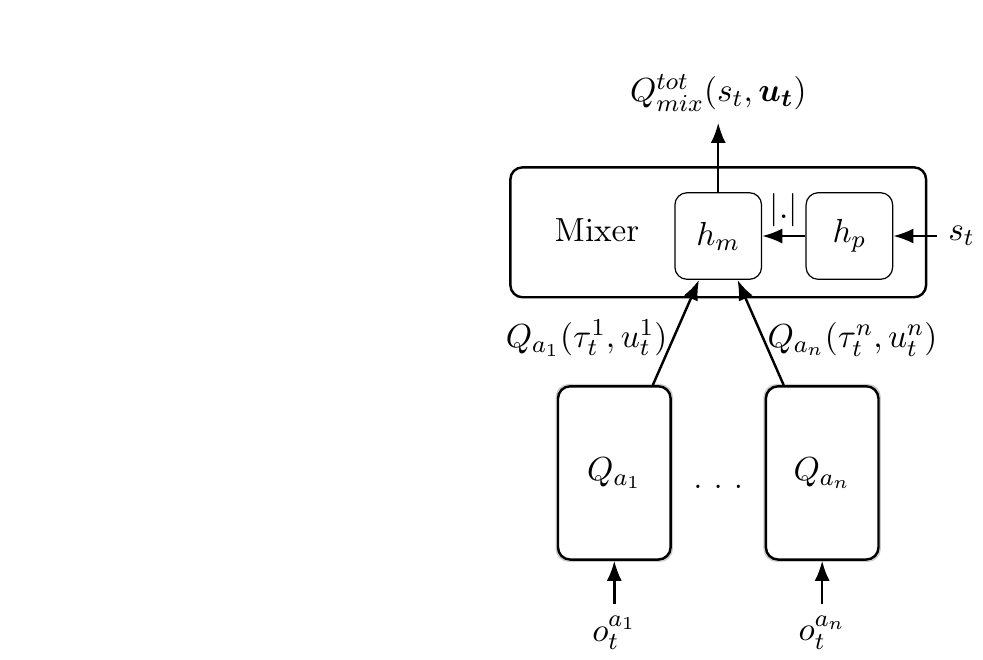
Архітектура QMIX зі змішувальною та гіпермережею
Монотонності досить для IGM: якщо агрегація не спадає за жодним аргументом, зростання власної утилітності ніколи не зменшує спільної оцінки. Лінійність VDN — окремий випадок монотонності.
Монотонність забезпечують просто: усі ваги, крізь які проходять утилітності, роблять невід'ємними. Самі ваги видає окрема гіпермережа (hypernetwork), що приймає централізовану інформацію: повний стан сцени, карту перешкод, положення всіх апаратів.
Що саме вивчає змішувальна мережа
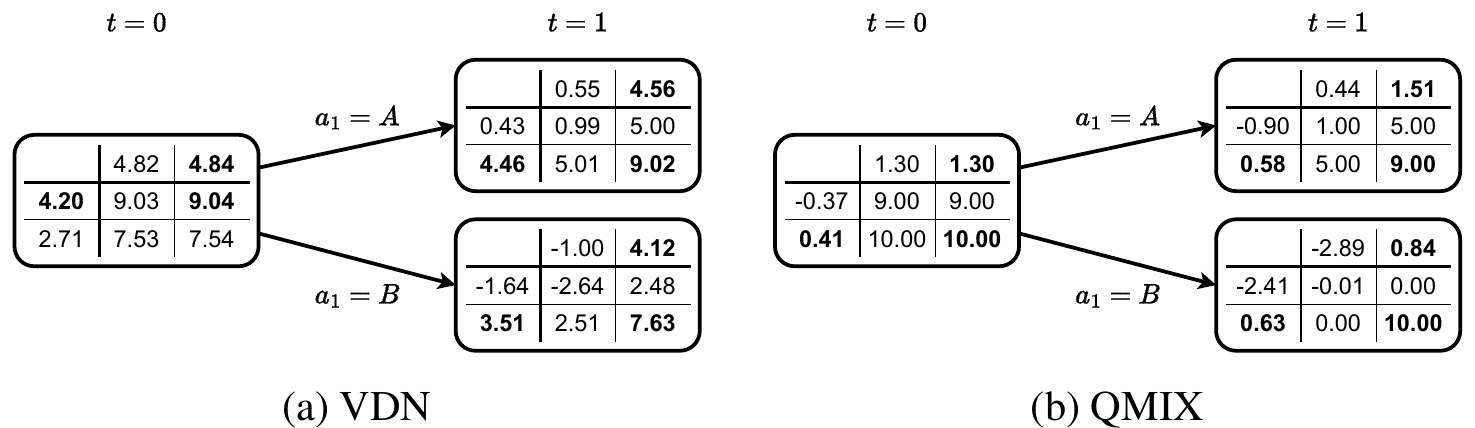
Вивчена декомпозиція цінності у VDN і QMIX
Візуалізація показує, як обидва методи розкладають спільну цінність. VDN змушений розподілити її лінійно; QMIX може надати одному апарату більшу вагу залежно від стану сцени — саме тому він справляється з ситуаціями, де внески агентів не додаються.
Ціна: QMIX має більше параметрів, важче навчається й вимагає централізованого стану на етапі навчання. Для кооперативних задач із чіткою декомпозицією VDN часто достатньо.
Parameter sharing: одна мережа на весь рій
Апарати в рої найчастіше фізично однакові, а їхні ролі взаємозамінні. Тоді немає причин тримати окрему мережу на кожен апарат: навчають одну політику, і всі апарати виконують її копії. Рій зі 128 апаратів виконує одну й ту саму мережу на
Формальна умова коректності — сильна однорідність: має існувати оптимальна спільна політика, у якій усі індивідуальні політики однакові. Для однотипних квадрокоптерів, що летять кожен до своєї цілі, це виконується; для рою, де частина веде розвідку, а частина переслідує, — ні.
Два часткові пом'якшення:
- індекс або вектор ролі у спостереженні: одна мережа реалізує кілька поведінок, якщо їй вистачить ємності;
- обмін досвідом замість обміну параметрами: кожен апарат тримає власну мережу, але навчається й на траєкторіях інших, переважених коефіцієнтом importance sampling.
Гетерогенний рій: різні ролі, різні винагороди
Коли апарати виконують різні функції, parameter sharing уже не застосовний, і природним вибором стає MADDPG у режимі CTDE: централізований критик, індивідуальні винагороди за ролями.
Конфігурація — 5 переслідувачів, 5 розвідників і 2 утікачі, які теж навчаються й рухаються на 30 % швидше за переслідувачів.
| Роль | Мета | Член винагороди |
|---|---|---|
| Переслідувач | зблизитися з ціллю | |
| Розвідник | рівномірно покривати область | мінімізація найбільшої комірки Вороного |
| Обидві | лишатися в робочій зоні | експоненційний штраф за вихід за межі |
| Обидві | не стикатися | сталий штраф за порушення фізичних меж |
Реальний політ: 6 Crazyflie 2.1 — 3 розвідники, 2 переслідувачі, 1 утікач; локалізація UWB з 8 якорями, 3 конуси як перешкоди. Середня мінімальна відстань до цілі 0,50 м проти 0,46 м у симуляції.
Частина 5 · Межі навчання: тридцять дронів без жодного RL
Стійкий флокінг великого рою отримано без навчання політики. Береться явна інтерпретована модель флокінгу з 11 параметрами, і еволюційна оптимізація CMA-ES підбирає ці 11 чисел.
| Показник | Значення |
|---|---|
| Реальні польоти | 30 квадрокоптерів на відкритому повітрі |
| Симуляція | 100 агентів, швидкості 4–32 м/с |
| Придатність при 4 / 6 / 8 м/с | 0,92 / 0,87 / 0,80 |
| Середня відстань до найближчого сусіда | 12–30 м |
| Стійкість до затримки зв'язку | до 1 с |
| Максимальна швидкість | 32 м/с у симуляції, 8 м/с у реальному польоті |
Простір пошуку тут — 11 чисел, а не
Чотири способи не зіткнутися
| Підхід | Що має знати агент | Які гарантії | Де ламається |
|---|---|---|---|
| Потенціальне поле | положення сусідів і перешкод | формальних немає | локальні мінімуми, осциляції у вузькому проході |
| ORCA | відносне положення й швидкість сусідів, припущення, що всі виконують те саме правило | зіткнень немає протягом горизонту | нехолономна динаміка, похибка оцінки швидкості, сусід із іншим алгоритмом |
| Навчена політика | власний стан, | гарантій немає, лише статистика на розподілі навчальних сцен | вихід за межі розподілу: 0,02 зіткнення при 8 апаратах і 8,63 при 128 |
| Навчена бар'єрна функція | те саме плюс сертифікат безпеки | безпека закодована в обмеженні, а не у винагороді | понад 95 % успіху при 1024 агентах проти ≈ 20 % без сертифіката |
Критерій вибору: якщо задача допускає формулювання гарантій — беріть метод із гарантіями. Навчена політика виправдана там, де класичний метод не формулюється або надто повільний.
ORCA: гарантія на горизонті
Метод працює не в просторі положень, а в просторі швидкостей. Для кожного сусіда агент будує множину швидкостей, які протягом найближчих
| Позначення | Значення |
|---|---|
| відносна швидкість | |
| горизонт передбачення, типово 1–3 с | |
| круг радіуса |
Наївна версія має ваду: якщо ухиляються обидва, пара починає осцилювати. ORCA знімає це взаємністю: обчислюють мінімальну поправку, яка виводить відносну швидкість за межу небезпечної множини, і кожен агент бере на себе рівно половину. Жодної моделі навчання, жодного зв'язку.
На чому вчити: пропускна здатність вирішує все
Політиці рою потрібні сотні мільйонів кроків середовища. Отже, вирішальний параметр симулятора — не точність фізики, а кількість кроків за секунду.
| Симулятор | Основа | Паралельних середовищ | Пропускна здатність |
|---|---|---|---|
| gym-pybullet-drones | PyBullet, CPU | одиниці | ≈ 4 тис. кроків фізики/с (16,8× реального часу на ноутбуці) |
| OmniDrones | Isaac Sim, GPU | 1024–4096 | 196–732 тис. кроків/с (один агент), 115–310 тис. (четверо) |
| Aerial Gym | Isaac Gym, GPU | до 217 роботів у середовищі | до 3,8 млн кроків/с сумарно |
Різниця між CPU і GPU — два-три порядки. Саме вона, а не нові алгоритми, зробила навчання роєвих політик здійсненним: те, що на CPU рахувалося б місяцями, на GPU займає години. Числа мають сенс лише разом із конфігурацією: у GPU-рядках це сумарна пропускна здатність усіх паралельних середовищ, а не швидкість одного.
OmniDrones додатково містить прямі порівняння MAPPO, HAPPO, MADDPG і QMIX на одних і тих самих задачах рою.
Реальне залізо: що обмежує експеримент
| Параметр | Значення |
|---|---|
| Максимальний рій | 49 апаратів одночасно |
| Апарат | 92 мм по діагоналі, 27 г без надбудов, ARM 168 МГц |
| Радіоканал | три USB-передавачі 2,4 ГГц, кожен апарат постійно закріплений за одним із трьох |
| Середня похибка позиціювання | менше 2 см |
| Затримка системи для рою з 49 апаратів | 26 мс |
| Час польоту | ≈ 6 хвилин |
Три наслідки, які варто назвати студентам прямо:
- шість хвилин польоту означають, що серія прогонів робиться пакетами із заміною акумуляторів, і кожен прогін коштує дорого;
- позиції надходять від зовнішньої системи захоплення руху, тобто децентралізованість у приміщенні децентралізована лише щодо обчислень, а не щодо локалізації;
- усі контролери виконуються на борту, а наземна станція шле лише завдання.
Джерело параметрів: Preiss, Hönig та ін., Crazyswarm, ICRA 2017.
Висновки
- Політика рою мусить бути інваріантною до перестановки й до розміру рою. Усереднене вкладення дає обидві властивості структурно, а не через навчання: різниця виходу при перестановці рівно 0,0000.
- CTDE — робочий компроміс: критик бачить усе під час навчання, політика бачить лише локальне в польоті. Після навчання критик викидають.
- Чисто спільна винагорода не працює: дрон, що зробив 62 % роботи, отримує стільки ж, скільки той, що висів. Змішана винагорода
дає десятикратну різницю. - Розріджений штраф за зіткнення сам по собі не вчить — поряд обов'язковий щільний штраф близькості з удвічі більшою вагою.
- Інваріантність дає безкоштовний перенос у межах двократної зміни
; далі потрібне донавчання, яке знижує зіткнення з 8,63 до 1,37. - IGM — умова коректності декомпозиції; VDN вимагає лінійності, QMIX — лише монотонності, і лінійність є окремим випадком.
- Навчена політика не має гарантій. ORCA й бар'єрні функції їх мають. Обирайте за гарантіями, а не за модою.
Перехід до Модуля 09
Модуль 08 дав апарат: інваріантні кодувальники, CTDE, декомпозиція цінності, parameter sharing. Методів достатньо — бракує інженерної дисципліни, з якою їх доводять до результату.
Модуль 09 · Практика багатоагентного навчання відповідає на питання, яке виникає в кожного, хто запускав навчання рою: політика не вчиться — чому саме і що перевіряти першим. Там же — коли parameter sharing коректний, як чесно побудувати криву навчання й чому порівняння двох алгоритмів буває недійсним навіть за красивих графіків.
Література та ресурси
- Batra S. та ін. Decentralized Control of Quadrotor Swarms with End-to-end Deep Reinforcement Learning. CoRL, 2021. arXiv:2109.07735
- Huang S. та ін. Collision Avoidance and Navigation for a Quadrotor Swarm Using End-to-end Deep Reinforcement Learning. ICRA, 2024. arXiv:2309.13285
- Sunehag P. та ін. Value-Decomposition Networks For Cooperative Multi-Agent Learning. arXiv:1706.05296
- Rashid T. та ін. QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent RL. ICML, 2018. arXiv:1803.11485
- Lowe R. та ін. Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (MADDPG). arXiv:1706.02275
- Yu C. та ін. The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games (MAPPO). arXiv:2103.01955
- Vásárhelyi G. та ін. Optimized Flocking of Autonomous Drones in Confined Environments. Science Robotics, 2018, 3(20). DOI 10.1126/scirobotics.aat3536
- van den Berg J. та ін. Reciprocal n-Body Collision Avoidance (ORCA). ISRR, 2011.
- Zaheer M. та ін. Deep Sets. NeurIPS, 2017. arXiv:1703.06114
- Preiss J. A., Hönig W. та ін. Crazyswarm: A Large Nano-Quadcopter Swarm. ICRA, 2017.
- Практика: EPyMARL · OmniDrones · Crazyswarm2