Тема
Модуль 06 · Глибоке навчання з підкріпленням для БПЛА
Як глибоке навчання з підкріпленням застосовують до керування безпілотними апаратами: від таксономії методів до конкретних польотних задач і перенесення політики на реальний борт.
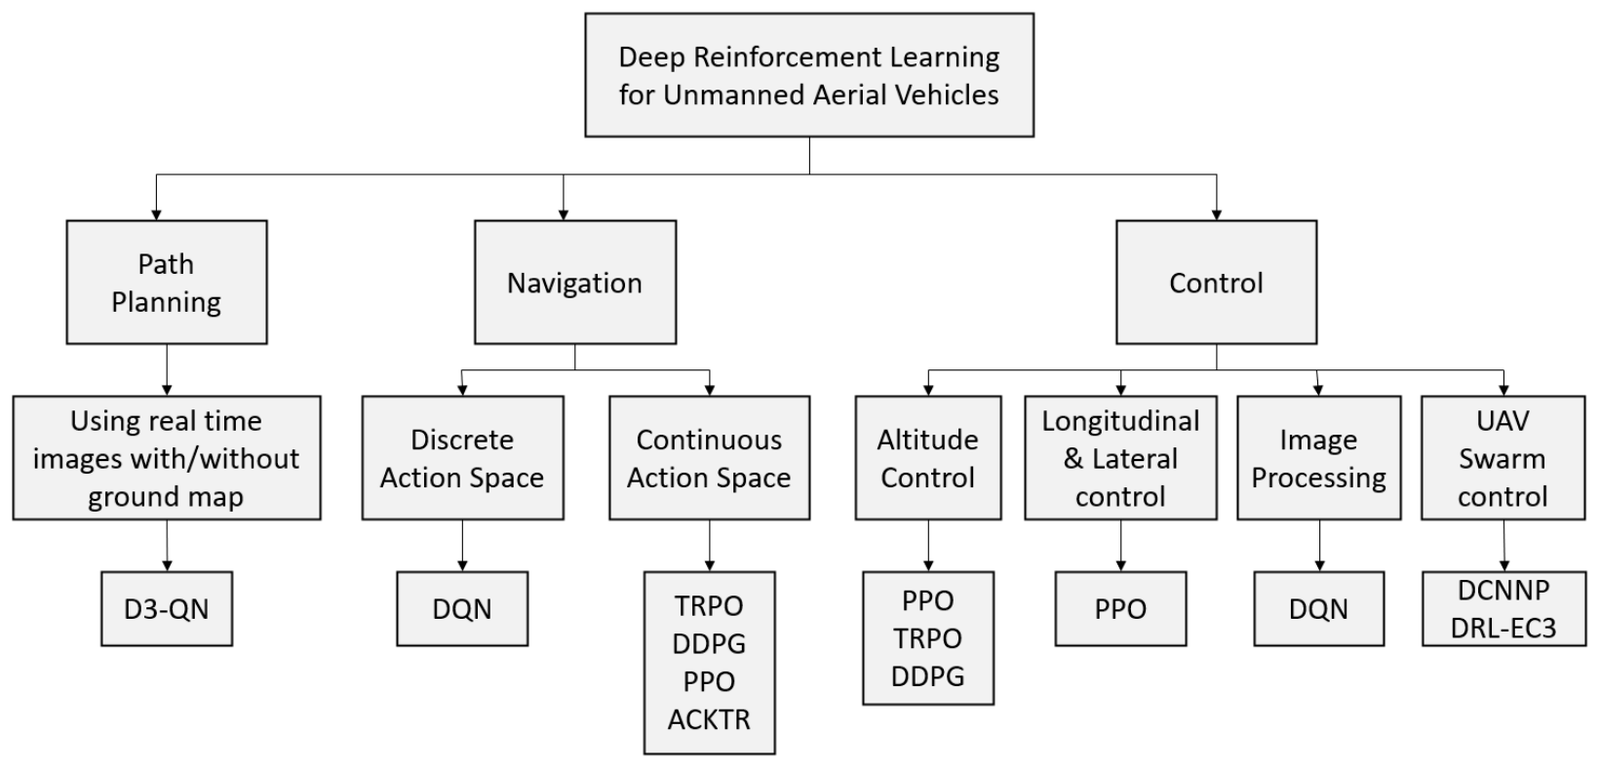
Таксономія алгоритмів глибокого RL для задач БПЛА
Зміст лекції
Модуль 04 дав одноагентний RL, Модуль 05 — багатоагентні моделі. Тут апарат з'єднується з реальним об'єктом керування.
| Частина | Про що |
|---|---|
| 1. Вибір алгоритму | таксономія методів і зіставлення задачі з родиною алгоритмів |
| 1б. Механіка PPO | on-policy, GAE, обрізання, ентропія, гіперпараметри |
| 2. Проєктування задачі | вектор спостереження, рівень керування, функція винагороди |
| 3. Польотні задачі | керування орієнтацією, посадка, стеження, рій |
| 4. Порівняння в польоті | що показали реальні експерименти |
| 5. Sim-to-real | доменна рандомізація і порядок перенесення на борт |
Головне питання модуля не «який алгоритм кращий», а «як поставити задачу так, щоб її взагалі можна було навчити».
Результати навчання
Після лекції ви зможете:
- назвати три категорії підходів — value-based, policy-based, actor–critic — і розрізнити model-free від model-based, on-policy від off-policy;
- пояснити, чому з градієнтом політики не можна використовувати replay buffer, і що з цього випливає для вибору алгоритму;
- пояснити роль
в GAE та в обрізанні PPO і сказати, що станеться, якщо кожен зсунути в обидва боки; - назвати гіперпараметр, який крутять першим, коли політика перестала досліджувати;
- зіставити польотну задачу з придатною родиною алгоритмів і обґрунтувати вибір типом простору дій;
- спроєктувати вектор спостереження й вектор дії для заданої задачі БПЛА;
- підібрати ваги доданків винагороди за порядком величини й перевірити масштаб термінального штрафу;
- пояснити, чому політика керує кутовими швидкостями, а не моторами напряму;
- описати конвеєр sim-to-real і роль доменної рандомізації;
- пояснити, чому стандартизація винагород може змінити саму задачу.
Частина 1 · Вибір алгоритму під задачу
Дерево вибору має три гілки: планування шляху, навігація й керування. Вирішальний критерій на нижньому рівні — тип простору дій: дискретний набір команд чи неперервні керувальні сигнали.
| Група задач | Задача | Умова | Придатні алгоритми |
|---|---|---|---|
| Планування шляху | побудова маршруту | зображення в реальному часі | D3QN |
| Навігація | рух до цілі | дискретний простір дій | DQN |
| Навігація | рух до цілі | неперервний простір дій | TRPO, DDPG, PPO, ACKTR |
| Керування | керування висотою | неперервні команди | PPO, TRPO, DDPG |
| Керування | поздовжнє й бічне керування | неперервні команди | PPO |
| Керування | керування за зображенням | дискретні команди | DQN |
| Керування | керування роєм | багатоагентна задача | DCNNP, DRL-EC³ |
Навіщо DRL там, де є класичне керування
Класичне керування спирається на лінеаризовану динаміку й потребує точної моделі апарата. DRL дає чотири речі, яких там немає:
- працює model-free, коли точну модель побудувати важко;
- враховує нелінійності, які лінійні регулятори ігнорують;
- пристосовується до мети онлайн, без окремого налаштування під кожен сценарій;
- працює в середовищах, невідомих апаратові наперед.
Додатково DRL відкриває задачі, які класичними засобами майже не беруться: безпечне керування гібридними апаратами й керування роєм із мінімальними витратами часу, енергії та кількості маневрів.
Але: заміна одного алгоритму іншим у межах тієї самої постановки часто зводиться до зміни функції втрат. Це ознака того, що постановка задачі важить більше за алгоритм.
Порівняння безмодельних алгоритмів
| Алгоритм | Тип агента | Політика | Простір дій |
|---|---|---|---|
| SARSA | value-based | on-policy | дискретний |
| DQN та варіанти (Double, Dueling, Prioritized) | value-based | off-policy | дискретний |
| NAF | value-based | off-policy | неперервний |
| REINFORCE | policy-based | on-policy | дискретний або неперервний |
| TRPO, PPO | actor–critic | on-policy | дискретний або неперервний |
| A2C, A3C | actor–critic | on-policy | дискретний або неперервний |
| DDPG, TD3 | actor–critic | off-policy | неперервний |
| SAC | actor–critic | off-policy | неперервний |
Таблиця відповідає на головне питання проєктування: чи вкладається задача в дискретний набір команд. Якщо ні, вся ліва частина відпадає одразу.
DDPG: детермінований актор для неперервного керування
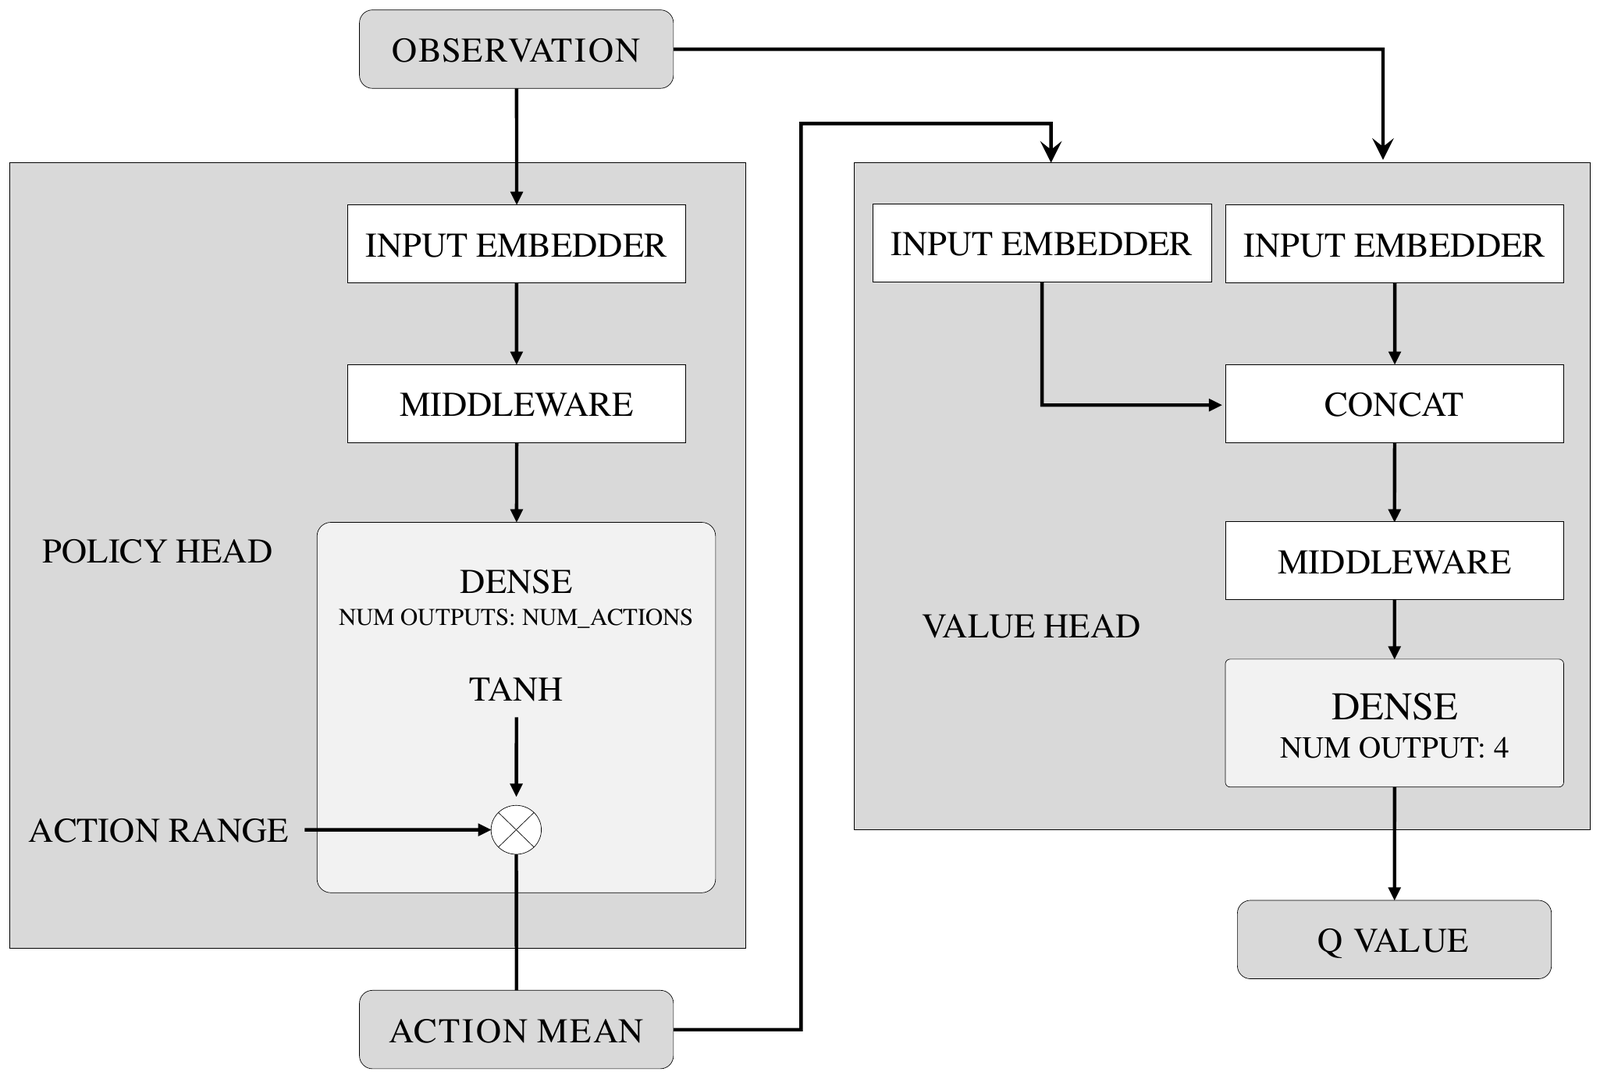
Блок-схема алгоритму DDPG
DDPG поєднує ідеї DQN і actor–critic. Оригінальна робота — Lillicrap та ін., arXiv:1509.02971. Актор видає детерміновану дію, критик оцінює пару «стан–дія», обидві мережі мають заморожені цільові копії, і навчання йде з replay buffer — тобто off-policy. Дослідження забезпечує шум, який додають безпосередньо до виходу актора.
Саме тому DDPG природно лягає на керування тягою й кутовими швидкостями: там дія — це вектор дійсних чисел, а не вибір із меню.
Практичне застереження: базовий DDPG нестабільний. Сучасні рекомендації — два критики й затримане оновлення актора (TD3), м'яке оновлення цільових мереж з коефіцієнтом
Чому PPO, а не DQN: on-policy і його ціна
Теорема про градієнт політики дає вираз, у який невідома динаміка середовища не входить:
Читається так: підняти ймовірність дії тим сильніше, чим більша її очікувана віддача. Дільник
Головне обмеження — у самому матсподіванні: воно береться за поточною політикою. Дані, зібрані будь-якою іншою політикою, зокрема попередніми версіями цієї самої, використовувати не можна. Звідси два наслідки, які студенти зазвичай дізнаються, набивши ґулю:
- replay buffer із градієнтом політики несумісний у принципі;
- DQN-подібний критик теж не годиться: він наближає оптимальну цінність через рівняння оптимальності Беллмана, а теорема вимагає цінність за поточної політики.
Саме тому в лабораторних стоїть PPO, а не DQN: керування тягою неперервне, і дані доводиться збирати заново після кожного оновлення.
Компроміс зсуву й дисперсії: скільки кроків заглядати вперед
Оцінити віддачу можна по-різному, і вибір керує головним компромісом навчання.
| Що це | Зсув | Дисперсія | |
|---|---|---|---|
| однокроковий бутстреп | високий | низька | |
| середній | середня | ||
| Монте-Карло, весь епізод | нуль | висока |
Це не теоретизування: Albrecht та ін. виміряли обидві величини на 10 000 епізодів у навченому середовищі. Дисперсія монотонно росте з
Чому це важливо саме для дрона: епізод висіння — 400–500 кроків. Монте-Карло означає одне оновлення в кінці епізоду з дисперсією по всій траєкторії; однокроковий бутстреп дає оновлення щокроку, але тягне зсув недонавченого критика.
GAE: неперервна ручка між цими двома краями
Замість дискретного вибору «
| До чого зводиться | Поведінка | |
|---|---|---|
| найменша дисперсія, найбільший зсув | ||
| робоча точка за замовчуванням | компроміс | |
| Монте-Карло-перевага | без зсуву, дисперсія найбільша |
Один параметр gae_lambda, типове значення 0,95.
Джерело окреме. Підручник курсу GAE не містить — він зупиняється на
Обрізання PPO: чому крок обмежують, а не зменшують
Один крок градієнта навіть із малим темпом навчання може зіпсувати політику: після оновлення розподіл даних змінюється, і те, що було добрим напрямком, перестає ним бути. TRPO обмежує крок явним обмеженням на розбіжність політик — але це дорого рахувати. PPO робить дешевий сурогат.
Вага важливісної вибірки показує, наскільки нова політика розійшлася з тією, якою дані реально збирали:
Мінімум із двох доданків робить межу односторонньою: покращувати політику далі за межу невигідно, а повертатися назад — можна. Типове clip_range.
Обрізання — єдине, що PPO додає до A2C. Натомість воно дозволяє кілька проходів по одному й тому самому батчу (n_epochs), бо
Ентропійний бонус і нормалізація: дві ручки, які насправді крутять
Ентропійний бонус додають до втрат актора, щоб політика не схлопнулася в майже детерміновану зарано:
Ентропія максимальна на рівномірному розподілі, тому штраф за її зниження тримає дослідження живим. У SB3 це ent_coef; для висіння з неперервною тягою типово 0 — 0,01. Це перше, що варто крутити, коли політика перестала досліджувати.
Стандартизація віддач — другий типовий прийом: у багатьох задачах винагороди охоплюють кілька порядків, і мережі цінності важко їх наближати. Приводять до середнього 0 і відхилення 1.
⚠️ Але тут є пастка, про яку варто знати заздалегідь. Розглянемо середовище з двох дій: перша дає
Для рою це не абстракція: якщо ваша винагорода складена зі штрафів — відхилення від строю, зближення, витрата енергії, — стандартизація може перетворити задачу «виконати місію швидше» на «літати довше».
Гіперпараметри PPO, з якими ви працюватимете
Зведено те, що реально доводиться задавати в лабораторних. Значення — робочі точки, а не догма.
| Параметр | У SB3 | Робоча точка | За що відповідає |
|---|---|---|---|
| Темп навчання | learning_rate | розмір кроку оптимізатора | |
| Дисконт | gamma | 0,99 | горизонт планування |
| Обрізання | clip_range | 0,2 | наскільки політиці дозволено відійти за оновлення |
| GAE | gae_lambda | 0,95 | зсув проти дисперсії оцінки переваги |
| Кроків на збір | n_steps | 2048 | розмір батча між оновленнями |
| Проходів по батчу | n_epochs | 4–10 | скільки разів перевикористати ті самі дані |
| Ентропія | ent_coef | 0 — 0,01 | скільки дослідження лишити |
| Розмір мережі | net_arch | два шари по 64 | ємність актора й критика |
Що крутити першим, коли не вчиться. Спершу ентропія — вона керує дослідженням, і саме її радять перевіряти в першу чергу. Далі темп навчання. clip_range вище 0,2 підвищує швидкість збіжності ціною стабільності, нижче — навпаки.
І головне правило чесності, до якого ще повернемося: порівняння двох алгоритмів, де один отримав ширший пошук гіперпараметрів, недійсне.
Частина 2 · Проєктування задачі
Дрон рухається в трьох вимірах і може перекинутися, тож спостереження мусить нести й орієнтацію, і кутові швидкості. Вісімнадцять чисел нижче — стандартний набір із сучасних робіт з рою.
| Блок | Компоненти | Розмір | Одиниці | Приклад |
|---|---|---|---|---|
| Вектор на ціль | 3 | м | 0,31 · −0,26 · +0,10 | |
| Лінійна швидкість | 3 | м/с | 0,84 · −0,61 · 0,05 | |
| Орієнтація | матриця повороту | 9 | безрозмірні | діагональ 0,985 · 0,972 · 0,985 |
| Кутова швидкість | 3 | рад/с | 0,42 · −1,70 · 0,15 | |
| Разом | 18 |
Два проєктні рішення, які варто пояснити студентам окремо:
- вектор на ціль, а не абсолютні координати — тоді політика працює в будь-якій точці кімнати;
- матриця повороту, а не кути Ейлера — у кутів є розриви на ±180°, і мережа на них зривається. Це прямий наслідок Модуля 02.
Відстань до цілі тут 0,42 м — довжина вектора
Рівні керування: чому не одразу мотори
Політика може віддавати команди на різних рівнях. Що нижчий рівень — то більше свободи в маневрі, але то важче навчити й перенести на залізо.
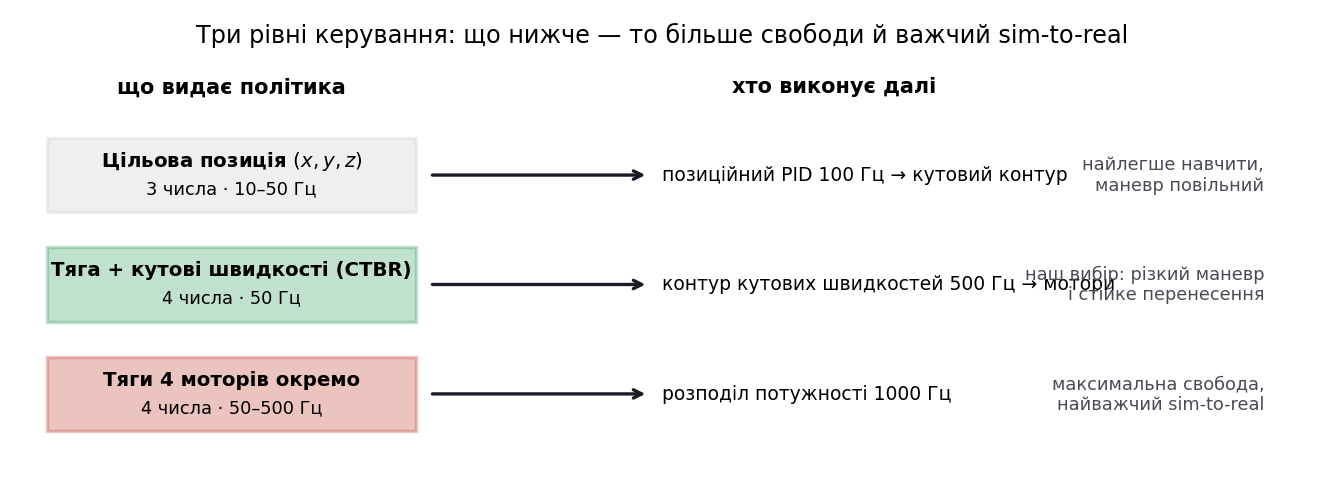
Три рівні команд керування, які може віддавати політика
Внутрішній контур кутових швидкостей на 500 Гц реагує в десять разів швидше за політику й прощає їй неточність: якщо політика попросила «крен 1,2 рад/с», регулятор доб'ється цього, навіть якщо один мотор трохи слабший. Політика, яка керує моторами напряму, мусить сама вивчити всю цю компенсацію — і вивчить її під конкретний симулятор.
| Вихід політики | Діапазон | Одиниці | Приклад |
|---|---|---|---|
| Колективна тяга | безрозмірна | 0,66 | |
| Кутова швидкість крену | рад/с | +1,20 | |
| Кутова швидкість тангажа | рад/с | −2,30 | |
| Кутова швидкість рискання | рад/с | +0,05 |
Винагорода як зважена сума
Кожну з конкурентних цілей подають окремим доданком, і все зводять до зваженої суми.
| Доданок | Типова роль |
|---|---|
| помилка позиції або орієнтації | головна мета, найбільша вага |
| помилка швидкості | згладжує підхід до цілі, гасить перерегулювання |
| зусилля керування | економія енергії, менший знос приводів |
| зміна дії між кроками | плавність, менше збудження резонансів |
| бонус за живучість / штраф за аварію | задає межі допустимої поведінки |
Загальне правило reward shaping: додаткові доданки мають підказувати напрям, а не створювати власний локальний оптимум, у якому агентові вигідно зависнути назавжди.
Код: калібрування ваг винагороди
Ваги підбирають не навмання: оцінюють типовий масштаб кожного доданка на початку навчання, вирішують, який внесок він має давати, і ділять друге на перше.
python
import numpy as np

TERMS = {                      # доданок: (типовий масштаб на початку, бажаний внесок)
    "помилка позиції, м":      (2.0, 1.00),
    "помилка швидкості, м/с":  (1.0, 0.30),
    "помилка рискання, рад":   (0.5, 0.20),
    "зусилля керування":       (0.4, 0.10),
    "ривок дії":               (0.2, 0.05),
}
w = {k: contrib / scale for k, (scale, contrib) in TERMS.items()}

def reward(f):
    """f — словник поточних значень доданків. r = 1 - sum(w_i * f_i)."""
    return 1.0 - sum(w[k] * f[k] for k in w)

near  = {"помилка позиції, м": 0.20, "помилка швидкості, м/с": 0.10,
         "помилка рискання, рад": 0.05, "зусилля керування": 0.05, "ривок дії": 0.02}
start = {"помилка позиції, м": 2.00, "помилка швидкості, м/с": 1.00,
         "помилка рискання, рад": 0.30, "зусилля керування": 0.40, "ривок дії": 0.20}
r_near, r_start = reward(near), reward(start)

# Небезпечний режим — не політ біля цілі, а початок навчання: там кожен крок
# коштує r_start < 0, і дожити до кінця епізоду означає накопичити збиток.
STEPS, HZ = 500, 50
for crash_step in (100, 250):
    debt = -(STEPS - crash_step) * r_start
    for pen in (10, 100, 400):
verdict = "падати ВИГІДНО" if pen < debt else "падати невигідно"Результат: чому штраф −10 навчає падати
text
ваги: {'позиція': 0.5, 'швидкість': 0.3, 'рискання': 0.4, 'зусилля': 0.25, 'ривок': 0.25}

r(майже в цілі)    = +0.83
r(щойно стартував) = -0.57
контраст сигналу   = 1.40 на крок

епізод 500 кроків (10 с) ідеального зависання = 416 одиниць

політика ще не навчена, кожен крок коштує -0.57:
  аварія на кроці 100: далі накопичиться 228 збитку, штраф -10  -> падати ВИГІДНО
  аварія на кроці 100: далі накопичиться 228 збитку, штраф -100 -> падати ВИГІДНО
  аварія на кроці 100: далі накопичиться 228 збитку, штраф -400 -> падати невигідно
  аварія на кроці 250: далі накопичиться 143 збитку, штраф -10  -> падати ВИГІДНО
  аварія на кроці 250: далі накопичиться 143 збитку, штраф -100 -> падати ВИГІДНО
  аварія на кроці 250: далі накопичиться 143 збитку, штраф -400 -> падати невигідно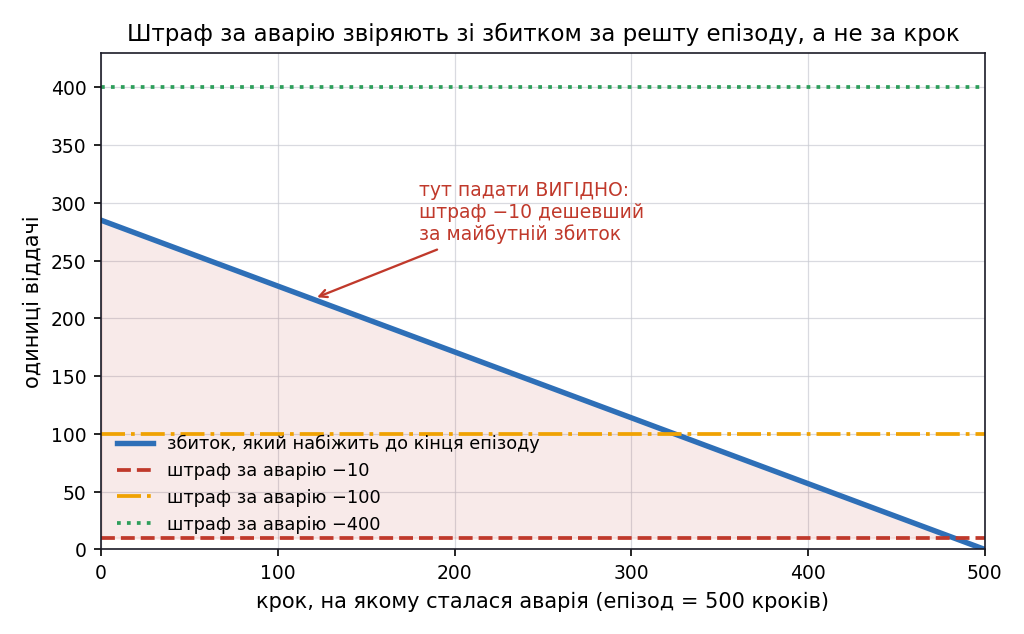
Штраф за аварію проти віддачі, втраченої через аварію
Загальне правило: ваги задають відносну важливість, а масштаб термінального штрафу треба звіряти зі збитком, який агент накопичить за решту епізоду. Поки політика погана, цей збиток додатний, і замалий штраф робить аварію найвигіднішою дією.
Внесок доданків у двох режимах польоту
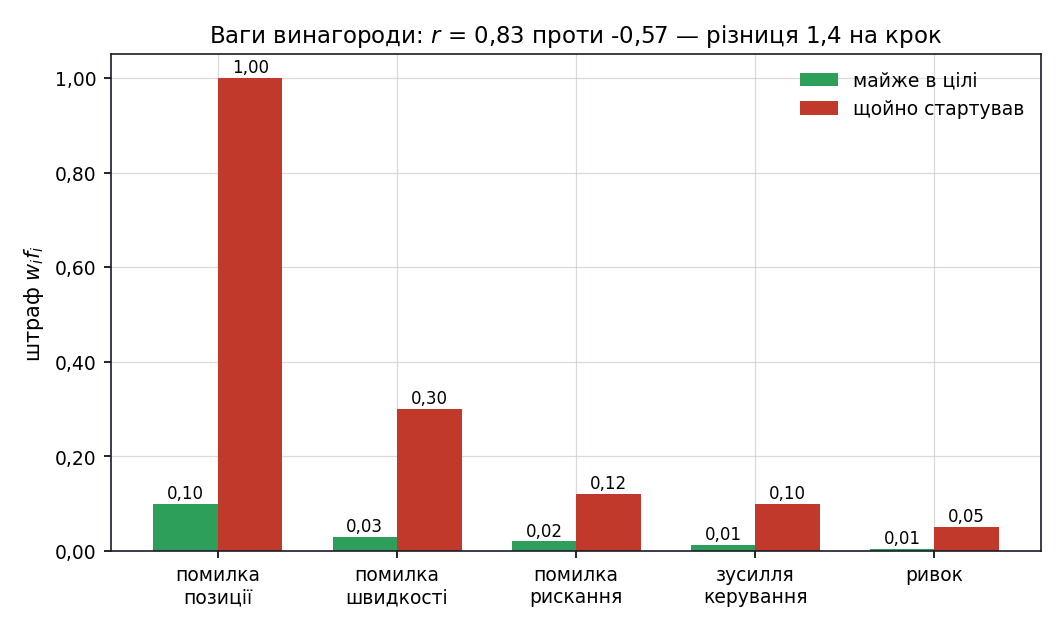
Внесок доданків винагороди у двох режимах польоту
Контраст сигналу 1,40 на крок — це різниця між «добре» і «погано», і вона має бути помітною на тлі шуму. Якщо контраст менший за розкид винагороди між епізодами, градієнт тоне в шумі й навчання не рушить.
Перевірка на двох режимах: апарат майже в цілі дає
Складена винагорода: хто скільки важить за епізод
Епізод 8 с при 50 Гц — 400 кроків. Стовпчик показує внесок доданка за весь епізод, а не за крок: саме так їх і порівнюють.
наближення до цілі
-0.72
кутова швидкість
-0.28
нахил
-0.24
різкість керування
-0.05
бонус за життя
+4.00
аварія
+0.00
+2.71віддача за епізод
+1.76віддача за решту епізоду, якщо не падати
достатньочи стримує штраф за аварію
Виберіть «Політ з аварією» і зменшуйте бонус за життя, доки віддача за решту епізоду не стане від'ємною: летіти далі тепер означає накопичувати збиток. Після цього зменшуйте штраф за аварію — щойно він виявиться дешевшим за цей збиток, агентові вигідніше розбитися одразу. Це не помилка алгоритму, а помилка постановки, і знаходять її саме таким розкладом, а не за сумарною кривою.
Частина 3 · Польотні задачі
Далі — що вже зроблено в реальних роботах: керування орієнтацією, нестандартні апарати, посадка, стеження та рій.
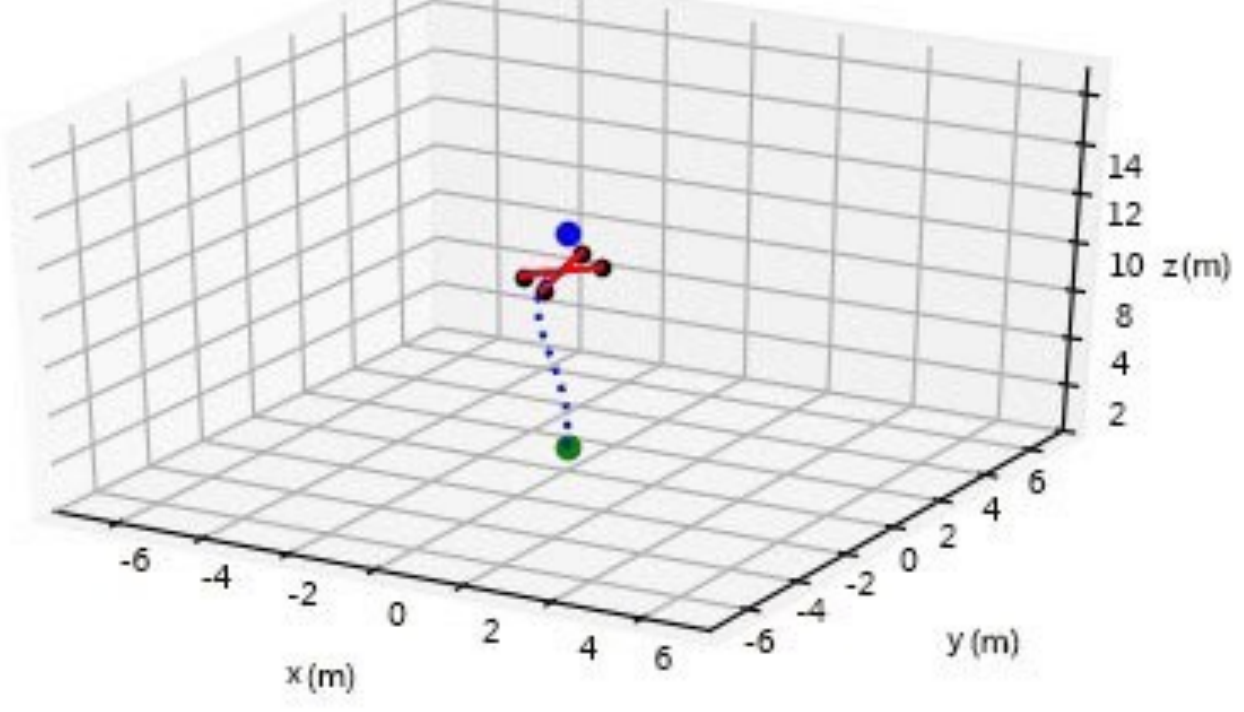
Політ дронів за маршрутними точками методом DDPG у просторі
Керування орієнтацією: дві базові роботи
Складність задачі — у мінливих умовах експлуатації, складній динаміці, вимозі енергоефективності та вразливості до збурень і шумів сенсорів.
- Bøhn та ін. (2019), апарат літакової схеми, PPO. DRL застосовано, щоб урахувати нелінійності динаміки й перехресний зв'язок поздовжнього й бічного каналів. Ціль — задана швидкість польоту та кути крену й тангажа. Обмеження прямо назване авторами: усі результати отримано в симуляції.
- Koch та ін. (2019), квадрокоптер, порівняння DDPG, TRPO, PPO і ПІД. Метрики класичні для теорії керування: час наростання, перерегулювання, помилка, стійкість. Висновок: PPO найкращий із перевірених, перевершив TRPO і водночас простіший у реалізації.
Політ автономного апарата загалом потребує двох контурів: внутрішній відповідає за орієнтацію й швидкість, зовнішній — за траєкторію, зв'язок і керування групою.
Нестандартні апарати
- Xu J. та ін. (2019), гібридний апарат, PPO. Гібридна схема поєднує ротори з нерухомим крилом: вертикальний зліт, велика тривалість польоту, енергоефективність. Модель має 13 змінних стану, чотири з них — інтегральні доданки похибки. Винагорода зібрана з енергоефективності, стійкості польоту, інтегральної похибки, похибки стеження за швидкістю й похибки орієнтації.
- Xu D. та ін. (2019), біонічний морфінговий апарат, DDPG. Ідея морфінгу запозичена в птахів, які змінюють форму крил під режим польоту. DDPG обрано тому, що задача вимагає неперервності просторів станів і дій. Керування деформацією належить до внутрішнього контуру.
- Wan та ін. (2020), Robust-DDPG. Перевершив звичайний DDPG за швидкістю збіжності, стабільністю й ефективністю завдяки затриманому навчанню та іншим прийомам стабілізації.
Посадка за маркером і стеження за людиною
- Polvara та ін. (2018), DQN → double DQN. Мета — точна автономна посадка на платформу з візуальними маркерами за зображенням із камери низької якості. Місію розділено на дві підзадачі, кожна з власною мережею. Головна проблема — розрідженість винагороди; розв'язок — секціонований буфер відтворення, у якому досвід категоризовано за типом, щоб рідкісні успішні посадки не тонули у вибірці. Один із перших прикладів end-to-end керування посадкою за зображенням.
- Passalis, Tefas (2019), DDPG. Місія — знімати людину спереду, утримуючи обличчя в кадрі. DQN тут не підходить: він нестійкий у неперервних задачах із великими наборами сирих піксельних даних. Результат перевершує і класичне ПІД-керування, і відомі двовимірні алгоритми розпізнавання облич.
Керування роєм: три роботи
- Tožička та ін. (2018), DCNNP, 5 апаратів. Глибока згорткова мережа-політика керує п'ятьма БПЛА; місії — шикуватися в задану форму й захищати ділянку. Схема — централізоване навчання й централізоване виконання: один апарат планує поведінку для всіх. DCNNP значно перевершив випадкову політику, але від периметрової евристики в захисті ділянки відрізнявся мало.
- Liu та ін. (2018), DRL-EC³. Енергоефективне керування покриттям і зв'язністю на базі DDPG: актор і критик — двошарові мережі 400 і 300 нейронів. Винагорода складена з покриття, індексу справедливості покриття, енергоспоживання й неперервності зв'язку. Перевершує і випадкову, і жадібну політики, перевага зберігається зі зростанням кількості апаратів.
- Yang та ін. (2019), децентралізоване багатоагентне навчання. Задача — розподіл каналів зв'язку, щоб апарати могли обмінюватися даними про керувальні завдання.
Зверніть увагу на перший рядок: централізоване виконання — це не рій за означенням Модуля 01. Справжня децентралізація з'явиться в Модулі 08.
Частина 4 · Порівняння алгоритмів у польоті
Пряме порівняння on-policy методів (SARSA, PPO, TRPO) з off-policy (Q-learning, DQN, DDPG) за перехідною характеристикою по кожній команді орієнтації. Цільова кутова швидкість —
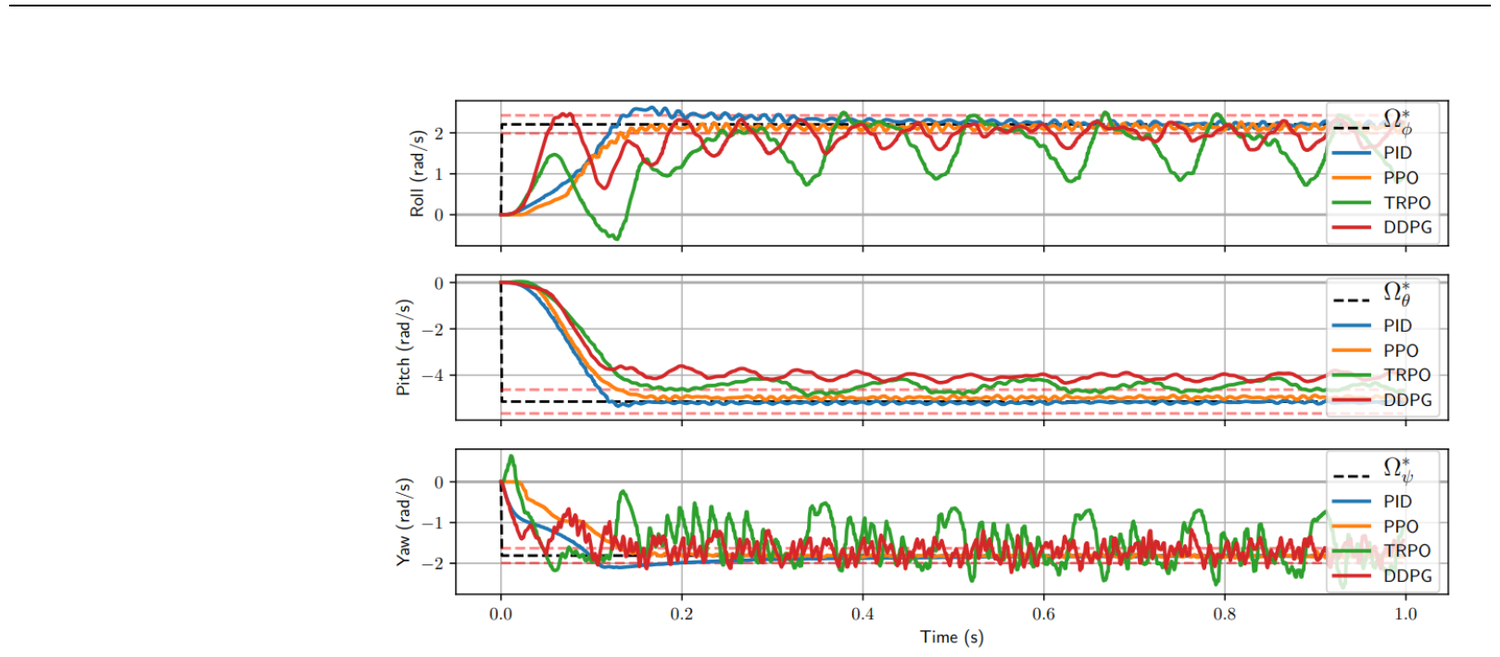
Перехідна характеристика навчених політик проти ПІД-регулятора
Усі алгоритми виходять на усталений режим, проте TRPO і DDPG дають екстремальні коливання по каналах крену й рискання, що в реальному польоті означало б нестійкість. За величиною помилки найточнішим регулятором орієнтації виявився PPO — саме тому PPO беруть і для навчання гоночних апаратів.
Чотири задачі, три алгоритми
Задачі розв'язувалися приблизно за 5000 ітерацій політики з батчем 256 кроків.
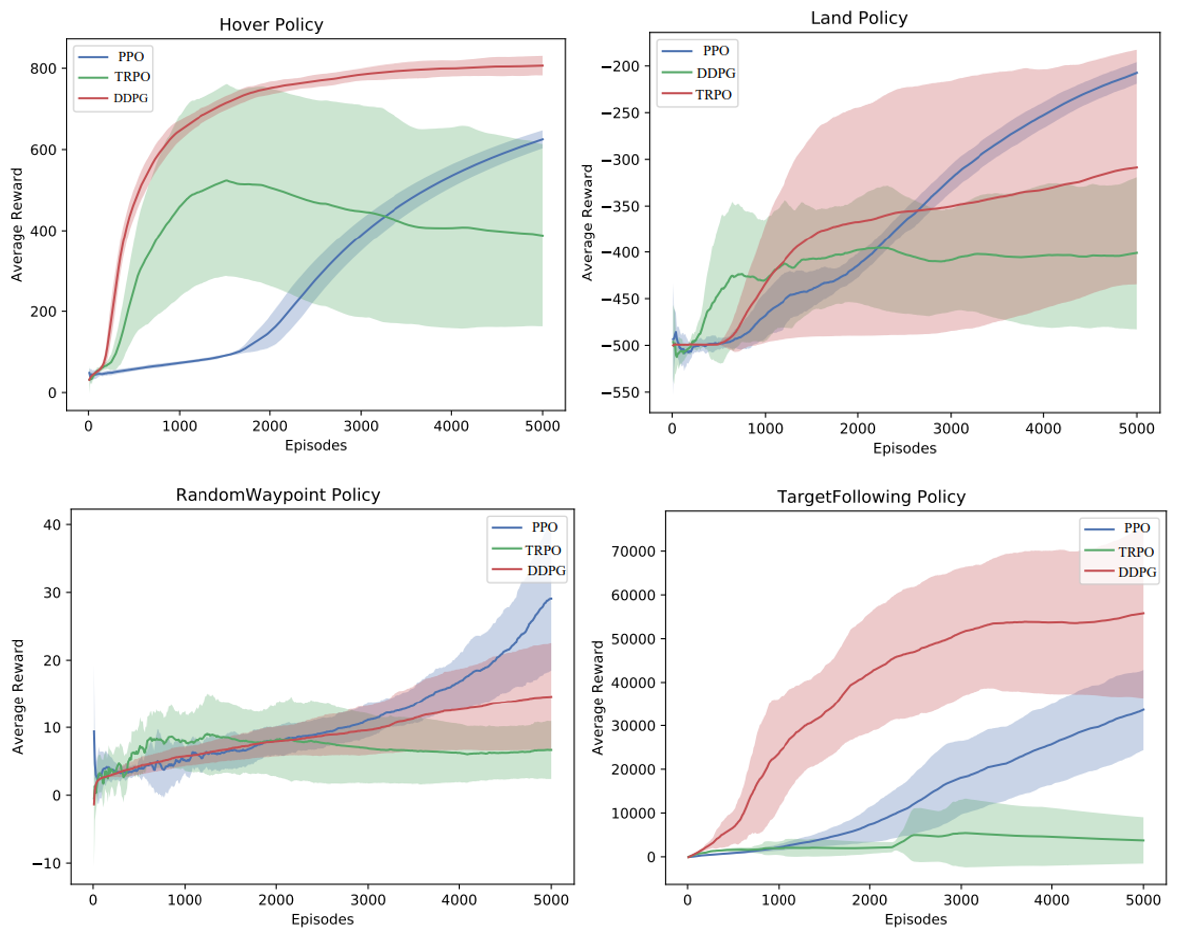
Середня винагорода для задач висіння, посадки, польоту до точки і стеження
| Задача | Кращий алгоритм | Характер результату |
|---|---|---|
| Посадка | PPO | найпослідовніший результат |
| Зависання | DDPG | найплавніший політ |
| Випадкові waypoint | PPO | найплавніша навігація між точками |
| Стеження за ціллю | DDPG | найвища середня винагорода |
Загальний висновок серії: глибокий RL здатний генерувати адаптивні траєкторії, близькі до оптимальних за часом. Але зверніть увагу, що переможець змінюється від задачі до задачі — універсального алгоритму немає.
Частина 5 · Sim-to-real
Політика, навчена в симуляторі, стикається з реальністю, що відрізняється в дрібницях: маса інша після встановлення навантаження, коефіцієнт тяги відрізняється від паспортного, канал керування має затримку, гіроскоп шумить, а вітер узагалі не був змодельований.
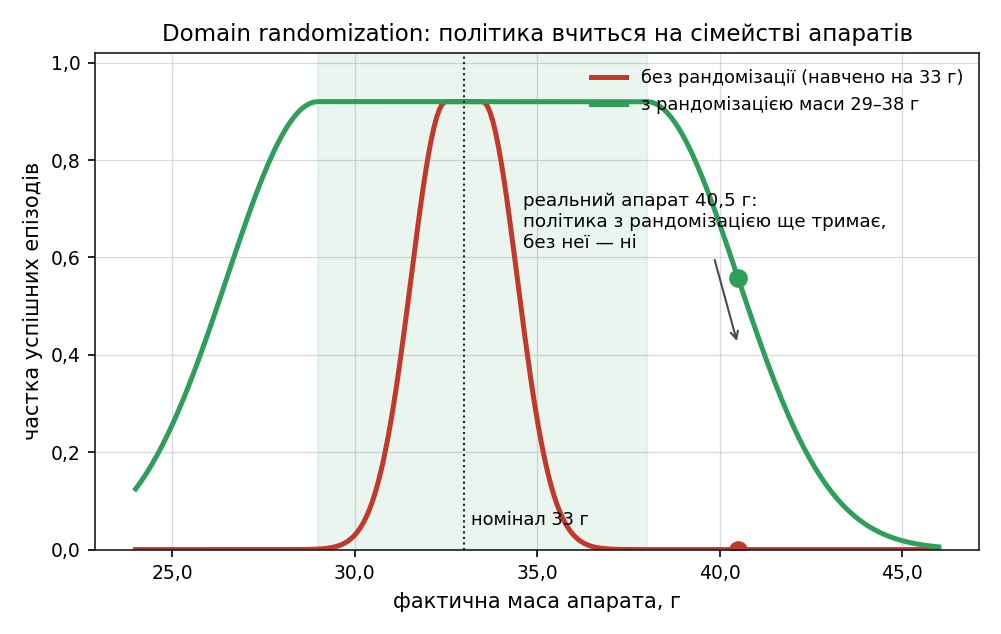
Вплив доменної рандомізації на перенесення до важчого апарата
Основний інструмент — доменна рандомізація: параметри симулятора випадково змінюють від епізоду до епізоду, щоб політика навчилася працювати на цілому сімействі апаратів, а не на одному ідеальному. Реальність тоді стає ще одним екземпляром цього сімейства.
Що саме рандомізують для Crazyflie
| Параметр | Діапазон | Навіщо саме це |
|---|---|---|
| Маса апарата | 29 – 38 г | різні акумулятори, різні комплекти плат |
| Коефіцієнт тяги мотора | ±15 % від номіналу | мотори зношуються нерівномірно |
| Розкид між моторами | до 8 % один від одного | після падінь дрон стає несиметричним |
| Затримка мотора | 15 – 45 мс | реальні колекторні мотори інертні |
| Затримка керування | 5 – 20 мс | радіо, черги, фільтр |
| Дрейф нуля гіроскопа | ±0,05 рад/с | BMI088 пливе при нагріванні |
| Шум оцінки позиції | 2 см — оптичний захват, 10 см — UWB | |
| Зовнішнє збурення | до 0,15 Н випадково | протяг, обдув від сусіда |
Емпіричне правило: якщо політика тримається на всьому діапазоні рандомізації в симуляторі, реальний дрон опиняється десь усередині цього діапазону — і летить без донавчання.
Порядок перенесення на борт
1Ідентифікація маси й тяги на стенді
2Навчання з доменною рандомізацією
3Перевірка поза навчальним діапазоном
4Політ під наглядом із ручним перехопленням
Обов'язковий елемент, який часто пропускають, — резервний класичний регулятор, на який система перемикається за виходом стану за допустимі межі. Навчена політика не має формальних гарантій стійкості; регулятор із Модуля 02 їх має.
Для апаратів більших за Crazyflie діапазони ширші: маса й момент інерції ±20 %, коефіцієнти тяги ±15 %, затримка каналу 5–30 мс, вітер 0–5 м/с поривами, стала часу приводу 0,05–0,12 с.
Обмеження, які визнають самі автори методів
- Перенесення з приміщення на відкритий простір. Моделі планування шляху, що добре працюють у приміщенні, не переносяться назовні без керування висотою; додавання висоти змінює простір дій.
- Постановка важить більше за алгоритм. Заміна одного алгоритму іншим у межах тієї самої постановки часто зводиться до зміни функції втрат.
- Погодні умови поза моделями. Вітер, дощ, пил здебільшого не входять у моделі й мають розглядатися як системні збурення з оцінкою невизначеності.
- Навігація в невідомому середовищі зі змінними перешкодами лишається відкритою задачею.
- Брак реальних польотних випробувань. Головне обмеження всієї галузі: переважна більшість результатів отримана в симуляції; реальних польотів, особливо просто неба й за змінних умов, бракує.
Висновки
- Вибір родини алгоритмів визначає тип простору дій: дискретні команди — DQN і похідні, неперервне керування — PPO, DDPG, TD3, SAC.
- Постановка задачі важить більше за алгоритм. Вектор на ціль замість абсолютних координат і матриця повороту замість кутів Ейлера впливають на результат сильніше, ніж заміна PPO на TRPO.
- Політика керує тягою й кутовими швидкостями, а не моторами: внутрішній контур 500 Гц прощає їй неточність і робить перенесення на залізо можливим.
- Ваги винагороди підбирають за порядком величини, а масштаб термінального штрафу звіряють зі збитком за решту епізоду: поки політика погана, кожен крок коштує −0,57, за 400 кроків набігає 228, і штраф −10 навчає падати.
- У прямому порівнянні на керуванні орієнтацією PPO виявився найточнішим, TRPO і DDPG дали коливання, неприйнятні в реальному польоті. Але переможець змінюється від задачі до задачі.
- Доменна рандомізація перетворює реальність на ще один екземпляр навченого сімейства; резервний класичний регулятор лишається обов'язковим.
Перехід до Модуля 07
Модуль 06 працював з одним апаратом. Роботи з керування роєм, розглянуті в частині 3, використовували централізоване виконання — тобто за означенням Модуля 01 це ще не рій.
Модуль 07 · Багатоагентний градієнт політики з'єднує механіку PPO цього модуля з багатоагентними моделями Модуля 05. Там з'ясується, що прямий перенос одноагентного алгоритму на рій працює, але гірше, ніж міг би, — і що з цим роблять централізовані критики, контрфактична базова лінія й правильна робота з вибором рівноваги.
Література та ресурси
- Azar A. T. та ін. Drone Deep Reinforcement Learning: A Review. Electronics, 2021, 10(9), 999. DOI 10.3390/electronics10090999
- Koch W., Mancuso R., West R., Bestavros A. Reinforcement Learning for UAV Attitude Control. ACM TCPS, 2019, 3(2). arXiv:1804.04154
- Bøhn E. та ін. Deep Reinforcement Learning Attitude Control of Fixed-Wing UAVs Using Proximal Policy Optimization. ICUAS, 2019. arXiv:1911.05478
- Song Y., Steinweg M., Kaufmann E., Scaramuzza D. Autonomous Drone Racing with Deep Reinforcement Learning. IROS, 2021. arXiv:2103.08624
- Polvara R. та ін. Toward End-to-End Control for UAV Autonomous Landing via Deep Reinforcement Learning. ICUAS, 2018.
- Liu C. H. та ін. Energy-Efficient UAV Control for Effective and Fair Communication Coverage: A Deep Reinforcement Learning Approach. IEEE JSAC, 2018, 36(9), 2059–2070.
- Lillicrap T. та ін. Continuous Control with Deep Reinforcement Learning (DDPG). arXiv:1509.02971
- Fujimoto S., van Hoof H., Meger D. Addressing Function Approximation Error in Actor-Critic Methods (TD3). arXiv:1802.09477
- Симулятори й стеки: PX4 · Gazebo · AirSim · Flightmare · gym-pybullet-drones