Тема
Модуль 04 · Навчання з підкріпленням: основи
Одноагентне навчання з підкріпленням як апарат синтезу керування через взаємодію: від постановки задачі прийняття рішень до глибоких алгоритмів навчання політики.
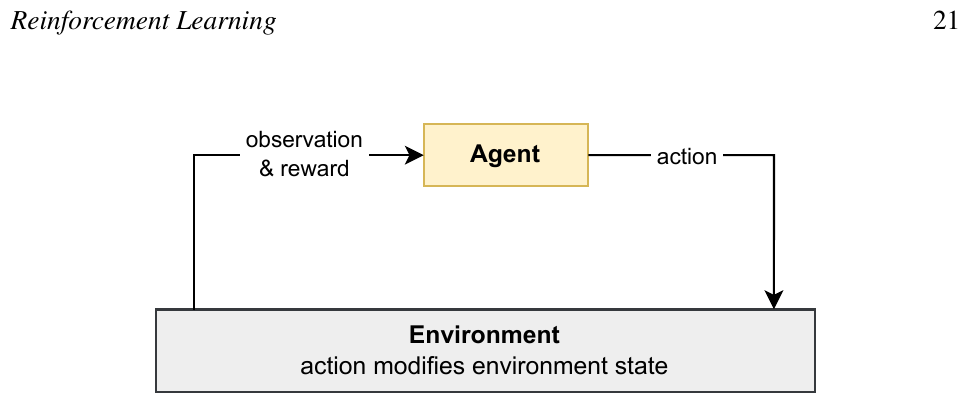
Базовий цикл навчання з підкріпленням: агент, середовище, винагорода
Зміст лекції
Лекція будує апарат знизу вгору й перевіряє кожен крок на одній наскрізній задачі — навчити нанодрон Crazyflie 2.1 висіти на висоті один метр.
| Частина | Про що |
|---|---|
| 1. Постановка задачі | агент, середовище, MDP, цінності, рівняння Беллмана |
| 2. Наскрізний приклад | Crazyflie 2.1: стан, дія, винагорода, крива навчання |
| 3. Табличні методи | динамічне програмування, Q-learning, on-policy проти off-policy |
| 4. Глибокі методи | DQN, policy gradient, actor–critic, PPO |
| 5. Оцінювання | як чесно порівнювати алгоритми |
Зміна припущень порівняно з модулями 02–03: динаміка переходів і функція винагороди агентові невідомі. Відомими вважають лише простір станів і простір дій.
Результати навчання
Після лекції ви зможете:
- записати марковський процес прийняття рішень як кортеж і пояснити властивість Маркова;
- пояснити вплив коефіцієнта дисконтування на оптимальну поведінку;
- записати рівняння Беллмана й отримати з
оптимальну політику; - спроєктувати вектор спостережень, дію та функцію винагороди для конкретної задачі БПЛА;
- виконати вручну кілька оновлень Q-learning і показати, як цінність поширюється від цілі;
- пояснити різницю між on-policy та off-policy й обґрунтувати вибір під задачу;
- назвати, що саме ламається в наївному глибокому Q-навчанні і як це усувають DQN і PPO;
- побудувати коректний протокол порівняння алгоритмів.
Частина 1 · Постановка задачі
Навчання з підкріпленням розв'язує послідовні задачі прийняття рішень: агент діє в середовищі протягом багатьох кроків, щоб досягти мети. Схема цього циклу — на титульному рисунку модуля.
Що таке навчання з підкріпленням
На кожному кроці агент отримує спостереження, обирає дію і отримує скалярну винагороду. Розв'язком задачі є оптимальна політика (policy) — правило вибору дії в кожному стані, яке максимізує накопичену винагороду. Один прогін від початкового стану до термінального називають епізодом.
| Складник задачі | Що задає | Типові варіанти |
|---|---|---|
| Модель прийняття рішень | механіку взаємодії агента із середовищем | MDP, POMDP, багаторукий бандит |
| Ціль навчання | властивість оптимальної політики | максимум очікуваної дисконтованої віддачі |
RL не є навчанням з учителем: винагорода не повідомляє, яку дію треба було обрати, вона лише оцінює наслідок. Не є воно й навчанням без учителя, бо винагорода — зовнішній сигнал, з якого виводиться оптимальна поведінка.
Дія змінює середовище: наступні дані, які побачить агент, залежать від того, як він поводився раніше. Саме цим RL відрізняється від задач із фіксованою вибіркою.
Дослідження проти використання
Центральна проблема навчання — баланс exploration–exploitation. Дослідження нових дій може виявити кращу поведінку, але коштує втраченої винагороди тут і зараз.
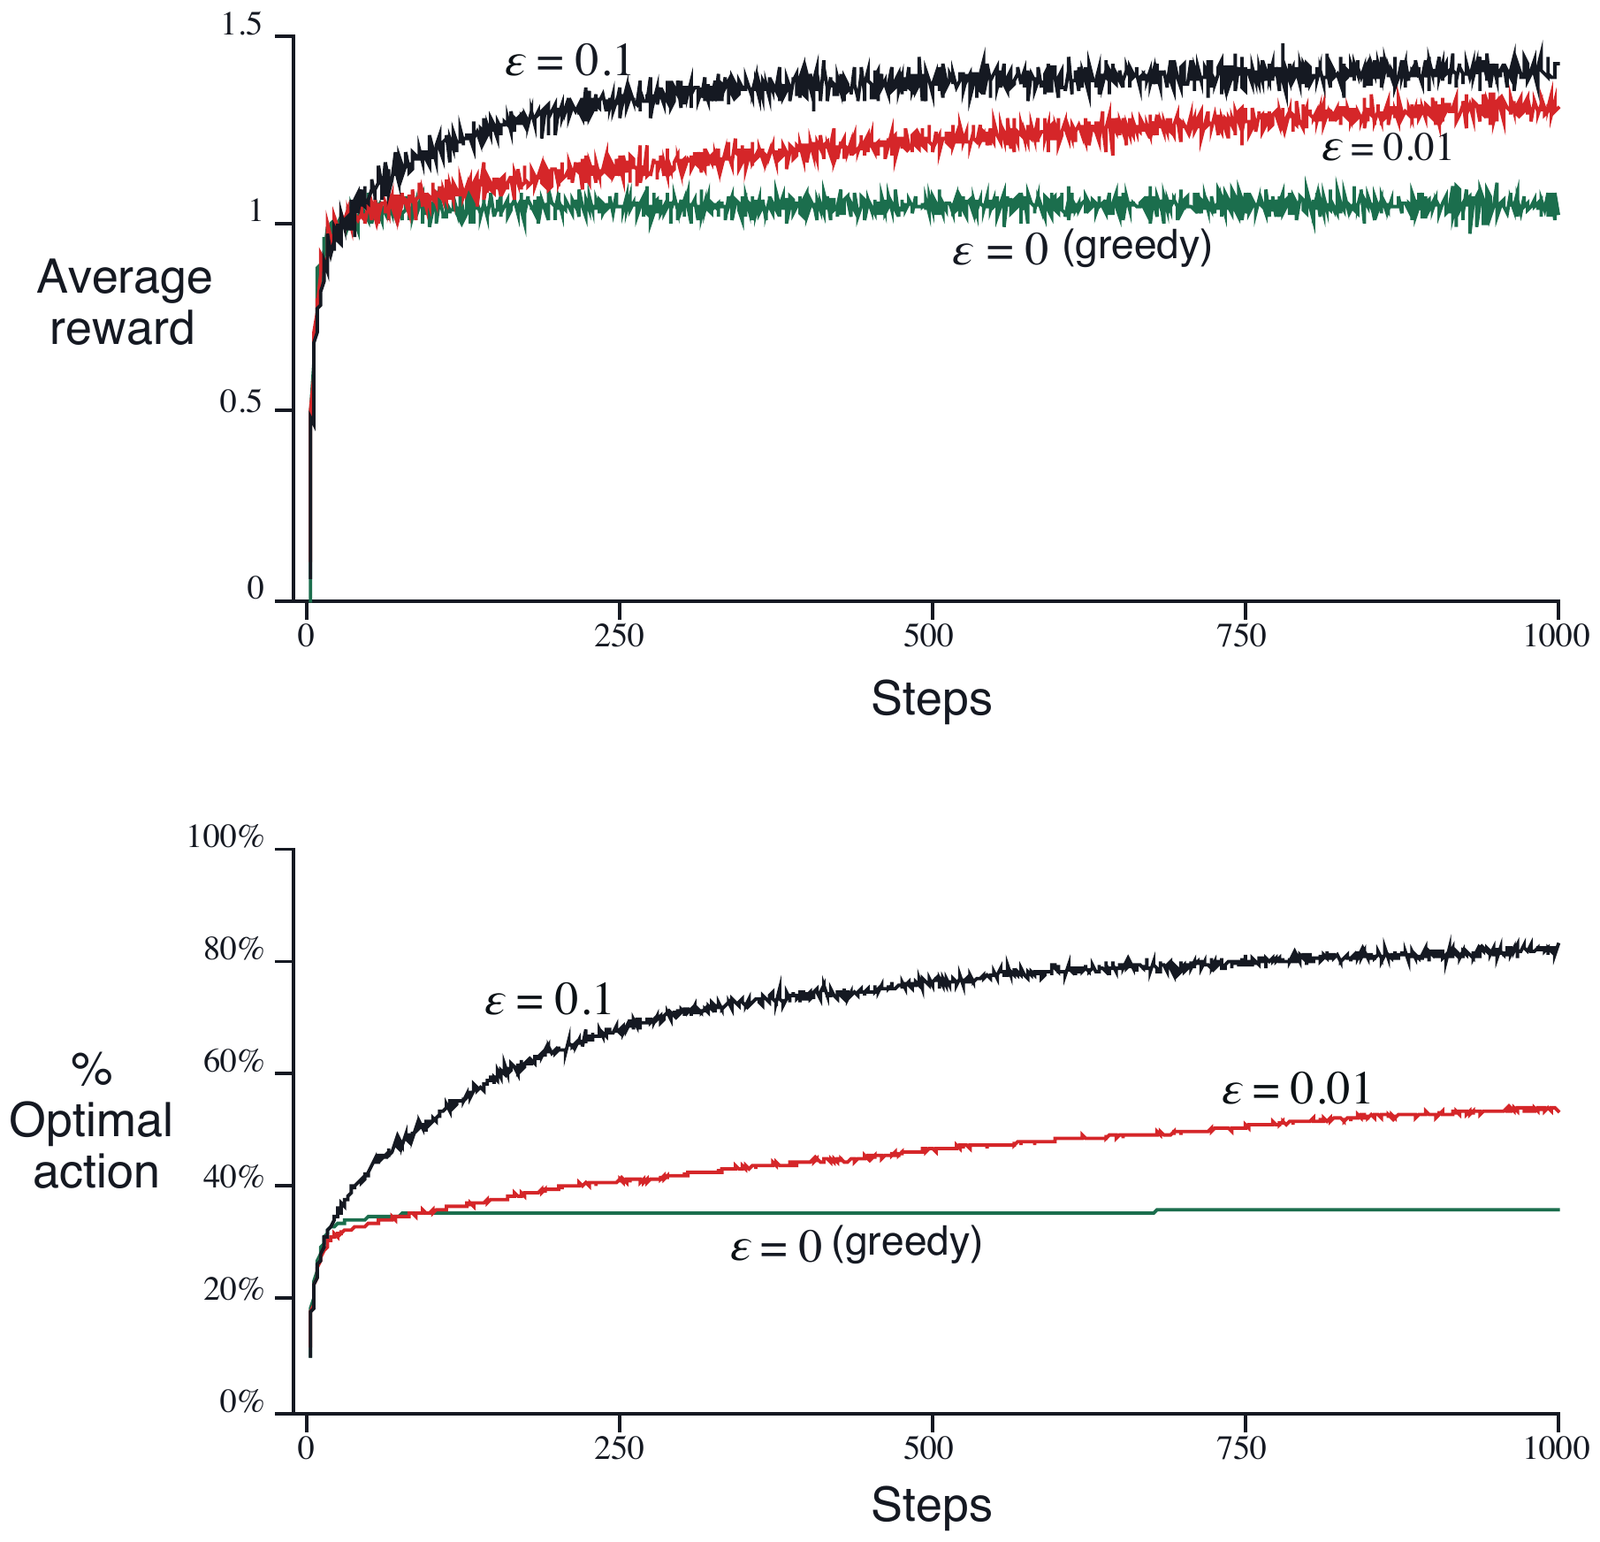
Якість ε-жадібної стратегії за різних темпів дослідження
Найпростіший робочий механізм —
| Поведінка агента | Коли доречно | |
|---|---|---|
| 1,0 | повністю випадкові дії | перші тисячі кроків |
| 0,3 | часте відхилення від жадібної дії | середина навчання |
| 0,05 | майже завжди жадібна дія | кінець навчання |
| 0 | детермінована жадібна політика | оцінювання вивченої політики |
Дослідження проти використання
П'ять важелів, агент не знає їхньої якості. Ймовірність ε він пробує випадковий, інакше бере найкращий за поточною оцінкою. Криві усереднені по 200 прогонах.
2.11середня винагорода на останніх 100 кроках
81 %часу на найкращому важелі
9жаль за 100 кроків
Поставте ε = 0: агент чіпляється за перший важіль, який випадково дав добру винагороду, і більше нічого не пробує — крива застигає нижче межі. Поставте ε = 0,5: половину кроків він витрачає на явно гірші важелі й теж програє. Оптимум лежить між ними, і саме тому в лекції ε зменшують із часом: спершу дослідження, потім використання.
Марковський процес прийняття рішень
MDP — стандартна формальна модель середовища. Він задається кортежем із п'яти елементів: що агент бачить, що може зробити, як середовище реагує, скільки за це платять і з чого все починається.
| Позначення | Значення |
|---|---|
| множина станів, серед них термінальні | |
| множина дій, доступних агентові | |
| ймовірність опинитися в | |
| винагорода за цей перехід | |
| розподіл початкових станів епізоду |
Властивість Маркова: для передбачення майбутнього досить поточного стану й дії — уся попередня історія не додає інформації.
Практичний наслідок для інженера: якщо стан не містить потрібної інформації (задано координату, але не швидкість), властивість Маркова порушується, і жоден алгоритм цього не компенсує. Проєктування простору станів — частина постановки задачі, а не деталь реалізації.
Очікувана дисконтована віддача
Ціль навчання формалізують як математичне сподівання дисконтованої суми винагород.
| Позначення | Значення |
|---|---|
| винагорода, отримана на кроці | |
| коефіцієнт дисконтування | |
| усереднення за початковим станом, діями політики й переходами |
Коефіцієнт
Числова ілюстрація: винагорода
Функції цінності та рівняння Беллмана
Цінність стану
| Позначення | Значення |
|---|---|
| усереднення за наступними станами згідно з динамікою | |
| припущення, що далі агент діятиме оптимально | |
| дисконт цінності наступного кроку |
Маючи
Оптимальна функція цінності єдина, а оптимальних політик може бути кілька; серед них завжди є детермінована.
Марсохід: MDP, який можна порахувати вручну
Марсохід стоїть на старті. Праворуч — короткий ризикований шлях до бази, ліворуч — довший, але надійніший маршрут через дві точки відбору проб.
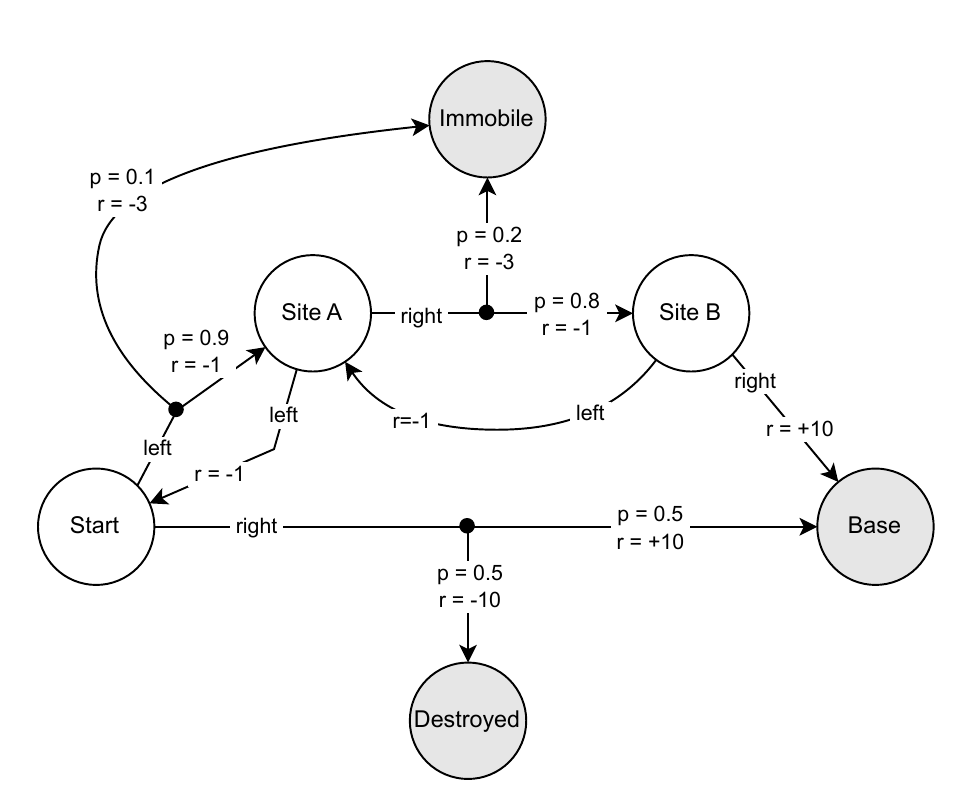
MDP марсохода: стани, ймовірності переходів і винагороди
Прибуття на базу дає
Той самий апарат, інша ціль навчання
| Величина при | Старт | Точка A | Точка B |
|---|---|---|---|
| Цінність рівноймовірної політики | −0,44 | 0,37 | 4,67 |
| Оптимальна цінність | 4,10 | 6,20 | 10,00 |
Оптимальна політика при
При
Частина 2 · Наскрізний приклад: Crazyflie 2.1
Досі стан, дія й винагорода жили в умовних задачах. Далі ті самі поняття прикладено до реального нанодрона, який учиться висіти на висоті один метр. Ці числа наскрізні — вони повертатимуться далі в курсі.
| Характеристика | Значення |
|---|---|
| Злітна маса | 27 г — модель CF2X, на якій ідуть лабораторні; із двома платами розширення виходить ≈ 33 г |
| Габарити | 92 × 92 × 29 мм |
| Максимальна тяга (4 мотори) | 60,8 г-сили = 0,596 Н, тобто 2,25 ваги |
| Тяга при висінні | 27 / 60,8 = 0,44 від максимуму |
| Головний мікроконтролер | STM32F405, Cortex-M4, 168 МГц, 192 КБ ОЗП |
| Час польоту | близько 6 хв |
Запас у 1,75 раза й визначає, наскільки різко апарат може маневрувати. Документація: Bitcraze Crazyflie 2.1.
Сенсори: що апарат насправді відчуває
Дрон не бачить своєї висоти напряму — він її обчислює з кількох сирих вимірювань.
| Сенсор | Що вимірює | Частота | Точність |
|---|---|---|---|
| BMI088 гіроскоп | кутова швидкість по 3 осях | 1000 Гц | до ±34 рад/с, є дрейф нуля |
| BMI088 акселерометр | лінійне прискорення | 1000 Гц | шумний, потребує фільтрації |
| BMP388 барометр | тиск → висота | 50 Гц | дрейф десятки см у приміщенні |
| VL53L1x (Flow deck) | відстань до підлоги | 40 Гц | до 4 м, похибка одиниці мм |
| PMW3901 (Flow deck) | оптичний потік → швидкість | 100 Гц | від 80 мм над підлогою |
| DWM1000 (Loco deck, UWB) | відстані до якорів | ~500 вим./с | ±10 см на дальності 10 м |
Жоден сенсор не видає позицію. Позицію збирає фільтр Калмана з Модуля 02 — і саме його вихід потрапляє в політику.
1Інерціальні сенсори 1000 Гц
2Далекомір і оптичний потік
3Розширений фільтр Калмана 100 Гц
4Оцінка стану для політики
Спостереження, дія та винагорода
Для задачі висіння беремо мінімальний вектор — дев'ять чисел. Політика працює не з картинкою світу, а з коротким вектором.
| Компонент спостереження | Розмір | Одиниці | Приклад |
|---|---|---|---|
| Помилка висоти | 1 | м | −0,130 |
| Вертикальна швидкість | 1 | м/с | −0,12 |
| Горизонтальні швидкості | 2 | м/с | +0,04, −0,02 |
| Крен і тангаж | 2 | рад | +0,03, −0,01 |
| Кутові швидкості | 3 | рад/с | +0,11, −0,07, +0,02 |
| Разом | 9 |
Політика керує одним числом — нормованою сумарною тягою
Читаємо приклад уголос: апарат на висоті 0,87 м, на 13 см нижче цілі, повільно опускається зі швидкістю 12 см/с. Політика має додати тяги.
Винагорода: чим ближче до метра і чим спокійніше, тим краще
Винагорода нараховується на кожному кроці, 50 разів на секунду, і політика вчиться максимізувати їхню суму за епізод.
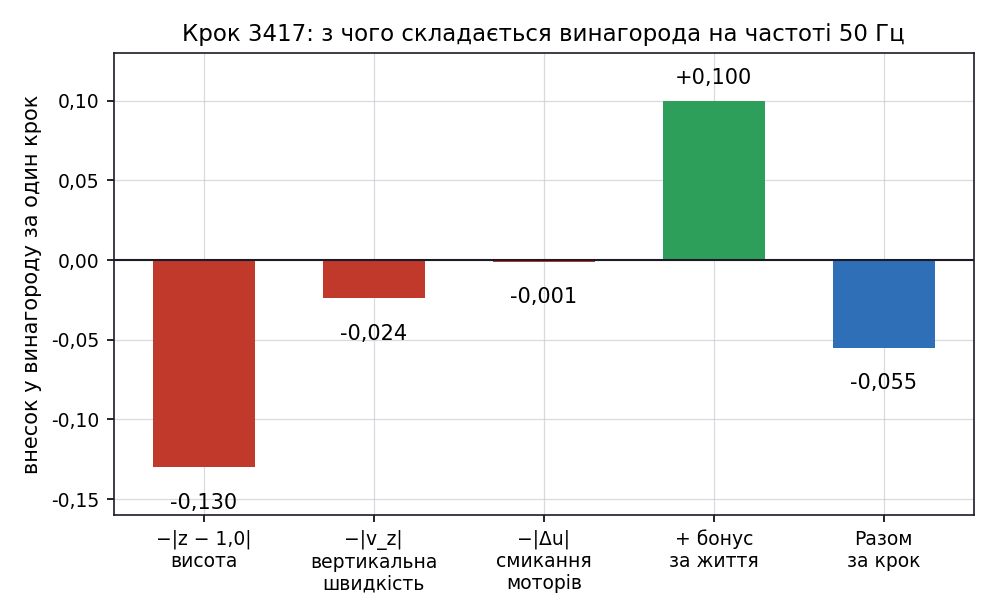
Розклад винагороди на доданки для одного кроку керування
| Складова | Навіщо | Вага | Внесок |
|---|---|---|---|
| тримати задану висоту | 1,00 | −0,130 | |
| не пружинити вгору-вниз | 0,20 | −0,024 | |
| не смикати мотори | 0,05 | −0,001 | |
| бонус за життя | не вимикати мотори заради швидкого кінця | 0,10 | +0,100 |
| Разом за крок | −0,055 |
Бонус за життя виглядає дрібницею, але без нього виникає класична пастка: якщо всі складові від'ємні, агентові вигідно швидко впасти й обірвати епізод. Ідеальне висіння дало б +0,10 за крок, тобто +5,0 за секунду.
Один крок цілком, як арифметика
Крок номер 3417. Крок триває 0,02 с, маса 27 г = 0,027 кг, максимальна тяга 60,8 г-сили = 0,596 Н.
| Етап | Обчислення | Результат |
|---|---|---|
| 1. Стан до кроку | ||
| 2. Спостереження | −0,130 | |
| 3. Політика видає | нейромережа → | |
| 4. Фізична тяга | 0,369 Н | |
| 5. Сила ваги | 0,265 Н | |
| 6. Чиста сила | +0,104 Н | |
| 7. Прискорення | +3,88 м/с² | |
| 8. Нова швидкість | −0,042 м/с | |
| 9. Нова висота | 0,868 м | |
| 10. Винагорода | −0,042 |
Висота ще трохи впала через інерцію, але швидкість падіння зменшилася з 12 до 4 см/с, і винагорода зросла з −0,055 до −0,042. Саме такі мікроскопічні покращення, повторені мільйони разів, і є навчанням.
Що видно на кривій навчання
Навчання не є монотонним покращенням. Воно має характерні фази, і корисно розпізнавати, яка фаза триває зараз, щоб не зупинити навчання зарано. На осі — нормована віддача: сума винагород, поділена на тривалість епізоду в секундах, у тих самих одиницях, що й у лабораторній роботі 2. Ідеальному висінню відповідає +5,0.
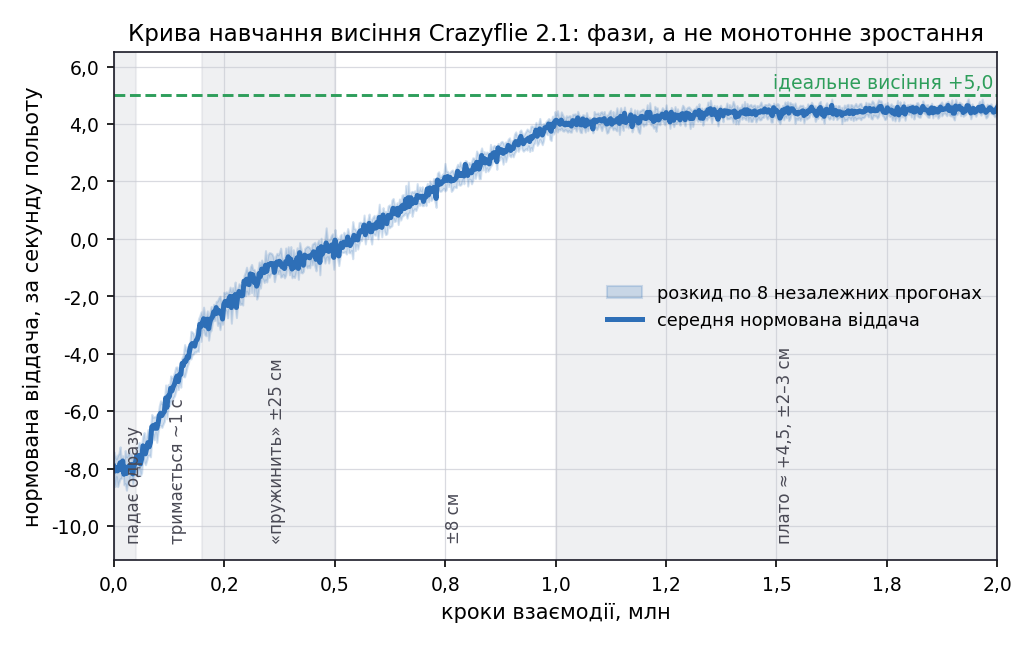
Крива навчання висіння Crazyflie з позначеними фазами
| Кроки | Що робить дрон | Нормована віддача |
|---|---|---|
| 0 – 50 тис. | падає одразу, мотори на випадковій потужності | винагорода ≈ −8, епізоди по 0,5 с |
| 50 – 200 тис. | тримається близько 1 с | винагорода росте до −3 |
| 200 – 500 тис. | висить, але пружинить на ±25 см | винагорода −1,0 … −0,4 |
| 500 тис. – 1 млн | тримає ±8 см | винагорода +2 … +4, розкид падає |
| 1 – 2 млн | тримає ±2–3 см | плато ≈ +4,5 проти ідеальних +5,0 |
Дві найчастіші аварії навчання: крива застрягає на −8 (агент не знайшов рятівної тяги) і крива красиво росте, але дрон крутиться на місці (агент знайшов, як збирати бонус за життя, не виконуючи задачу).
Частина 3 · Табличні методи
Якщо динаміка середовища відома повністю, оптимальну політику можна обчислити без жодної взаємодії. На практиці цей ідеальний випадок майже не трапляється.
| Умова | Динамічне програмування | Навчання з підкріпленням |
|---|---|---|
| Потрібна модель переходів і винагород | так, повністю | ні |
| Джерело даних | обчислення за моделлю | досвід взаємодії |
| Вартість кроку | перебір усіх станів і дій | одна вибірка досвіду |
| Придатність для БПЛА | лише для спрощених моделей | основний робочий режим |
Причина збіжності динамічного програмування суто математична: оновлення Беллмана стискає відстань між будь-якими двома оцінками цінності у
Q-learning: одна вибірка замість усереднення
Там, де динамічне програмування усереднює за всіма можливими наступними станами, метод часових різниць бере один реально спостережений перехід і рухає оцінку в бік того, що побачив.
| Позначення | Значення |
|---|---|
| один крок досвіду | |
| темп навчання: частка, на яку оцінка зсувається до цілі | |
| оцінка найкращого продовження з наступного стану |
Для термінального наступного стану доданок із
Сітковий світ: два оновлення вручну
Сітка три на три. Агент починає в
Агент опинився в
У наступному епізоді агент зі старту йде праворуч у
Два оновлення — і в таблиці вже видно маршрут до цілі. Цінність поширюється від цільової клітинки назад, по одному кроку за оновлення.
Код: Q-learning на сітці
python
import numpy as np

GAMMA, ALPHA = 0.9, 0.5
GOAL, TRAP = (0, 2), (1, 1)
ACTIONS = [(-1,0), (1,0), (0,-1), (0,1)]        # вгору, вниз, ліворуч, праворуч

def step(s, a):
    dr, dc = ACTIONS[a]
    r, c = s[0] + dr, s[1] + dc
    if not (0 <= r < 3 and 0 <= c < 3):
        r, c = s                                 # стіна: лишаємось на місці
    rew = 10.0 if (r, c) == GOAL else (-5.0 if (r, c) == TRAP else 0.0)
    return (r, c), rew, (r, c) in (GOAL, TRAP)

Q = np.zeros((3, 3, 4))
rng = np.random.default_rng(0)
for ep in range(1, 401):
    s = (0, 0)
    eps = max(0.1, 1 - ep / 200)                 # ε спадає протягом навчання
    for _ in range(40):
        a = rng.integers(4) if rng.random() < eps else int(Q[s].argmax())
        s2, r, done = step(s, a)
        target = r + (0.0 if done else GAMMA * Q[s2].max())
        Q[s][a] += ALPHA * (target - Q[s][a])    # правило Q-learning
        s = s2
if done: breakРезультат коду: цінність поширюється від цілі
text
після   2 епізодів  V(старт)= 0.00  V(1,2)= 5.00  V(2,1)= 0.00
після  20 епізодів  V(старт)= 8.91  V(1,2)= 9.96  V(2,1)= 7.81
після 400 епізодів  V(старт)= 9.00  V(1,2)=10.00  V(2,1)= 8.10

оптимальна дія зі старту: праворуч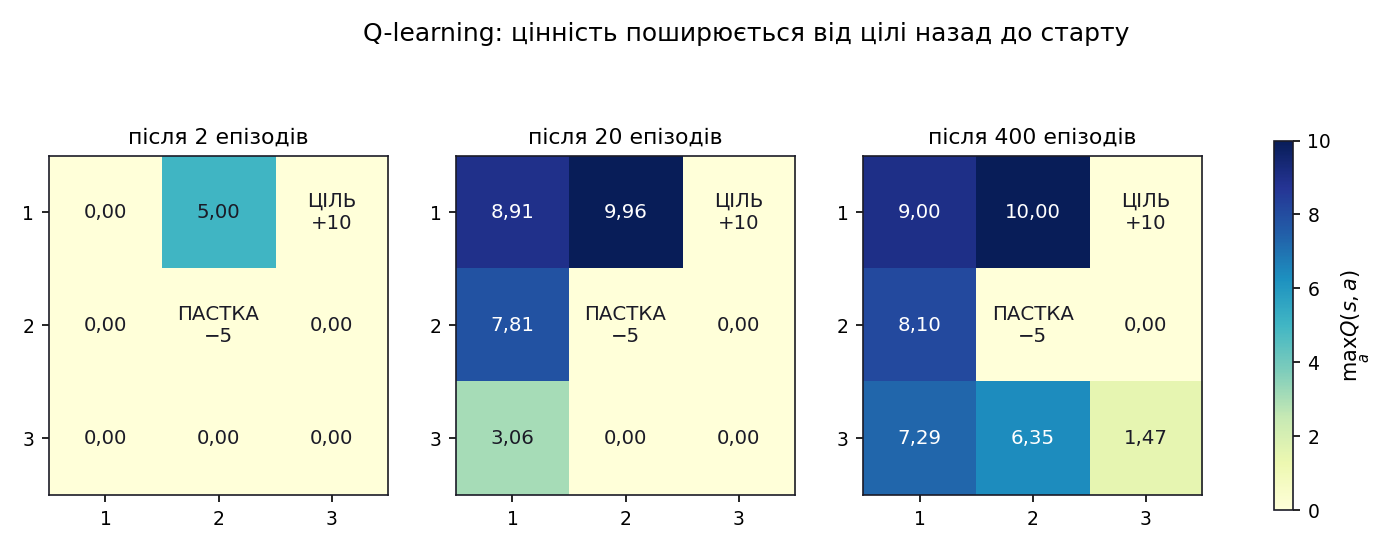
Поширення цінності в Q-навчанні після 2, 20 і 400 епізодів
Після двох епізодів ненульова лише клітинка
Q-навчання: як цінність доходить до старту
Сітка 5×5, старт у лівому верхньому куті, ціль у правому нижньому. γ = 0,95, α = 0,5 — ті самі числа, що в коді лекції.
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
—
0епізодів навчання
0 / 25клітинок із ненульовою цінністю
—цінність стартової клітинки
0.663межа: γ⁸ за 8 кроків до цілі
Натисніть «+1 епізод» кілька разів: цінність з'являється спершу лише в клітинках біля цілі й лише потім доповзає до старту. Це прямий наслідок того, що Q-навчання оновлює одну пару «стан — дія» за крок. Поставте ε = 0 і перезапустіть: агент піде першим знайденим шляхом і більшу частину сітки не побачить узагалі — саме той компроміс дослідження проти використання, про який ішлося на початку модуля.
On-policy проти off-policy
Розрізнення стосується одного питання: чи мусять дані, на яких навчається алгоритм, походити саме від тієї політики, яку ми покращуємо.
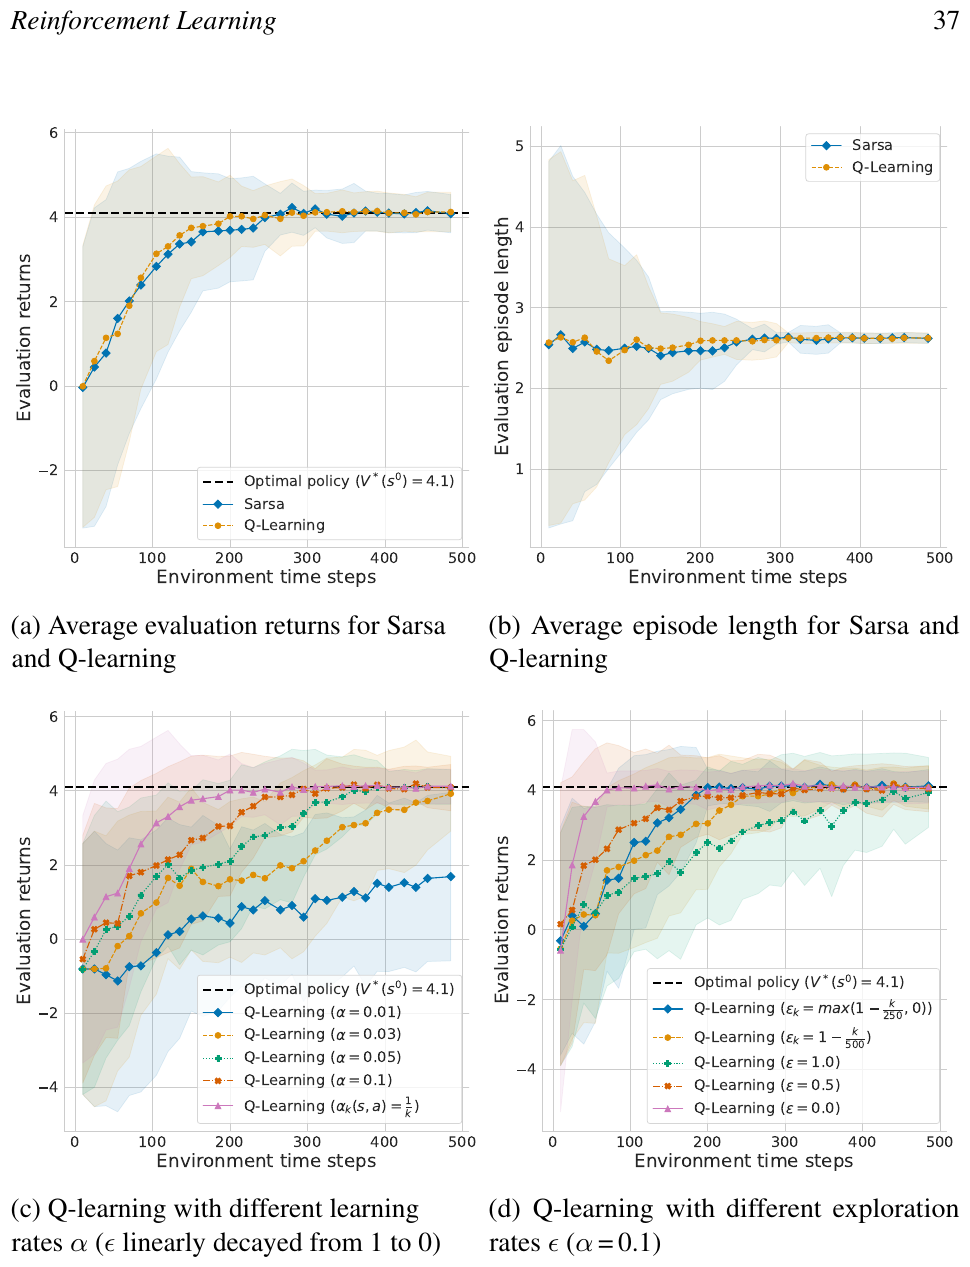
Криві навчання Sarsa та Q-навчання поруч
| Властивість | On-policy (Sarsa, A2C, PPO) | Off-policy (Q-learning, DQN, SAC) |
|---|---|---|
| Джерело даних | лише поточна політика | будь-який досвід, зокрема старий |
| Повторне використання досвіду | обмежене | так, через replay buffer |
| Економність за даними | нижча | вища |
| Стабільність навчання | зазвичай вища | потребує спеціальних механізмів |
Для рою БПЛА розрізнення має прямий інженерний сенс. Реальний політ дорогий і небезпечний, тому кожен епізод хочеться використати багато разів — аргумент за off-policy. У швидкому симуляторі дешевше згенерувати новий rollout, ніж боротися з нестабільністю, — і тоді виграє on-policy.
Частина 4 · Глибокі методи
Табличний підхід зникає, щойно стан перестає бути кількома клітинками. Для БПЛА навіть груба дискретизація десятьма рівнями на кожну з дванадцяти змінних дає близько трильйона комірок.
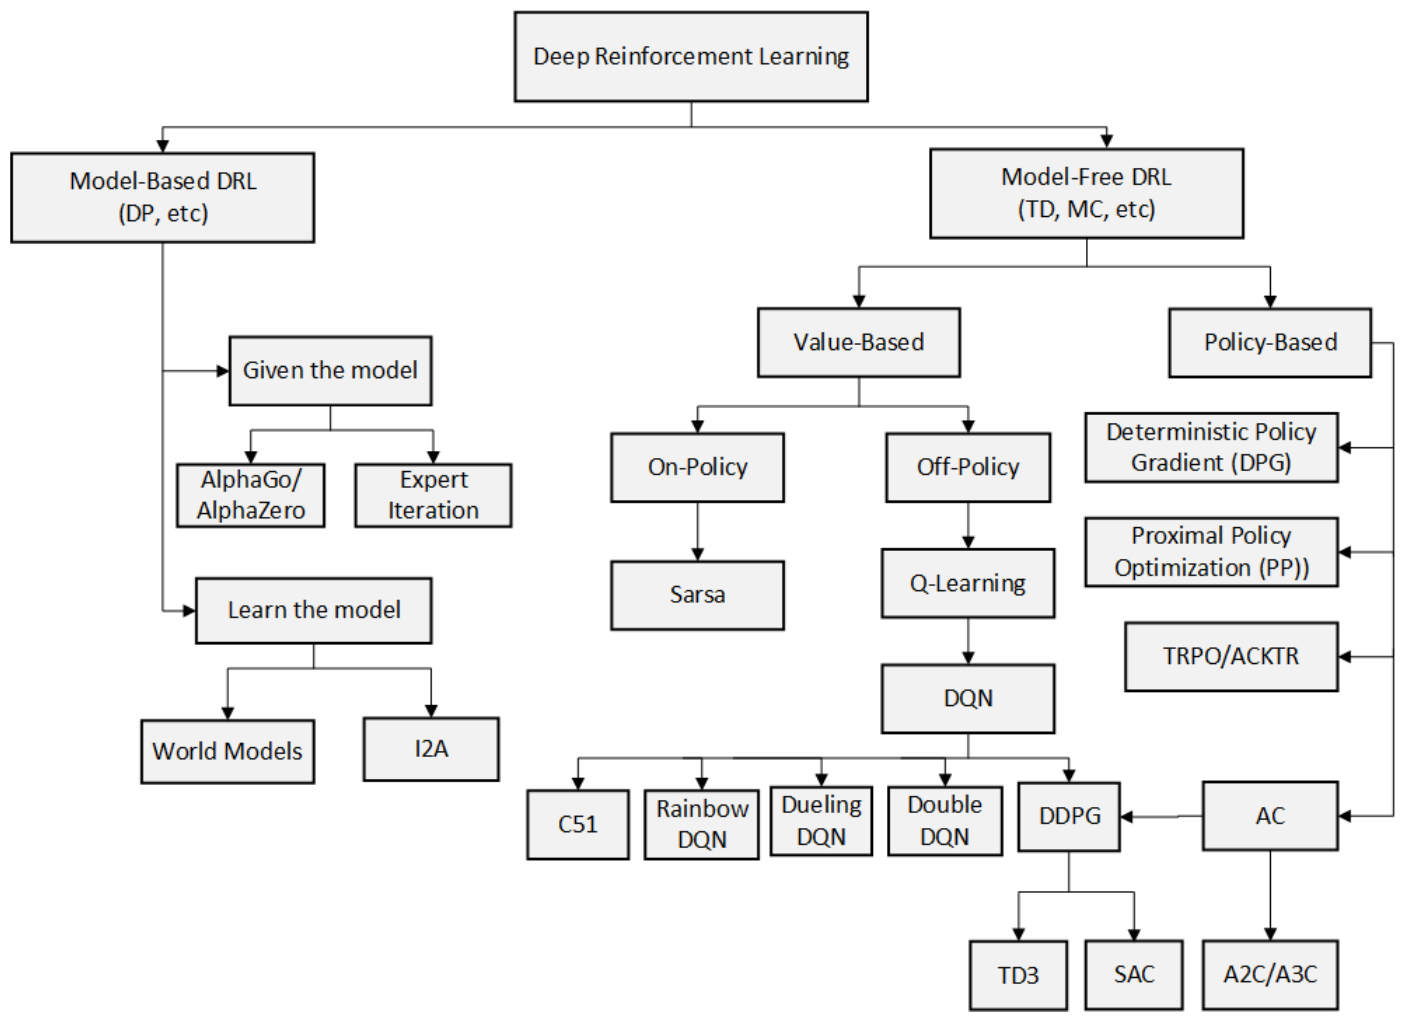
Таксономія алгоритмів глибокого навчання з підкріпленням
Тому таблицю замінюють нейромережею: на вході стан, на виході — оцінка цінності для кожної дискретної дії за один прямий прохід. Звідси й обмеження: така архітектура працює лише зі скінченним набором дій.
Що ламається в наївному глибокому Q-навчанні
Здається, достатньо мінімізувати квадратичну похибку між оцінкою мережі та бутстрепованою ціллю. На практиці пряме перенесення розходиться, і причин дві.
- Рухома ціль. Ціль оновлення обчислюється тією ж мережею, яку ми навчаємо. Оскільки мережа узагальнює, зміна ваг заради одного стану зсуває оцінки для всіх станів одразу — агент женеться за власною тінню.
- Корельовані вибірки. Послідовні кроки одного епізоду дуже схожі. Мережа перенавчається на найсвіжішому досвіді й забуває раніше вивчене — катастрофічне забування.
Обидві проблеми загострює смертельна тріада: одночасна присутність off-policy навчання, апроксимації функції та бутстрепованих цілей. Прибрати будь-який складник не можна — треба компенсувати їхню взаємодію.
DQN: дві опори стабільності
Target network — заморожена копія мережі цінності, якою обчислюються цілі; її ваги оновлюють, періодично копіюючи ваги основної мережі. Ціль перестає рухатися на кожному кроці. Replay buffer — черга фіксованої місткості з переходами; навчання йде на випадкових міні-пакетах, що руйнує кореляцію сусідніх кроків.
| Позначення | Значення |
|---|---|
| параметри основної мережі та target network | |
| міні-пакет переходів із replay buffer | |
| ціль оновлення; для термінального переходу дорівнює просто |
Градієнт через ціль не пропускають:
Оригінальна робота: Mnih та ін., Human-level control through deep reinforcement learning, Nature 2015.
DQN на практиці: типові параметри
| Параметр | Типове значення | Що змінюється при відхиленні |
|---|---|---|
| 0,99 | менші значення роблять агента короткозорим | |
| Темп навчання | більший темп прискорює й дестабілізує навчання | |
| Спад | від 1,0 до 0,05 за половину бюджету | швидший спад ризикує застрягти |
| Розмір міні-пакета | 512 | менші пакети дають шумніший градієнт |
| Місткість replay buffer | 10 000 переходів | малий буфер повертає кореляцію даних |
| Період оновлення target network | кожні 100 кроків | часте оновлення повертає рухому ціль |
| Кількість зерен для звіту | не менше п'яти | менше — недостовірне порівняння |
Бюджет такого експерименту — близько ста тисяч кроків. Для порівняння: політ реального квадрокоптера тривалістю двадцять хвилин при частоті керування 50 Гц дає лише шістдесят тисяч кроків, тому навчання без симулятора практично нездійсненне.
Policy gradient і actor–critic
Другий шлях не проходить через таблицю цінностей: політику параметризують мережею з вагами
Ідея проста: збільшуй логарифм імовірності тих дій, які виявилися добрими. Найпростіша реалізація — REINFORCE — незміщена, але надзвичайно шумна.
Схема actor–critic розв'язує це двома мережами. Актор — політика, яка обирає дії. Критик — функція цінності стану. Актор навчається не за сирою віддачею, а за перевагою:
Додатковий доданок у втраті актора — ентропія розподілу дій: її максимізація штрафує політику за передчасну впевненість і підтримує дослідження.
1Спільний стан
2Мережі актора й критика
3Оцінка переваги
4Оновлення політики
PPO: обмежений крок оновлення
Навіть за малого темпу навчання один крок градієнта може змінити політику настільки, що якість різко впаде, а зіпсована політика збиратиме вже непридатні дані. PPO дозволяє оновлювати політику доти, доки вона не надто відхилилася від тієї, що зібрала дані.
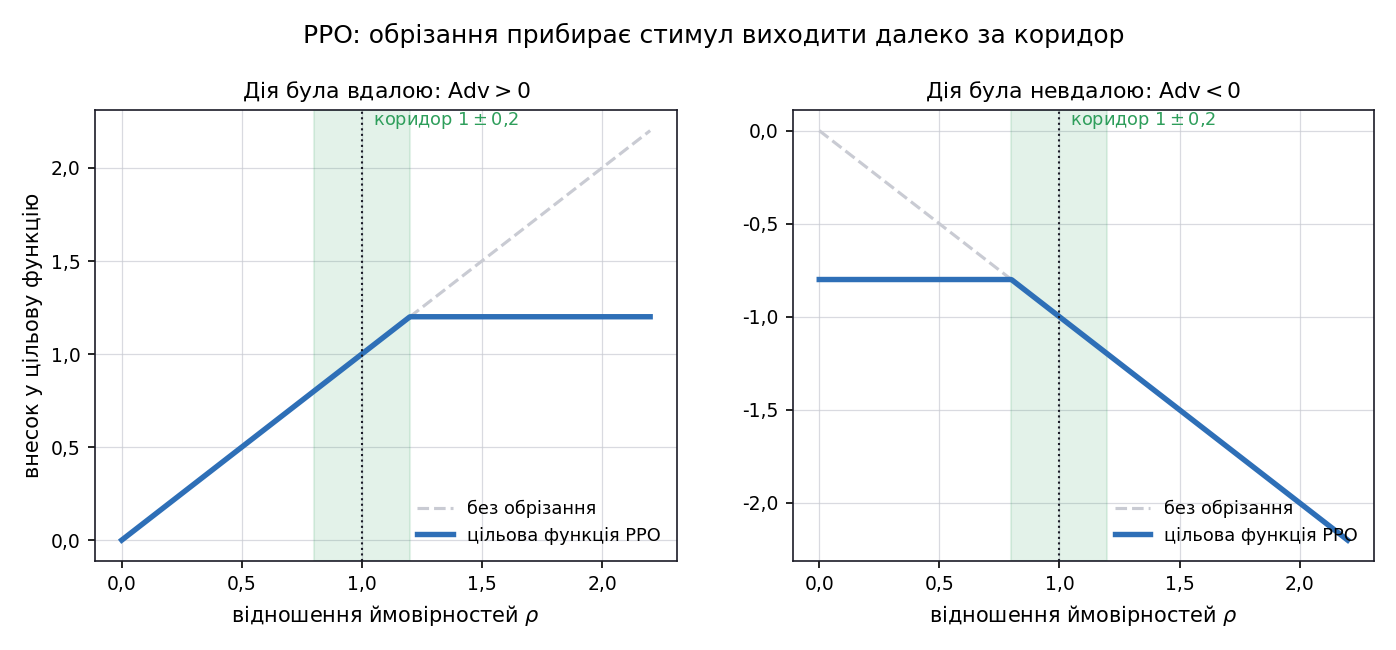
Обрізана цільова функція PPO для додатної та від'ємної переваги
Якщо дія була вдалою, вигоду від подальшого підвищення її ймовірності перестають зараховувати, щойно
DQN, PPO і SAC: як вибирати
| Властивість | DQN | PPO | SAC |
|---|---|---|---|
| Тип дій | лише дискретні | дискретні й неперервні | переважно неперервні |
| Режим навчання | off-policy | on-policy | off-policy |
| Економність за даними | висока | низька | найвища |
| Що навчається | цінність дій | політика й критик | стохастична політика й два критики |
| Механізми | replay buffer, target network | clipping, кілька епох на пакет | replay buffer, ентропійний доданок |
| Чутливість до гіперпараметрів | середня | низька | висока |
| Сценарій для БПЛА | вибір дискретного маневру | навчання в симуляторі, базовий вибір | керування тягою за обмеженого бюджету польотів |
Практичне правило. Дії дискретні й кроки дешеві — DQN. Потрібен надійний результат без тонкого налаштування і є швидкий симулятор — PPO. Дії неперервні, а кожен крок коштує дорого — SAC.
Реалізації: Stable-Baselines3 · CleanRL · Gymnasium
Частина 5 · Чесне оцінювання результату
Спосіб вимірювання результату визначає, чи можна взагалі порівнювати алгоритми. Оскільки і середовище, і політика випадкові, одна крива нічого не доводить.
| Елемент протоколу | Вимога |
|---|---|
| Кількість прогонів | від п'яти до ста незалежних, кожен зі своїм зерном |
| Оцінювання точки кривої | багато епізодів жадібної політики й усереднення віддач |
| Смуга навколо кривої | стандартне відхилення або похибка середнього |
| Вісь абсцис | кумулятивні кроки взаємодії, а не кількість епізодів |
| Бюджет налаштування | однаковий пошук гіперпараметрів для всіх алгоритмів |
Дві типові методичні помилки. Перша — відкладати на осі абсцис епізоди: алгоритм, який робить більше оновлень на епізод, виглядатиме кращим безпідставно. Друга — порівнювати алгоритм, для якого перебрано сотні конфігурацій, з алгоритмом із типовими параметрами. Обидві дають переконливі графіки й хибні висновки.
Типові помилки й обмеження
- Неповний стан. Якщо стан не задовольняє властивість Маркова, жоден алгоритм цього не виправить. Спершу проєктують спостереження, потім обирають метод.
- Смертельна тріада. Поєднання off-policy навчання, апроксимації функцій і бутстрепованих цілей нестабільне за побудовою; механізми DQN лише компенсують це.
- Дискретність дій у DQN. Мережа цінності дій не працює з неперервним керуванням, а дрібна дискретизація вбиває навчання комбінаторним вибухом.
- Буфер лише для off-policy. Зберігати досвід для PPO чи A2C не має сенсу: їхній градієнт визначений лише для свіжих даних.
- Хибне конструювання винагороди. Невдалий reward shaping призводить до того, що агент максимізує проміжну підказку, а не мету задачі.
- Методичні помилки оцінювання. Одне зерно, вісь епізодів замість кроків і нерівний бюджет налаштування дають красиві, але недостовірні порівняння.
Висновки
- Задача RL складається з моделі прийняття рішень і цілі навчання. Стандартна модель — MDP; коефіцієнт дисконтування належить постановці задачі, а не оптимізатору.
- Усі рівняння Беллмана виражають одну ідею: цінність зараз дорівнює негайній винагороді плюс дисконтована цінність продовження. З
політика отримується прямим аргмаксимумом. - Q-learning замінює усереднення за моделлю однією вибіркою досвіду і поширює цінність від цілі назад — це видно на сітці три на три вже після двох оновлень.
- Перенесення табличного правила на нейромережу ламається через рухому ціль і корельовані вибірки; DQN усуває обидві причини поєднанням target network і replay buffer.
- Сімейство policy gradient оптимізує політику напряму й знімає обмеження на дискретність дій, платячи прив'язкою до свіжих даних; PPO робить крок безпечним через обрізання.
- Проєктування винагороди — інженерна робота: бонус за життя в задачі висіння прибирає стимул швидко впасти.
- Будь-яке твердження про перевагу алгоритму має сенс лише разом із протоколом вимірювання.
Перехід до Модуля 05
Одноагентний апарат зібрано повністю: постановка, цінності, табличне навчання, глибокі методи й протокол оцінювання. Усе це припускало, що середовище стаціонарне — його правила не змінюються, поки агент навчається.
Модуль 05 · Багатоагентне навчання: моделі та виклики знімає це припущення. Коли кілька агентів навчаються одночасно, кожен із них є частиною середовища для решти. Нестаціонарність, яку тут спричиняла лише зміна власної політики агента, стає наслідком навчання інших агентів рою — і це змінює саму модель прийняття рішень.
Література та ресурси
- Albrecht S. V., Christianos F., Schäfer L. Multi-Agent Reinforcement Learning: Foundations and Modern Approaches. MIT Press, 2024. Розділ 2, розділ 8. Вільна онлайн-версія
- Sutton R. S., Barto A. G. Reinforcement Learning: An Introduction. 2nd ed. MIT Press, 2018. Розділи 3–6, 13. Вільний PDF
- Mnih V. та ін. Human-Level Control through Deep Reinforcement Learning. Nature, 2015, 518, 529–533. DOI 10.1038/nature14236
- Schulman J. та ін. Proximal Policy Optimization Algorithms. arXiv:1707.06347
- Haarnoja T. та ін. Soft Actor-Critic. ICML, 2018, 1861–1870. arXiv:1801.01290
- Watkins C. J. C. H., Dayan P. Q-learning. Machine Learning, 1992, 8, 279–292.
- Azar A. T. та ін. Drone Deep Reinforcement Learning: A Review. Electronics, 2021, 10(9), 999. DOI 10.3390/electronics10090999
- Практика: Gymnasium · Stable-Baselines3 · CleanRL · Bitcraze Crazyflie