Тема
Модуль 05 · Багатоагентне навчання: моделі та виклики
Що змінюється, коли рішення ухвалює не один агент, а кілька одночасно. Модуль будує мову для таких задач і показує, які припущення одноагентного навчання перестають працювати.
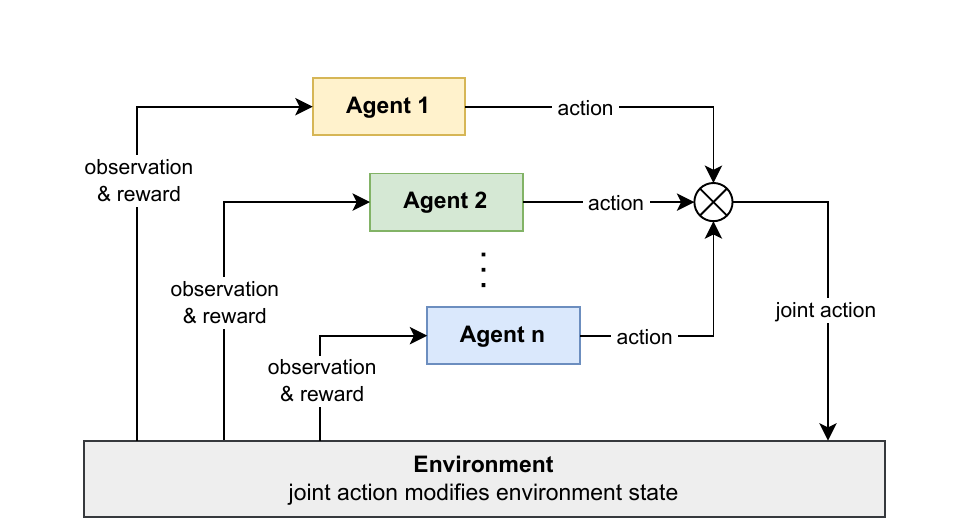
Схема багатоагентного навчання: агенти, спостереження, дії та винагороди
Зміст лекції
Багатоагентне навчання з підкріпленням (multi-agent reinforcement learning, MARL) завжди складається з двох частин: модель гри задає механіку взаємодії, концепція розв'язку каже, якою має бути спільна політика.
| Частина | Про що |
|---|---|
| 1. Моделі ігор | від матричної гри до частково спостережуваної стохастичної |
| 2. Матричні ігри як мікромоделі | п'ять класичних ігор і що кожна означає для рою |
| 3. Концепції розв'язку | рівновага Неша, Парето-оптимальність, добробут, справедливість |
| 4. Режими навчання | централізоване проти незалежного |
| 5. Чотири виклики MARL | нестаціонарність, вибір рівноваги, розподіл заслуг, масштабування |
Результати навчання
Після лекції ви зможете:
- записати кортежем моделі нормальної форми, стохастичної гри та POSG і вказати, яка з них є частковим випадком якої;
- знайти детерміновану рівновагу Неша в матричній грі й пояснити, чому саме вона;
- пояснити, чому середовище виглядає нестаціонарним для агента, що вчиться поруч з іншими;
- розрізнити централізоване й незалежне навчання та назвати проблему кожного;
- назвати чотири виклики MARL і навести для кожного числовий приклад;
- зіставити тип гри з конкретною задачею рою БПЛА.
Частина 1 · Моделі ігор
Перш ніж говорити про навчання, потрібна модель того, як влаштована взаємодія. Чотири моделі пов'язані відношенням «частковий випадок».
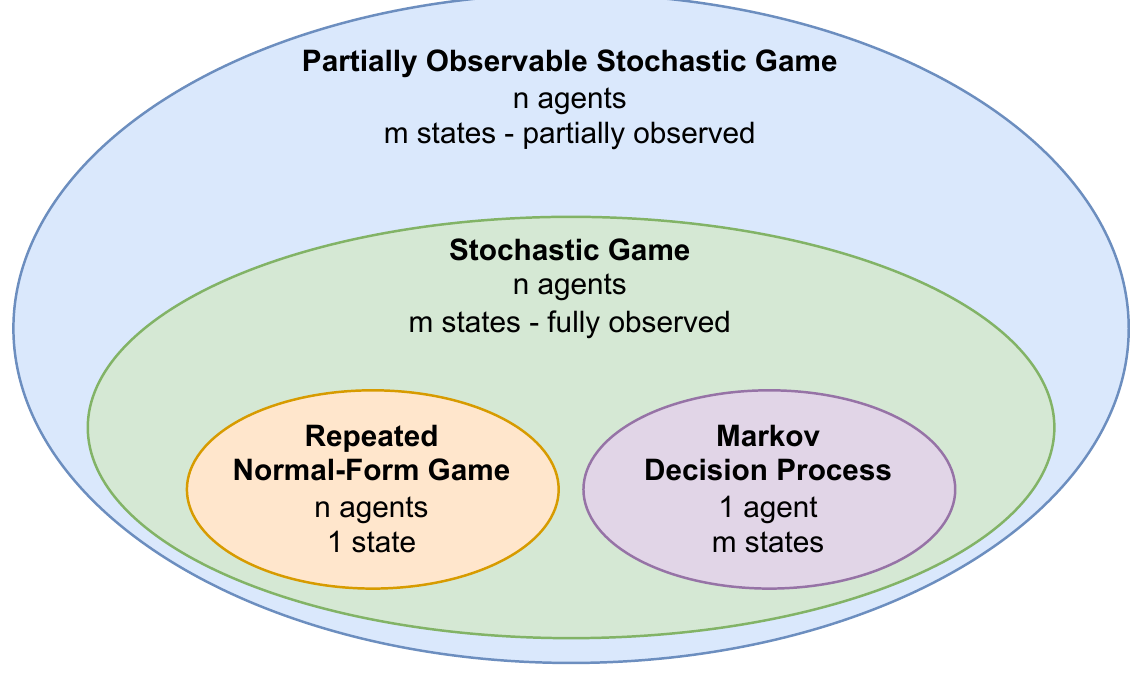
Ієрархія моделей ігор: POSG, стохастична гра, повторювана гра, MDP
Найзагальніша — частково спостережувана стохастична гра (POSG): кілька агентів, багато станів, кожен бачить лише частину картини. Якщо стан і дії всіх видно повністю — це стохастична гра. Якщо стан один і ніколи не змінюється — повторювана гра в нормальній формі. Якщо агент один — звичайний MDP, з якого починався Модуль 04.
Багатоагентна система і цикл MARL
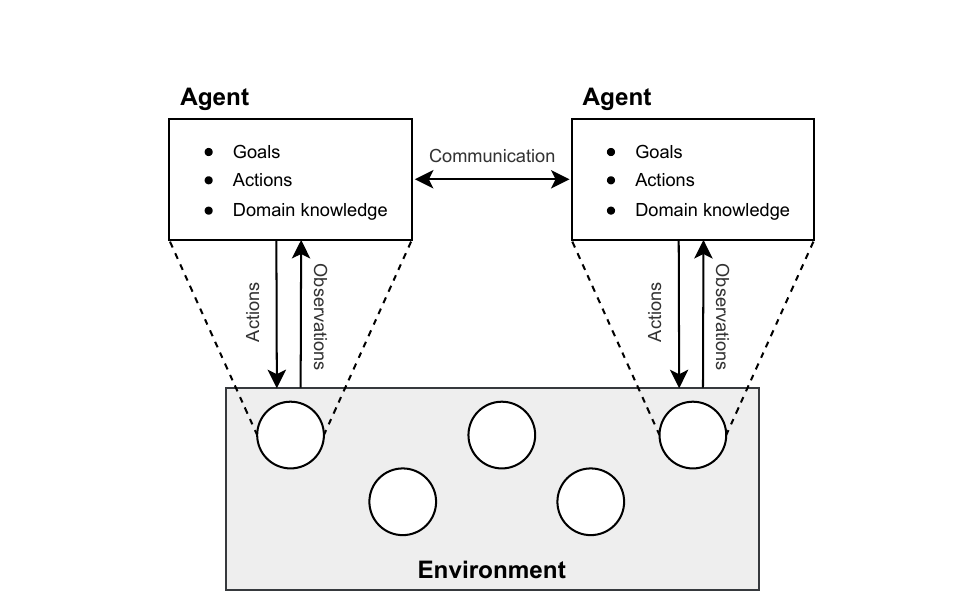
Схема багатоагентної системи
Агенти діють одночасно: кожен обирає дію незалежно, дії утворюють спільну дію (joint action), і саме вона змінює стан середовища. Кожен агент отримує власне спостереження й власну винагороду.
Ключова відмінність від Модуля 04: винагорода агента залежить не лише від його дії, а від спільної дії всіх. Саме ця залежність від чужого вибору й породжує всю подальшу теорію. Ігри з почерговими ходами (шахи, покер) описують іншим апаратом і тут не розглядаються.
Гра в нормальній формі
Найпростіша модель описує одну одночасну взаємодію.
| Позначення | Значення |
|---|---|
| множина агентів | |
| множина дій агента | |
| множина спільних дій | |
| функція винагороди агента |
Якщо ту саму гру повторювати
Стохастична гра і POSG
Стохастична гра додає до нормальної форми множину станів і функцію переходів. Кожен окремий стан можна розглядати як маленьку гру в нормальній формі, а вся стохастична гра склеює такі ігри переходами.
POSG — та сама гра, у якій агент замість стану отримує спостереження, а політика обумовлена не станом, а власною історією спостережень:
Стохастична гра — окремий випадок POSG, у якому спостереження збігається зі станом. POSG зі спільною винагородою має власну назву — Dec-POMDP, і саме до цього класу належить більшість задач рою.
Часткова спостережуваність на прикладі
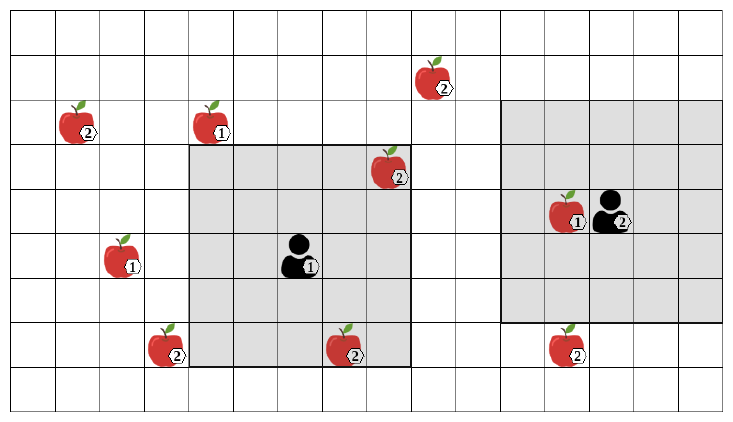
Середовище level-based foraging із частковою спостережуваністю
Часткова спостережуваність буває двох типів, і вони по-різному впливають на задачу.
| Тип | Що агент бачить | Приклади в рої |
|---|---|---|
| Приховані дії інших | стан і власну дію, але не дії сусідів | апарати поза каналом зв'язку |
| Обмежений огляд | лише частину стану | обмежений радіус сенсора, будівля між апаратами |
Оскільки стан невідомий, агент тримає стан переконань — оцінку розподілу ймовірностей по станах. Точна фільтрація на практиці недосяжна: пам'ять і час оновлення зростають експоненційно. Тому в глибокому навчанні оцінку замінюють рекурентною мережею, прихований вектор якої сам вчиться кодувати потрібне з історії спостережень.
Частина 2 · Матричні ігри як мікромоделі
Двоє агентів, кілька дій, винагорода у вигляді таблиці. На цих прикладах видно все головне: домінування, координацію, ризик і рівновагу.
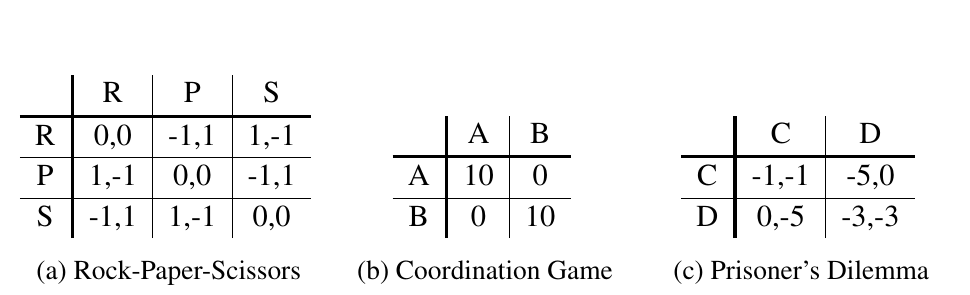
Три гри в нормальній формі для двох агентів
Характер задачі задає не сама таблиця, а співвідношення винагород агентів.
| Клас | Співвідношення | Що це означає для рою |
|---|---|---|
| zero-sum | чиста протидія, компроміс неможливий | |
| common-reward | усі винагороди однакові | чиста кооперація, лишається координація |
| general-sum | обмежень немає | і кооперація, і конфлікт одночасно |
Prisoner's Dilemma: рівновага гірша за співпрацю
| C | D | |
|---|---|---|
| C | −1, −1 | −5, 0 |
| D | 0, −5 | −3, −3 |
Єдина рівновага — (D, D) з віддачами
Головний урок. Пара (C, C) з віддачами
Stag Hunt: дві рівноваги і ціна помилки
Двоє мисливців обирають між великою здобиччю (S), яку можна взяти лише разом, і дрібною (H), яку кожен бере самостійно.
| S | H | |
|---|---|---|
| S | 4, 4 | 0, 3 |
| H | 3, 0 | 2, 2 |
Дві детерміновані рівноваги: (S, S) з
(S, S) домінує за винагородою, (H, H) домінує за ризиком: вона гарантує щонайменше 2 за будь-якої поведінки напарника. На ранніх етапах навчання, коли дії ще випадкові, агент бачить, що S інколи дає 0, а H — завжди 2 або більше. Це підштовхує обох до гіршої рівноваги.
Задача рою: маневр, який вдається лише разом, — підняття вантажу вдвох, одночасне блокування двох виходів.
Chicken і Battle of the Sexes
Chicken. Двоє рухаються назустріч; S — не звертати, L — звернути.
| S | L | |
|---|---|---|
| S | 0, 0 | 7, 2 |
| L | 2, 7 | 6, 6 |
Рівноваги: (S, L) і (L, S). Пара (L, L) з
Battle of the Sexes. Обидва хочуть бути разом, але в різних місцях.
| A | B | |
|---|---|---|
| A | 10, 7 | 2, 2 |
| B | 0, 0 | 7, 10 |
Рівноваги: (A, A) і (B, B). Проблема не в тому, щоб знайти рівновагу, а в тому, щоб домовитися, яку саме обрати, не маючи каналу для домовленостей. Задача рою: вибір спільної точки збору чи спільної частоти.
Код: пошук детермінованих рівноваг
Перевірка рівноваги завжди однакова: зафіксувати чужі дії й перевірити, чи є в агента щось краще.
python
import numpy as np, itertools

def pure_nash(R1, R2, names1, names2):
    """Повертає всі пари, від яких жодному агентові не вигідно відхилитись."""
    eq = []
    for i, j in itertools.product(range(R1.shape[0]), range(R1.shape[1])):
        best1 = R1[i, j] >= R1[:, j].max()   # агент 1 не покращить, змінивши рядок
        best2 = R2[i, j] >= R2[i, :].max()   # агент 2 не покращить, змінивши стовпець
        if best1 and best2:
            eq.append((names1[i], names2[j], R1[i, j], R2[i, j]))
    return eq

GAMES = {
    "Prisoner's Dilemma": (np.array([[-1,-5],[0,-3]]), np.array([[-1,0],[-5,-3]]), "CD", "CD"),
    "Stag Hunt":          (np.array([[4,0],[3,2]]),    np.array([[4,3],[0,2]]),    "SH", "SH"),
    "Chicken":            (np.array([[0,7],[2,6]]),    np.array([[0,2],[7,6]]),    "SL", "SL"),
    "Battle of the Sexes":(np.array([[10,2],[0,7]]),   np.array([[7,2],[0,10]]),   "AB", "AB"),
    "Rock-Paper-Scissors":(np.array([[0,-1,1],[1,0,-1],[-1,1,0]]),
                           np.array([[0,1,-1],[-1,0,1],[1,-1,0]]), "RPS", "RPS"),
}Результат коду: усі п'ять ігор одразу
text
Prisoner's Dilemma     (D,D) -> (-3,-3)
Stag Hunt              (S,S) -> (+4,+4); (H,H) -> (+2,+2)
Chicken                (S,L) -> (+7,+2); (L,S) -> (+2,+7)
Battle of the Sexes    (A,A) -> (+10,+7); (B,B) -> (+7,+10)
Rock-Paper-Scissors детермінованих рівноваг немає (лише ймовірнісна)Три висновки, важливі для решти курсу: рівноваг може бути кілька; рівновага не зобов'язана бути найкращою для всіх; деякі ігри мають лише ймовірнісні рівноваги. Скінченна гра в нормальній формі завжди має щонайменше одну рівновагу Неша — але, як показує останній рядок, вона може не бути детермінованою.
Для Rock-Paper-Scissors єдина рівновага — обидва агенти обирають кожну дію з імовірністю
Матрична гра: рівновага проти оптимальності
Рамка — рівновага Неша, зелений фон — Парето-оптимальна клітинка. Натисніть на клітинку, щоб побачити добробут і справедливість.
| Агент 2: C | Агент 2: D | |
|---|---|---|
| Агент 1: C | -1, -1 | -5, 0 |
| Агент 1: D | 0, -5 | -3, -3 |
рівновага Неша Парето-оптимальнавиплати подано як «агент 1, агент 2»
1детермінованих рівноваг
-2добробут обраної клітинки
1справедливість, добуток
нірівновага Парето-оптимальна
У Prisoner's Dilemma єдина рівновага не є Парето-оптимальною: обидва агенти раціональні, і обидва отримують гірше, ніж могли б. У Stag Hunt рівноваг дві, і вибір між ними неможливо зробити наодинці — це і є проблема вибору рівноваги з модуля. Для рою висновок практичний: тип гри визначає, чи можна взагалі очікувати доброго спільного рішення від незалежно навчених агентів.
Частина 3 · Концепції розв'язку
Розв'язок гри — це не одна політика, а спільна політика: кортеж із політики кожного агента. Оцінюють її очікуваною дисконтованою віддачею кожного агента.
Віддача агента
Рівновага Неша — спільна політика, у якій політика кожного агента є найкращою відповіддю на політики решти:
В іграх з нульовою сумою для двох агентів рівновага Неша збігається з minimax-розв'язком: обидва погляди дають те саме число — значення гри.
Парето-оптимальність, добробут і справедливість
Рівновага — не єдиний критерій якості.
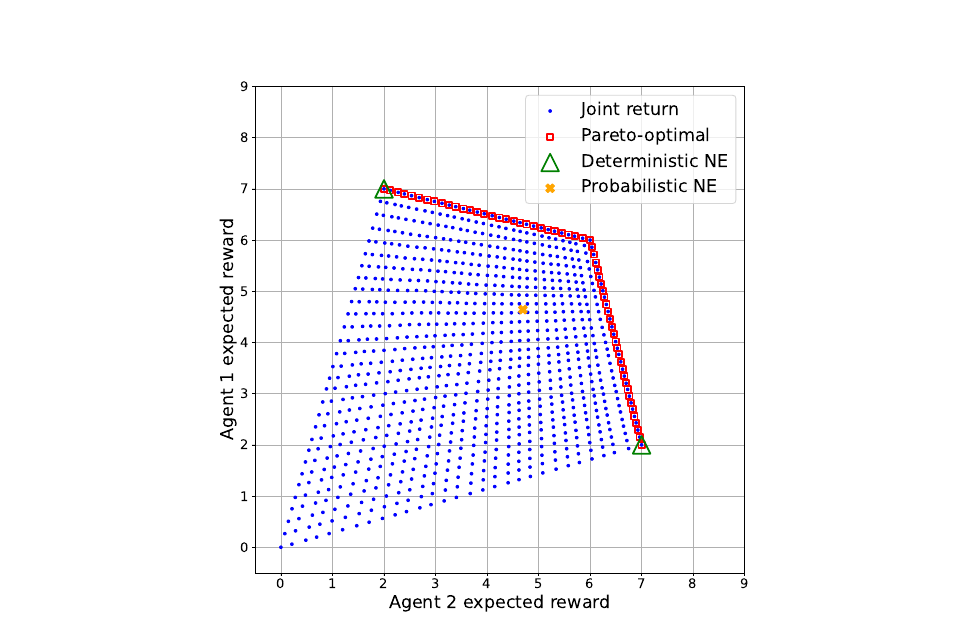
Досяжні спільні віддачі та межа Парето у грі Chicken
Політика Парето-оптимальна, якщо покращити становище одного агента, не погіршивши становища інших, неможливо. Добробут — сума віддач, справедливість — добуток:
Числовий приклад: три спільні політики з віддачами
Оптимальність за добробутом завжди дає Парето-оптимальність, зворотне хибно. За додатних віддач те саме справджується й для справедливості: Парето-домінуюча політика має більший добуток, тому максимум
Ціна обчислення рівноваги
Кожна скінченна гра має рівновагу Неша, але знайти її — обчислювально важка задача: ефективних алгоритмів для загального випадку не відомо, і в найгіршому разі час зростає експоненційно. Для окремих випадків усе краще: minimax у грі з нульовою сумою для двох агентів обчислюється швидко.
Окрема міра якості навчання — жаль (regret): різниця між отриманим і тим, що дала б одна найкраща дія проти тієї ж поведінки суперників. Приклад: десять епізодів Prisoner's Dilemma, агент отримав −21; постійне D дало б −15, отже жаль дорівнює 6, у середньому 0,6 за епізод.
Практичний висновок для курсу: MARL не шукає точну рівновагу. Він шукає достатньо добру спільну політику навчанням із взаємодії.
Частина 4 · Режими навчання
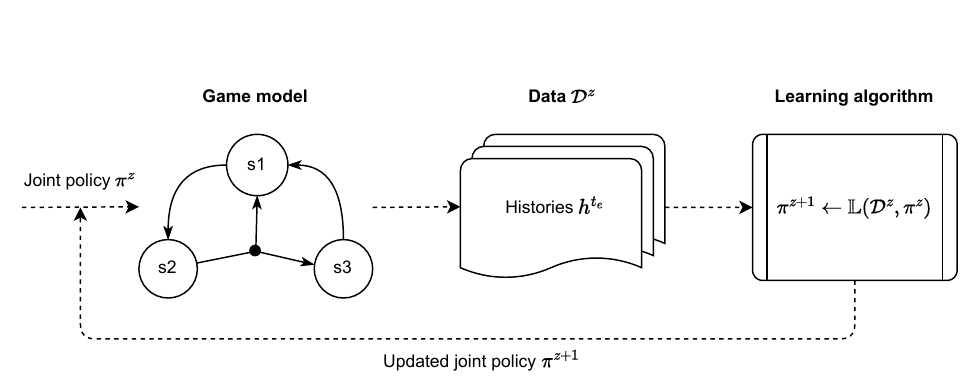
Складові загального процесу навчання в MARL
Два базові способи звести багатоагентну задачу до знайомого одноагентного апарату — і обидва мають ціну.
| Аспект | Централізоване навчання | Незалежне навчання |
|---|---|---|
| Що навчається | одна політика, що бачить усе й обирає спільну дію | кожен агент вчить власну політику зі своєї історії |
| Винагорода | потребує зведення кортежу винагород до числа | зведення не потрібне |
| Простір дій | зростає експоненційно з кількістю агентів | не зростає |
| Виконання | вимагає централізованого зв'язку в реальному часі | повністю розподілене |
| Головна проблема | масштаб і спосіб зведення винагород | нестаціонарність |
Централізоване проти незалежного: вимірювання
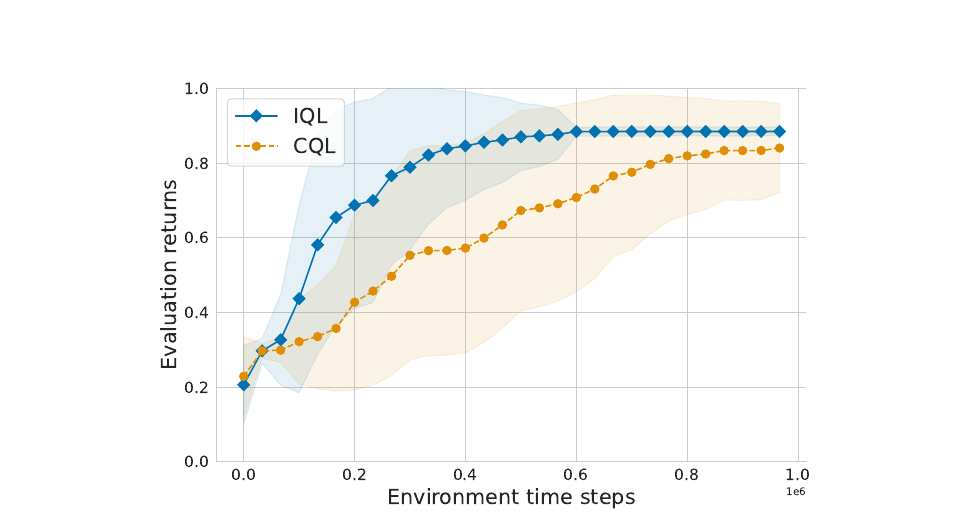
Криві навчання централізованого та незалежного Q-навчання
Для ігор зі спільною винагородою зведення тривіальне, і централізоване навчання гарантовано знаходить Парето-оптимальний розв'язок. Для ігор з нульовою та загальною сумою такого зведення може взагалі не існувати.
Практичне заперечення сильніше за теоретичне: агенти в рої фізично розподілені, тож потрібні локальні політики. Апарат не може під час польоту чекати на рішення центру.
Попри свою наївність, незалежне навчання лишається базовим орієнтиром у дослідженнях і часто дає результати, конкурентні із сучасними алгоритмами.
Централізоване навчання з децентралізованим виконанням
Компроміс, на якому побудована більшість сучасних алгоритмів MARL: під час навчання в симуляторі доступні стани й дії всіх агентів, а під час виконання кожен апарат діє лише за власним спостереженням.
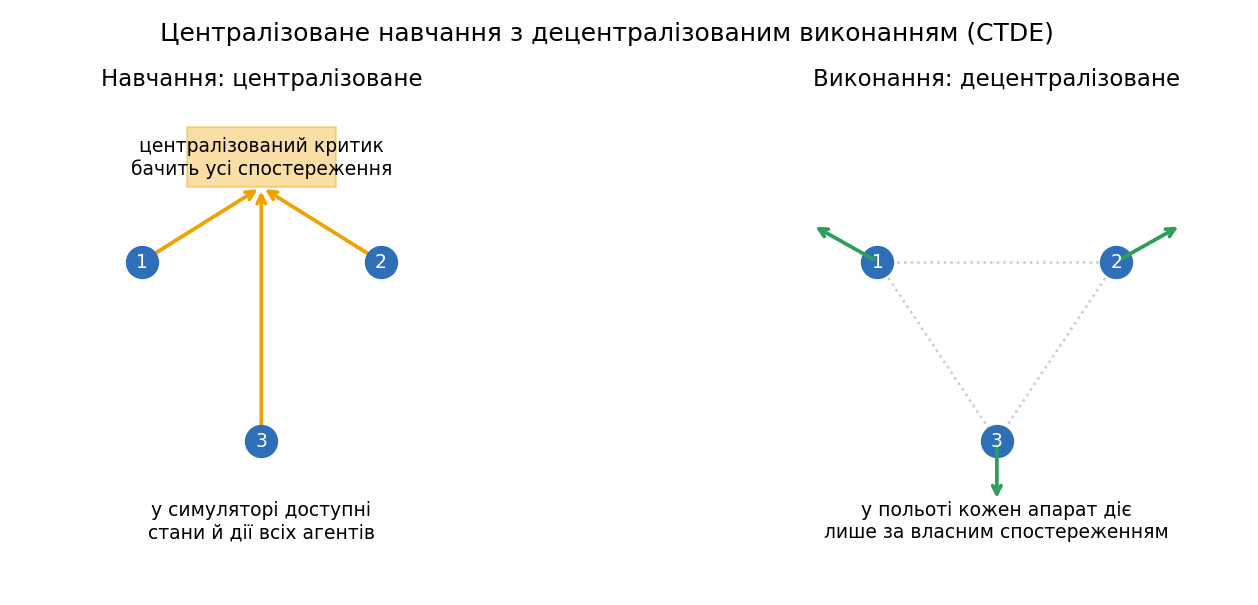
Централізоване навчання з децентралізованим виконанням
Схему називають CTDE (centralized training, decentralized execution). Вона знімає нестаціонарність на етапі навчання, не порушуючи вимоги розподіленого виконання. Детально алгоритми CTDE — MADDPG, MAPPO, QMIX — розглянуто в Модулі 08.
Частина 5 · Чотири виклики MARL
Далі — властивості, через які одноагентні рецепти не переносяться на багатоагентні системи напряму.
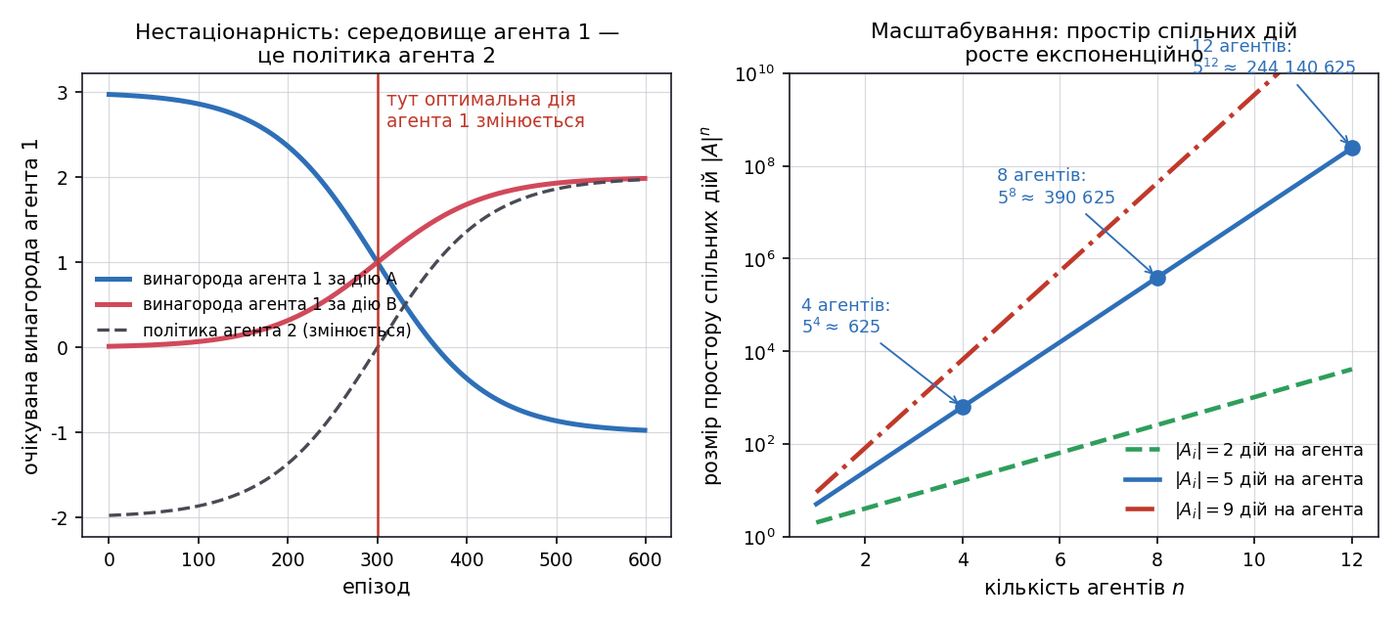
Нестаціонарність і зростання простору спільних дій
Виклик 1: нестаціонарність
Коли агент
| Позначення | Значення |
|---|---|
| динаміка, як її «бачить» агент | |
| справжня динаміка гри над спільними діями | |
| політика агента |
Поки сусіди вчаться, їхні політики змінюються, а разом з ними змінюється й те, що агент
Нестаціонарність у вимірюваннях
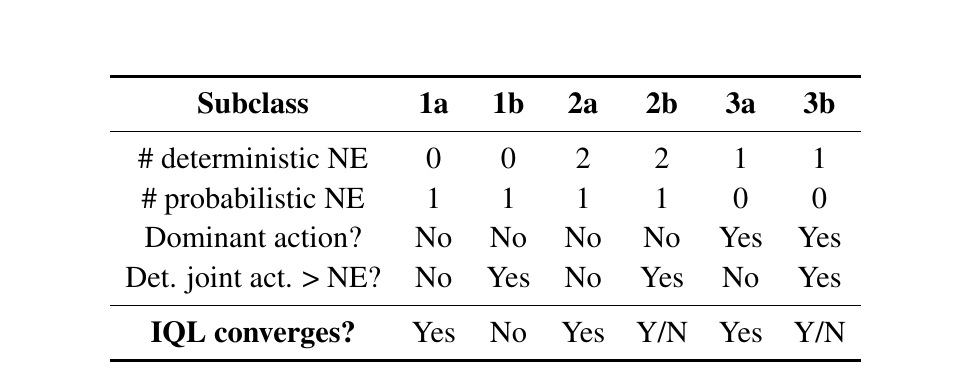
Збіжність нескінченно малого незалежного Q-навчання
Виникають циклічні режими: агент пристосовується до сусідів, ті пристосовуються до нього, і так по колу. На графіку видно, що траєкторія політик не сходиться в точку, а обертається навколо рівноваги.
Усі відомі теоретичні гарантії збіжності обмежені вузькими класами ігор. Це не дефект конкретного алгоритму, а властивість задачі.
Виклик 2: вибір рівноваги
Коли рівноваг кілька, постає окреме питання: на якій із них агенти мають зійтися і як вони про це домовляться, не маючи каналу для домовленостей.
Показовий випадок — Stag Hunt: рівновага
Чотири підходи, якими на це відповідають:
- звузити множину розв'язків додатковим критерієм — Парето-оптимальністю, добробутом або справедливістю;
- скористатися структурою гри: в іграх з нульовою сумою значення рівноваги єдине, вибирати нема з чого;
- моделювати інших агентів — будувати прогноз їхніх дій і зважати на нього;
- комунікація — із застереженням: якщо агенти не зобов'язані діяти згідно з переданим, а одержувач не може перевірити повідомлення, комунікація сама стає джерелом проблем.
Виклик 3: розподіл заслуг
В одноагентному RL розподіл заслуг — це питання «яка з моїх минулих дій привела до цієї винагороди». У багатоагентному додається друге: «чия саме дія серед усіх агентів».
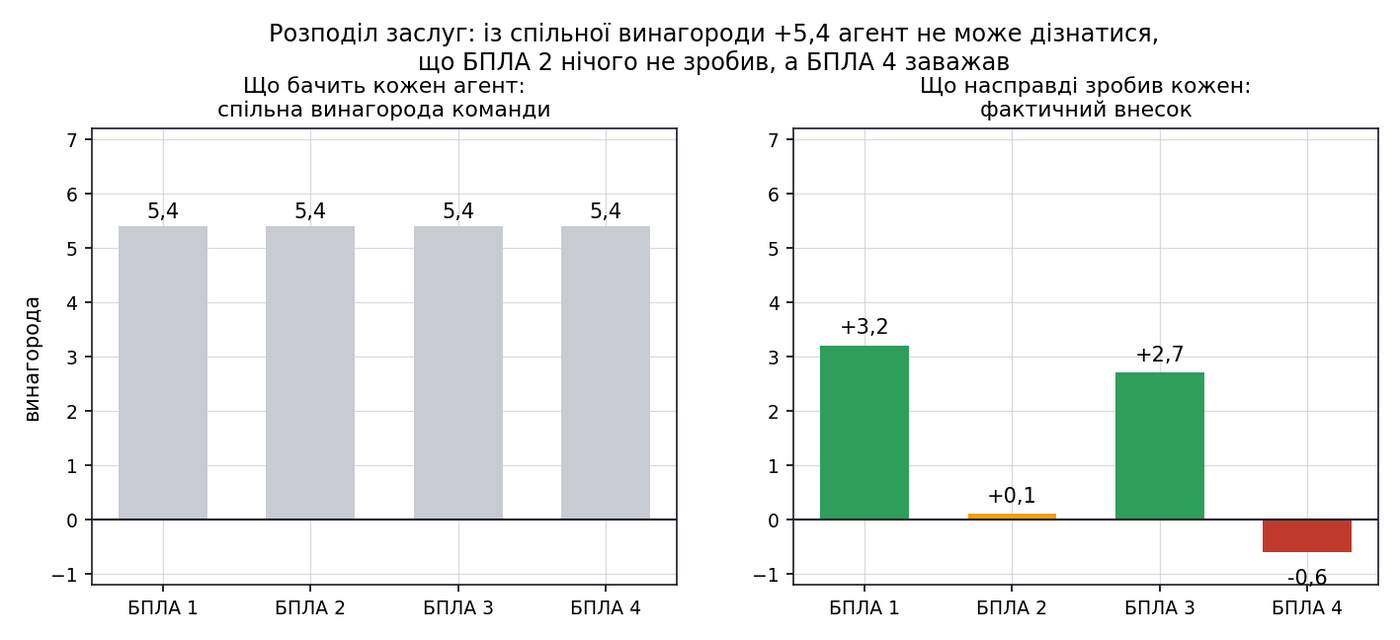
Спільна винагорода приховує внесок окремого агента
Найгостріше проблема стоїть у задачах зі спільною винагородою: одне й те саме число видають усім, і кожен має сам здогадатися, чи був його внесок корисним.
Що з цим роблять: оцінюють не власну дію, а спільну. У Rock-Paper-Scissors агент, що дивиться лише на власну дію, бачить середню цінність R близько нуля; функція від пари дій розрізняє
Виклик 4: масштабування до багатьох агентів
Кількість спільних дій — це добуток кількостей індивідуальних дій, тому вона зростає експоненційно з числом агентів.
Числовий приклад для рою, де кожен апарат має 6 дій (чотири напрямки, збирання, очікування):
| Агентів | Спільних дій | Скільки це |
|---|---|---|
| 2 | 36 | таблиця оглядається цілком |
| 3 | 216 | ще можна перебрати вручну |
| 5 | 7 776 | таблиця на кілька тисяч рядків |
| 8 | 1 679 616 | перебір уже не варіант |
| 10 | 60 466 176 | у 1,7 млн разів більше, ніж для двох |
Перехід від 3 до 5 агентів — стрибок у 36 разів. Розбиття однієї великої задачі на
Проти кого тренуватися
| Режим | Що означає |
|---|---|
| Algorithm self-play | усі агенти використовують один алгоритм навчання |
| Policy self-play | політику навчають безпосередньо проти неї самої |
| Mixed-play | агенти використовують різні алгоритми |
Policy self-play передбачає algorithm self-play, але не навпаки. Його перевага — швидкість: досвід усіх агентів зливається в одну політику. Обмеження — потрібні симетричні ролі й егоцентричні спостереження.
Припущення self-play стримує нестаціонарність, яка ще посилюється, коли агенти вчаться різними методами. Історичний приклад: TD-Gammon досяг рівня чемпіона в нардах, тренуючись проти себе.
Тип гри визначає задачу рою
Формальні класи ігор не є абстракцією: кожен відповідає впізнаваній задачі рою БПЛА.
| Тип гри | Задача рою | Що визначає складність |
|---|---|---|
| zero-sum, 2 агенти | перехоплення чужого апарата, ухилення | компромісу немає, потрібна гарантія проти найгіршого |
| common-reward (Dec-POMDP) | спільне обстеження площі, спільна доставка | розподіл заслуг: винагорода одна на всіх |
| Stag Hunt | маневр, що вдається лише разом | вибір між ризикованою і безпечною рівновагою |
| Chicken | розходження у вузькому коридорі | обидва не поступляться — зіткнення |
| Battle of the Sexes | вибір спільної точки збору чи частоти | рівноваг дві, треба домовитися без переговорів |
| General-sum, | кілька операторів ділять повітряний простір | часткова кооперація й конкуренція одночасно |
Практичне правило: перш ніж обирати алгоритм, визначте, у якому рядку цієї таблиці опинилася задача. Від цього залежить, чи взагалі має сенс шукати рівновагу і яку саме.
Словник: RL та теорія ігор
Той самий предмет описують двома словниками. Курс користується термінологією RL, але літературу з теорії ігор доводиться читати постійно.
| RL | Теорія ігор | Що це |
|---|---|---|
| середовище | гра | модель дій, спостережень, винагород і динаміки |
| агент | гравець | сутність, що ухвалює рішення |
| винагорода | payoff, utility | скалярне значення після дії |
| політика | стратегія | функція, що приписує ймовірності діям |
| детермінована | pure | приписує ймовірність 1 одному варіанту |
| ймовірнісна | mixed | приписує ймовірності кільком варіантам |
| спільна дія | action profile | кортеж, по одному елементу на агента |
«Детермінована рівновага Неша» і pure Nash equilibrium — те саме.
Висновки
- Моделі ігор утворюють ієрархію: POSG ⊃ стохастична гра ⊃ повторювана гра в нормальній формі; MDP — стохастична гра з одним агентом.
- Задача MARL — це пара модель гри плюс концепція розв'язку. Сама модель не каже, яку спільну політику вважати бажаною.
- Рівновага Неша означає стійкість до одностороннього відхилення — і нічого більше. Вона може бути гіршою за нерівноважний варіант, їх може бути кілька, а іноді вона лише ймовірнісна.
- Оптимальність за добробутом дає Парето-оптимальність, зворотне хибно; за додатних віддач те саме вірно й для справедливості, але між собою добробут і справедливість не пов'язані.
- Чотири виклики: нестаціонарність, вибір рівноваги, розподіл заслуг, масштабування — від 216 до 7 776 спільних дій при переході від 3 до 5 агентів.
- Практичний компроміс — CTDE: централізоване навчання, децентралізоване виконання.
Перехід до Модуля 06
Модуль 05 побудував мову й показав, чому одноагентні рецепти не переносяться напряму. Але всі розглянуті приклади були табличними: матриці 2×2, сітки, скінченні множини станів.
Модуль 06 · Глибоке навчання з підкріпленням для БПЛА повертається до одного апарата, але з неперервним станом і неперервним керуванням — там, де таблиця неможлива в принципі. Розглянуто архітектури мереж, DDPG і SAC для керування тягою й кутами, а також розрив між симуляцією та реальним польотом.
Виклики цього модуля нікуди не зникають: у Модулі 08 вони повернуться вже разом із глибокими мережами, і саме там з'являться MADDPG, MAPPO та QMIX.
Література та ресурси
- Albrecht S. V., Christianos F., Schäfer L. Multi-Agent Reinforcement Learning: Foundations and Modern Approaches. MIT Press, 2024. Розділи 3–5. marl-book.com
- Nash J. Equilibrium Points in n-Person Games. PNAS, 1950, 36(1), 48–49. DOI 10.1073/pnas.36.1.48
- Shapley L. S. Stochastic Games. PNAS, 1953, 39(10), 1095–1100.
- Littman M. L. Markov Games as a Framework for Multi-Agent Reinforcement Learning. ICML, 1994, 157–163.
- Claus C., Boutilier C. The Dynamics of Reinforcement Learning in Cooperative Multiagent Systems. AAAI, 1998, 746–752.
- Daskalakis C., Goldberg P. W., Papadimitriou C. H. The Complexity of Computing a Nash Equilibrium. SIAM J. Computing, 2009, 39(1), 195–259.
- Papoudakis G. та ін. Benchmarking Multi-Agent Deep Reinforcement Learning Algorithms in Cooperative Tasks. NeurIPS Datasets and Benchmarks, 2021. arXiv:2006.07869
- Wolpert D. H., Tumer K. Optimal Payoff Functions for Members of Collectives. Advances in Complex Systems, 2002, 4(2/3), 265–279.
- Практика: PettingZoo — багатоагентні середовища · Level-Based Foraging · EPyMARL