Тема
Модуль 09 · Практика багатоагентного навчання
Що робити, коли політика не вчиться: діагностика типових збоїв, чесний протокол вимірювання й прийоми, які реально економлять час.
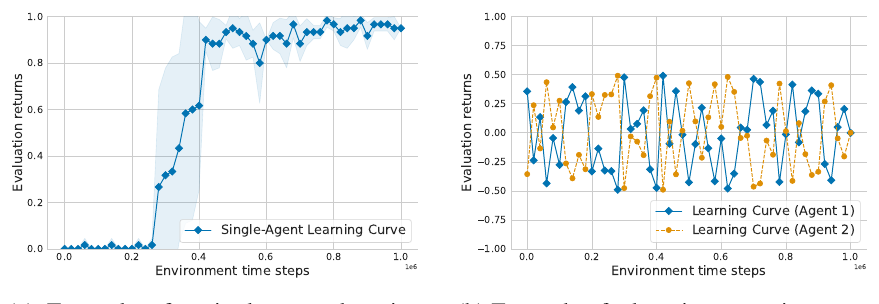
Джерело: Albrecht, Christianos, Schäfer, Multi-Agent Reinforcement Learning, MIT Press, 2024, рис. 10.2.
Зміст лекції
Попередні модулі давали методи. Цей — інженерну дисципліну, без якої методи не доводяться до результату.
| Частина | Про що |
|---|---|
| 1. Інтерфейс середовища | що має вміти середовище і як обрати, де перевіряти |
| 2. Пам'ять агента | стек спостережень, рекурентна мережа чи нічого |
| 3. Однорідність рою | спільні параметри, коли вони коректні, і що робити з ролями |
| 4. Обмін досвідом | альтернатива спільним параметрам |
| 5. Чесне вимірювання | криві навчання, скільки прогонів, бюджет пошуку |
| 6. Діагностика | чому політика не вчиться: тринадцять типових причин і що з ними робити |
Частина 6 — головна. Її варто тримати відкритою під час лабораторних робіт.
Результати навчання
Після лекції ви зможете:
- прочитати опис просторів спостережень і дій багатоагентного середовища й сказати, скільки в ньому агентів;
- обрати середовище під те, що саме хочете перевірити;
- обрати між стеком спостережень, рекурентною мережею й відсутністю пам'яті, спираючись на властивості задачі;
- відрізнити слабко однорідних агентів від сильно однорідних і сказати, коли parameter sharing коректний;
- пояснити, чому спільний буфер сам собою нічого не прискорює;
- побудувати криву навчання так, щоб за нею можна було порівнювати алгоритми;
- назвати, чому порівняння двох алгоритмів може бути недійсним навіть за однакових графіків;
- пояснити на числах, чому стандартизація винагород може перетворити «виконати місію швидше» на «літати довше»;
- за симптомом визначити ймовірну причину того, що політика рою не вчиться.
Частина 1 · Інтерфейс середовища
Перше, з чим стикається кожен, хто береться за багатоагентне навчання: єдиного інтерфейсу середовищ у MARL немає, на відміну від одноагентного випадку. Різні фреймворки домовляються по-різному, і алгоритм, який працює з усіма, написати важко.
Мінімум, який має вміти середовище
Попри різнобій, базова пара функцій та сама, що в одноагентному випадку: reset() повертає початкове спостереження, step() просуває середовище на крок і повертає наступне спостереження, винагороду й ознаку завершення. Плюс середовище описує простори спостережень і дій.
python
import gymnasium as gym

env = gym.make("Foraging-8x8-2p-1f-v3")

env.observation_space
# >> Tuple(Box(..., 15), Box(..., 15))
env.action_space
# >> Tuple(Discrete(6), Discrete(6))

observations, info = env.reset(seed=0)
actions = env.action_space.sample()
observations, rewards, terminated, truncated, info = env.step(actions)| Елемент | Що означає в цьому прикладі |
|---|---|
Tuple(...) довжини 2 | простори — кортежі по агентах; довжина 2 означає двох агентів |
Box(..., 15) | спостереження одного агента — вектор із 15 чисел |
Discrete(6) | шість дій: чотири напрямки, взяти предмет, нічого не робити |
terminated / truncated | завершення за правилами задачі проти обриву за лімітом часу |
Цього мінімуму досить, щоб описати частково спостережувану багатоагентну задачу. Складніші інтерфейси лише додають: обмеження доступних дій по ходу епізоду, видачу повного стану середовища для централізованого критика. Середовища з іншим інтерфейсом підключають обгортками.
Де перевіряти: критерії вибору середовища
Питання ставлять не «яке середовище найкраще», а які саме здібності треба перевірити. Релевантні властивості:
- надійна збіжність до конкретної концепції розв'язку;
- ефективність масштабування за числом агентів;
- робота за великих просторів станів і дій, за часткової спостережуваності та за розріджених винагород (винагорода нульова більшу частину часу).
Найважчі задачі — це комбінація всіх трьох: великий простір, обмежена видимість і рідкий сигнал.
Окремий критерій, який зазвичай забувають: яких навичок середовище вимагає від агентів. Вони різні:
| Навичка | Де перевіряється |
|---|---|
| коли й з ким кооперуватися | задачі збирання предметів удвох |
| якою інформацією ділитися | задачі з явним каналом зв'язку |
| як розподілити ролі в команді | командні задачі з різними позиціями |
Алгоритм може блискуче справлятися з одним типом навичок і провалювати інший, тому одного бенчмарка не досить. Для рою БПЛА це означає: утримання строю, обхід перешкод і покриття території перевіряють різні здібності політики, і хороший результат на одному нічого не обіцяє на іншому.
Частина 2 · Пам'ять агента
Теоретично політику треба обумовлювати на всій історії спостережень — інакше в частково спостережуваному середовищі вона не має потрібної інформації. Але мережа має фіксований вхід.
Три варіанти пам'яті й як обрати
| Варіант | Коли брати | Ціна |
|---|---|---|
| Нічого, лише | середовище майже повністю спостережуване | нуль |
| Стек останніх | усе потрібне вміщується у фіксоване число кроків | вхід росте в |
| Рекурентна мережа (GRU, LSTM) | потрібна інформація з далекого минулого | згасання градієнта, повільніше навчання |
Рекурентна структура найближча до теоретично коректної, але на практиці страждає від згасання градієнта, через що інформація з далекого минулого все одно не використовується.
Питання, яке варто поставити собі перед вибором: наскільки важлива для розв'язку інформація з попередніх спостережень? Для висіння Crazyflie — майже не важлива, вистачає поточного стану. Для обстеження території, де треба пам'ятати, де вже був, — критично.
Частина 3 · Однорідність рою
Зі зростанням числа апаратів простір параметрів росте: окрема мережа на кожного означає, що навчати доводиться в
Слабко й сильно однорідні агенти
Слабко однорідні: агенти можуть обмінятися політиками, і результат розв'язання задачі збережеться.
Сильно однорідні: агенти слабко однорідні і оптимальна спільна політика складається з однакових індивідуальних політик.
Різниця не формальна. Уявіть два апарати й два різні орієнтири, до яких треба розлетітися. Політики можна поміняти місцями — задача розв'яжеться, отже агенти слабко однорідні. Але оптимальна поведінка різна: один летить ліворуч, другий праворуч. Сильної однорідності немає.
А якщо орієнтир один і обом треба до нього — агенти сильно однорідні.
Parameter sharing: коли він коректний
Формально це обмеження на спільну політику: вона зобов'язана складатися з однакових індивідуальних. Отже, parameter sharing коректний рівно тоді, коли агенти сильно однорідні.
Два виграші: число параметрів стале незалежно від розміру рою, і спільні ваги оновлюються досвідом усіх агентів одразу.
⚠️ Пастка: сильна однорідність — сильне припущення, і перевірити його важко. У прикладі з двома орієнтирами оптимальні політики різні й просто не можуть бути вивчені за такого обмеження.
Що робити з різними ролями:
- індекс агента у спостереженні — теоретично дозволяє виробити різну поведінку, але на практиці ємності мережі може забракнути, щоб представити кілька різних стратегій;
- обмін досвідом замість обміну параметрами — наступний розділ.
Виміряно на задачі збирання предметів: спільні параметри пришвидшують збіжність, але в тому експерименті не підвищили фінальну віддачу — усі варіанти зійшлися до схожої політики. Це спостереження на конкретній задачі, а не загальний закон.
Частина 4 · Обмін досвідом
Компроміс: тримати окремі параметри на кожного агента, але ділити траєкторії. Припущення сильної однорідності при цьому не потрібне, і політики можуть вийти різними.
Спільний буфер і чому сам собою він не працює
Для off-policy усе просто: замість
⚠️ Але проста заміна буферів нічого не змінить. Число зразків на навчання лишилося тим самим. Виграш спільного буфера в тому, що в ньому більше й свіжішого досвіду, — і щоб ним скористатися, треба збільшити число кроків зворотного поширення.
Для on-policy потрібна корекція важливісною вибіркою — так влаштований SEAC:
| Спільні параметри | Обмін досвідом | |
|---|---|---|
| Припущення | сильна однорідність | не потрібне |
| Число параметрів | стале | росте з |
| Обчислення на крок | менше | дорожче: батч більший |
| Фінальна віддача | обмежена однаковістю політик | може бути вищою |
Менш очевидний виграш обміну: він вирівнює темп навчання агентів. Відстаючий швидко наздоганяє, вчачись на траєкторіях тих, у кого політика вже краща, — а коли агенти йдуть в одному темпі, у них більше шансів дослідити дії, які вимагають координації.
Частина 5 · Чесне вимірювання
У багатоагентному навчанні порівнювати важче, ніж в одноагентному, з двох причин: висока чутливість до гіперпараметрів і до зерен, і концепції розв'язку, що не зводяться до одного числа.
Крива навчання: що по осях і скільки прогонів
По осі абсцис — накопичені кроки середовища, а не епізоди. Інакше порівняння перекошується: алгоритм, який на ранніх епізодах досліджував більше, зробив більше кроків і більше оновлень за те саме число епізодів, і його крива росте «швидше» з причини, не пов'язаної з якістю.
По осі ординат — та величина, на яку навчали. Але корисно поруч показати й недисконтовану віддачу: її легше інтерпретувати. Якщо апарат покрив десять комірок, недисконтована віддача дорівнює десяти, а дисконтована — щось менше, і зрозуміти за нею число комірок важко.
Скільки прогонів. Однозначної норми немає, є практика: у дешевих табличних задачах автори підручника беруть від п’ятдесяти до ста незалежних прогонів, у дорогих глибоких — п'ять, і завжди показують середнє зі смугою розкиду. У ваших лабораторних мінімум — п'ять.
⚠️ Смуга на графіку має бути підписана: стандартне відхилення й похибка середнього — різні речі, і читач мусить знати, що бачить.
Правило чесного порівняння
Порівняння двох алгоритмів, де один отримав ширший пошук гіперпараметрів, нечесне.
Це головне правило розділу, і порушують його постійно — зазвичай ненавмисно: свій алгоритм крутили тиждень, чужий узяли зі значеннями за замовчуванням.
Практика пошуку: grid search за кількома комбінаціями і кількома зернами, потім вибір найкращої комбінації за метрикою кривої. Починати варто біля значень, про які відомо, що вони розумні, і зосередитися насамперед на гіперпараметрах, що керують дослідженням — коефіцієнті ентропії передусім.
Максимум чи середнє по кривій. Максимум каже, чи розв'язав алгоритм задачу хоч колись; середнє — наскільки швидко й стабільно він учився. Якщо кілька алгоритмів дійшли до одного максимуму, розрізнити їх дозволяє саме середнє.
Код: чому стандартизація може змінити задачу
Порахуємо приклад із попередньої частини до кінця. Середовище з одного стану й двох дій: перша дає
python
import numpy as np

P_END = 0.01                        # імовірність завершення після дії 2
R1, R2 = -1.0, -0.1

steps_1 = 1.0                       # дія 1 завершує епізод одразу
steps_2 = 1.0 / P_END               # геометричний розподіл: у середньому 100

# Батч, який реально збирає реалізація: обидві винагороди трапляються.
batch = np.concatenate([np.full(500, R1), np.full(500, R2)])
mean, std = float(batch.mean()), float(batch.std())

std_1 = (R1 - mean) / std
std_2 = (R2 - mean) / stdЖодного трюку тут немає — це рівно те, що робить VecNormalize або будь-який власний код стандартизації.
Результат коду: перевага перевернулася
text
дія 1: винагорода -1.0 за крок, епізод 1 крок
дія 2: винагорода -0.1 за крок, епізод у середньому 100 кроків

віддача за епізод: дія 1 = -1.0, дія 2 = -10.0
обидві від'ємні, дія 1 краща → агент прагне завершити епізод якнайшвидше

батч із 1000 винагород: середнє -0.550, відхилення 0.450

після стандартизації:
  дія 1: -1.0  →  -1.00
  дія 2: -0.1  →  +1.00   ← стала ДОДАТНОЮ
порядок покрокових винагород збережено: -1.00 < +1.00

але віддача за епізод: дія 1 = -1.0, дія 2 = +100.0
тепер кожен зайвий крок ДОДАЄ винагороду, і вигідно тягнути епізод
перевага перевернулася: було краще завершити, стало краще жити довшеЗверніть увагу, що саме зламалося. Порядок покрокових винагород збережено —
Причина в тому, що стандартизація перевела частину винагород у додатну область, а тривалість епізоду вона не чіпає. Поки всі винагороди від'ємні, кожен зайвий крок коштує; щойно вони стали додатними, кожен зайвий крок приносить.
Для рою це не абстракція: якщо ваша винагорода складена зі штрафів — відхилення від строю, зближення, витрата енергії, — стандартизація перетворює задачу «виконати місію швидше» на «літати довше». Саме тому в чек-листі відтворюваності стоїть окремий пункт про попередню обробку винагород.
Частина 6 · Чому політика не вчиться
Найпрактичніша частина курсу. Кожен рядок — симптом, який ви побачите в журналі навчання, і причина, яку варто перевірити першою.
Діагностика: симптом → причина → що робити
| Симптом | Ймовірна причина | Що робити |
|---|---|---|
| Крива коливається, агент «забуває» вивчене | нестаціонарність: сусіди вчаться одночасно | перейти до централізованого критика |
| Off-policy закріплює стратегію, яку сусіди вже контрять | буфер зберігає застарілі політики сусідів | менший буфер, ваги важливісної вибірки, hysteretic Q |
| Рій не намагається, щоб не бути оштрафованим | вибір боязкої рівноваги | переглянути співвідношення штрафу й бонусу |
| «Ледар» у рої вчиться не працювати | спільна винагорода не несе інформації про внесок | контрфактична базова лінія, декомпозиція цінності |
| Критик дає невірні оцінки | критик не бачить історії агента → зсув | подавати |
| Додали централізований критик — стало шумніше | зайва інформація підвищує дисперсію | перевірити, чи не роздуто вхід |
| Спільні параметри не дають розійтися по ролях | середовище слабко, а не сильно однорідне | індекс агента або обмін досвідом |
| Спільний буфер нічого не змінив | число зразків лишилося тим самим | збільшити кроки зворотного поширення |
| Навчання розповзається, цінності не наближаються | винагороди охоплюють кілька порядків | стандартизація віддач |
| Після стандартизації агент почав «тягнути час» | стандартизація змінила природу задачі | див. Модуль 06 |
| Крива пласка, хоча агенти вчаться | гра з нульовою сумою: обидва ростуть разом | фіксований опонент або пул минулих версій |
| Один алгоритм «перемагає» інший | несумірний бюджет пошуку гіперпараметрів | зрівняти бюджет |
| Немає прискорення від паралельних середовищ | середовище — фізична система в одному екземплярі | ці прийоми незастосовні |
Три поради, які економлять найбільше часу
Один оптимізатор на всіх. Багато реалізацій незалежного навчання заводять окремий екземпляр оптимізатора на кожного агента. Це гарантує незалежність, але дуже дорого й не використовує паралелізацію. Один оптимізатор, що охоплює всі параметри — навіть якщо агенти складаються з різних мереж, — істотно швидший: втрати просто складаються перед кроком.
python
params = list(net1.parameters()) + list(net2.parameters()) + list(net3.parameters())
opt = torch.optim.Adam(params)
...
loss = loss1 + loss2 + loss3
loss.backward()
opt.step()Стандартна конфігурація мереж для задач такого масштабу: два прихованих шари по 64 нейрони, ReLU. Це відправна точка, а не догма.
Критерій вибору середовища. Питання не «яке середовище найкраще», а які саме здібності ви хочете перевірити: надійну збіжність до розв'язку, масштабування за числом агентів, роботу за часткової спостережуваності чи за розріджених винагород. Найважчі задачі — комбінація великого простору станів, обмеженої спостережуваності й розріджених винагород.
Висновки
- Пам'ять агента обирають за питанням «наскільки важлива інформація з минулого», а не за замовчуванням: рекурентна мережа найближча до теорії, але страждає від згасання градієнта.
- Parameter sharing коректний лише за сильної однорідності — коли оптимальні політики агентів однакові. Він пришвидшує збіжність, але не підвищує фінальну віддачу.
- Обмін досвідом знімає це припущення ціною більших обчислень і вирівнює темп навчання агентів.
- Спільний буфер сам собою нічого не прискорює: треба збільшити число оновлень.
- По осі абсцис кривої — кроки середовища, не епізоди. Смуга розкиду має бути підписана.
- Порівняння з несумірним бюджетом пошуку гіперпараметрів нечесне — це найчастіше порушуване правило галузі.
- Більшість збоїв навчання в рої мають типову причину, і таблиця діагностики економить дні.
Перехід до Модуля 10
Апарат зібрано повністю: постановка, алгоритми, інваріантності, декомпозиція цінності й інженерна дисципліна вимірювання.
Модуль 10 · Конкретні задачі роїв прикладає все це до реальних місій: покриття території, пошук об'єкта, розподіл цілей, керований поділ рою — і показує, якими метриками замовник міряє результат.
Література та ресурси
- Albrecht S. V., Christianos F., Schäfer L. Multi-Agent Reinforcement Learning: Foundations and Modern Approaches. MIT Press, 2024 — розділи 2.7 (криві навчання й вісь кроків), 8.2.8 (паралельні середовища), 9.7, 10.5, 10.6, 11.1. Вільний PDF
- Christianos F., Schäfer L., Albrecht S. V. Shared Experience Actor-Critic for Multi-Agent Reinforcement Learning (SEAC). NeurIPS, 2020. arXiv:2006.07169
- Christianos F., Papoudakis G., Rahman A., Albrecht S. V. Scaling Multi-Agent Reinforcement Learning with Selective Parameter Sharing. ICML, 2021. arXiv:2102.07475
- Henderson P., Islam R., Bachman P. та ін. Deep Reinforcement Learning that Matters. AAAI, 2018. arXiv:1709.06560
- Agarwal R., Schwarzer M., Castro P. S. та ін. Deep Reinforcement Learning at the Edge of the Statistical Precipice. NeurIPS, 2021. arXiv:2108.13264
- Stable-Baselines3 · EPyMARL · PettingZoo