Тема
Модуль 12 · Реалізація та інструменти
Як довести алгоритм до працездатного експерименту: інтерфейс середовища, стек реалізації, чесний протокол оцінювання, вибір симулятора й заліза, типові помилки.
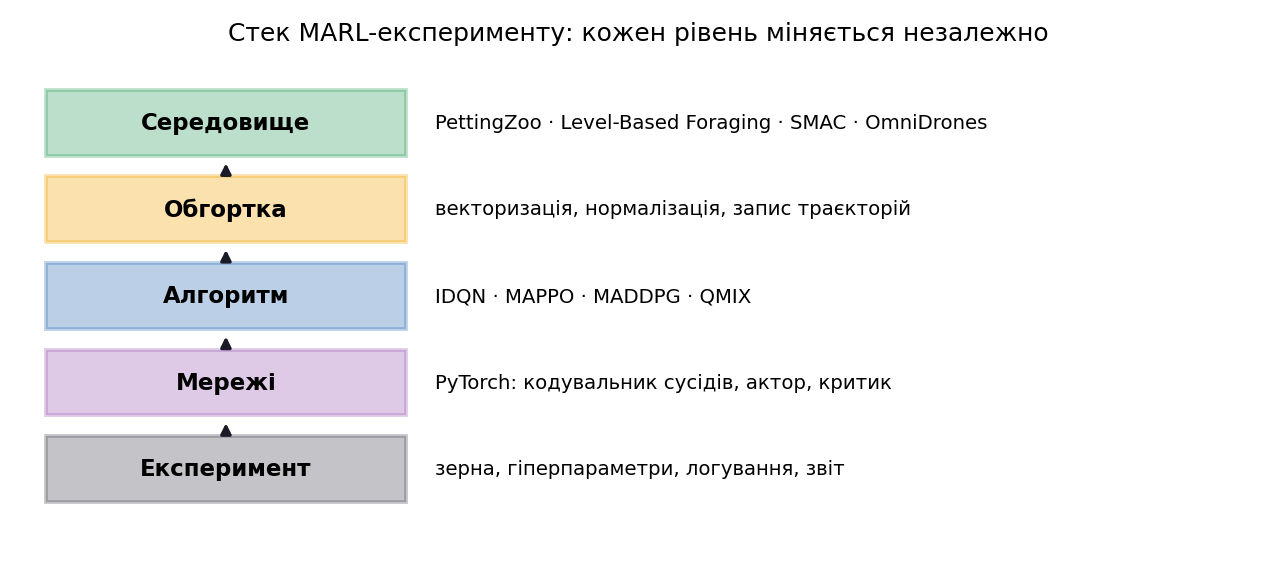
Стек експерименту MARL: середовище, обгортка, алгоритм, мережі, експеримент
Зміст лекції
| Частина | Про що |
|---|---|
| 1. MARL у коді | інтерфейс середовища, мережі, спільні параметри |
| 2. Чесний результат | криві навчання, зерна, бюджет пошуку, чек-лист відтворюваності |
| 3. Де випробовують | каталог середовищ і критерії вибору |
| 4. Залізо | компоненти мультикоптера, платформи роїв, симулятори |
| 5. Типові помилки | де найчастіше ламається реалізація і звітність |
Дев'ять попередніх модулів давали методи. Цей — інструмент і дисципліну експерименту, без яких методи лишаються текстом.
Результати навчання
Після лекції ви зможете:
- описати мінімальний інтерфейс багатоагентного середовища й прочитати опис простору дій і спостережень;
- реалізувати мережу з parameter sharing і пояснити, коли це припущення коректне;
- перетворити IDQN на VDN однією операцією й пояснити, що саме змінилося;
- скласти чек-лист відтворюваного експерименту з дев'яти пунктів;
- пояснити, чому одна крива з одного запуску не є результатом;
- обрати середовище під задачу за чотирма властивостями;
- оцінити, скільки кроків середовища дасть обраний симулятор;
- прочитати специфікацію компонентів мультикоптера.
Частина 1 · Інтерфейс «агент — середовище»
Єдиного інтерфейсу середовищ у MARL немає: різні фреймворки описують взаємодію по-різному, і алгоритм, написаний під один, рідко запускається на іншому без переробки. Проте загальна ідея та сама.
python
import lbforaging
import gymnasium as gym

env = gym.make("Foraging-8x8-2p-1f-v3")

env.observation_space
# >> Tuple(Box(..., 15), Box(..., 15))
env.action_space
# >> Tuple(Discrete(6), Discrete(6))

observations, info = env.reset(seed=0)
actions = env.action_space.sample()                     # по одній дії на агента
observations, rewards, terminated, truncated, info = env.step(actions)| Елемент | Значення в прикладі |
|---|---|
| Задача | Foraging-8x8-2p-1f-v3 — сітка 8×8, 2 агенти, 1 предмет, версія v3 |
| Спостереження | вектор із 15 чисел на агента, тип Box |
| Дії | Discrete(6) = 4 рухи + collect + noop |
Повернення step() | 4 елементи: спостереження, винагороди, прапорець термінації, службовий словник |
Середовище зобов'язане описати простір спостережень і простір дій — саме з них алгоритм дізнається розміри мереж.
Мережі MARL: спільні параметри
Parameter sharing означає, що агенти використовують один і той самий набір ваг.
| Символ | Значення |
|---|---|
| параметри мережі функції цінності агента | |
| параметри мережі політики агента | |
| кількість агентів |
Дві переваги. Кількість параметрів лишається сталою незалежно від числа агентів, тоді як без спільних параметрів вона росте лінійно. І спільні ваги оновлюються досвідом усіх агентів одразу, тож навчання бачить більший набір траєкторій.
Ціна — сильне припущення однорідності: якщо агенти ділять параметри, їхні політики стають ідентичними. Часткове пом'якшення — додати індекс агента до спостереження, але ємності мережі може не вистачити на кілька справді різних стратегій.
Код: мережа зі спільними параметрами
python
import torch
import torch.nn as nn
from typing import List


class MultiAgentFCNetwork(nn.Module):
    """Окрема мережа на кожного агента: параметрів у n разів більше."""

    def __init__(self, in_sizes: List[int], out_sizes: List[int]):
        super().__init__()
        self.networks = nn.ModuleList([
            nn.Sequential(nn.Linear(i, 64), nn.ReLU(),
                          nn.Linear(64, 64), nn.ReLU(),
                          nn.Linear(64, o))
            for i, o in zip(in_sizes, out_sizes)
        ])

    def forward(self, inputs: List[torch.Tensor]) -> List[torch.Tensor]:
        return [net(x) for net, x in zip(self.networks, inputs)]


class MultiAgentFCNetworkShared(nn.Module):
    """Одна мережа на всіх: кількість параметрів не залежить від n."""

    def __init__(self, in_sizes: List[int], out_sizes: List[int]):
        super().__init__()
        assert len(set(in_sizes)) == 1 and len(set(out_sizes)) == 1, \
            "спільні параметри вимагають однакових розмірів у всіх агентів"
        self.network = nn.Sequential(nn.Linear(in_sizes[0], 64), nn.ReLU(),
                                     nn.Linear(64, 64), nn.ReLU(),
                                     nn.Linear(64, out_sizes[0]))

    def forward(self, inputs: List[torch.Tensor]) -> List[torch.Tensor]:
return [self.network(x) for x in inputs]Від мережі до алгоритму: IDQN
Щоб застосувати ці моделі в IDQN, достатньо задати розміри просторів. Мережа цінності приймає індивідуальне спостереження
python
obs_sizes = (5, 5)          # по 5 чисел у спостереженні кожного з двох агентів
action_sizes = (3, 3)       # по 3 дії на агента

model = MultiAgentFCNetwork(obs_sizes, action_sizes)
# або: MultiAgentFCNetworkShared(obs_sizes, action_sizes)

q_values = model([obs1, obs2])
# >> ([Q11, Q12, Q13], [Q21, Q22, Q23])   Qij — цінність дії j агента i

q_values_stacked = torch.stack(q_values)
print(q_values_stacked.shape)
# >> torch.Size([2, 3])     2 — агенти, 3 — дії

_, a_prime = q_values_stacked.max(-1) # найкраща дія кожного агентаГоловний прийом — окремий «агентний» вимір тензора: підсумовування, максимум і вибірка по ньому замінюють цикли по агентах. Саме він робить перехід до VDN однорядковим.
Від IDQN до VDN: одна операція
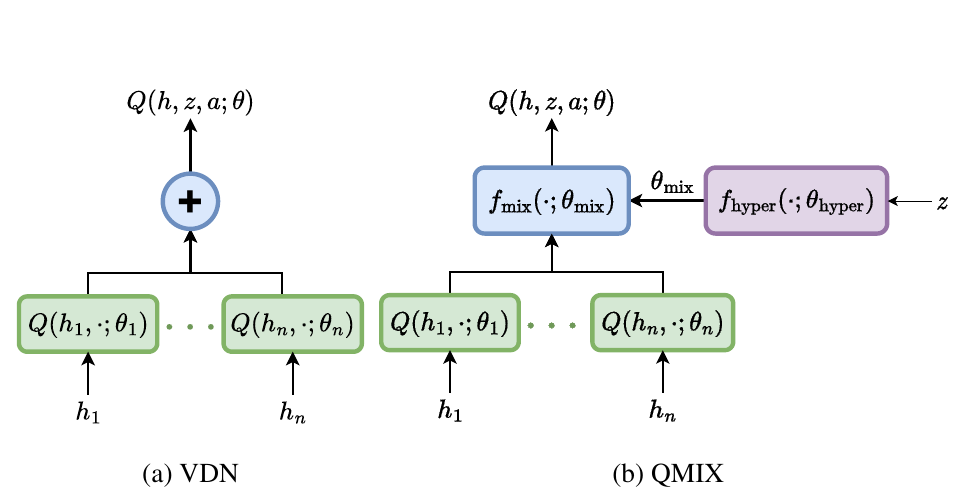
Архітектура мереж VDN і QMIX
python
# IDQN: кожен агент має власну ціль і власну втрату
q_taken = q_values_stacked.gather(-1, actions.unsqueeze(-1)).squeeze(-1)  # [n]
target  = rewards + gamma * (1 - done) * q_next_max                      # [n]

# VDN: усе те саме, але цінності підсумовуються по агентному виміру
q_total      = q_taken.sum(0)                       # <- ЄДИНА зміна
target_total = rewards.sum(0) + gamma * (1 - done) * q_next_max.sum(0)

loss = torch.nn.functional.mse_loss(q_total, target_total.detach())Одна операція .sum(0) перетворює незалежне навчання на декомпозицію цінності. Далі QMIX замінює суму на змішувальну мережу з невід'ємними вагами — але структура коду лишається тією самою.
Що дає ця одна операція на кривих
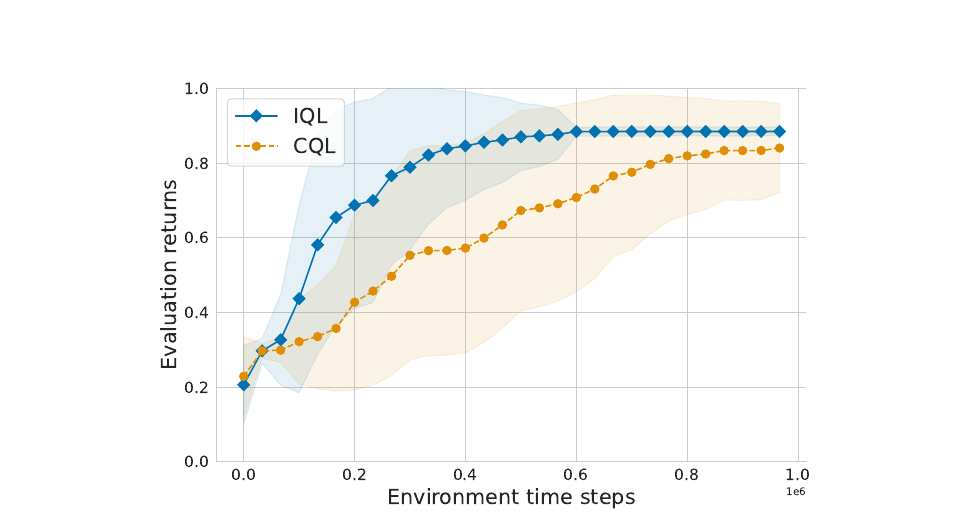
Криві навчання централізованого та незалежного Q-навчання
Різниця між незалежним і централізованим навчанням проявляється не в перших епізодах, а на плато: незалежні агенти сходяться швидше, але до гіршого спільного рішення. Саме цей розрив і закривають VDN і QMIX, лишаючись при цьому децентралізованими у виконанні.
Частина 2 · Як чесно показати результат
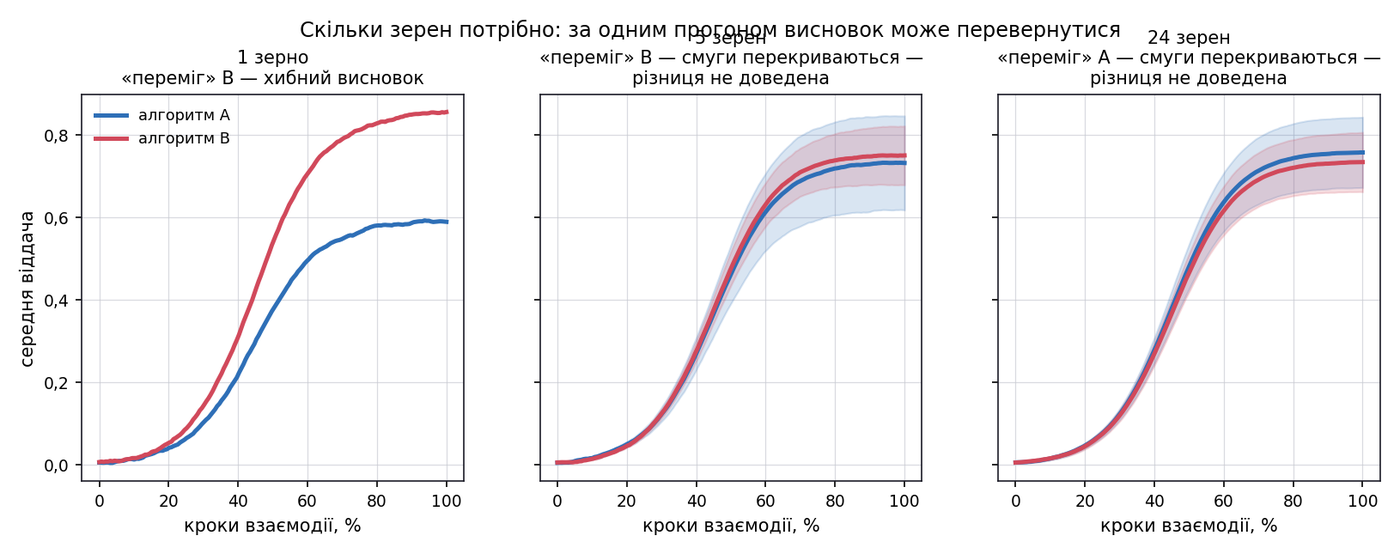
Скільки зерен потрібно, щоб висновок став стабільним
Одна крива з одного запуску не є результатом. На рисунку — два алгоритми, з яких A кращий за побудовою експерименту. За одним прогоном «перемагає» B — тобто висновок просто хибний. За п'ятьма і навіть за двадцятьма чотирма зернами смуги
Звідси два уроки. Перший: одна траєкторія нічого не доводить. Другий, менш очевидний: більше зерен не робить різницю значущою автоматично — вони лише уточнюють оцінку. Щоб стверджувати перевагу, потрібен довірчий інтервал середнього або тест на парних різницях, а не візуальне порівняння смуг розкиду.
Скільки зерен, щоб порівняння щось доводило
Два алгоритми, справжня різниця +0,04 частки успіху. Ведіть повзунок і дивіться, коли висновок стає обґрунтованим.
0.484середнє A (1 запусків)
0.852середнє B
-0.368різниця середніх
—95 % інтервал різниці
ніперевага A доведена
На одному запуску «перемагає» B, хоча кращий за побудовою експерименту — A: висновок просто хибний. За п'ятьма і навіть за двадцятьма чотирма зернами середнє A піднімається вище, але різниця лишається недоведеною. Доведіть повзунок до кінця: інтервал різниці нарешті перестає містити нуль, а смуги розкиду усе одно перекриваються. Саме тому перекриття смуг не є ані доказом, ані спростуванням — стверджувати можна лише за довірчим інтервалом різниці або тестом на парних різницях.
Чек-лист відтворюваного експерименту
Експеримент відтворюваний, якщо стороння людина за вашим описом отримає ті самі числа з точністю до випадковості.
| # | Пункт | Що конкретно фіксуємо |
|---|---|---|
| 1 | Середовище | назва, версія, повний набір параметрів задачі |
| 2 | Зерно | список значень і спосіб задання для середовища, бібліотеки та мережі |
| 3 | Кількість запусків | не менше п'яти незалежних |
| 4 | Гіперпараметри | повна таблиця, включно з тими, що лишилися за замовчуванням |
| 5 | Бюджет пошуку | скільки конфігурацій перебрано — однаково для всіх порівнюваних |
| 6 | Протокол оцінювання | інтервал, кількість епізодів, значення |
| 7 | Статистика на графіку | що саме є лінією і що саме є затіненням |
| 8 | Базова лінія | з чим порівнюємо: випадкова політика, евристика, попередній алгоритм |
| 9 | Обчислювальні витрати | тип прискорювача, час одного запуску, загальний бюджет |
Пункт 5 — найчастіше порушуваний. Порівняння, у якому один алгоритм отримав ширший пошук гіперпараметрів, є некоректним.
Пошук гіперпараметрів і бюджет
Одночасне навчання кількох агентів, кожен з яких змінює середовище для інших, робить MARL особливо чутливим до гіперпараметрів.
bash
for s in $(seq 1 5); do
  for lr in $(seq 0.01 0.01 0.1); do
    python algorithm.py --lr=$lr --seed=$s &
  done
done
waitТакий перебір дає 5 зерен × 10 значень темпу навчання = 50 запусків; символ & запускає кожну команду асинхронно.
| Гіперпараметр | Типове значення |
|---|---|
| Кількість зерен (глибоке навчання) | 5 |
| Кількість запусків (табличне навчання) | 100 |
| Коефіцієнт дисконтування | 0,99; 0,95 для коротких епізодичних задач |
| Темп навчання | |
| Розмір міні-пакета | 128–512 |
| Місткість буфера |
Емпіричне правило: стартувати від значень, які вже добре себе показали, і зосереджуватися на тих гіперпараметрах, що керують дослідженням простору, — наприклад, коефіцієнті ентропії.
Частина 3 · Каталог середовищ
Вибір середовища визначають чотири властивості: спостережуваність, тип спостережень, тип дій, щільність винагород.
| Середовище | Спостережуваність | Спостереження | Дії | Винагороди |
|---|---|---|---|---|
| LBF | повна, часткова | дискретні | дискретні | розріджені |
| MPE | повна, часткова | неперервні | дискр., неперерв. | щільні |
| SMAC | часткова | змішані | дискретні | щільні |
| RWARE | часткова | дискретні | дискретні | розріджені |
| Google Research Football | повна, часткова | змішані | дискретні | обидва |
| Hanabi | часткова | дискретні | дискретні | розріджені |
| Overcooked | повна | змішані | дискретні | розріджені |
| Melting Pot | часткова | неперервні | дискретні | обидва |
| PettingZoo | повна, часткова | змішані | дискр., неперерв. | обидва |
Практичне правило для старту: беріть найпростіше середовище, у якому ваша гіпотеза ще має сенс. LBF і MPE дозволяють відлагодити алгоритм за хвилини, а не за дні.
Симулятори БПЛА: пропускна здатність вирішує все
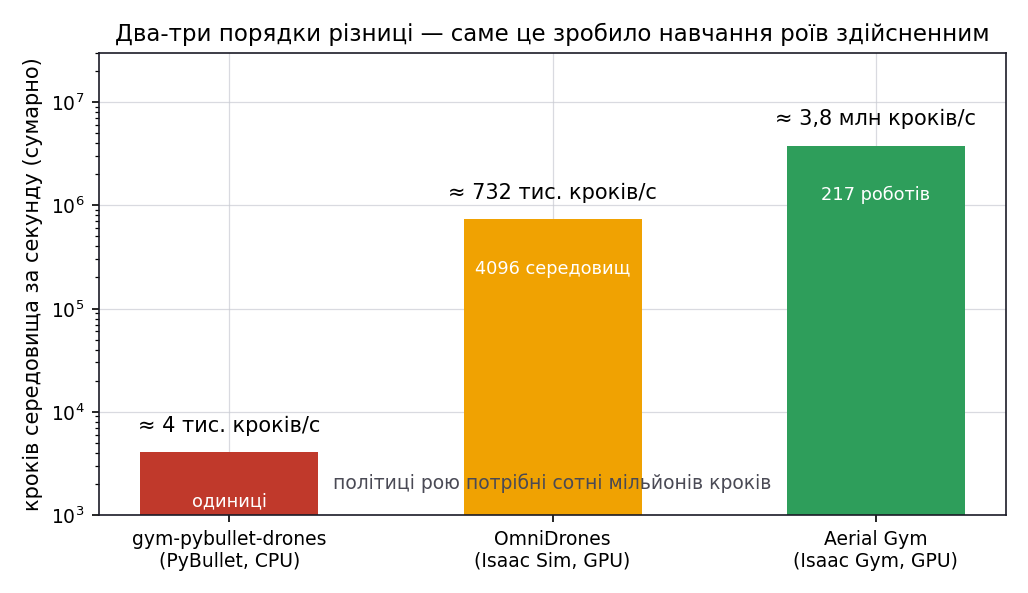
Пропускна здатність симуляторів у логарифмічному масштабі
Політиці рою потрібні сотні мільйонів кроків середовища. Отже, вирішальний параметр — не точність фізики, а кількість кроків за секунду.
| Симулятор | Основа | Паралельних середовищ | Для чого придатний |
|---|---|---|---|
| gym-pybullet-drones | PyBullet, CPU | одиниці | навчальні лабораторні, мінімальний поріг входу |
| OmniDrones | Isaac Sim, GPU | до 4096 | багатоагентні бенчмарки роїв |
| Aerial Gym | Isaac Gym, GPU | навчання за глибинними зображеннями |
Різниця в понад два порядки — саме вона, а не нові алгоритми, зробила навчання роєвих політик здійсненним.
Частина 4 · Компоненти мультикоптера
Мультикоптер складається з відокремлених модулів. Якщо збирати апарат, не розуміючи принципу роботи компонентів, результатом буде або погана якість польоту, або нездатність злетіти.
| Група | Компоненти й ключові числа |
|---|---|
| Рама | фюзеляж, шасі, канал. Конфігурації QUAD +, QUAD X, HEXA +, HEXA X, Y6, OCTO. Діагональ: F450 = 450 мм, F550 = 550 мм |
| Силова установка | мотор, ESC, гвинт, батарея. Гвинт 1045 = діаметр 10″, крок 4,5″. Мотор 2212 = статор Ø22 мм, висота 12 мм. 1000 KV = 1000 об/хв без навантаження на 1 В |
| Живлення | комірка LiPo: 3,7 В номінал, 4,2 В повний заряд. «3S1P» = 11,1 В. ESC: запас за струмом 20 % |
| Командно-керувальна | польотний контролер, IMU, барометр, магнітометр, GNSS, радіоканал, телеметрія |
Позначення читаються однозначно: 2212/1000KV з гвинтом 1045 на 3S — це конкретна робоча точка, для якої в паспорті мотора є таблиця тяги й струму. Саме з неї беруть максимальну тягу для розрахунку запасу з Модуля 02.
Апаратні платформи роїв
| Платформа | Масштаб | Роль у дослідженнях |
|---|---|---|
| s-bot / Swarm-bots | до 20 роботів, самозбирання | колективне транспортування, покриття, пошук |
| Swarmanoid | 2006–2010, три типи роботів | різнорідний рій, пошук і доставляння |
| Kilobot | тисяча роботів, демонстрації із сотнями | масштаб, колективні рішення |
| e-puck | понад 30 — уже складно й дорого | універсальний наземний робот |
| Crazyflie | до 49 апаратів у Crazyswarm | основна літальна платформа роєвих досліджень |
Обмеження, які варто назвати студентам прямо: час польоту нанокоптера ≈ 6 хвилин, локалізація в приміщенні зовнішня, кожен прогін коштує заміни акумуляторів. Тому симулятор — основний інструмент, а реальний політ — перевірка.
Частина 5 · Типові помилки реалізації
- Цикл по агентах замість агентного виміру тензора. Працює, але повільно й погано читається;
.sum(0),.max(-1),.gather(-1, …)роблять те саме за один виклик. - Спільні параметри для різнорідних агентів. Формально код запуститься, але припущення однорідності порушено, і політики зійдуться до компромісу, поганого для всіх ролей.
- Градієнт крізь ціль. У DQN і похідних ціль треба відірвати від графа (
.detach()), інакше навчання розходиться. - Одна крива в звіті. Найчастіша методична помилка; див. рисунок із зернами.
- Різний бюджет пошуку в порівнянні. Друга за частотою; робить порівняння недійсним.
- Вісь епізодів замість кроків взаємодії. Алгоритм, що робить більше оновлень на епізод, виглядатиме кращим безпідставно.
Висновки
- Єдиного інтерфейсу середовищ у MARL немає, але мінімум однаковий:
reset(),step(), опис просторів спостережень і дій. - Агентний вимір тензора замінює цикли по агентах і робить перехід IDQN → VDN однорядковим.
- Parameter sharing тримає кількість параметрів сталою й прискорює навчання, але вимагає однорідності агентів.
- Одна крива з одного запуску не є результатом: за одним прогоном висновок може перевернутися, за п'ятьма — лишитися недоведеним.
- Чесне порівняння вимагає однакового бюджету пошуку гіперпараметрів для всіх алгоритмів.
- Вирішальний параметр симулятора — пропускна здатність, а не точність фізики: різниця між CPU і GPU становить понад два порядки.
- Реальний рій обмежений залізом: ≈ 6 хвилин польоту, зовнішня локалізація в приміщенні, до 49 апаратів на Crazyswarm.
Підсумок курсу
Курс пройшов повний шлях, який студент має вміти відтворити самостійно:
1Задача рою й архітектура
2Дані апарата й комунікація
3Навчена політика в симуляції
4Метрики й обмеження
| Модуль | Що він додав до цього ланцюга |
|---|---|
| 01 | архітектура системи, означення рою, критерії доцільності |
| 02 | мова опису: орієнтація, стійкість, лапласіан, |
| 03 | класичні закони керування роєм і їхні межі |
| 04–05 | постановка задачі навчання, одноагентна й багатоагентна |
| 06–07 | глибокі методи, CTDE, інваріантні кодувальники, декомпозиція цінності |
| 08 | прикладні місії: покриття, пошук, розподіл цілей |
| 09 | що робити, коли все ламається |
| 10 | як це реалізувати й чесно виміряти |
Головний висновок курсу: жодна властивість рою не з'являється автоматично. Ані масштабованість, ані відмовостійкість, ані безпека. Кожну треба спроєктувати, реалізувати й виміряти.
Література та ресурси
- Albrecht S. V., Christianos F., Schäfer L. Multi-Agent Reinforcement Learning: Foundations and Modern Approaches. MIT Press, 2024. Розділи 10–11 (реалізація, середовища). marl-book.com
- Papoudakis G., Christianos F., Schäfer L., Albrecht S. V. Benchmarking Multi-Agent Deep RL Algorithms in Cooperative Tasks. NeurIPS Datasets and Benchmarks, 2021. arXiv:2006.07869
- Henderson P. та ін. Deep Reinforcement Learning that Matters. AAAI, 2018. arXiv:1709.06560 — чому одна крива нічого не доводить.
- Agarwal R. та ін. Deep Reinforcement Learning at the Edge of the Statistical Precipice. NeurIPS, 2021. arXiv:2108.13264
- Quan Quan. Introduction to Multicopter Design and Control. Springer, 2017. Розділи 2–4 (компоненти, силова установка, стенд).
- Preiss J. A., Hönig W. та ін. Crazyswarm: A Large Nano-Quadcopter Swarm. ICRA, 2017.
- Інструменти: PyTorch · Gymnasium · PettingZoo · EPyMARL · Stable-Baselines3
- Симулятори: gym-pybullet-drones · OmniDrones · Aerial Gym · PX4 SITL · Crazyswarm2