Тема
Модуль 07 · Багатоагентний градієнт політики
Як перейти від «кожен учиться сам» до навчання, у якому агенти враховують одне одного: централізовані критики, розподіл заслуг і вибір рівноваги.
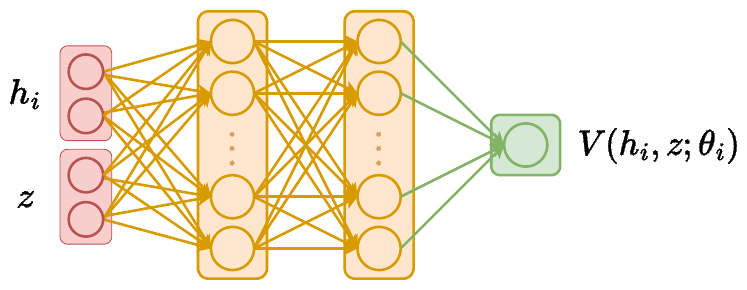
Джерело: Albrecht, Christianos, Schäfer, Multi-Agent Reinforcement Learning, MIT Press, 2024, рис. 9.2.
Зміст лекції
Модуль 06 дав механіку PPO для одного апарата. Тут той самий апарат стає одним із багатьох, і з'ясовується, що прямий перенос працює гірше, ніж міг би.
| Частина | Про що |
|---|---|
| 1. Незалежне навчання | найпростіший підхід, і чому він усе-таки працює |
| 2. Багатоагентна теорема | що змінюється у градієнті, коли агентів багато |
| 3. Централізовані критики | критик стану, критик дій, що подавати на вхід |
| 4. Розподіл заслуг | контрфактична базова лінія й COMA |
| 5. Вибір рівноваги | чому рій сходиться до боязкої поведінки |
Наскрізна лінія модуля: під час навчання можна користуватися чим завгодно, під час виконання — лише власним спостереженням.
Одна технічна примітка про позначення. У Модулі 06 усе стосувалося одного апарата, тому індекс агента був зайвий:
Результати навчання
Після лекції ви зможете:
- оцінити, чому в задачі рою таблиця станів не працює вже на трьох агентах;
- реалізувати незалежне навчання й назвати три його вади;
- пояснити, чому on-policy незалежне навчання страждає від нестаціонарності менше за off-policy;
- виписати багатоагентну теорему про градієнт політики й сказати, чим вона відрізняється від одноагентної;
- пояснити, чому централізований критик не порушує децентралізованого виконання;
- сказати, що обов'язково подавати на вхід критика і чому без цього оцінка зсунута;
- побудувати контрфактичну базову лінію, пояснити, яку проблему вона розв'язує, і перевірити на числах, що вона не зсуває градієнт;
- на числах показати, чому градієнт політики заганяє рій у боязку рівновагу.
Частина 1 · Незалежне навчання
Найпростіше, що можна зробити з роєм: посадити на кожен апарат окремого одноагентного агента й дати їм учитися одночасно. Сусіди при цьому вважаються частиною середовища.
Незалежне навчання: означення й три вади
Кожен агент тримає власні параметри, власний буфер і вчиться лише на власних спостереженнях, діях і винагородах. Для DQN це IDQN, для актор-критика — IA2C, для PPO — IPPO.
Три вади, які випливають прямо з означення:
- політика не може використати інформацію про сусідів ані під час навчання, ані під час виконання;
- нестаціонарність: сусіди вчаться одночасно, тому середовище під агентом змінюється, поки він до нього пристосовується;
- агент не відрізняє випадковість середовища від наслідків дій сусідів: коли їхні політики змінюються, для нього змінюються і переходи, і спостереження, і винагороди.
Попри це незалежне навчання лишається робочою першою спробою й у багатьох задачах конкурує зі складнішими методами.
Чому off-policy страждає більше за on-policy
Різниця між ними більша, ніж здається, і саме через неї IDQN у рої поводиться гірше за IA2C і IPPO.
On-policy алгоритми завжди вчаться на найсвіжіших політиках сусідів, бо градієнт рахують по щойно зібраних траєкторіях. Шахова аналогія: щойно другий агент навчився протидіяти дебютові першого, траєкторії першого це негайно відображають.
Off-policy із буфером продовжує вчитися на застарілих записах, де той самий дебют ще працював. Буфер мовчки припускає, що збережений досвід лишається актуальним, — а в рої він застаріває тим швидше, чим активніше вчаться сусіди.
Що з цим роблять:
| Прийом | Ідея |
|---|---|
| Менший буфер | старі записи витісняються швидше |
| Ваги важливісної вибірки в буфері | зберігати ймовірності дій усіх агентів на момент збору й перезважувати |
| Hysteretic Q-learning | менший темп навчання для оновлень, що знижують оцінку |
| Leniency | ігнорувати знижувальні оновлення з імовірністю, яка згасає з навчанням |
Скільки станів має навіть маленька задача рою
Перш ніж говорити про алгоритми, варто побачити масштаб. Класична навчальна задача — сітка, на якій кілька агентів збирають предмети, причому важкий предмет вимагає двох агентів одночасно.
| Конфігурація | Розмір простору станів | Що показало навчання |
|---|---|---|
| сітка 11×11, 2 агенти, 2 предмети | 42 602 | вміщується в таблицю, розв'язується табличними методами |
| сітка 15×15, 2 агенти, випадковий старт | незалежний актор-критик доходить до віддачі 1 за 40 млн кроків, близько 3 годин на звичайному процесорі | |
| сітка 15×15, 3 агенти, 3 предмети | віддача 0,5 — у середньому половина предметів — менш ніж за 6 годин |
Два висновки. По-перше, таблиця закінчується майже одразу: досить збільшити сітку на чотири клітинки й додати агента, щоб станів стало більше, ніж атомів у краплі води. По-друге, від переходу до третього агента простір виріс у сто тисяч разів, а результат упав удвічі — це і є та сама проблема масштабування, яку в Модулі 05 назвали четвертим викликом.
Для рою БПЛА це означає просту річ: жодного перебору станів не буде, політику доведеться наближати мережею з самого початку.
Частина 2 · Багатоагентна теорема про градієнт політики
Одноагентна теорема припускає, що віддача залежить від однієї політики. У рої вона залежить від політик усіх — і це треба записати чесно.
Що саме змінюється у формулі
Чотири відмінності від одноагентного випадку, кожна з наслідком:
| Що змінилось | Наслідок |
|---|---|
| Замість стану | середовище частково спостережуване, стану ніхто не бачить |
| цінність дії агента залежить від того, що роблять інші | |
| Матсподівання береться і за | оцінка чинна лише для поточних політик сусідів |
| Градієнт логарифма — за політикою, обумовленою лише | виконання лишається децентралізованим |
Останній рядок — це і є формальний запис CTDE прямо в теоремі: навчатися можна з повною інформацією, діяти — лише зі своєю.
Незалежне навчання — частковий випадок цієї ж формули, у якому
Частина 3 · Централізовані критики
Ключове спостереження, з якого все випливає: під час навчання на критика немає жодних обмежень, а після навчання критик не використовується взагалі — дії видає лише актор.
Критик стану: що подавати на вхід
Критик називають централізованим, якщо він обумовлений будь-якою інформацією понад власні спостереження й дії агента. Позначимо цю додаткову інформацію
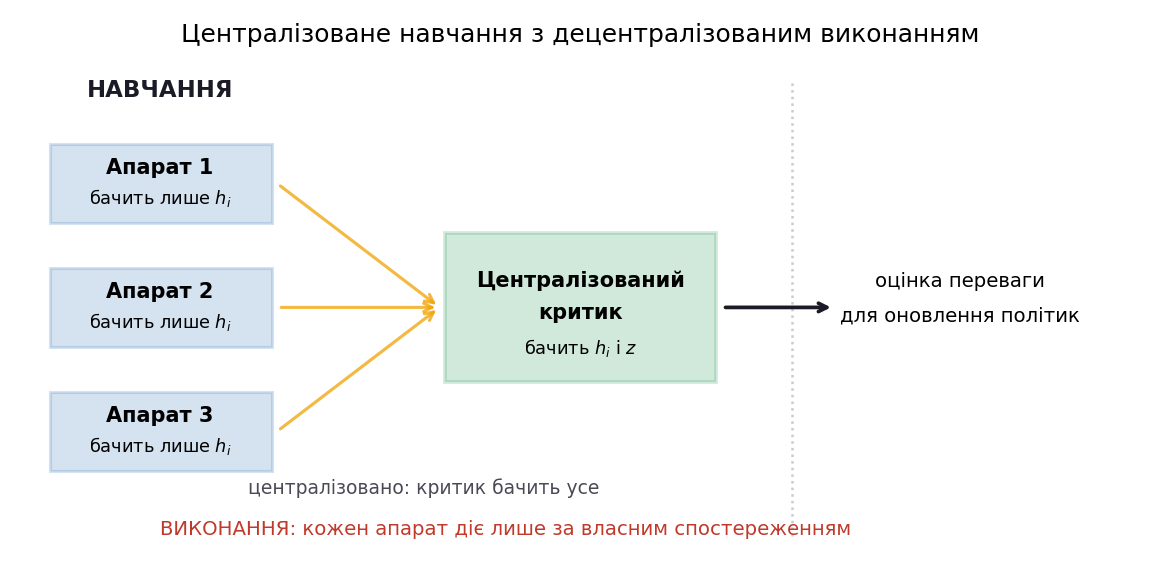
Централізоване навчання з децентралізованим виконанням
На вхід критика йдуть дві речі: власна історія агента
Додаткова інформація — компроміс. Теоретично будь-яка зайва інформація підвищує дисперсію градієнта, не покращуючи гарантій збіжності. Емпірично вона часто допомагає: критик у глибокому навчанні все одно не сходиться до істини, і централізовані дані іноді рятують від локального оптимуму.
Практична рекомендація: подавати історію станів
Чому критикові обов'язково подавати історію агента
Тонкість, на якій легко втратити місяць налагодження. Здається природним обумовити критика на поточному стані середовища — він же централізований, нехай бачить усе. Але цього мало.
Уявіть дві траєкторії, які приводять у той самий стан
Виходить, що критик має менше інформації, ніж актор, і не може визначити, яку саме політику він оцінює. Формальний наслідок доведено: критики, обумовлені на спостереженнях або на стані замість історій спостережень, дають зсув і підвищену дисперсію градієнта політики.
Практичний рецепт із цього: власна історія
Експеримент, який показує виграш централізованого критика
Гра «диктор і слухач» — навмисно вигадана так, щоб координація була єдиним способом виграти.
- Слухач бачить своє положення й три різні орієнтири, але не знає, який із них цільовий.
- Диктор бачить лише форму потрібного орієнтира й може передати одне число від 1 до 3.
- Винагорода спільна: слухач має дійти до цільового орієнтира.
Складність у тому, що навчання йде з двох боків одночасно. Диктор має навчитися розрізняти форми й передавати різні числа — і робити це достатньо довго, щоб слухач устиг навчитися на них реагувати. Поки сигнал безладний, слухачеві немає на що спиратися; поки слухач не реагує, диктор не отримує сигналу, що передає правильно.
Результат вимірювання: актор-критик із централізованим критиком, який бачить спостереження обох агентів, сходиться до істотно вищих віддач, ніж незалежне навчання на тій самій задачі.
Для рою це прямий аргумент: там, де успіх залежить від узгодження, незалежне навчання застрягає не через слабкий алгоритм, а тому, що агент фізично не бачить причини свого успіху.
Критик цінності дій і чому тут не можна брати прийоми DQN
Другий варіант — критик, який оцінює конкретну спільну дію:
Зверніть увагу: ціль рахується за реально застосованими наступними діями всіх агентів, тобто це SARSA-подібне оновлення, а не
Архітектурний трюк, без якого це не працює. Наївна мережа з виходом на кожну спільну дію має розмірність виходу, що росте експоненційно з числом агентів. Розв'язок: подавати
Це архітектура критика COMA — вона знадобиться вже в наступній частині, бо саме завдяки їй контрфактична базова лінія рахується одним проходом мережі. Не плутайте з MADDPG: там критик
Частина 4 · Розподіл заслуг
Спільна винагорода не каже, хто саме її заробив. Якщо рій отримав
Різницеві винагороди: ідея й дві її проблеми
Питання розподілу заслуг ставлять так: що було б, якби цей агент зробив щось інше, а решта діяла так само?
Тут
На практиці ця формула впирається у дві речі:
| Проблема | У чому саме |
|---|---|
| Яку дію брати за замовчуванням | «Нічого не робити» для дрона не визначено: не летіти — теж дія, і вона теж має наслідки |
| Звідки взяти | Потрібен доступ до самої функції винагороди, щоб перерахувати її для дії, якої не було |
Першу проблему знімає простий хід: брати дію за замовчуванням не вигадану, а з поточної політики самого агента. Другу — оцінювати не винагороди, а віддачі навченим критиком. Разом це й дає COMA з наступної картки.
Контрфактична базова лінія й COMA
Ідея з різницевих винагород: спитати, що було б, якби агент зробив щось інше, а решта діяла так само.
Дія «за замовчуванням» тут не вигадується, а береться з поточної політики самого агента: чи привела його дія до кращого результату, ніж типова дія цієї ж політики.
COMA піднімає цю ідею з рівня одношагових винагород на рівень віддач:
Три властивості: базова лінія не зміщує градієнт, вона дешево обчислюється на архітектурі з попереднього розділу (один прохід дає
⚠️ Але метод нестабільний. Емпірично COMA страждає від високої дисперсії базової лінії й неузгоджених оцінок цінності, що дає нестійке навчання й іноді погані результати. Це чесна оцінка з підручника, а не застереження про всяк випадок.
Код: контрфактична базова лінія
Перевіримо на числах два твердження: базова лінія не зсуває градієнт і при цьому зменшує його розкид.
python
import numpy as np

# Q(спільна дія) для агента 1: рядок — його дія, стовпець — дія сусіда.
Q = np.array([[8.0, 1.0, 0.0],
              [3.0, 6.0, 2.0],
              [0.0, 2.0, 5.0]])
pi_1 = np.array([0.20, 0.50, 0.30])

a2 = 1                          # сусід зробив свій хід
q = Q[:, a2]                    # один прохід мережі дає всі |A_1| значень
baseline = float(pi_1 @ q)      # маргіналізація = скалярний добуток
adv = q - baseline

def gradient_stats(coef):
    """Матсподівання й слід коваріації оцінки градієнта по логітах."""
    mean, sq = np.zeros(3), 0.0
    for a in range(3):
        g = coef[a] * (np.eye(3)[a] - pi_1)   # score function для softmax
        mean += pi_1[a] * g
        sq += pi_1[a] * float(g @ g)
return mean, sq - float(mean @ mean)Уся «дорога» частина — це pi_1 @ q: один скалярний добуток на крок.
Результат коду: та сама оцінка, менший розкид
text
Q(спільна дія) для агента 1, стовпець — дія сусіда:
               ліворуч     прямо  праворуч
    ліворуч        8.0       1.0       0.0
      прямо        3.0       6.0       2.0
   праворуч        0.0       2.0       5.0

сусід обрав «прямо»: рядок Q = [1. 6. 2.]
базова лінія = pi_1 · Q = 3.80

дія            Q     перевага
    ліворуч    1.0       -2.80
      прямо    6.0       +2.20
   праворуч    2.0       -1.80

E[градієнт] із сирою Q  = [-0.56  1.1  -0.54]
E[градієнт] із перевагою = [-0.56  1.1  -0.54]
матсподівання збігаються — базова лінія незсунена

розкид оцінки: сира Q = 6.16, перевага = 1.40 — менше в 4.4 раза

базова лінія за різних дій сусіда: 3.10 3.80 2.50
вона залежить від того, що зробили сусіди, тому її рахують щокрокуДва рядки матсподівання збігаються до знака — це та сама незсуненість, про яку йшлося на попередній картці, тільки перевірена, а не оголошена. А розкид упав у 4,4 раза: саме заради цього базову лінію й вводять.
Останній рядок пояснює, чому не можна порахувати лінію один раз і запам'ятати: вона різна для кожної дії сусідів, тому обчислюється заново на кожному кроці.
Частина 5 · Вибір рівноваги
Останній сюжет модуля — найпрактичніший для рою, бо пояснює конкретну поведінку, яку ви побачите в лабораторних.
Чому рій сходиться до боязкої поведінки
Гра «полювання на оленя»: удвох на оленя — по 4 кожному; той, хто пішов на зайця сам, поки сусід ловив оленя, отримує 3; якщо на зайця пішли обидва — по 2. Хто пішов на оленя сам, отримує 0.
| Олень | Заєць | |
|---|---|---|
| Олень | 4, 4 | 0, 3 |
| Заєць | 3, 0 | 2, 2 |
Обидва варіанти — рівноваги. Але тепер порахуємо, куди веде градієнт політики з рівномірної початкової політики
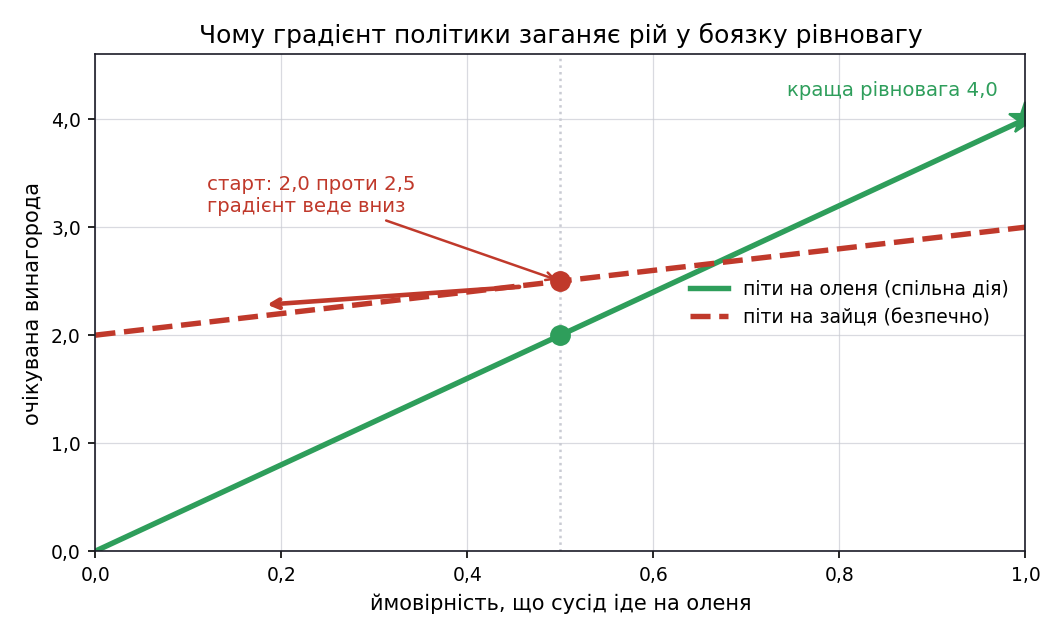
Чому градієнт політики заганяє рій у боязку рівновагу
Градієнт підіймає ймовірність зайця. Це робить оленя ще менш привабливим для сусіда, той теж зсувається до зайця — додатний зворотний зв'язок, який замикає рій у гіршій рівновазі з винагородою 2 замість 4.
Пряма аналогія для рою БПЛА: маневр, який дає найкращий результат за злагодженості всіх, але штрафується при розсинхронізації, витісняється «безпечним зависанням». У лабораторній роботі 4 ви побачите м'якший варіант того самого ефекту: якщо штраф за близькість переважує виграш від прямого маршруту, рій навчиться обходити сусідів по широкій дузі замість того, щоб проходити поруч.
Як лікують боязку рівновагу
Проблема з попередньої картки має ім'я — вибір рівноваги, і в неї є прямий розв'язок.
Ідея: агент припускає, що решта грає найкраще для нього, а не як заманеться. Формально він вибирає свою політику проти найкращої відповіді сусідів, а не проти поточної:
Це припущення виглядає наївним, але саме воно ламає ту петлю: агент більше не «здається» першим, побачивши, що сусід поки що обережний.
Виміряні результати:
| Задача | Централізований актор-критик | Метод із вибором рівноваги |
|---|---|---|
| Гра сходження, оптимум | застряг на | дійшов до |
| Збирання предмета вдвох, штраф | навчився взагалі не пробувати | зрештою розв'язав задачу |
Другий рядок — те, що ви побачите в лабораторній роботі 4 у м'якшому вигляді. Але й ціна відома: метод явно перебирає спільні дії сусідів, тому погано масштабується, і це відкрита задача, а не вирішена.
Порівняння підходів
| IPPO | MAPPO | Критик дій | COMA | |
|---|---|---|---|---|
| Режим | децентралізовано | CTDE | CTDE | CTDE |
| Вхід критика | лише | те саме | ||
| Що додає | нічого понад PPO | стійкість до нестаціонарності | оцінку конкретної спільної дії | розподіл заслуг |
| Масштабованість | найкраща | добра | вхід росте з числом агентів | як у критика дій |
| Відома проблема | нестаціонарність | зайва інформація підвищує дисперсію | простір спільних дій росте експоненційно | нестабільне навчання |
| Коли брати в рої | однорідний рій, щільний локальний сигнал | часткова спостережуваність, є симулятор із повним станом | потрібна оцінка саме спільної дії | лише якщо розподіл заслуг — головна проблема |
MAPPO — це PPO, у якого критик бачить глобальну інформацію, а актор лише локальну. Жодних змін у втратах і жодних надбудов. Практичні поради авторів: нормалізувати цінності, тримати
Джерело окреме. Підручник курсу MAPPO не розглядає — ані MAPPO, ані MADDPG у ньому немає за назвою. Механіку централізованого критика підручник дає, а імена алгоритмів і практичні поради взято зі статей, указаних у списку літератури.
Висновки
- Незалежне навчання — робоча перша спроба, і в багатьох задачах воно конкурує зі складнішими методами. Але воно не бачить сусідів і страждає від нестаціонарності.
- On-policy незалежне навчання страждає менше за off-policy, бо завжди вчиться на найсвіжіших політиках сусідів; буфер натомість зберігає застарілі записи.
- Багатоагентна теорема відрізняється від одноагентної чотирма речами: історія замість стану, спільна дія в аргументі
, матсподівання за всіма політиками й градієнт лише за власною історією. Останній множник записує CTDE формально. - Централізований критик безкоштовний під час виконання, бо після навчання не використовується. Але власну історію агента подавати обов'язково — без неї оцінка зсунута.
- Зайва інформація на вході критика підвищує дисперсію градієнта, не покращуючи гарантій. Це компроміс, а не безумовне покращення.
- Контрфактична базова лінія розв'язує розподіл заслуг коректно й дешево, але COMA на практиці нестабільний.
- Градієнт політики систематично заганяє рій у боязку рівновагу: безпечна дія виграє в очікуванні, поки сусіди ще не навчилися.
Перехід до Модуля 08
Цей модуль дав загальний апарат: як узагалі влаштоване навчання, коли агентів багато. Але він нічого не сказав про те, що агенти — це апарати в просторі, яких може бути вісім, а може сто двадцять вісім.
Модуль 08 · Багатоагентне навчання для роїв БПЛА додає до цього апарату дві речі, специфічні саме для рою: інваріантність спостереження до перестановки й до кількості сусідів, і декомпозицію цінності, яка дозволяє навчати рій зі спільною винагородою.
Література та ресурси
- Albrecht S. V., Christianos F., Schäfer L. Multi-Agent Reinforcement Learning: Foundations and Modern Approaches. MIT Press, 2024 — розділи 9.3–9.4. Вільний PDF
- Lowe R., Wu Y., Tamar A. та ін. Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments (MADDPG). NeurIPS, 2017. arXiv:1706.02275
- Foerster J., Farquhar G., Afouras T. та ін. Counterfactual Multi-Agent Policy Gradients (COMA). AAAI, 2018. arXiv:1705.08926
- Yu C., Velu A., Vinitsky E. та ін. The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games (MAPPO). arXiv:2103.01955
- Christianos F., Papoudakis G., Albrecht S. V. Pareto Actor-Critic for Equilibrium Selection in Multi-Agent Reinforcement Learning. arXiv:2209.14344
- Papoudakis G., Christianos F., Schäfer L., Albrecht S. V. Benchmarking Multi-Agent Deep Reinforcement Learning Algorithms in Cooperative Tasks. arXiv:2006.07869