Тема
Лекція 01 · Вступ до машинного навчання
Перша лекція курсу відповідає на три питання: що саме означає «навчатися з даних», які бувають задачі машинного навчання і чому реальні дані майже ніколи не готові до того, щоб одразу подати їх у модель. Усі приклади ми розберемо на двох справжніх наборах — Iris і списку пасажирів «Титаніка».
Зміст лекції
Лекція побудована як шлях від питання «що це взагалі таке» до першої повністю навченої й чесно оціненої моделі.
- Що таке машинне навчання. Означення, різниця з класичним програмуванням, місце серед суміжних дисциплін.
- Дані та їхні дефекти. Таблиця зразків і ознак, типи ознак, пропуски, викиди, дисбаланс класів — усе на реальному наборі даних.
- Три режими навчання. З учителем, без учителя, з підкріпленням; регресія проти класифікації.
- Нотація і будова методу. Позначення курсу, трійка «модель — функція втрат — оптимізація».
- Узагальнення. Тренувальна і тестова помилка, розбиття вибірки, золоте правило, витік даних.
- Чесна інтерпретація. Кореляція та причинність, обмеження методів.
Порядок не випадковий: спершу з'ясуємо, що модель отримує на вхід, потім — що вона з цим робить, і лише наприкінці — як зрозуміти, чи можна їй довіряти.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чим машинне навчання відрізняється від класичного програмування, і сказати, що саме є «результатом» навчання;
- визначити для довільної прикладної задачі, що тут є зразком, ознакою й міткою;
- розрізнити навчання з учителем, без учителя і з підкріпленням та навести приклад кожного;
- відрізнити задачу регресії від задачі класифікації за типом цільової змінної;
- побудувати конвеєр підготовки даних із заповненням пропусків, кодуванням категорій і масштабуванням;
- пояснити, навіщо потрібні окремі тренувальна, валідаційна й тестова вибірки, і сформулювати золоте правило;
- розпізнати витік даних і пояснити, чому кореляція в даних не доводить причинного зв'язку.
Комп'ютер бачить не зображення, а масив чисел
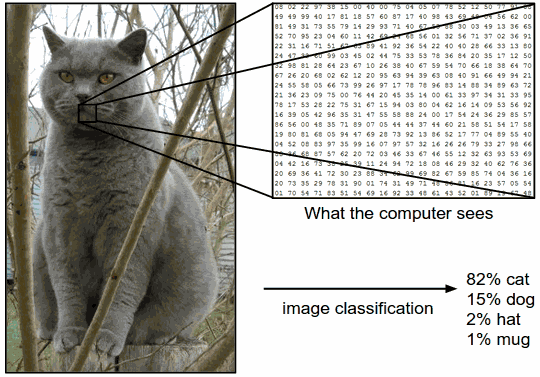
Фотографія кота для комп'ютера — це прямокутна таблиця з кількох сотень тисяч чисел, кожне з яких описує яскравість одного пікселя. Жодне окреме число не містить поняття «кіт». Проте система, навчена на мільйоні знімків, повертає розподіл упевненості: 82 % кіт, 15 % собака, решта — інше.
Ніхто не писав правила «якщо піксель 1042 темніший за піксель 1043, то це вухо». Правило виникло саме — з прикладів. Так само влаштовані пошук, машинний переклад, рекомендації й медична діагностика за знімком: усюди правило добуто з даних, а не сформульовано людиною.
Означення: алгоритми, які навчаються з даних
Курс дотримується двох формулювань, які доповнюють одне одного.
"What is Machine Learning? — algorithms that can learn from data." — EPFL CS-433, лекція 01a
"Using computer to automatically detect patterns in data and use these to make predictions or decisions." — UBC CPSC 340, лекція 1
Перше формулювання коротке й задає напрям: машинне навчання (machine learning) — це алгоритми, здатні навчатися з даних. Друге пояснює, з чого складається процес: комп'ютер автоматично виявляє закономірності й використовує їх для прогнозів або рішень. Ключове слово в обох — «автоматично»: закономірність не описує людина, її знаходить алгоритм.
Джерела: EPFL CS-433 · UBC CPSC 340
Дві традиції програмування
Найкоротший спосіб пояснити машинне навчання — порівняти напрям потоку даних.
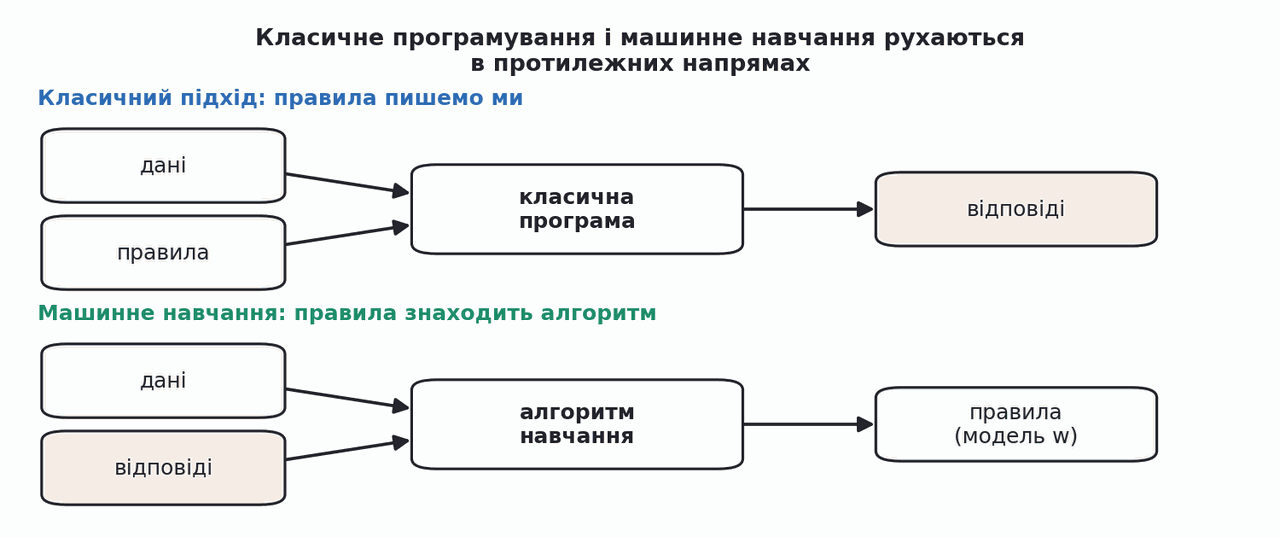
У класичному підході ми пишемо правила самі: програма отримує дані й правила, а видає відповіді. Так працює бухгалтерія, компілятор, будь-який алгоритм сортування.
У машинному навчанні напрям обертається: алгоритм отримує дані разом із бажаними відповідями, а видає правила. Ці правила зберігаються у вигляді чисел — параметрів моделі, які в курсі позначатимемо
Машинне навчання серед суміжних дисциплін
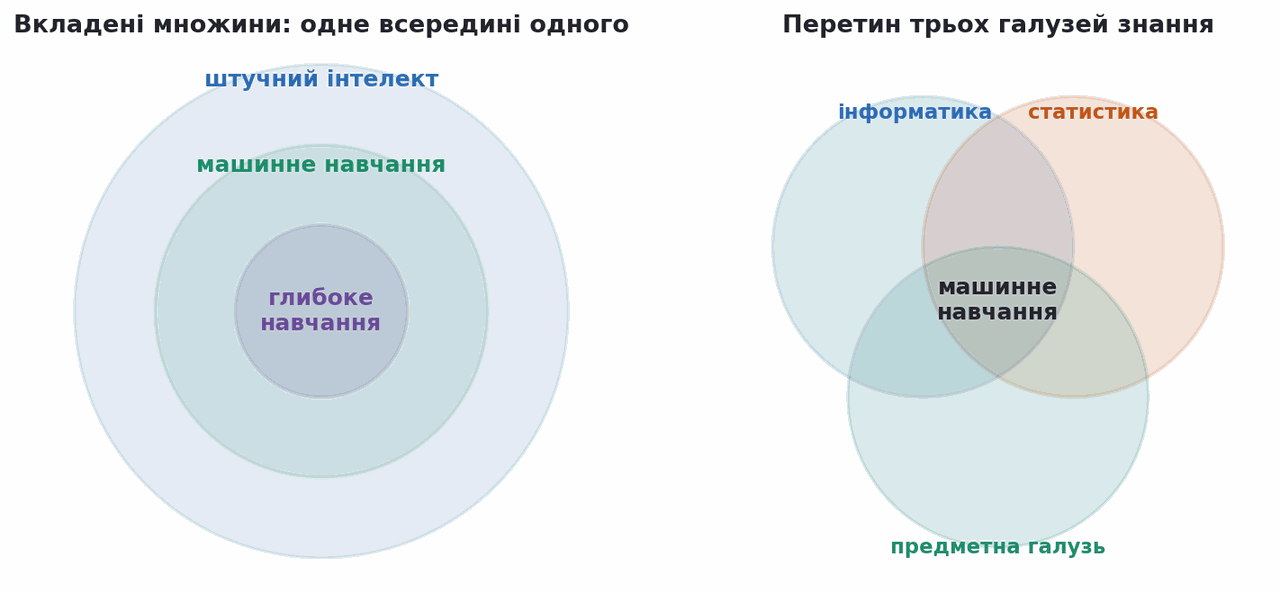
Терміни «штучний інтелект», «машинне навчання» і «глибоке навчання» часто вживають як синоніми, хоча вони позначають вкладені одна в одну області. Штучний інтелект — найширше поняття, що охоплює й системи, побудовані на явно записаних правилах. Машинне навчання — його частина, у якій правила видобуваються з даних. Глибоке навчання — частина машинного навчання, що спирається на багатошарові нейронні мережі; йому присвячено лекції 10–14.
За походженням машинне навчання лежить на перетині трьох галузей: інформатика дає алгоритми й обчислення, статистика — моделі й міру невизначеності, предметна галузь — розуміння того, що взагалі варто прогнозувати.
Дані — це таблиця зразків і ознак
"[Data is] a collection of examples, and their features. Each row is an 'example', each column is a 'feature'." — UBC CPSC 340, лекція 2
Рядок таблиці — зразок (example, sample), стовпець — ознака (feature). Один зі стовпців ми оголошуємо міткою (label, target) — саме його модель має навчитися передбачати.
Вивід код запущено, вивід не редагувався
text
 survived  pclass    sex  age    fare embarked
        0       3   male 22.0  7.2500        S
        1       1 female 38.0 71.2833        C
        1       3 female 26.0  7.9250        S
        1       1 female 35.0 53.1000        S

пропуски: survived 0, pclass 0, sex 0, age 177, fare 0, embarked 2
частка вижилих: 0.384
На що дивитися: у віку бракує 177 значень із 891, у порту посадки — двох, а вижила лише 38,4 % пасажирів, тож класи нерівні.
Ознаки бувають різних типів
Тип ознаки визначає, що з нею взагалі можна робити: категоріальну не можна усереднювати, порядкову не можна кодувати як незалежні категорії, бо це втратить порядок.
| Тип | Підтип | Ознака в наборі «Титанік» |
|---|---|---|
| категоріальна | бінарна | sex — чоловік або жінка |
| категоріальна | номінальна | embarked — порт посадки: Шербур, Квінстаун, Саутгемптон |
| числова | порядкова | pclass — клас каюти: 1, 2, 3 (порядок є, різниця не рівна) |
| числова | лічильна | sibsp, parch — кількість родичів на борту |
| числова | неперервна | age — вік у роках, fare — вартість квитка |
Класифікація типів наведена за UBC CPSC 340; приклади підібрані з набору даних цієї лекції.
Джерело: UBC CPSC 340 · Exploratory Data Analysis
Набір даних лекції: пасажири «Титаніка»
Список пасажирів «Титаніка» — 891 запис із 15 стовпцями. Для кожного пасажира відомі клас каюти, стать, вік, кількість родичів на борту, вартість квитка й порт посадки. Передбачаємо мітку survived: вижив пасажир чи ні.
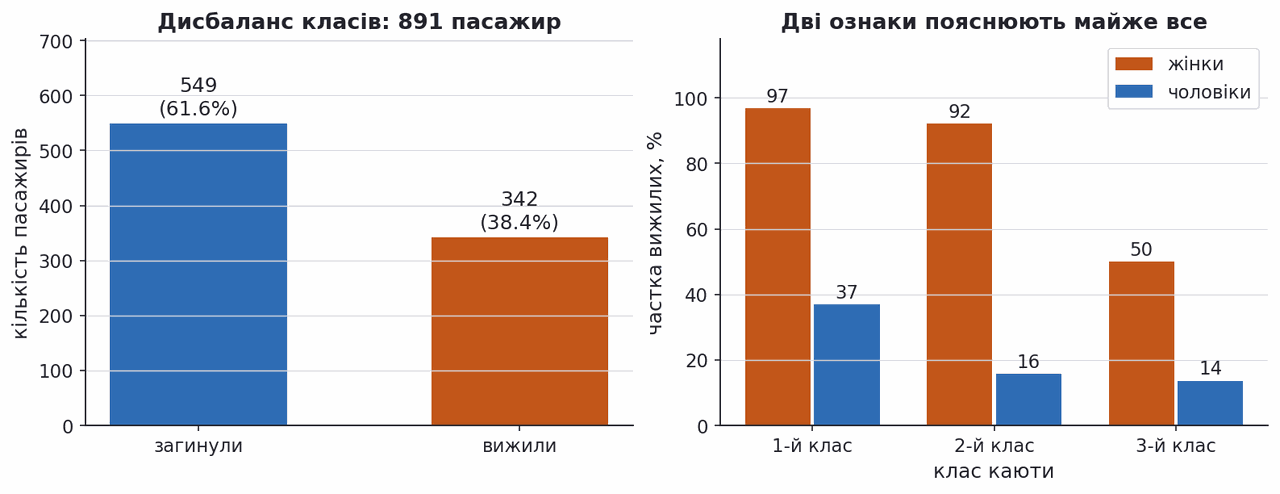
Набір цікавий не розміром, а тим, що містить одразу всі типові проблеми реальних даних — пропуски, категоріальні ознаки, викиди й дисбаланс класів. Вижили 342 пасажири з 891, тобто 38,4 %: класи незбалансовані, і модель, яка завжди відповідатиме «загинув», уже матиме 61,6 % правильних відповідей.
Дві ознаки пояснюють майже всю різницю у виживанні: серед жінок першого класу вижили 97 %, серед чоловіків третього — 14 %.
Джерело даних: seaborn-data · titanic.csv
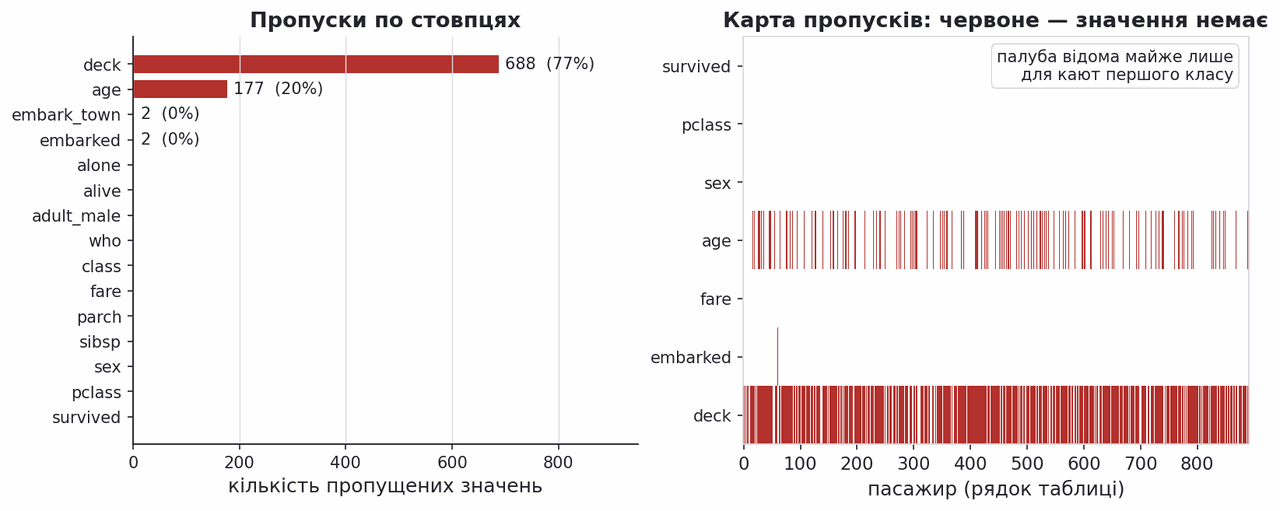
Пропуски: у стовпці палуби бракує 688 значень із 891
Пропущене значення (missing value) — не нуль і не нейтральне число. Це відсутність відомостей, і причина відсутності часто сама по собі інформативна.
У стовпці deck немає 688 значень із 891, тобто 77 %. Карта пропусків праворуч показує, що вони розподілені не випадково: номер палуби зафіксовано майже виключно для дорогих кают, тож сам факт «палуба відома» непрямо кодує клас каюти. Вік невідомий для 177 пасажирів, порт посадки — лише для двох.
Стовпець із 77 % пропусків зазвичай не рятують — його прибирають. Стовпець із 20 % пропусків, як age, заповнюють, бо вік справді впливає на результат.
Пропуски заповнюють, а категорії кодують числами
Модель приймає лише числову матрицю. Тому кожну категоріальну ознаку розкладають на набір нулів та одиниць — це пряме кодування (one-hot encoding), — а пропуски заповнюють медіаною для числових ознак і найчастішим значенням для категоріальних.
Вивід код запущено, вивід не редагувався
text
було (891, 7) → стало (891, 12)
числові лишились як є: age, fare, sibsp, parch
pclass   → pclass_1, pclass_2, pclass_3
sex      → sex_female, sex_male
embarked → embarked_C, embarked_Q, embarked_S
На що дивитися: сім вихідних стовпців перетворилися на дванадцять: чотири числові лишилися, а три категоріальні розклалися на вісім стовпців із нулів та одиниць.
Джерело: scikit-learn · ColumnTransformer
Що саме робить підготовка даних
Вісім справжніх рядків «Титаніка» — серед них ті, у кого бракує віку або порту посадки. Вмикайте кроки по черзі й дивіться, як змінюється таблиця: це рівно те, що виконує
ColumnTransformer із коду вище. | pclass | sex | age | sibsp | parch | fare | embarked |
|---|---|---|---|---|---|---|
| 3 | male | NaN | 0 | 0 | 8,46 | Q |
| 2 | male | NaN | 0 | 0 | 13 | S |
| 3 | female | NaN | 0 | 0 | 7,22 | C |
| 1 | female | 38 | 0 | 0 | 80 | NaN |
| 1 | female | 62 | 0 | 0 | 80 | NaN |
| 3 | male | 22 | 1 | 0 | 7,25 | S |
| 1 | female | 38 | 1 | 0 | 71,28 | C |
| 1 | female | 35 | 1 | 0 | 53,1 | S |
(891, 7)форма всієї таблиці
179пропусків лишилося
німодель це прийме
Поки пропуски не заповнено, NaN у таблиці — і жодна лінійна модель не навчиться: арифметика з ним дає знову NaN. Поки категорії не закодовано, стовпець sex містить слова, а не числа. Увімкніть обидва кроки — сім стовпців перетворяться на дванадцять, бо кожна категорія розгортається в набір нулів і одиниць; саме це число друкує код вище. Стандартизація нічого не додає до форми, але приводить ознаки до спільного масштабу — вік у роках і тариф у фунтах перестають конкурувати величиною. Зверніть увагу: медіана віку 28 років і найчастіший порт «S» рахуються тільки за навчальною частиною, інакше в модель просочиться інформація про тест.
Розподіли, викиди й асиметрія
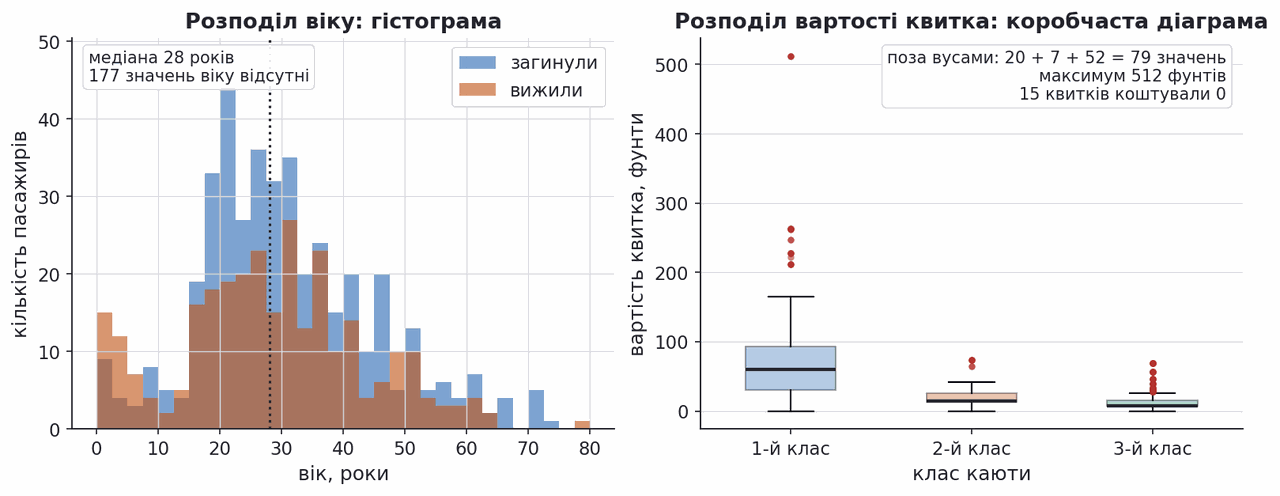
Перш ніж навчати модель, кожну ознаку варто побачити окремо. Гістограма показує форму розподілу, коробчаста діаграма (box plot) — медіану, розкид і викиди (outliers).
Вік пасажирів розподілений майже симетрично навколо медіани 28 років, з окремим сплеском на дітях до 10 років. Вартість квитка поводиться інакше: розподіл різко асиметричний, за межі вусів виходять 79 значень (20 у першому класі, 7 у другому, 52 в третьому), максимум становить 512 фунтів проти медіани 14,5. П'ятнадцять квитків коштували рівно нуль — таке значення треба перевіряти окремо, перш ніж вважати його помилкою введення.
Викид не завжди треба видаляти. Спочатку треба зрозуміти, звідки він узявся: помилка приладу, помилка введення чи справжнє рідкісне спостереження.
Зведені числа не замінюють графік
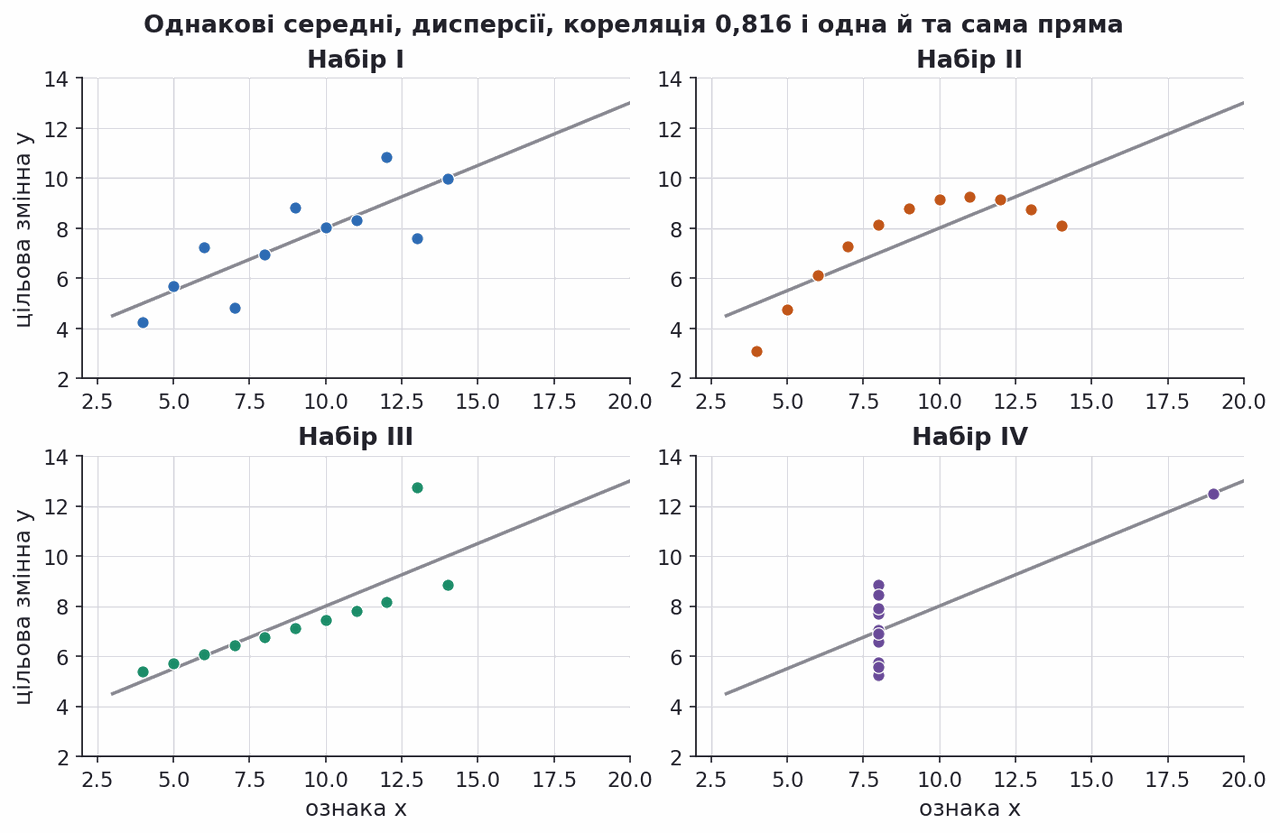
Класичний аргумент проти того, щоб довіряти самим лише зведеним статистикам, — квартет Анскомба. Чотири набори по одинадцять точок мають однакове середнє за
Виглядають вони при цьому цілком по-різному: перший набір справді лінійний, другий описує параболу, у третьому одна точка викривляє пряму, у четвертому взагалі немає залежності — лінію тримає єдине спостереження праворуч.
Звідси практичне правило курсу: дивитися на дані очима — не етап, який можна пропустити заради економії часу.
Джерело: Anscombe F. J. Graphs in Statistical Analysis, 1973
Навчання з учителем: мітки відомі заздалегідь
Навчання з учителем (supervised learning) — режим, у якому кожен зразок тренувальної вибірки супроводжується правильною відповіддю.
"Our goal is, given a training set, to learn a function h : X → Y so that h(x) is a 'good' predictor for the corresponding value of y." — Stanford CS229, вступний розділ
У курсі ми позначаємо цю функцію
Друга розвилка стосується мети. Прогнозування (prediction) відповідає на питання «яка вага людини зростом 170 см», інтерпретація (interpretation) — на питання «чи вищі люди важчі». Одна й та сама модель може служити обом цілям, але вимоги до неї різні.
Джерело: Stanford CS229 · Main Notes
Регресія передбачає число
"Regression is to relate input variables to the output variable, to either predict outputs for new inputs and/or to understand the effect of the input on the output." — EPFL CS-433, лекція 01b
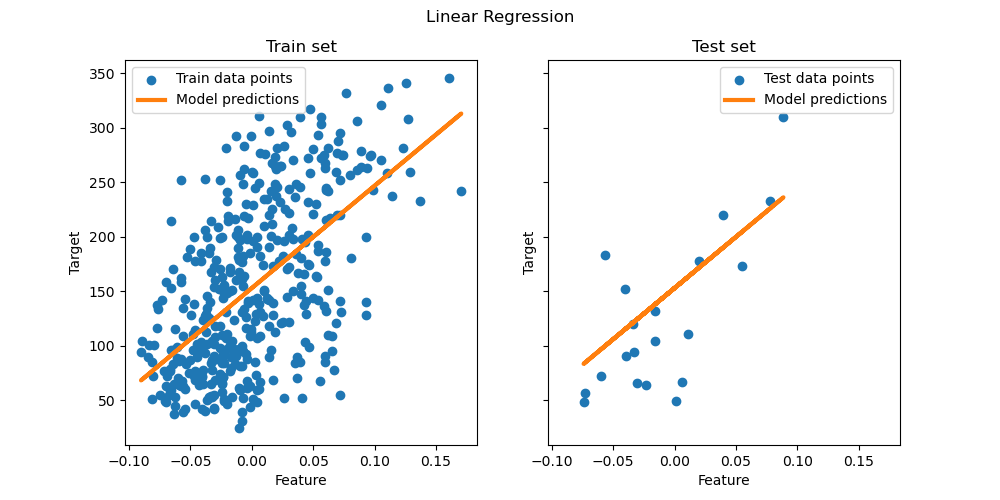
Дані регресії — пари
На рисунку — найпростіший випадок з однією ознакою: пряма, підігнана до тренувальних точок ліворуч, застосовується до нових точок праворуч. Видно і головне обмеження: точки не лягають на пряму, тож будь-який прогноз матиме похибку, і завдання полягає в тому, щоб зробити її якомога меншою на нових даних. Побудові такої прямої повністю присвячена лекція 02.
Класифікація передбачає категорію
"When y can take on only a small number of discrete values … we call it a classification problem." — Stanford CS229, вступний розділ
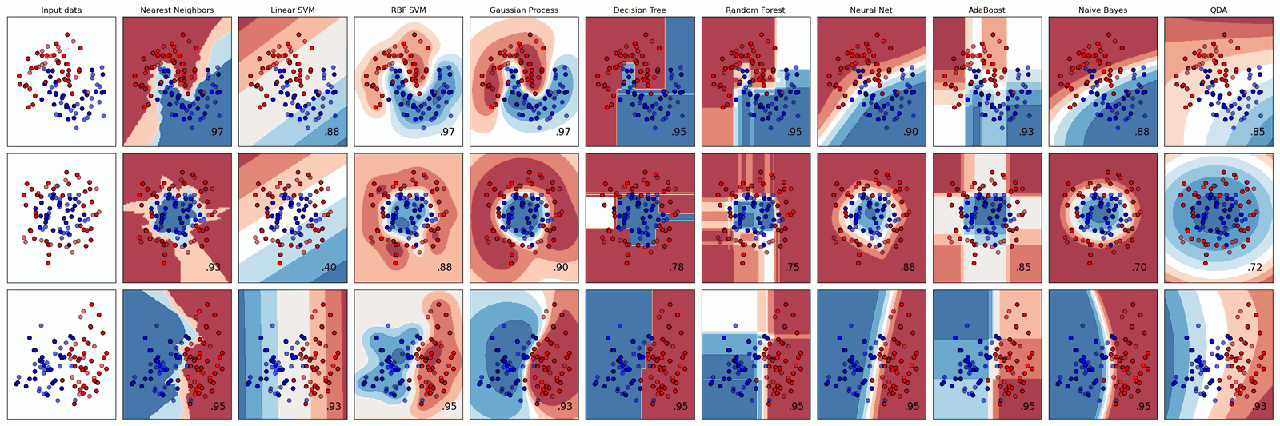
Класифікатор ділить простір ознак на області, по одній на клас. Поверхня між областями називається межею рішення (decision boundary), і саме її форма відрізняє методи один від одного.
На рисунку десять різних класифікаторів працюють на трьох однакових наборах даних. Перший стовпець — самі дані, далі — межі рішень і частка правильних відповідей у правому нижньому куті кожної панелі. Головний висновок: універсального методу немає, форма межі має відповідати формі даних. Класифікації присвячені лекції 05–07.
Джерело: scikit-learn · Classifier comparison
Iris: класична задача класифікації на трьох видах
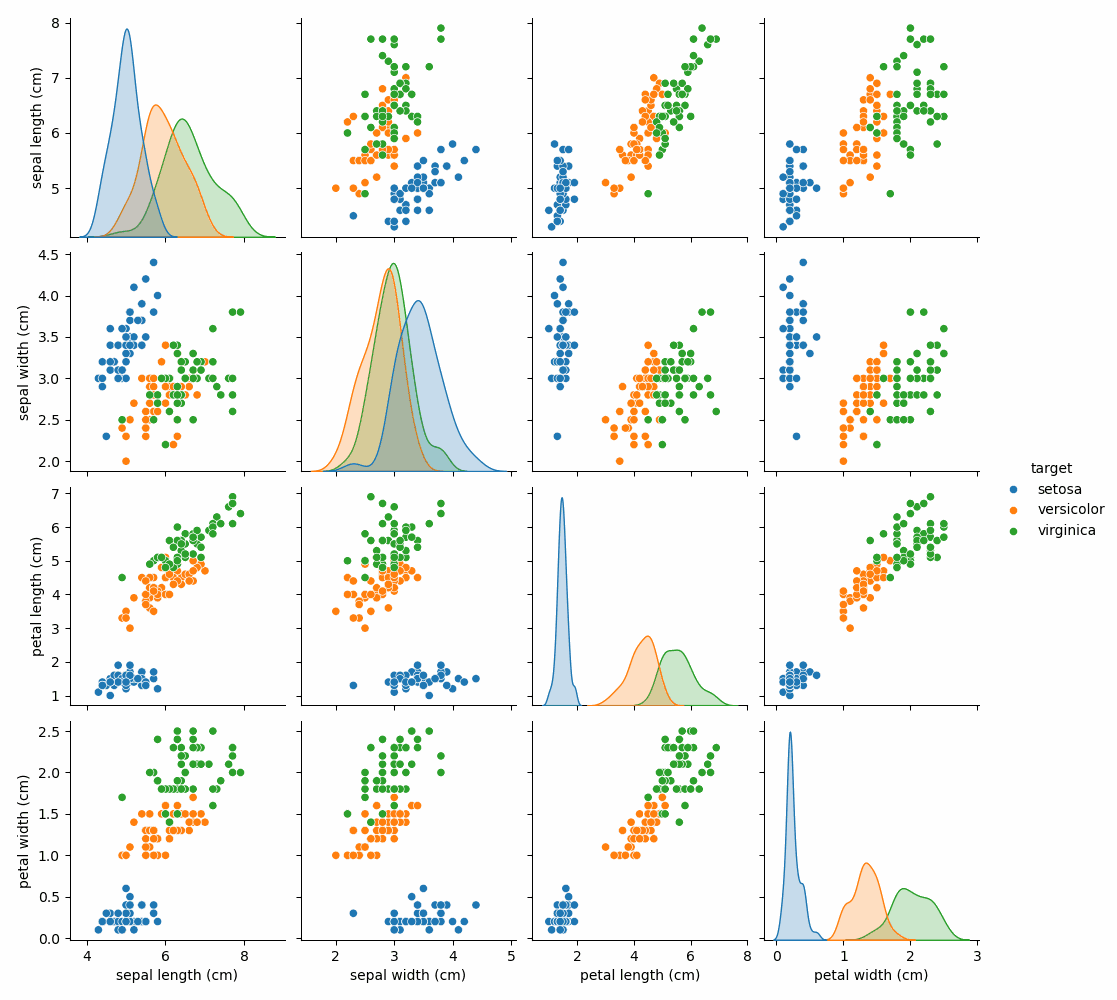
Набір Iris — 150 квіток трьох видів півників, для кожної виміряно чотири ознаки: довжину й ширину чашолистка та пелюстки в сантиметрах. Передбачається вид рослини. Дані зібрав Едгар Андерсон, а 1936 року їх опублікував Рональд Фішер; відтоді набір став стандартним прикладом у підручниках.
Парний графік (pair plot) показує всі пари ознак одразу, а на діагоналі — розподіл кожної ознаки окремо. Видно головне: вид setosa відділяється від решти однією прямою за довжиною пелюстки, а versicolor і virginica частково перекриваються — саме там будь-який класифікатор помилятиметься.
Джерело: scikit-learn · PCA on Iris · UCI Iris
Навчання без учителя шукає структуру в даних
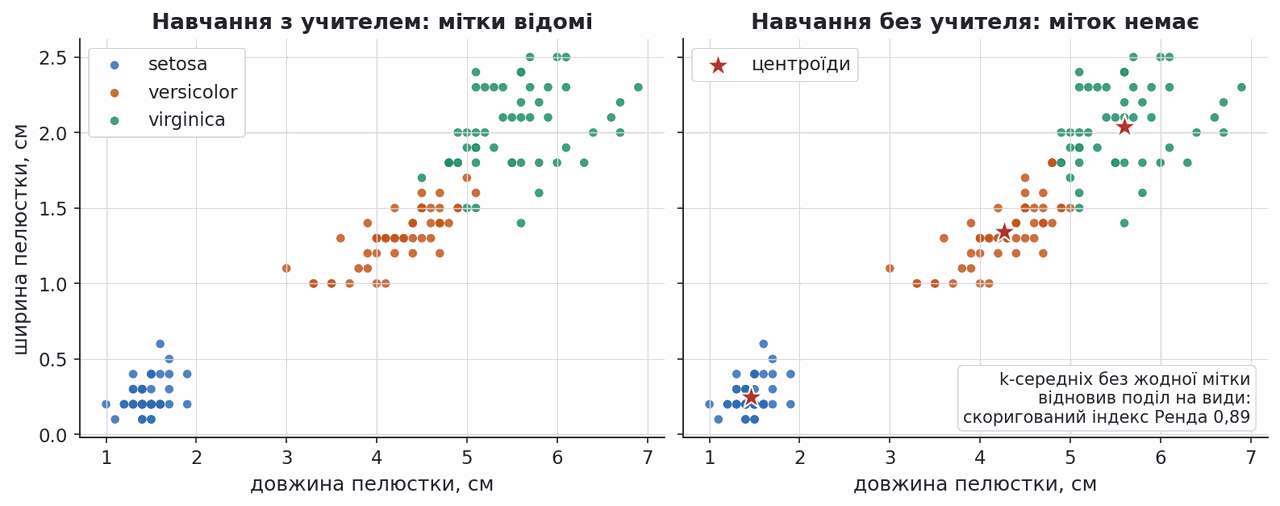
Навчання без учителя (unsupervised learning) відрізняється однією обставиною: міток немає. Є лише
Найпоширеніша така задача — кластеризація (clustering): розбити зразки на групи так, щоб усередині групи вони були схожі, а між групами — ні.
Ліворуч на рисунку показані справжні види півників, праворуч — три групи, які метод
Кластеризація — це сімейство різних алгоритмів
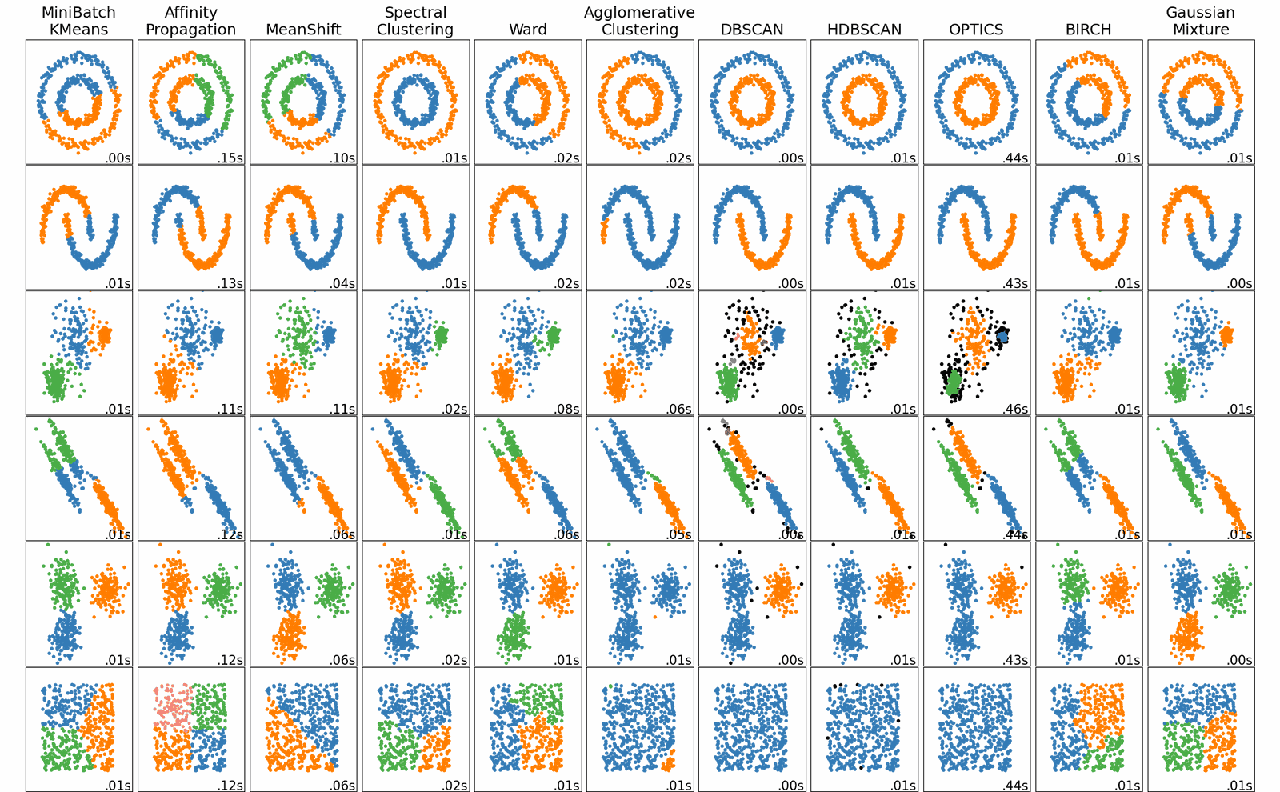
Слово «кластеризація» не називає конкретного методу. Алгоритмів десятки, і вони спираються на різні уявлення про те, що таке група: віддаленість від центру, щільність точок, послідовне злиття найближчих пар.
Наслідок видно на рисунку: на однакових даних різні алгоритми дають різні відповіді. Метод
Вибір алгоритму — це припущення про форму груп, і перевірити його можна тільки на власних даних. Детально ці методи розглянуто в лекції 08.
Зниження розмірності стискає десятки ознак у дві
Друга велика задача без учителя — зниження розмірності (dimensionality reduction): замінити багато ознак на кілька нових так, щоб втратити якнайменше інформації.
Мотивів два. Перший практичний: людина не вміє дивитися на чотиривимірний простір, а на двовимірний — уміє. Другий обчислювальний: у стиснутому просторі методи працюють швидше й стійкіше.
На рисунку чотири ознаки Iris замінено трьома головними компонентами — новими напрямами, уздовж яких дані розкидані найсильніше. Види залишилися розділеними, хоча жодну з початкових ознак більше не використано. Метод головних компонент розібрано в лекції 09.
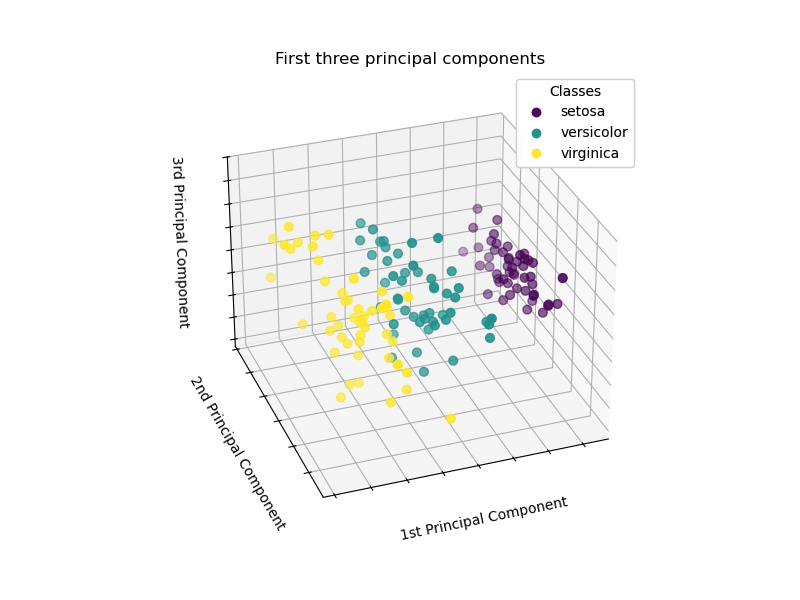
Джерело: scikit-learn · PCA on Iris dataset
Пошук аномалій виділяє нетипові спостереження
Третя задача без учителя — пошук аномалій (anomaly detection). Модель вивчає, як виглядає типове спостереження, і позначає ті, що на нього не схожі: шахрайську транзакцію, збій датчика, браковану деталь.
Це прямий родич сюжету про викиди у вартості квитка. Різниця в тому, що там ми дивилися на одну ознаку очима, а тут алгоритм оцінює нетиповість одразу в багатовимірному просторі, де точка може мати цілком звичайні значення кожної ознаки окремо й бути аномальною за їх поєднанням.
Кожен стовпець рисунка — окремий алгоритм, кожен рядок — свій набір даних. Помаранчевим позначено те, що алгоритм визнав нормою, синім — аномалії; чорні контури окреслюють знайдену межу норми.
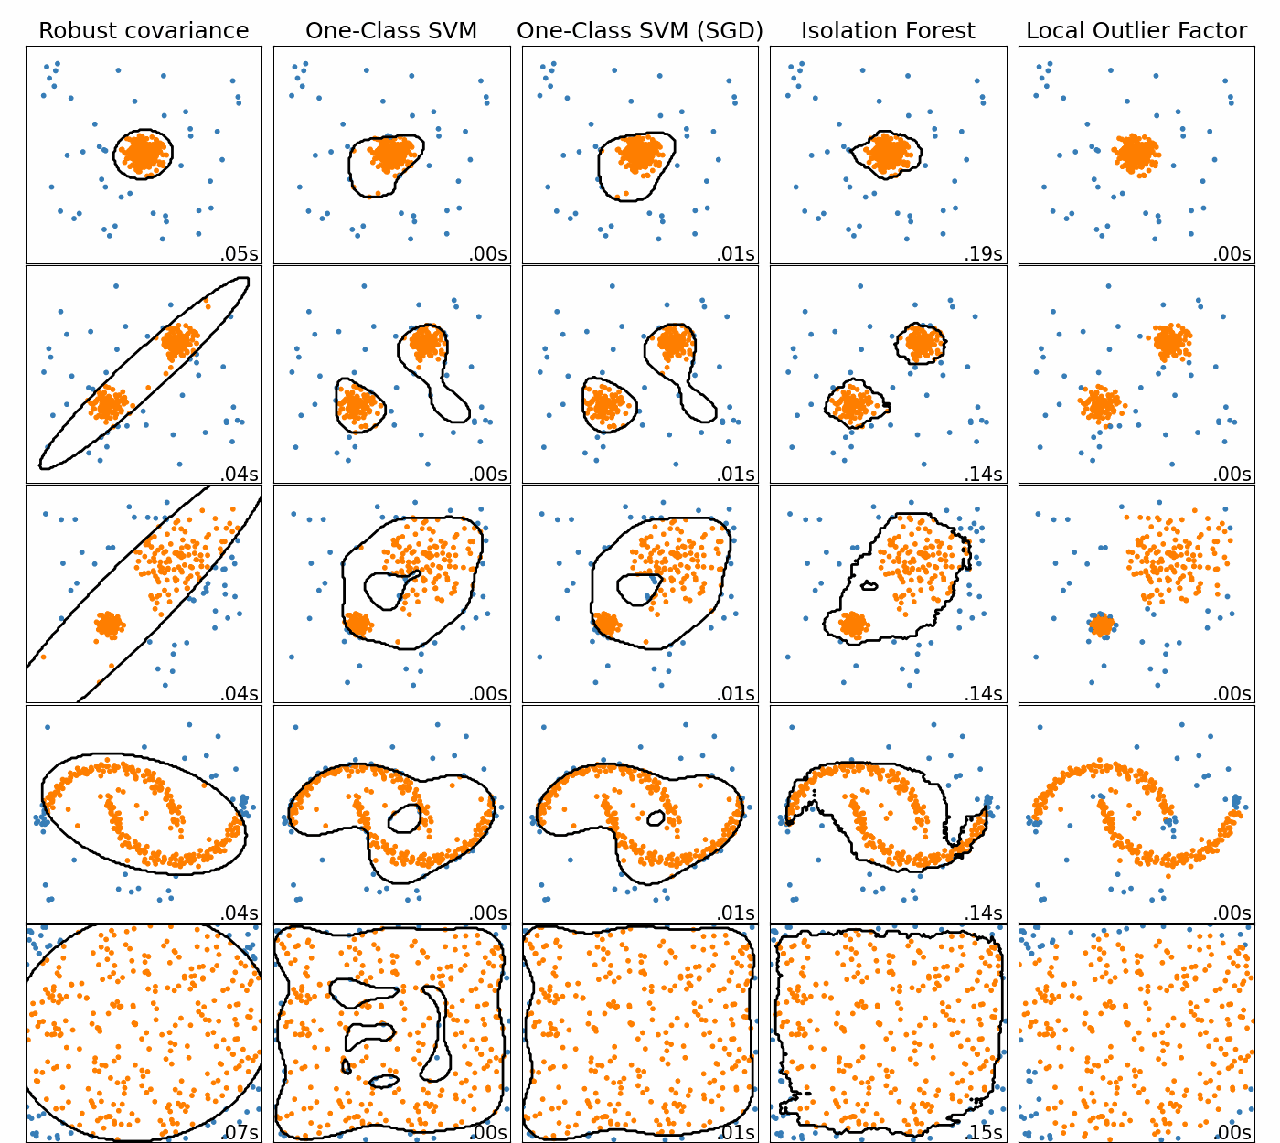
Джерело: scikit-learn · Comparing anomaly detection algorithms
Навчання з підкріпленням здобуває дані дією
Третій режим не має готового набору даних узагалі. Агент (agent) діє в середовищі (environment), середовище повертає новий стан і винагороду (reward), і агент поступово з'ясовує, які дії приносять більше винагороди в довгостроковій перспективі.
Правильної відповіді для кожного окремого кроку ніхто не повідомляє — відома лише сумарна винагорода наприкінці. Саме так навчають грати в шахи й го, керувати роботом, розподіляти обчислювальні ресурси.
Окремо стоїть самонавчання (self-supervised learning), де мітки будують із самих даних: приховують частину тексту чи зображення й вимагають від моделі її відновити. На цьому побудовані сучасні мовні моделі, і до нього ми повернемось у лекції 13.
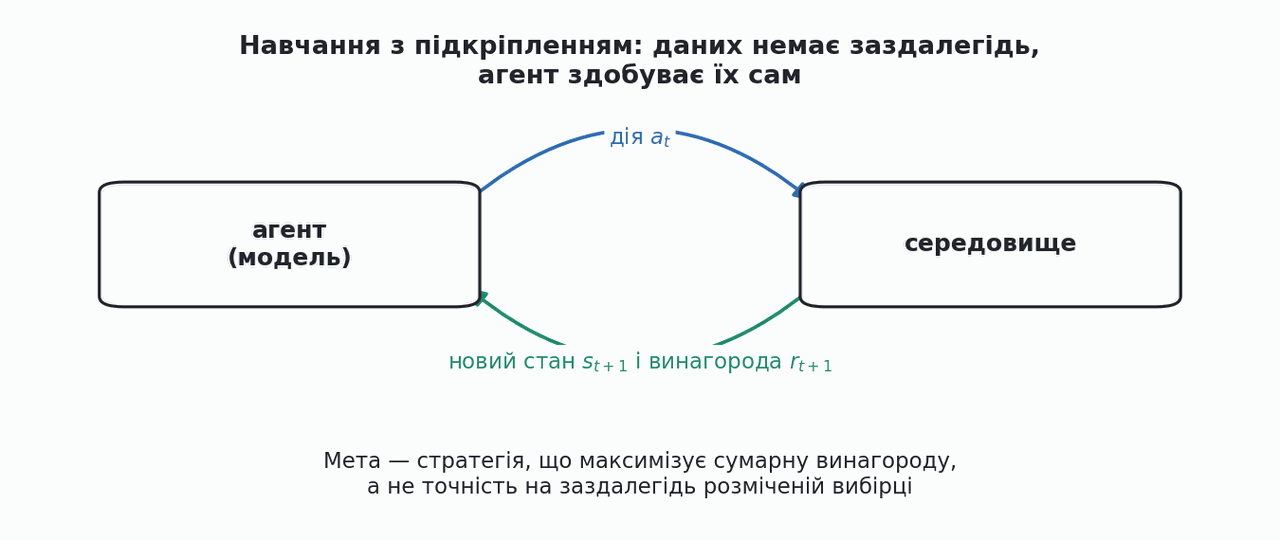
Джерело: Sutton R., Barto A. Reinforcement Learning: An Introduction
Позначення курсу
Одна нотація діятиме в усіх чотирнадцяти лекціях.
| Позначення | Значення | «Титанік» |
|---|---|---|
| кількість зразків | 891 пасажир | |
| кількість ознак | 7 початкових, 12 після кодування | |
| вектор ознак зразка | вік, вартість квитка, клас, стать… | |
| справжня мітка зразка | 1 — вижив, 0 — загинув | |
| прогноз моделі | оцінка шансу вижити | |
| параметри моделі | 12 ваг і вільний член |
Індекс
Одне поняття — багато назв
Машинне навчання виросло на стику кількох дисциплін, і кожна принесла власні слова для тих самих речей. Читаючи англомовну літературу, ви зустрінете їх усі впереміш.
| Наше слово | Синоніми в літературі |
|---|---|
| ознаки | features, covariates, independent variables, explanatory variables, predictors, regressors |
| мітка | target, label, response, outcome, dependent variable, measured variable, regressand |
Перелік наведено за конспектом EPFL, який спеціально попереджає про цю плутанину. У курсі ми послідовно вживаємо «ознака» і «мітка», але канонічні англійські терміни зберігаємо там, де українська калька звучить неприродно.
Джерело: EPFL CS-433 · Regression
Три складові будь-якого методу навчання
Скільки б методів ми не розглянули за семестр, кожен розкладається на ті самі три частини.
Модель — сімейство функцій, серед яких шукаємо відповідь. Обираючи лінійну модель, ми стверджуємо: потрібна залежність — пряма, лишилося знайти яка саме.
Функція втрат (loss function) — число, що вимірює незгоду прогнозу з міткою. Вона перетворює розпливчасте «модель добра» на величину, яку можна мінімізувати. Конкретні функції втрат з'являться в лекції 02.
Оптимізація — процедура, що добирає параметри
Ці три питання варто ставити щоразу, зустрічаючи новий метод: яке сімейство функцій, яка міра помилки, як шукаємо мінімум.
Наскрізний приклад: логістична регресія на «Титаніку»
Складаємо все разом: підготовка даних і модель об'єднуються в один об'єкт, який навчається на тренувальній частині та оцінюється на відкладеній.
Вивід код запущено, вивід не редагувався
text
частка правильних, тренування: 0.816
частка правильних, тест      : 0.789
              precision    recall  f1-score   support

     загинув       0.79      0.89      0.84       137
       вижив       0.78      0.63      0.70        86

    accuracy                           0.79       223
   macro avg       0.79      0.76      0.77       223
weighted avg       0.79      0.79      0.78       223
На що дивитися: точність на тесті 0,789 лише трохи нижча за тренувальну 0,816, а повнота для тих, хто вижив, лише 0,63 — модель пропускає більше третини врятованих.
Обгортка Pipeline тут не косметика: медіану віку й параметри масштабування обчислено тільки на тренувальній частині.
Що модель вивчила про шанси вижити
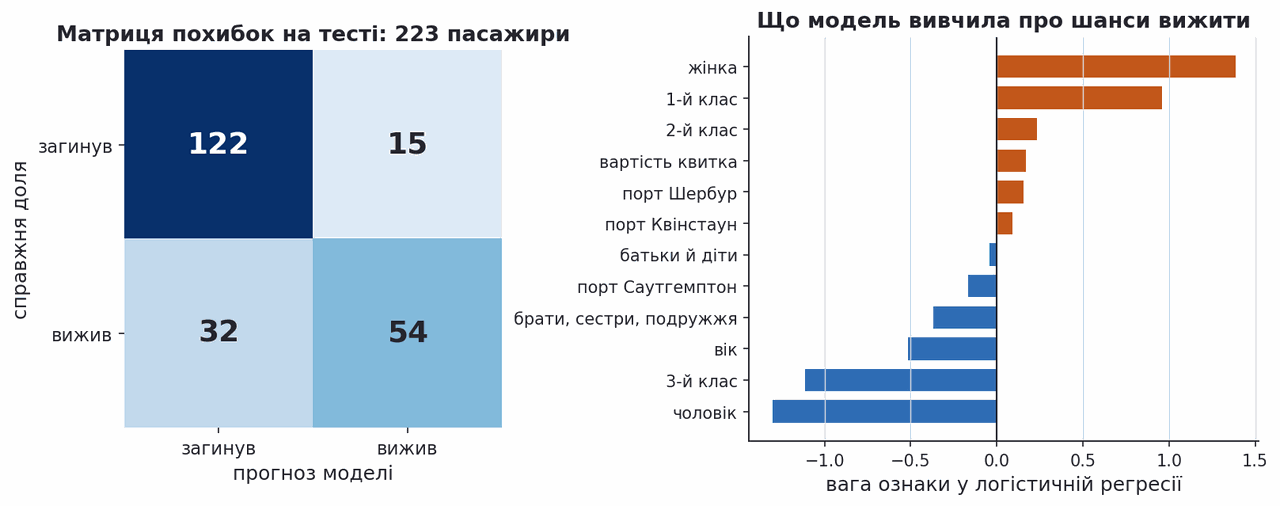
Модель дає 78,9 % правильних відповідей на 223 відкладених пасажирах проти 61,4 % у «моделі», яка завжди відповідає «загинув». Приріст є, але його треба читати уважно: із 86 вижилих модель знайшла 54 і пропустила 32.
Ваги логістичної регресії праворуч показують, що саме модель вважає важливим. Найбільша додатна вага — у ознаки «жінка», найбільші від'ємні — у «чоловік» і «третій клас». Вік і кількість братів або сестер на борту зменшують шанси, вартість квитка майже нічого не додає понад те, що вже сказав клас каюти.
Ці ваги обчислені на стандартизованих ознаках, тому їх можна порівнювати між собою. Як саме вони знаходяться — тема лекції 05.
Тестова помилка складається з двох частин
Мета навчання — не мінімальна помилка на тренувальних даних, а узагальнення (generalization): якість на даних, яких модель не бачила. Тестову помилку зручно розкласти на дві складові:
де
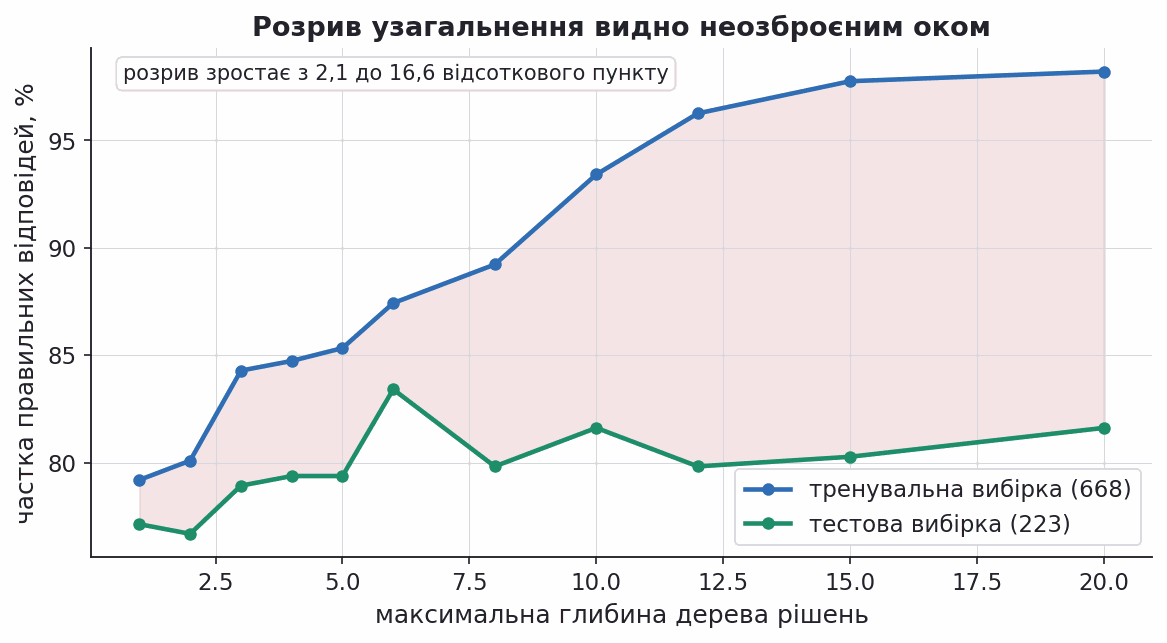
Рисунок показує обидві складові на «Титаніку». Дерево глибини 1 помиляється однаково на обох вибірках: розрив 2,1 відсоткового пункту. Дерево глибини 20 запам'ятовує тренувальні дані майже дослівно — 98,2 % правильних відповідей, — але на тесті дає лише 81,6 %, і розрив зростає до 16,6 пункту.
Недонавчання й перенавчання
Дві складові помилки тягнуть у різні боки: спрощуючи модель, ми зменшуємо розрив і збільшуємо тренувальну помилку, ускладнюючи — навпаки.
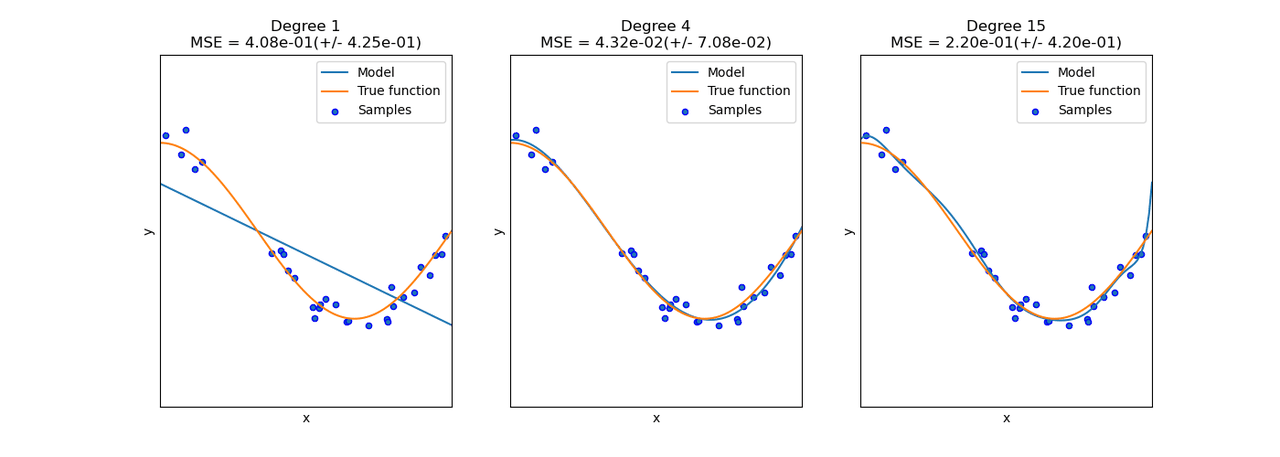
Недонавчання (underfitting) — модель занадто проста, вона не вловлює навіть тієї закономірності, що є в даних. На рисунку це ліва панель: пряма не здатна описати хвилю.
Перенавчання (overfitting) — модель занадто гнучка, вона підлаштовується під випадковий шум конкретної вибірки. Це права панель: многочлен п'ятнадцятого степеня проходить майже через кожну точку і при цьому вигинається там, де справжня функція гладка.
Посередині лежить потрібний баланс. Знайти його на око неможливо — потрібна процедура вимірювання, і саме тому наступний крок стосується розбиття даних. Повністю цю тему розібрано в лекції 03.
Тренувальна, валідаційна і тестова вибірки
Дані ділять щонайменше на дві частини, а частіше на три, і кожна має власне призначення.
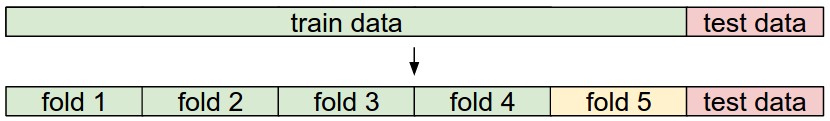
Тренувальна вибірка (training set) — на ній підбираються параметри моделі. Валідаційна (validation set) — на ній обирають гіперпараметри: глибину дерева, силу регуляризації, саму модель. Тестова (test set) — на ній робиться остаточне вимірювання якості, і використати її можна рівно один раз.
Верхній рядок рисунка показує просте розбиття, нижній — перехресну перевірку (cross-validation), коли роль валідаційної частини по черзі грає кожен блок тренувальних даних. Тестова частина при цьому не торкається взагалі. Пропорції розбиття не є універсальною константою: більшу частину віддають на тренування.
Джерело: Stanford CS231n · Validation sets and cross-validation
Золоте правило і незалежність спостережень
THE TEST DATA CANNOT INFLUENCE THE TRAINING PHASE IN ANY WAY. — UBC CPSC 340, лекція 4
Правило записане великими літерами в самому джерелі, і це не перебільшення. Щойно тестові дані вплинули на будь-яке рішення — вибір ознак, заповнення пропусків, підбір порога, — виміряна на них якість перестає бути оцінкою якості на нових даних.
Друге припущення стосується походження даних: вибірки мають бути незалежними й однаково розподіленими (i.i.d.). Усі зразки походять з одного розподілу, і кожен вибрано незалежно від інших. Джерело пропонує наочну метафору: витягнути карту з колоди, повернути назад, перетасувати, повторити.
На практиці припущення часто порушується — дані змінюються з часом, спостереження одного пацієнта корелюють між собою, — і тоді оцінка якості стає оптимістичною.
Джерело: UBC CPSC 340 · Fundamentals of Learning
Витік даних дає підозріло ідеальний результат
Витік даних (data leakage) — ситуація, коли до ознак потрапляє інформація, недоступна в момент реального прогнозу. Найчастіше це відбувається непомітно.
У наборі «Титанік» є стовпець alive зі значеннями yes і no. Це та сама мітка, лише словами. Достатньо забути його прибрати:
Вивід код запущено, вивід не редагувався
text
частка правильних на тесті: 1.0На що дивитися: точність 1,0 на тесті — не успіх моделі, а ознака того, що відповідь потрапила у вхідні дані.
Сто відсотків правильних відповідей — не привід радіти, а привід шукати помилку. Крім alive, у цьому наборі є ще п'ять похідних стовпців: class, who, adult_male, embark_town і alone. Перше правило захисту просте: перед навчанням перевірте, чи кожна ознака справді була б відома до настання події, яку ви прогнозуєте.
Кореляція не є причинністю
"Regression finds correlation not a causal relationship, so interpret your results with caution." — EPFL CS-433, лекція 01b
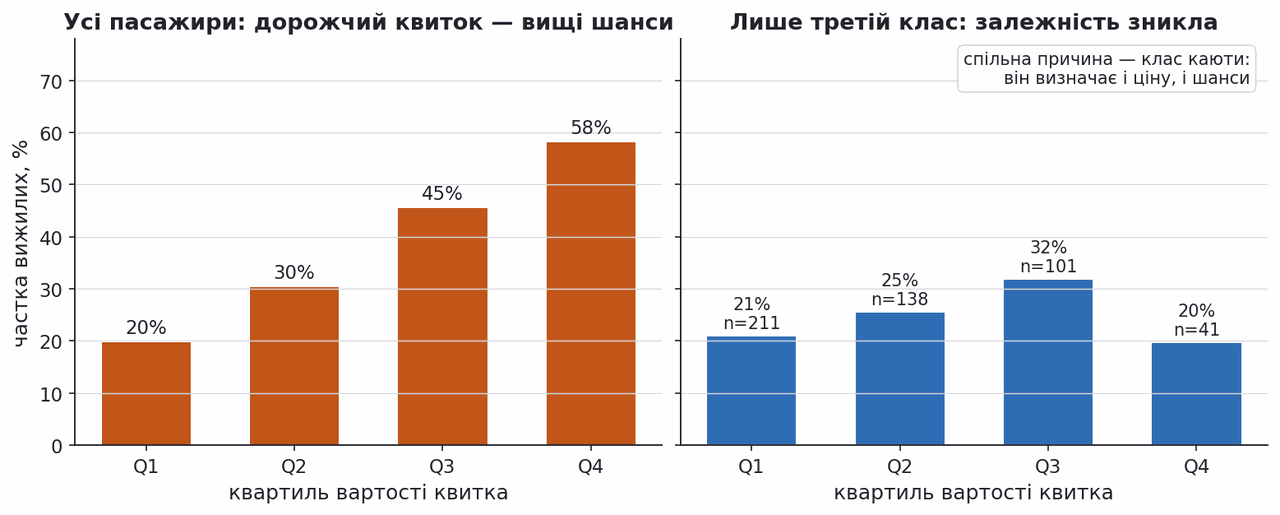
Ліва панель рисунка показує чіткий зв'язок: серед пасажирів із найдешевшими квитками вижили 20 %, серед найдорожчих — 58 %. Спокуслива інтерпретація — «дорогий квиток рятує життя».
Права панель розглядає лише третій клас, у якому їхав 491 пасажир із 891. Усередині одного класу залежність зникає: 21 %, 25 %, 32 %, 20 % — коливання без напряму. Отже, справа не в ціні. Клас каюти — спільна причина, що визначає і вартість квитка, і розташування кают відносно шлюпок.
Змінна, яка одночасно впливає на ознаку й на мітку, називається конфаундером (confounder). Модель, побудована на кореляціях, прогнозує добре й водночас пояснює неправильно — це різні речі.
Обмеження машинного навчання
Метод потужний, але його межі варто знати з першої лекції.
Модель не краща за свої дані. Якщо у вибірці систематично бракує певної групи людей, модель працюватиме на ній гірше — і не повідомить про це.
Кореляція не дає права на причинні висновки. Ми щойно бачили це на вартості квитка. Для причинних тверджень потрібні експеримент або окремий апарат причинного висновку.
Гарна якість на тесті не гарантує гарної роботи завтра. Припущення про однаковий розподіл порушується щоразу, коли світ змінюється.
Складні моделі важко пояснити. У медицині чи кредитуванні відповідь без пояснення часто просто неприйнятна.
Не кожна задача потребує навчання. Якщо правило можна записати трьома рядками коду, машинне навчання лише додасть невизначеності.
Підсумок лекції
Машинне навчання обертає напрям програмування. Замість того щоб писати правила, ми даємо алгоритму дані з відповідями і отримуємо правила у вигляді параметрів моделі.
Дані — це таблиця зразків і ознак, і в реальному наборі вона майже завжди має дефекти: 77 % пропусків у стовпці deck, викиди у вартості квитка, дисбаланс класів 62 на 38.
Три режими навчання розрізняються тим, що відомо алгоритму: мітки відомі — з учителем, міток немає — без учителя, даних немає взагалі й агент здобуває їх дією — з підкріпленням.
Будь-який метод складається з моделі, функції втрат і процедури оптимізації. Ці три питання ми ставитимемо кожному новому методу курсу.
Мета — узагальнення, а не мінімум помилки на тренуванні. Розрив між тренувальною і тестовою якістю вимірюється, і золоте правило захищає це вимірювання.
Наступна лекція будує першу повноцінну модель — лінійну регресію — і показує, звідки береться її функція втрат.
Джерела й додаткові матеріали
Курси, на яких побудовано лекцію
- EPFL CS-433 — лекції 01a і 01b: означення, дві традиції, регресія
- UBC CPSC 340 — лекції 1, 2, 4: дані, золоте правило, i.i.d.
- Stanford CS229 — вступ: регресія проти класифікації
- Stanford CS231n — зображення як числа, розбиття вибірок
Підручники
- Bishop. Pattern Recognition and Machine Learning — розділ 1
- Sutton, Barto. Reinforcement Learning — розділ 1
Документація та дані