Тема
Лекція 08 · Навчання без учителя: кластеризація
Досі кожен приклад у навчальній вибірці мав правильну відповідь. Сьогодні міток немає: є лише таблиця вимірювань, і треба самостійно знайти в ній групи схожих об'єктів. Розберемо чотири способи це зробити і чесно подивимось, як перевірити, чи вийшло щось осмислене.
Зміст лекції
Лекція йде від найпростішого алгоритму до найгнучкішого, і кожен наступний метод з'являється як відповідь на конкретну ваду попереднього.
- Задача кластеризації. Що дано, що шукаємо і чому «правильної відповіді» тут не існує.
- K-means. Цільова функція, алгоритм Ллойда, збіжність, вибір числа кластерів.
- Оцінювання результату. Силует, скоригований індекс Ренда і межі обох.
- Межі застосовності K-means. Форма кластерів, масштаб ознак, викиди, опуклість областей.
- DBSCAN. Кластер як щільна область, ядрові точки, явне позначення шуму.
- Ієрархічна кластеризація і суміші гаусіанів. Дендрограма, м'які призначення, алгоритм EM.
Перші два блоки дають робочий інструмент, третій вчить йому не довіряти наосліп, а решта показує, що робити, коли припущення K-means не виконуються.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чим постановка задачі без міток відрізняється від класифікації та регресії;
- записати цільову функцію K-means і показати, що обидва кроки алгоритму Ллойда її не збільшують;
- реалізувати K-means на numpy у десять рядків і запустити його зі scikit-learn;
- обрати число кластерів методом ліктя та за середнім силуетом і назвати обмеження обох підходів;
- пояснити, чому скоригований індекс Ренда неможливо порахувати в реальній задачі;
- назвати чотири ситуації, у яких K-means дає геометрично неправильну відповідь;
- налаштувати ε і MinPts для DBSCAN за графіком відстані до четвертого сусіда;
- прочитати дендрограму і пояснити різницю між способами зв'язування кластерів;
- вивести м'які призначення E-кроку та оновлення M-кроку для суміші гаусіанів.
Дані без міток: нова постановка задачі
У класифікації нам давали пари «об'єкт — відповідь», і модель училася відтворювати відповідь. Тепер дано лише
Причина проста й економічна: розмічені дані дорогі, а нерозмічених — скільки завгодно. Знімки клітин, тексти, логи транзакцій накопичуються самі; посадити експерта проставити до них мітки коштує часу й грошей.
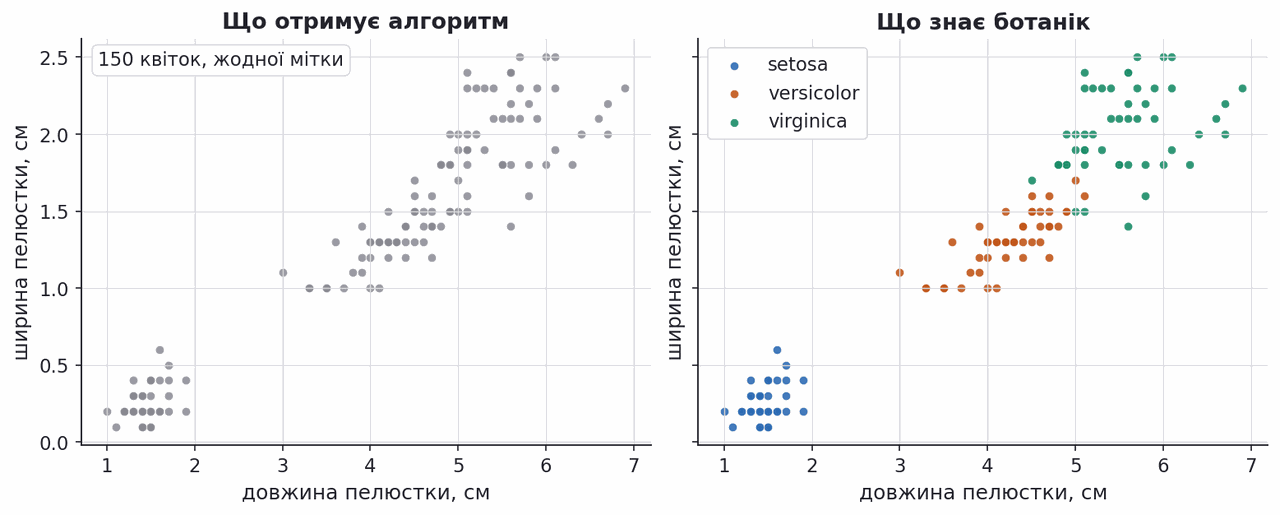
Ліворуч на рисунку — те, що бачить алгоритм: 150 квіток ірису, чотири виміри кожної, жодного слова про вид. Праворуч — те саме очима ботаніка. Мета кластеризації — за лівою картинкою відновити щось якомога ближче до правої.
Кластеризація та її сімейства методів
Кластеризація (clustering) — задача групування об'єктів так, щоб схожі опинилися в одній групі, а несхожі потрапили в різні.
"Clustering is the task of grouping a set of objects such that: similar objects end up in the same group; dissimilar objects are separated into different groups." — EPFL CS-433, лекція 10b
Слово «схожі» тут навмисно нестроге, і кожне сімейство методів уточнює його по-своєму.
| Сімейство | Що вважається кластером | Представники |
|---|---|---|
| Модельне | набір точок, який добре описує одна проста модель | K-means, суміші гаусіанів |
| Ієрархічне | вузол дерева злиттів, побудованого за відстанями | методи зв'язування, дендрограма |
| Щільнісне | зв'язна область високої щільності точок | DBSCAN, OPTICS |
| Графове | частина графа з міцними внутрішніми зв'язками | спектральна кластеризація |
Джерело: EPFL CS-433 Machine Learning
Дані лекції: Iris і Wine
Обидва набори невеликі, реальні й мають відомі мітки — саме тому на них зручно перевіряти кластеризацію: справжню відповідь ми притримуємо і дістаємо лише наприкінці, щоб оцінити результат.
Iris. 150 квіток трьох видів, чотири ознаки: довжина й ширина чашолистка та пелюстки в сантиметрах.
Wine. 178 зразків вина трьох сортів винограду, 13 хімічних ознак: вміст спирту, флаваноїдів, магнію, проліну та інші.
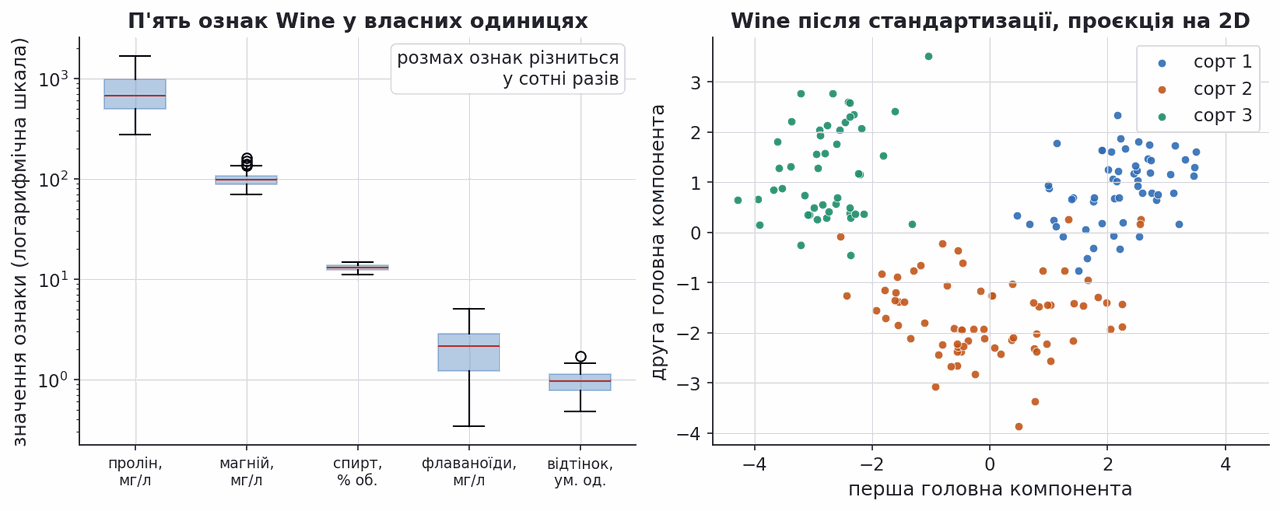
Ліворуч на рисунку видно причину, через яку Wine не можна кластеризувати «як є»: пролін вимірюють сотнями міліграмів на літр, а відтінок — одиницями. Метод, що спирається на евклідову відстань, почує лише пролін. Праворуч — ті самі дані після стандартизації, спроєктовані на дві головні компоненти.
Джерела даних: Iris, UCI · Wine, UCI
K-means: цільова функція
Найпростіша ідея кластера — «хмара точок навколо своєї середньої». Тоді якість розбиття природно міряти тим, наскільки далеко точки лежать від центрів своїх груп.
K-means розбиває дані на
| Позначення | Значення |
|---|---|
| центроїд (centroid) кластера | |
| індикатор «об'єкт | |
| число кластерів, яке задає людина |
Задача містить дискретні змінні
Алгоритм Ллойда чергує два кроки
Хоча спільна мінімізація за
Крок призначення. Центроїди зафіксовані; кожна точка йде до найближчого:
Крок оновлення. Призначення зафіксовані; кожен центроїд стає середнім своїх точок:
Обидва кроки розв'язують свою підзадачу точно, тому жоден із них не збільшує
П'ять ітерацій алгоритму на очах
Штучні дані, чотири справжні групи, старт навмисно невдалий: усі чотири центроїди опинилися в нижній половині хмари.
Ітерація 1 розтягує центроїди по площині й одразу зменшує WCSS майже втричі. Ітерації 2 і 3 уточнюють межі: точки на кордоні між групами міняють колір, а центроїди зсуваються слідом. На ітерації 4 значення WCSS уже майже не змінюється, а на п'ятій центроїди стоять на місці — це і є критерій зупинки.
Ламані лінії показують траєкторію кожного центроїда від старту до кінцевої позиції.
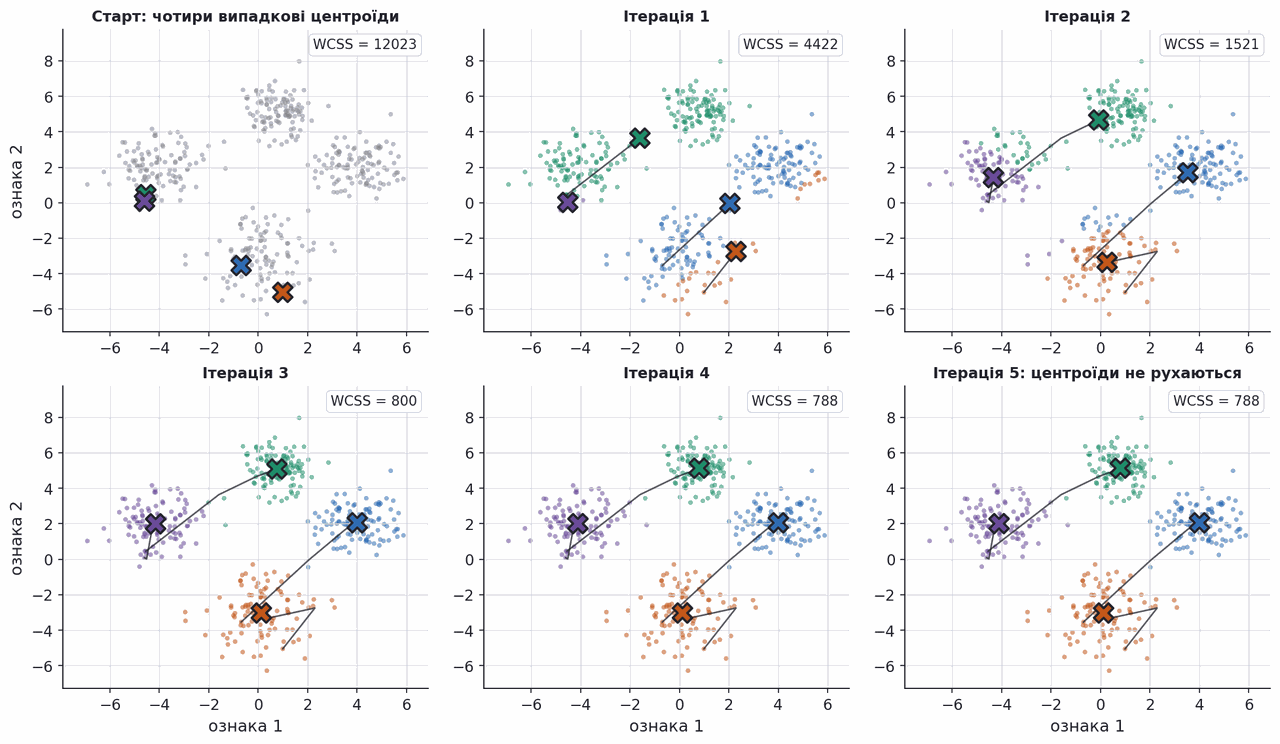
WCSS за ітераціями: 12 023 → 4 422 → 1 521 → 800 → 788 → 788. Значення не зростає жодного разу — і на останніх двох ітераціях воно вже однакове, як і обіцяє теорія.
Алгоритм Ллойда крок за кроком
Справжні дані Iris: довжина й ширина пелюстки, стандартизовані. Кожен крок — це два дії поспіль: кожна точка йде до найближчого центроїда, кожен центроїд переїжджає в середнє своїх точок.
Ітерація 0 із 6
Старти з різним результатом
146,6WCSS на цьому кроці
триваєцентроїди ще рухаються
6ітерацій до збіжності
18,0 … 18,0межі підсумкового WCSS по дванадцяти стартах
WCSS не зростає жодного разу — це і є гарантія алгоритму. Дві кнопки поруч із кроками перебирають дванадцять різних стартів і ставлять найгірший і найкращий за підсумковим WCSS, а плашка поруч показує обидві межі. І тут на цих даних відбувається несподіване. При K = 2 і K = 3 межі збігаються: 54,15 і 18,02 незалежно від старту. Тобто на двовимірних Iris невдалої ініціалізації просто не існує — усі дванадцять стартів приходять в одну точку. Посуньте K до чотирьох, і розрив з'явиться: від 12,28 до 17,32, тобто на чверть; при K = 5 — від 9,16 до 17,15. Правило звідси не «ініціалізація завжди важлива», а точніше: що дрібніше ділимо дані, то більше локальних мінімумів і то потрібніший n_init. На простій задачі з трьома добре розділеними групами про старт можна не думати. Перемкніть на «види» — видно, що setosa відокремлюється ідеально, а versicolor і virginica частково змішані: кластери не зобов'язані збігатися з класами.
Числовий приклад: шість квартир на прямій
Щоб побачити арифметику цілком, візьмімо одновимірний випадок: площі шести квартир 30, 35, 40, 60, 65 і 70 м², число кластерів
| Ітерація | Призначення 30 · 35 · 40 · 60 · 65 · 70 | Нові центроїди |
|---|---|---|
| 1 | 1 · 1 · 2 · 2 · 2 · 2 | |
| 2 | 1 · 1 · 1 · 2 · 2 · 2 | |
| 3 | без змін | збіглося |
На першій ітерації квартира 35 м² рівновіддалена від обох центроїдів:
Кінцеве розбиття осмислене: малі квартири 30–40 м² із центром 35 і великі 60–70 м² із центром 65. Підсумкова WCSS дорівнює
Код: K-means з нуля на numpy
Увесь алгоритм — це три рядки всередині циклу: матриця відстаней, вибір найближчого центроїда і усереднення.
Вивід код запущено, вивід не редагувався
text
ітерація 1:  WCSS =  330.76
ітерація 2:  WCSS =  208.29
ітерація 3:  WCSS =  146.73
ітерація 4:  WCSS =  142.08
ітерація 5:  WCSS =  140.42
ітерація 6:  WCSS =  140.18
ітерація 7:  WCSS =  140.03
ітерація 8:  WCSS =  140.03
На що дивитися: WCSS спадає на кожній ітерації й на восьмій повторюється: жодна точка не змінила кластер, алгоритм зійшовся.
Центроїди залишилися на місці — це і є критерій зупинки. Дані стандартизовано, тому WCSS вимірюється в квадратах стандартних відхилень.
Код: KMeans зі scikit-learn на Iris
У робочому коді алгоритм не пишуть руками: бібліотечна версія додає розумну ініціалізацію, десять незалежних запусків і швидкі обчислення відстаней.
Вивід код запущено, вивід не редагувався
text
WCSS        : 139.8
силует      : 0.46
ARI з видами: 0.62
кластер      0   1   2
вид
setosa       0  50   0
versicolor  39   0  11
virginica   14   0  36
На що дивитися: setosa цілком потрапила в окремий кластер, а versicolor і virginica перемішані (39 / 11 і 14 / 36) — звідси ARI лише 0,62.
Десять стартів знайшли трохи кращий мінімум, ніж наш єдиний запуск руками (139,8 проти 140,0).
Джерело: scikit-learn · KMeans
Результат на Iris поруч зі справжніми видами
Таблиця спряженості з попереднього розділу читається так: setosa виділилася повністю — усі 50 квіток в одному кластері й нікого чужого. Versicolor і virginica переплуталися: 11 versicolor пішли до virginica, 14 virginica — до versicolor.
Разом 25 квіток зі 150 опинилися «не там», і це не помилка реалізації. Ці два види справді перекриваються в просторі вимірювань: без міток немає підстав провести межу інакше.
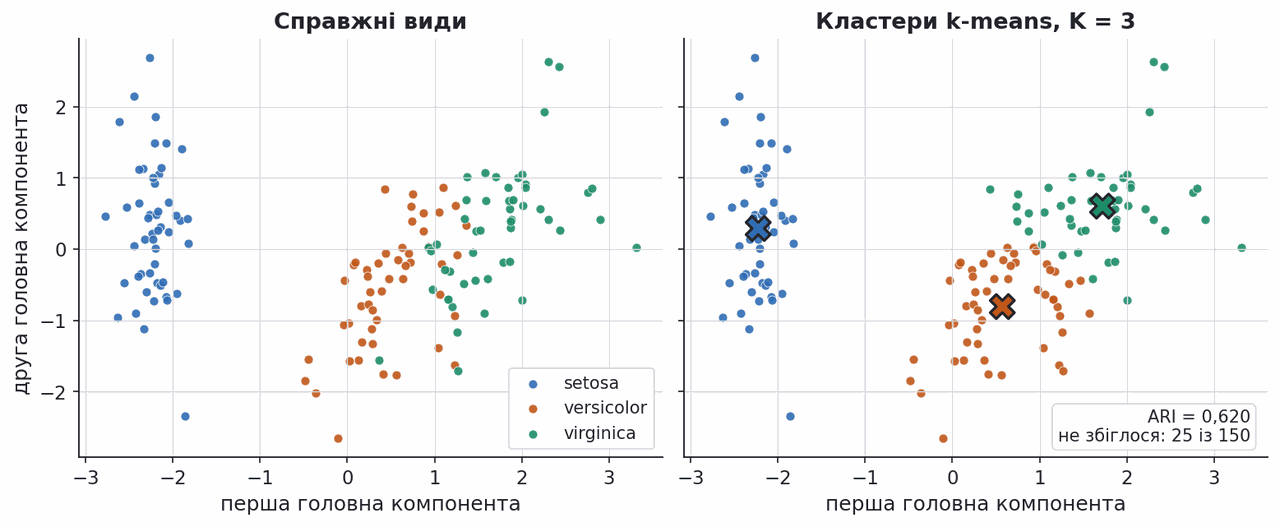
Число ARI = 0,620 у правому куті — скоригований індекс Ренда, до якого ми повернемось за кілька розділів. Поки що досить знати, що одиниця означає повний збіг із видами, а нуль — випадкове вгадування.
Одна невдала ініціалізація псує весь результат
Цільова функція K-means неопукла, тому результат залежить від стартових центроїдів — на відміну від логістичної регресії з лекції 05, де мінімум був єдиний.
На рисунку — дев'ять однакових груп точок і результат одного запуску з випадкового старту. Алгоритм чесно збігся, і все ж дві пари сусідніх груп він об'єднав, а ще дві розрізав навпіл: це локальний мінімум, з якого алгоритм сам не вийде.
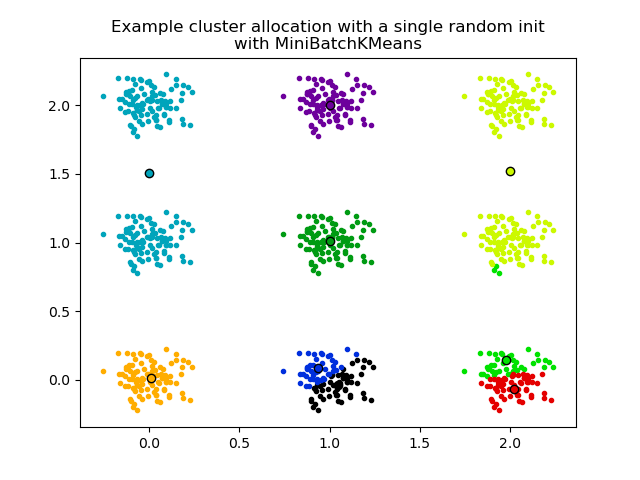
Стандартні ліки — кілька незалежних запусків із різних стартів і вибір того, у якого WCSS найменша. Саме це робить параметр n_init у scikit-learn.
Але ризик не однаковий завжди. На наших двовимірних Iris усі дванадцять стартів дають однакову відповідь при n_init.
Джерело: scikit-learn · Impact of k-means initialization
K-means++ обирає стартові центри розумно
Замість
- Перший центроїд
— випадкова точка даних. - Для кожної точки рахуємо квадрат відстані до найближчого з уже обраних центрів:
. - Наступний центроїд обираємо з імовірністю
. - Повторюємо до
центрів і запускаємо звичайний K-means.
Вибір лишається випадковим, тож поодинокий викид не стає центром автоматично. Автори довели, що очікувана WCSS такого старту перевищує оптимальну не більш ніж у
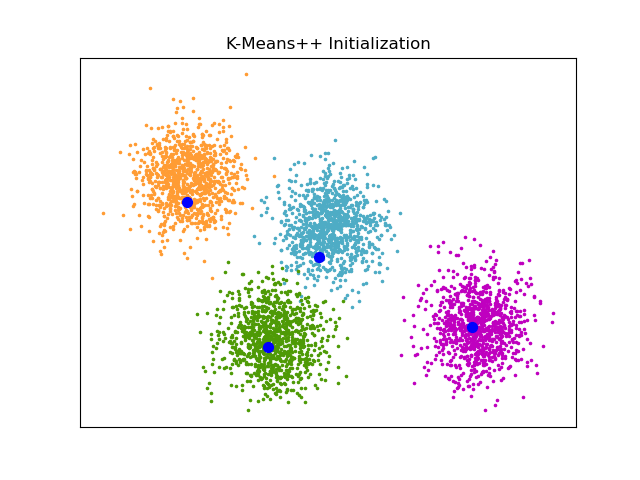
Джерело рисунка: scikit-learn · K-Means++ initialization
Стаття: Arthur, Vassilvitskii. k-means++, SODA 2007
Вибір K: метод ліктя і середній силует
Крос-перевірка тут не працює: глобально мінімальна WCSS не зростає зі збільшенням
Метод ліктя (elbow method) шукає не мінімум, а злам: значення
Середній силует дає другу думку. Для кожного об'єкта силует дорівнює
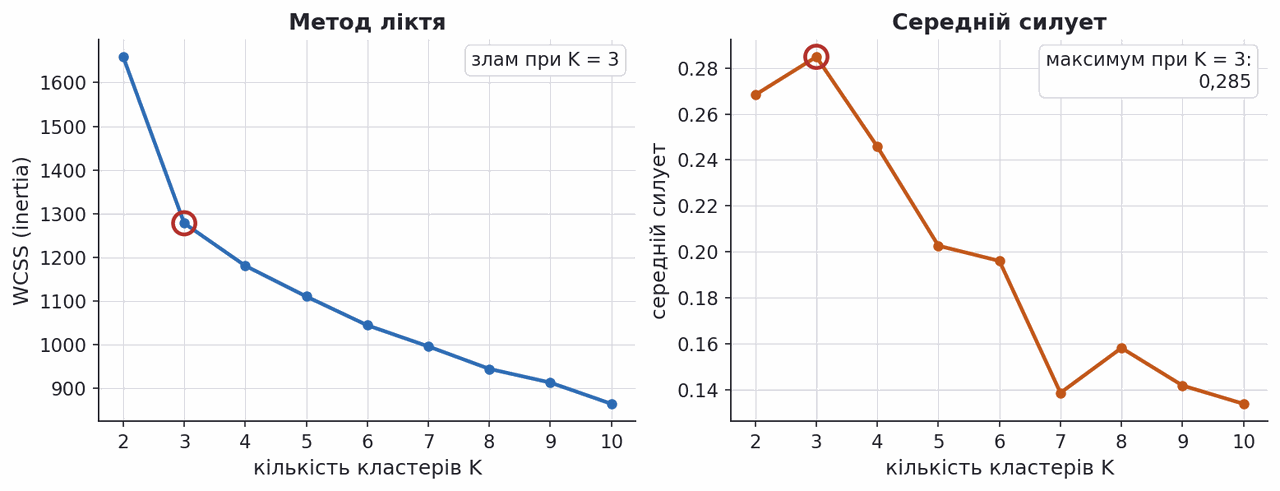
На Wine обидва критерії вказують на
Силуетний профіль показує якість кожного кластера
Одне усереднене число ховає деталі. Силуетна діаграма малює силует кожного об'єкта окремо, згрупувавши їх за кластерами: ширина смуги — розмір кластера, довжина — наскільки впевнено об'єкт у ньому сидить.
На рисунку показано розбиття на три кластери із середнім силуетом 0,59 — це червона пунктирна лінія. Кластер 1 повністю правіше за неї: він компактний і стоїть окремо. А от кластер 2 удвічі товщий за решту й майже цілком лежить лівіше, аж до нуля. Права панель пояснює причину: у нього злилися дві сусідні групи, тому багато його точок однаково близькі до чужого центра.
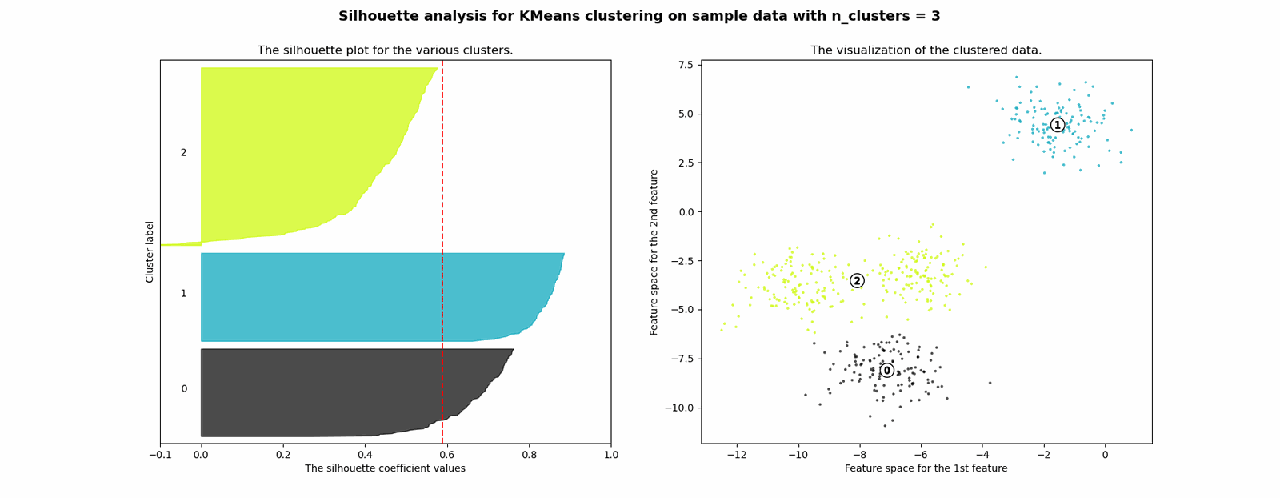
Правило читання просте: якщо в розбитті є кластер, який цілком лежить лівіше за середню лінію, або кластери різко різняться шириною, вибір
Джерело: scikit-learn · Silhouette analysis on KMeans
Оцінювання кластеризації без істинних міток
Тут потрібна повна чесність. Метрики якості кластеризації діляться на дві несумісні групи, і жодна не робить того, чого від неї хочеться.
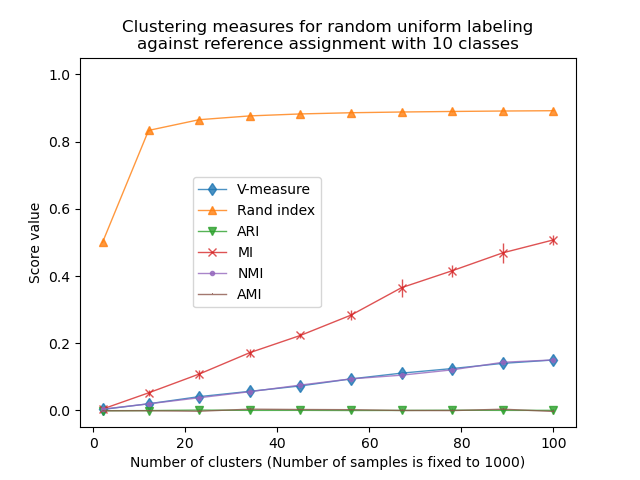
Зовнішні метрики порівнюють розбиття з відомою правильною відповіддю. Скоригований індекс Ренда (adjusted Rand index, ARI) рахує частку пар об'єктів, для яких кластеризація й істинні мітки узгоджені, і віднімає рівень випадкового збігу. Слово «скоригований» не косметичне: на рисунку нехитрий індекс Ренда для повністю випадкових розбиттів піднімається до 0,9, тоді як ARI тримається біля нуля.
Проблема в тому, що ARI вимагає міток — а в реальній задачі кластеризації їх немає. Ми могли порахувати ARI на Iris лише тому, що ботаніки колись розмітили ці 150 квіток.
Внутрішні метрики, як силует, обходяться без міток, але міряють винятково геометрію. Розбиття з чудовим силуетом цілком може не мати жодного змісту в предметній області.
Джерело: scikit-learn · Adjustment for chance in clustering evaluation
Масштаб ознак вирішує результат K-means
K-means працює з евклідовою відстанню, а відстань складається з внесків усіх ознак. Ознака з великим числовим розмахом дає внесок у сотні разів більший за решту й фактично одна визначає розбиття.
На Wine пролін вимірюється сотнями міліграмів на літр, а відтінок — величиною близько одиниці. Кластеризація сирих даних зводиться до розрізання шкали проліну на три частини: ARI із сортами винограду 0,371. Після стандартизації всі 13 ознак говорять на рівних, і ARI зростає до 0,897 — розбиття майже збігається із сортами.
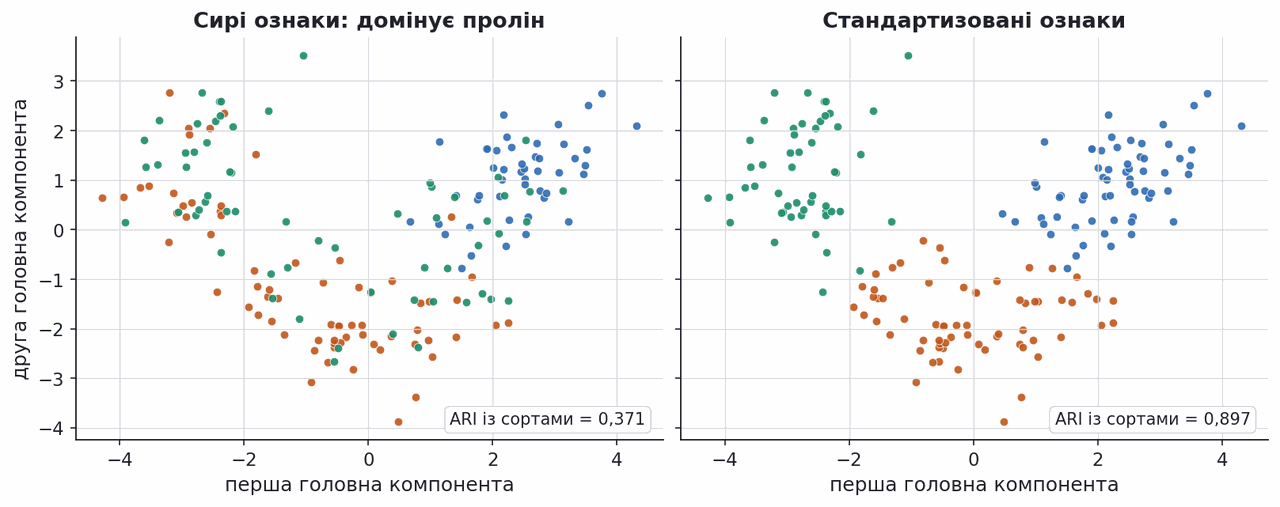
Обидві панелі намальовано в одних координатах, тому видно, що змінилися саме межі між кластерами, а не самі дані. Стандартизація перед будь-яким методом, що спирається на відстані, — не рекомендація, а вимога.
Один викид з'їдає цілий центроїд
Центроїд — це середнє, а середнє не стійке до крайніх значень. Достатньо одного об'єкта, який лежить далеко, щоб розбиття втратило сенс.
Повернімося до шести квартир. Додамо сьому: пентхаус 300 м². Тепер K-means із
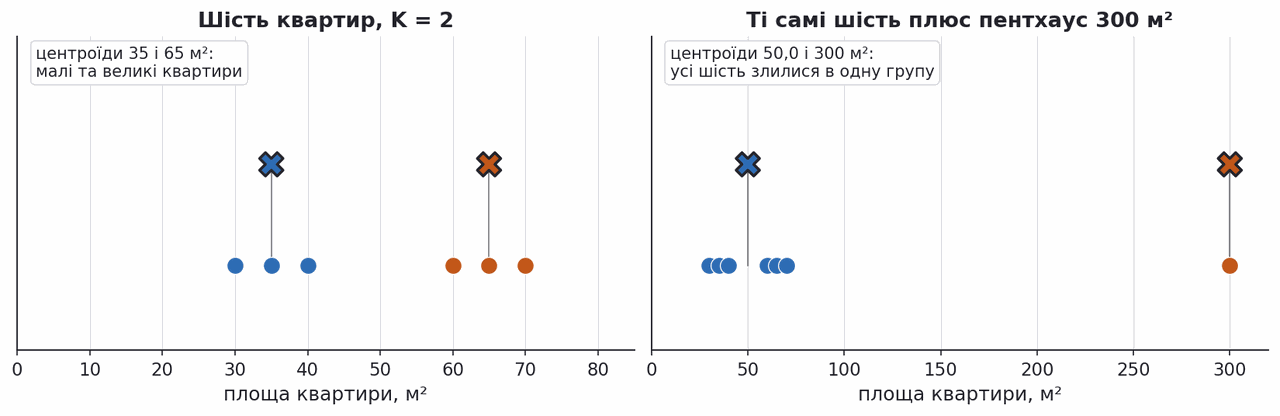
Часткові ліки — робастні варіанти. K-medians мінімізує суму модулів і бере покоординатну медіану замість середнього. K-medoids вимагає, щоб центром був реальний об'єкт вибірки, а не усереднена точка; це доречно там, де «середнє» безглузде — наприклад, для текстів.
Чотири випадки, у яких K-means помиляється
Ключовий рисунок лекції. Скрізь показано результат K-means, і скрізь він геометрично законний, але змістовно хибний.
Невідповідне число кластерів. Даних три групи, попросили дві — алгоритм слухняно розрізав одну з них.
Витягнуті кластери. Групи анізотропні, витягнуті вздовж спільного напряму. Прямі межі рубають їх упоперек, бо K-means припускає сферичну форму.
Різні дисперсії. Широка й вузька групи поруч: широка віддає свою периферію тісним сусідам, бо межа проходить точно посередині між центрами.
Різні розміри. Групи з 500, 100 і 10 точок: велика перетягує центроїд на себе і забирає частину найменшої.
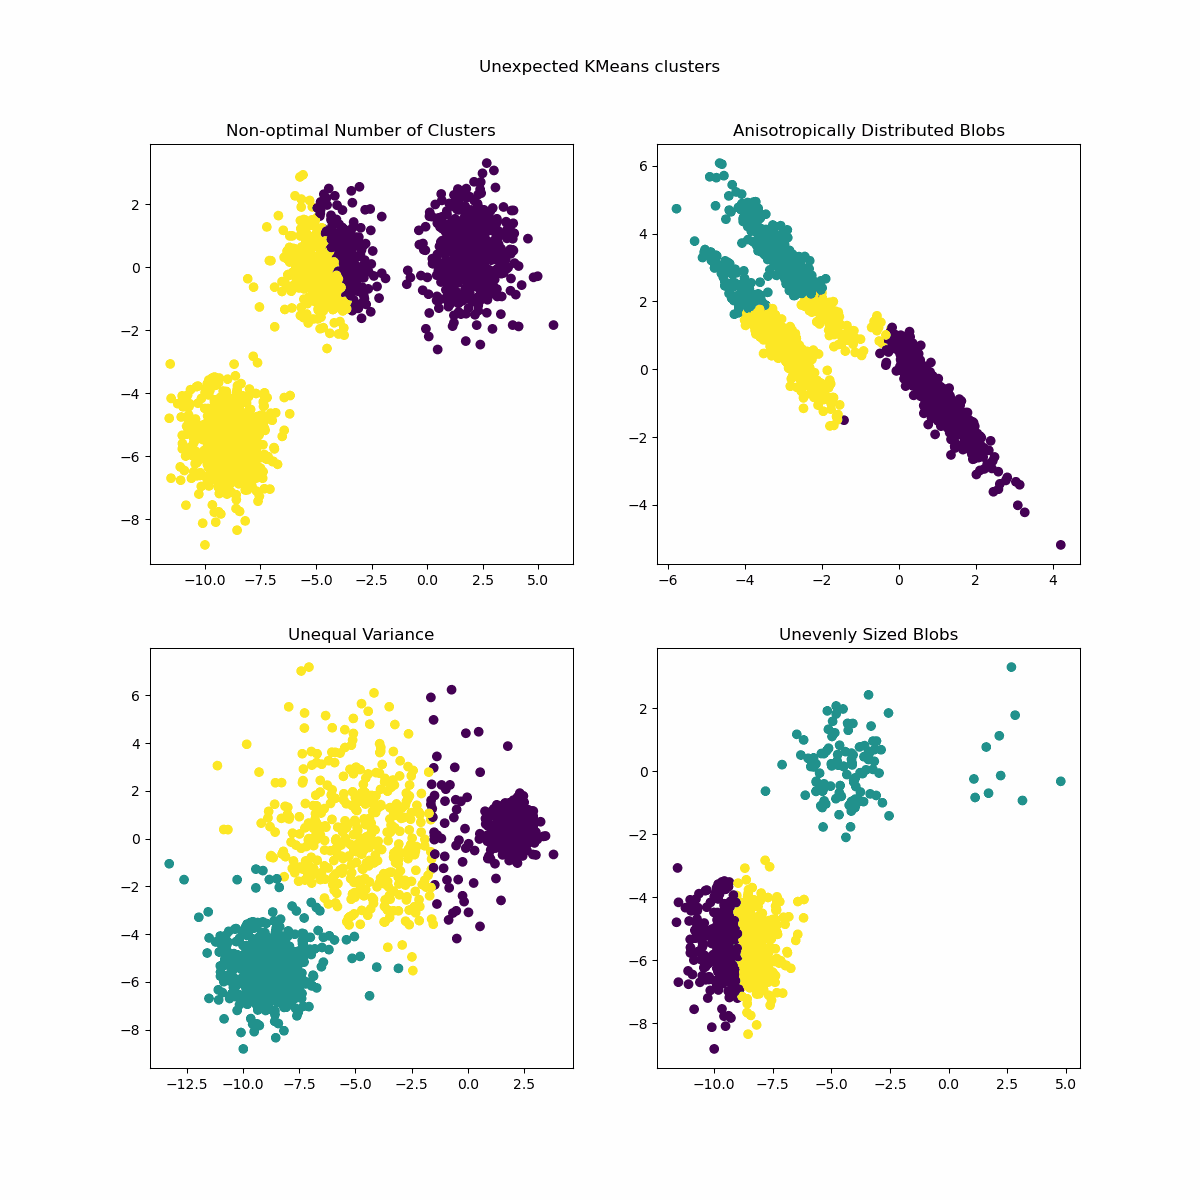
Спільне правило: K-means дає правильну відповідь лише тоді, коли справжні групи розділяються серединними перпендикулярами до відрізків між їхніми центрами. Три з чотирьох випадків вище знімаються сумішами гаусіанів, а перший — уважним вибором
Джерело: scikit-learn · Demonstration of k-means assumptions
DBSCAN: кластер як щільна область
Змінімо означення кластера: замість «точки навколо центру» скажемо «зв'язна область, у якій точки лежать густо». Тоді форма кластера довільна, а число кластерів виникає з даних.
DBSCAN (density-based spatial clustering of applications with noise) має два параметри: радіус
- ядрова (core) — у її
-околі не менше MinPts точок; - межова (border) — сама не ядрова, але лежить в
-околі ядрової; - шум (noise) — ані ядрова, ані межова.
Алгоритм бере невідвідану ядрову точку, приєднує все з її околу, потім околи нових ядрових точок — поки кластер не перестане рости. Ця ланцюгова реакція проходить крізь щільну область незалежно від її форми.
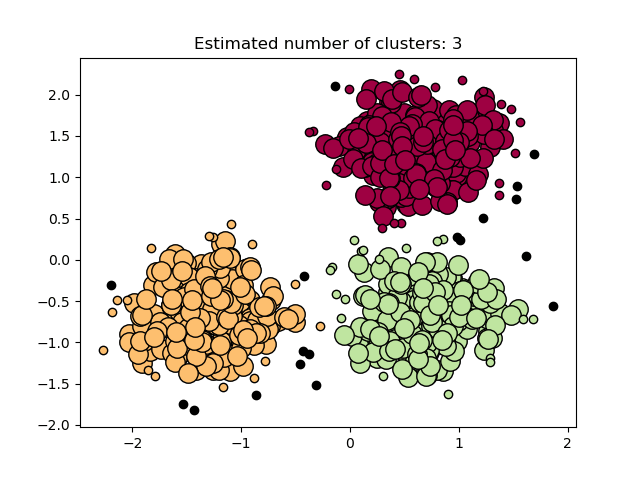
Великі кружки — ядрові, дрібні — межові, чорні — шум.
Джерело: scikit-learn · Demo of DBSCAN Стаття: Ester та ін., KDD 1996
Вибір ε за графіком відстані до четвертого сусіда
Обидва параметри DBSCAN підбирають руками, і практична евристика з оригінальної статті працює так. Спершу фіксуємо MinPts — автори рекомендують невелике значення близько чотирьох для двовимірних даних. Далі для кожної точки рахуємо відстань до її четвертого найближчого сусіда, сортуємо ці відстані за зростанням і будуємо графік.
Точки всередині щільних областей мають близького четвертого сусіда, тому крива довго йде майже горизонтально. Точки в порожнечі — навпаки, і на них крива різко злітає вгору. Злам відділяє одні від інших, і його висота і є розумним
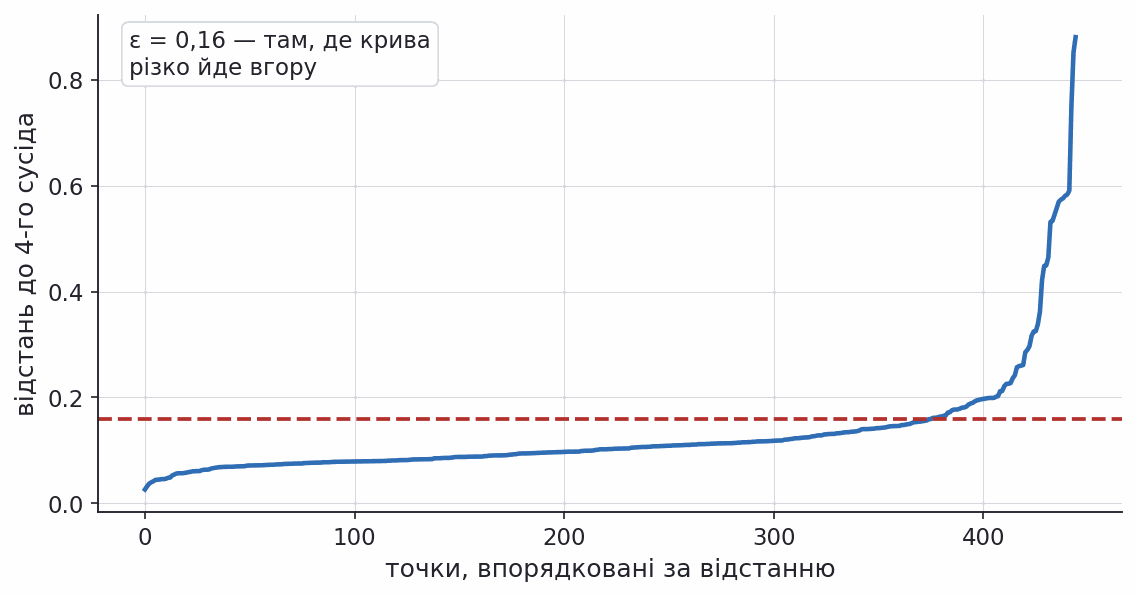
Для наших даних — 400 точок на двох півмісяцях плюс 45 рівномірно розкиданих сторонніх — злам припадає приблизно на 0,16. Медіанна відстань до четвертого сусіда дорівнює 0,102, максимальна сягає 0,88.
DBSCAN різко реагує на зміну ε
Зворотний бік свободи від параметра
На рисунку той самий набір даних оброблено двічі. При
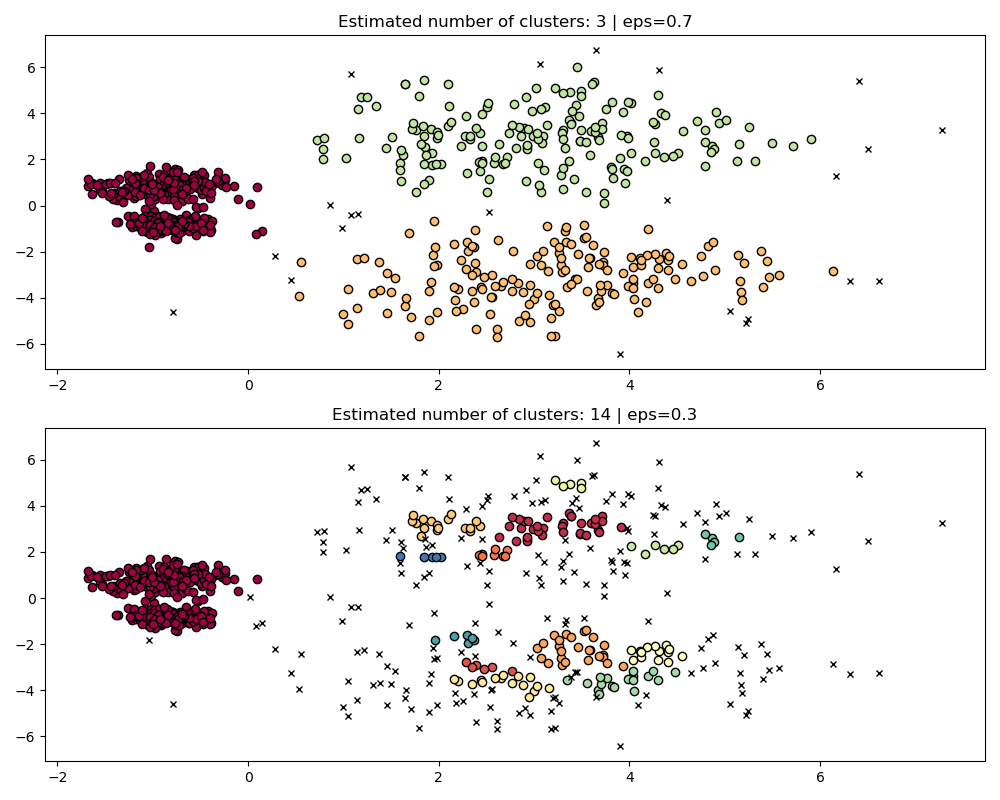
Особливо болісно це там, де щільність кластерів різна: єдиного
Джерело: scikit-learn · Demo of HDBSCAN
Той самий набір, різне ε
Три набори, кожен ламає алгоритм по-своєму. Сірі точки — шум: DBSCAN не зобов'язаний віднести до кластера всіх. Кнопка внизу перемикає на K-means, щоб порівняти на тих самих даних.
Порівняти з іншим методом
2знайдено кластерів
1точок у шумі (0,3 %)
0,99ARI зі справжніми групами
1,00найкраще, що дає цей метод на цьому наборі
На півмісяцях видно головну перевагу: DBSCAN знаходить два серпи, бо йде за щільністю, а не за відстанню до центра — перемкніться на K-means і побачите, що той ріже їх навпіл поперек. Але візьміть третій набір, де щільна група сусідить із розрідженою: жодне ε не годиться одразу для обох. Мале — і розріджена група цілком іде в шум; велике — і щільна злипається із сусідами. Саме цю ваду знімає HDBSCAN — кнопка поруч, — який перебирає цілий діапазон радіусів замість одного. Параметр minPts діє м'якше: він задає, скільки сусідів робить точку ядром, і головно впливає на те, що вважати шумом.
Тепер про ARI, який з'явився в нижньому ряду. Він порівнює знайдені групи зі справжніми, і саме тут ховається головна пастка кластеризації: у реальній задачі цього числа у вас немає. Подивіться на дві останні плашки. Найкраще, чого досягає DBSCAN на цьому наборі, зазвичай не гірше за HDBSCAN, а часом і краще — але це «найкраще» знайдене перебором по всій сітці ε × minPts, тобто з підглядуванням у відповідь. Посуньте ε на один крок від найкращого значення й подивіться, як падає ARI: у DBSCAN падіння різке, у HDBSCAN між сусідніми значеннями мінімального розміру — плавне. Перевага HDBSCAN не в тому, що його пік вищий, а в тому, що біля піку рівніше — і на нього легше потрапити, коли перевірити нічим.
HDBSCAN міняє гострий параметр на тупий
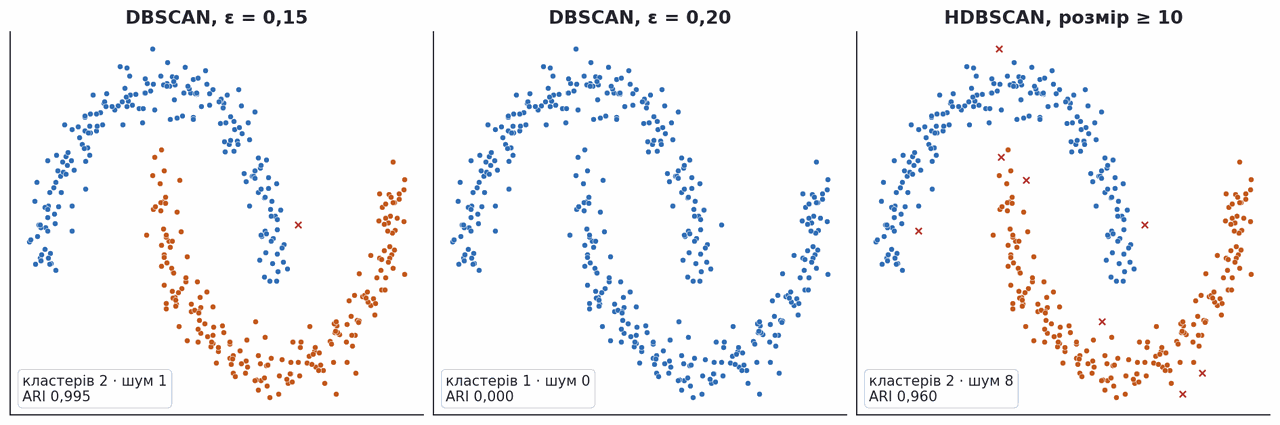
Твердження з попереднього розділу легко перевірити числом. HDBSCAN є в scikit-learn від версії 1.3, зовнішніх залежностей не потребує, а замість радіуса
Вивід код запущено, вивід не редагувався
text
DBSCAN  ε = 0.15  кластерів  2  шум   1  ARI 0.995
DBSCAN  ε = 0.20  кластерів  1  шум   0  ARI 0.000
DBSCAN  ε = 0.30  кластерів  1  шум   0  ARI 0.000
HDBSCAN mcs =  5   кластерів 13  шум  64  ARI 0.558
HDBSCAN mcs = 10   кластерів  2  шум   8  ARI 0.960
HDBSCAN mcs = 20   кластерів  2  шум  13  ARI 0.927
На що дивитися: DBSCAN переходить від майже ідеального ARI 0,995 до одного злитого кластера, щойно ε зростає з 0,15 до 0,20, а HDBSCAN при mcs 10 і 20 тримає ARI вище 0,92.
Різниця разюча. У DBSCAN між
Слово «тупий» тут не образа, а точний опис: гострий параметр — той, у якому мала помилка руйнує результат. Але й HDBSCAN не безпараметричний: при мінімальному розмірі 5 він розсипає ті самі дані на тринадцять кластерів і дає лише 0,558.
На Wine щільнісні методи не працюють обидва
Спокуса після попереднього розділу — узяти HDBSCAN замість DBSCAN і заспокоїтися. Перевірмо на реальних даних: Wine, 178 вин, тринадцять стандартизованих ознак, три справжні сорти.
Вивід код запущено, вивід не редагувався
text
DBSCAN  ε = 2.0  кластерів  5  шум  85  ARI 0.220
DBSCAN  ε = 2.5  кластерів  1  шум  24  ARI 0.005
DBSCAN  ε = 3.0  кластерів  1  шум  11  ARI -0.006
HDBSCAN mcs =  5   кластерів  2  шум  58  ARI 0.346
HDBSCAN mcs = 10   кластерів  2  шум  75  ARI 0.263
На що дивитися: жоден щільнісний метод не знаходить трьох сортів: найкращий ARI лише 0,346, і то ціною 58 точок, записаних у шум.
Найкращий DBSCAN дає ARI 0,220 при 85 точках шуму зі 178; при більшому радіусі він зливає все в один кластер (ARI 0,005). Найкращий HDBSCAN — 0,346, теж ціною 58 точок шуму. Для порівняння: K-means на тих самих даних дає 0,90.
Причина не в алгоритмах, а в геометрії, докладніше про неї — у лекції 09. У тринадцятивимірному просторі відстані між усіма точками зближуються, тож саме поняття «щільна область» розмивається: щільність, за якою один кластер уже виділяється, для іншого ще не настала. Щільнісні методи створені для двох-трьох вимірів, де згущення видно оком, — і використовувати їх варто саме там, а у високій розмірності спершу знижувати її методами лекції 09.
Півмісяці: K-means проти DBSCAN
Класичний тест на форму кластерів. Дані — два вигнуті пасма плюс 45 випадкових точок фону, які імітують шум вимірювань.
K-means зобов'язаний провести пряму межу і тому розрізає обидва півмісяці навпіл: ARI зі справжніми пасмами лише 0,475. DBSCAN із
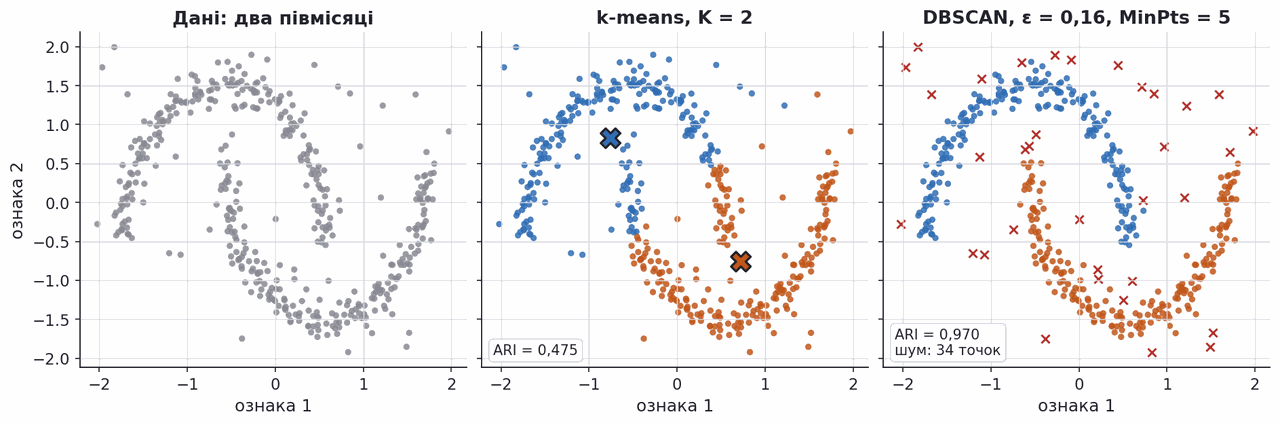
Причина поразки K-means геометрична. Точка йде до найближчого центроїда, тому область кластера — перетин півплощин «ближче до
Червоні хрестики на правій панелі — об'єкти, від яких DBSCAN відмовився. Жоден центроїдний метод такої відповіді дати не може: у K-means кожна точка обов'язково комусь належить.
Код: DBSCAN на зашумлених півмісяцях
Вивід код запущено, вивід не редагувався
text
кластерів  : 2
шум        : 34 точок із 445
ARI DBSCAN : 0.97
ARI k-means: 0.475
На що дивитися: DBSCAN знаходить обидва півмісяці (ARI 0,97) і відкидає 34 точки як шум, а K-means ріже їх прямою й отримує лише 0,475.
Зверніть увагу на мітку −1: у scikit-learn нею позначається саме шум, і при підрахунку кластерів її треба виключати вручну.
Джерело: scikit-learn · DBSCAN
K-means і DBSCAN поруч
| Властивість | K-means | DBSCAN |
|---|---|---|
| Число кластерів | задається наперед | виникає з даних |
| Форма кластерів | опуклі комірки Вороного | довільні зв'язні щільні області |
| Викиди | тягнуть центроїди, кластеризується все | позначаються окремою міткою шуму |
| Чутливість до старту | висока, потрібні рестарти | відсутня, крім рідких межових точок |
| Гіперпараметри | ||
| Вартість | ||
| Нові об'єкти | найближчий центроїд, миттєво | потрібні запити відстаней до навчальної вибірки |
Головне обмеження DBSCAN не в таблиці: у високих вимірностях поняття щільності розмивається, бо всі відстані стають приблизно однаковими. Практично метод добре працює до кількох десятків ознак, а далі його зазвичай ставлять після зниження розмірності.
Ієрархічна кластеризація будує дерево
Третій підхід відмовляється від єдиного розбиття. Агломеративна ієрархічна кластеризація (agglomerative hierarchical clustering) починає з того, що кожен об'єкт — окремий кластер, і на кожному кроці зливає два найближчі. Через
Це дерево малюють як дендрограму (dendrogram): по горизонталі — об'єкти або вже зібрані групи, по вертикалі — відстань злиття. Розріз горизонтальною лінією дає розбиття, і його висота задає число кластерів, тож
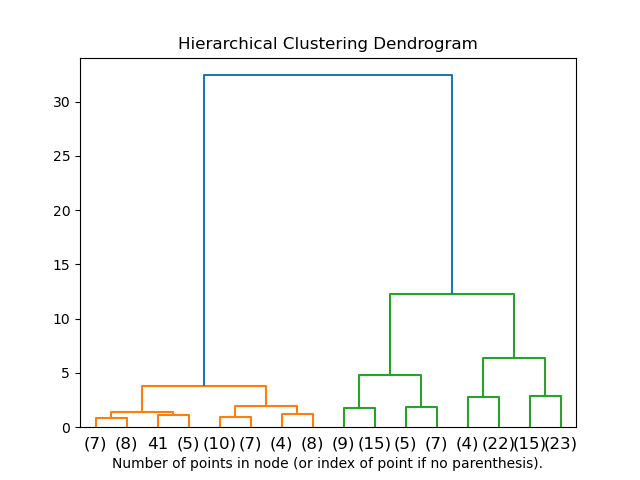
На дендрограмі Iris верхнє злиття відбувається на висоті 32, наступне — уже на 12, а всі решта показаних злиттів лежать нижче семи. Такий розрив означає, що поділ на дві або три групи природний, а дрібніші — уже штучні.
Джерело: scikit-learn · Plot Hierarchical Clustering Dendrogram
Спосіб зв'язування визначає форму кластерів
Щоб зливати кластери, потрібна відстань між групами, а не між точками. Її задає правило зв'язування (linkage), і вибір правила змінює результат сильніше за будь-який інший параметр.
Single бере мінімальну відстань між групами: тягнеться вздовж вигнутих структур, але схильний до ланцюжкового ефекту. Complete бере максимальну й дає компактні групи. Average усереднює попарні відстані. Ward зливає пару, яка найменше збільшує WCSS, тому поводиться найближче до K-means.
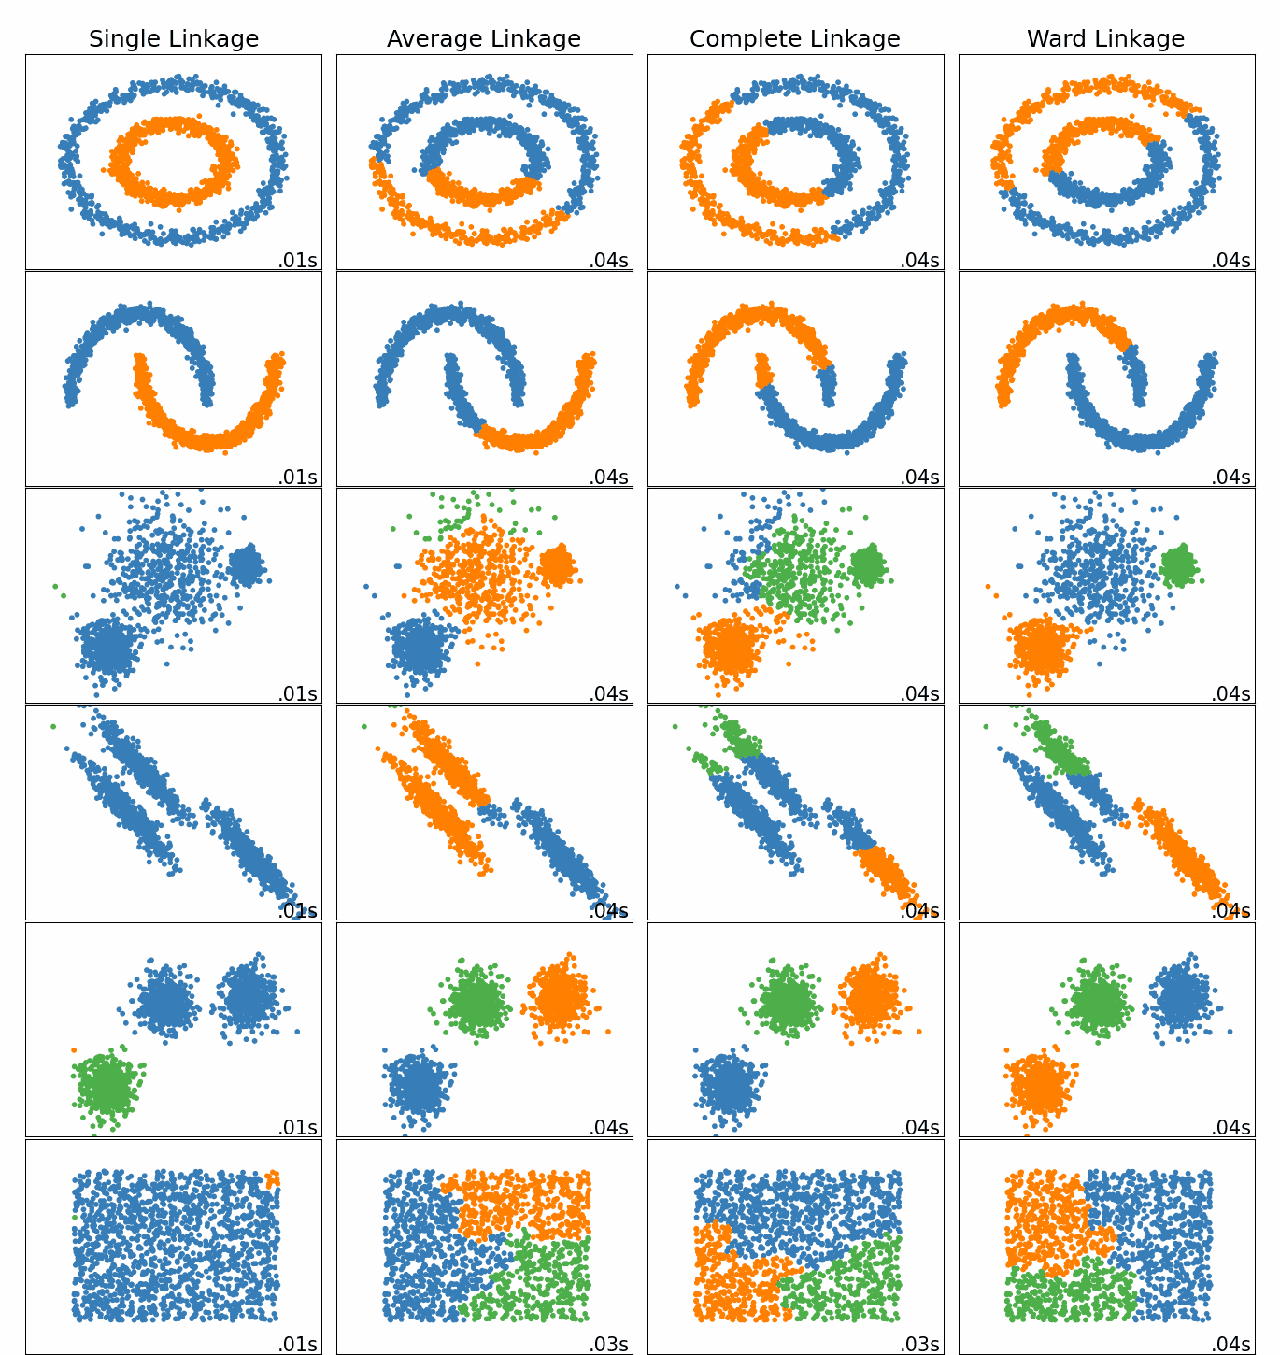
На стандартизованому Wine із трьома кластерами різниця вимірна: ward дає ARI 0,790, complete — 0,577, а average і single — біля нуля, бо обидва відрізають кілька поодиноких точок і лишають решту 174 зразки в одному велетенському кластері.
Джерело: scikit-learn · Comparing hierarchical linkage methods
Імовірнісний погляд на K-means
Повернімося до K-means і подивимось на нього очима лекції 04. Припустимо, що кожен кластер — це ізотропний гаусіан із центром
Логарифм цієї правдоподібності по всій вибірці дорівнює
Записавши припущення явно, ми одразу бачимо, що саме в них не так. Коваріація зафіксована як
Суміш гаусіанів знімає обидва обмеження
Суміш гаусіанів (Gaussian mixture model, GMM) описує дані як генеративний процес із двох кроків: спершу випадково обираємо компоненту
Тепер у кожної компоненти є власна коваріація
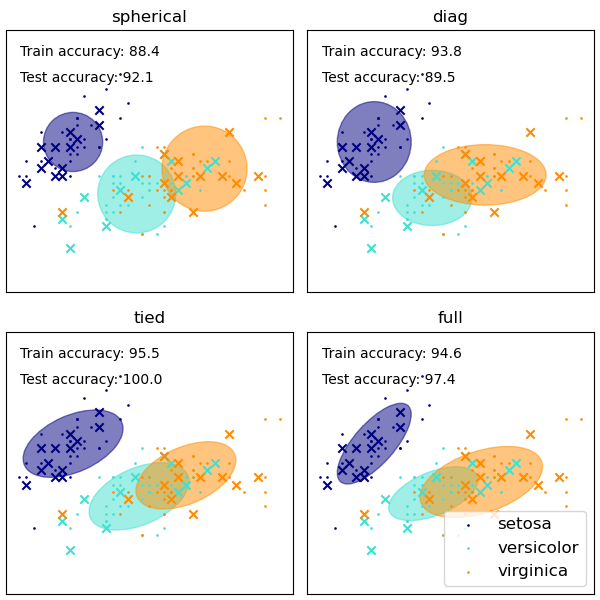
На Iris видно ціну гнучкості: spherical малює кола — це майже K-means; tied дає всім компонентам однаковий нахилений еліпс; full — власний еліпс кожній, але вимагає оцінити tied: гнучкіша модель не завжди краща.
Джерело: scikit-learn · GMM covariances
E-крок і M-крок алгоритму EM
Якби ми знали, з якої компоненти взялася кожна точка, оцінити
E-крок рахує м'які призначення — апостеріорні ймовірності належності при поточних параметрах:
M-крок перераховує параметри як зважені оцінки, де вагою кожної точки є її
Кожна ітерація не зменшує log-правдоподібність — це видно на тих самих Iris:
| Ітерація | log-правдоподібність | Приріст |
|---|---|---|
| 1 | −186,90 | — |
| 2 | −183,00 | +3,89 |
| 3 | −181,23 | +1,77 |
| 4 | −180,53 | +0,70 |
| 5 | −180,29 | +0,25 |
| 6 | −180,21 | +0,08 |
Приріст додатний на кожному кроці й швидко згасає — та сама картина, що у WCSS, тільки величина росте. Саме по собі це ще не збіжність: правдоподібність GMM із вільними коваріаціями не обмежена зверху, бо компонента може «сісти» на одну точку. Тому коваріації регуляризують (reg_covar). Ітерація коштує
Числовий приклад E-кроку на одній квітці
Візьмімо навчену на Iris суміш із трьох компонент і подивимось, що E-крок скаже про квітку №77. Це versicolor, яка лежить у зоні перекриття з virginica.
Підставляємо її вимірювання у формулу: рахуємо три добутки
Компонента, що відповідає setosa, отримує нуль — квітка від неї дуже далеко. Дві інші ділять імовірність у пропорції приблизно 38 до 62: модель схиляється до virginica, але лишає суттєвий сумнів.
K-means на тих самих даних просто відніс би цю квітку до кластера, де переважає virginica, і на цьому зупинився. Різниця не косметична: у медичній чи фінансовій задачі саме об'єкти з
Жорсткі призначення проти м'яких
Той самий набір даних, дві перекриті групи. Ліворуч K-means: пряма межа й дві категорії, точка на самій межі отримує мітку без жодного застереження. Праворуч GMM: неперервна карта ймовірності
Обведена точка лежить рівно посередині. K-means дає їй мітку 0 або 1 залежно від того, з якого боку від межі вона опинилась. GMM повідомляє
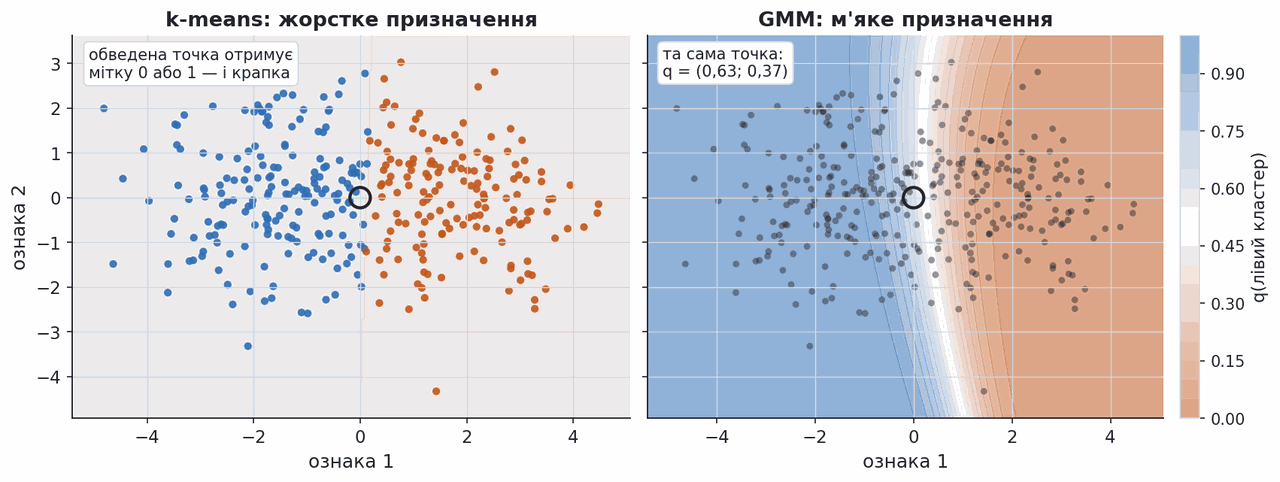
Існує проміжний варіант — жорсткий EM, у якому E-крок бере не ймовірності, а найімовірнішу компоненту. Якщо в ньому додатково зафіксувати
Код: GaussianMixture на Iris
Вивід код запущено, вивід не редагувався
text
частки суміші π: 0.301  0.333  0.365
ARI з видами   : 0.904
квітка №77 (versicolor):  q = 0.376  0.000  0.624
На що дивитися: квітка №77 розділена між двома компонентами як 0,376 і 0,624 — м'яке призначення показує невизначеність, яку K-means сховав би.
Порівняйте з K-means на тих самих даних: ARI 0,620 проти 0,904, помилок 5 квіток замість 25. Виграш дає саме вільна коваріація — versicolor і virginica утворюють витягнуті, а не кулясті хмари. Параметр init_params="k-means++" не випадковий: EM зазвичай ініціалізують K-means, бо він швидко дає розумну стартову точку.
Джерело: scikit-learn · GaussianMixture
EM виграє там, де K-means програє
Повернімося до двох випадків, на яких K-means зламався: витягнуті кластери й кластери різної дисперсії. На тих самих даних суміш гаусіанів дає правильну відповідь.
Причина суто в припущеннях. Вільна коваріація
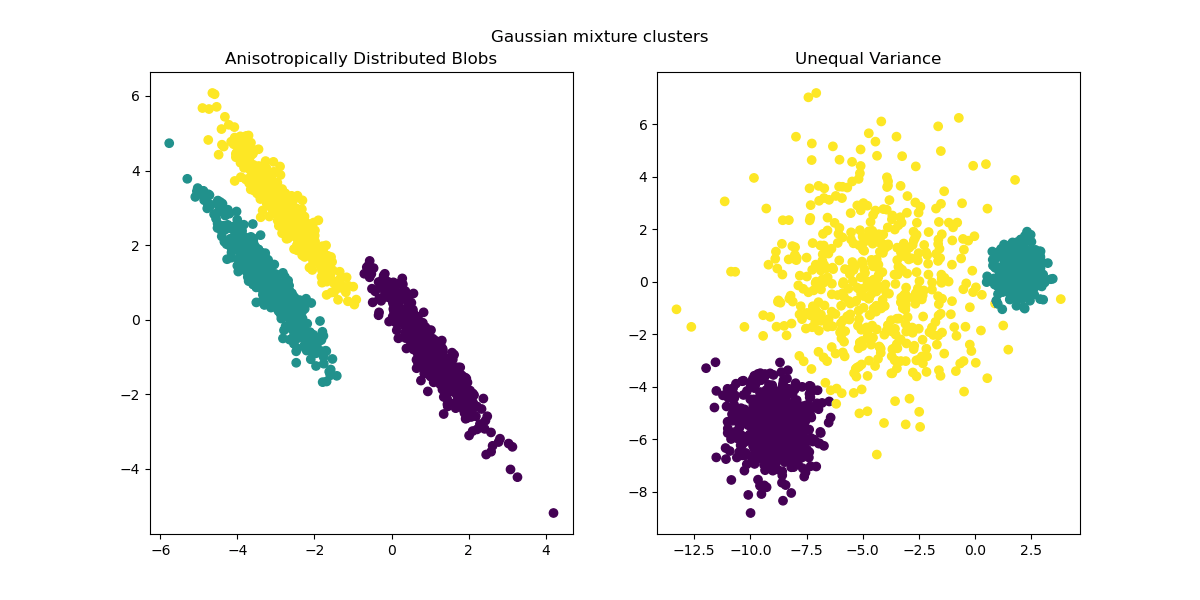
Ціна відома: ітерація дорожча, ітерацій зазвичай більше, а параметрів треба оцінити значно більше — при 13 ознаках Wine повна коваріація однієї компоненти має 91 число. На малій вибірці це швидко призводить до перенавчання, і тоді обирають обмежений тип коваріації.
Джерело: scikit-learn · Demonstration of k-means assumptions, Gaussian mixture
Вибір числа компонент для GMM
Для K-means число кластерів крос-перевіркою обрати не вдавалося: WCSS на відкладеній вибірці монотонно спадає зі зростанням
Є пастка. Правдоподібність суміші необмежена зверху: посадивши компоненту точно на одну точку й стиснувши її коваріацію до нуля, дістанемо нескінченність. Тому на практиці або обмежують коваріації знизу, або обирають число компонент за критерієм, який штрафує складність.
Найпоширеніший — байєсівський інформаційний критерій (Bayesian information criterion, BIC): до від'ємної log-правдоподібності додається штраф
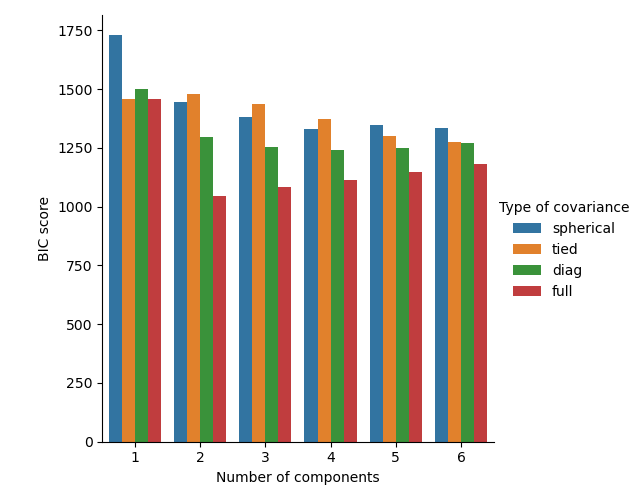
На рисунку перебираються і число компонент, і тип коваріації. Мінімум припадає на дві компоненти з повною коваріацією — і це справді та модель, з якої дані породжено.
Джерело: scikit-learn · Gaussian Mixture Model Selection
K-means і EM поруч
| Властивість | K-means | EM для суміші гаусіанів |
|---|---|---|
| Призначення | жорсткі, | м'які, |
| Форма кластера | сфера фіксованого радіуса | еліпс довільної форми й нахилу |
| Розміри кластерів | неявно однакові | керуються частками |
| Що оцінюється | тільки центроїди | |
| Вартість ітерації | ||
| Вибір числа груп | лікоть, силует, доменні знання | валідаційна правдоподібність, BIC |
| Побічний результат | немає | оцінка щільності |
Останній рядок варто розгорнути. Навчена суміш дає щільність у будь-якій точці простору, тому її використовують для пошуку аномалій: якщо
На практиці два методи не конкурують, а працюють у парі: K-means дешево знаходить розумну стартову точку, EM її уточнює.
Кластеризація як стиснення: квантування кольору
Наочне застосування, у якому кластери не мають жодного «змісту», а користь очевидна. Візьмімо зображення й подивимось на кожен піксель як на точку в просторі яскравостей. Кластеризуємо ці точки й замінимо кожен піксель центроїдом його кластера. Це квантування векторів (vector quantization).
Арифметика проста: сірий піксель зазвичай займає 8 біт, тобто 256 рівнів. Після K-means із
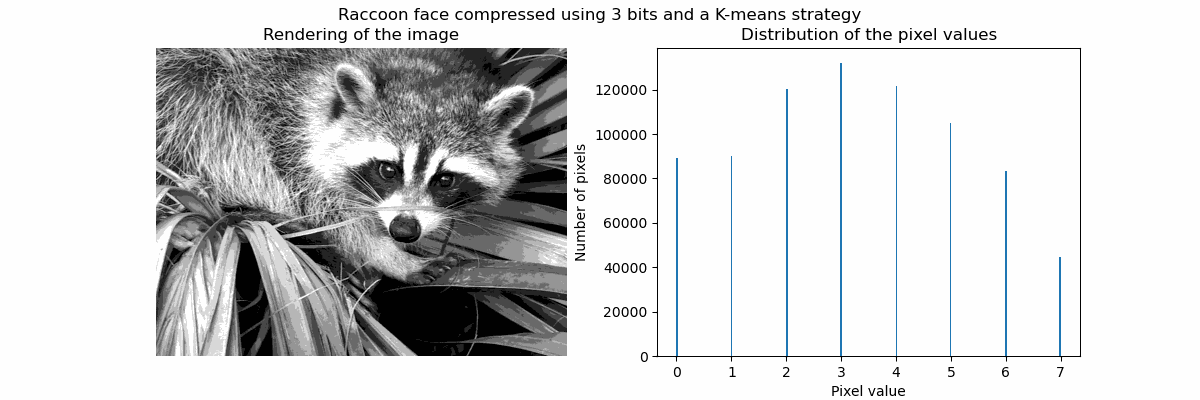
Праворуч видно, що зробив K-means із розподілом яскравостей: неперервна гістограма перетворилася на вісім стовпчиків, і висота кожного показує, скільки пікселів дістав відповідний рівень. Центроїди при цьому розташовані нерівномірно — вони густіші там, де пікселів більше, тому спотворення менші, ніж від рівномірного поділу шкали на вісім частин.
Джерело: scikit-learn · Vector Quantization Example
Обмеження кластеризації
Правильної відповіді не існує. Один і той самий набір даних можна осмислено розбити кількома способами: покупців — за віком або за сумою чека, тексти — за темою або за мовою. Алгоритм повертає розбиття, а не істину, і рішення, чи воно корисне, лишається за предметним фахівцем.
Оцінити результат складно. Зовнішні метрики на кшталт ARI потребують міток, яких у реальній задачі немає. Внутрішні, як силует, вимірюють лише геометрію й нічого не знають про зміст.
Кожен метод має власне означення кластера. K-means бачить кулі, DBSCAN — щільні області, ієрархічні методи — те, що задає правило зв'язування. Тому вони дають різні відповіді не через помилку, а за побудовою.
Результат залежить від підготовки даних. Масштаб ознак, вибір відстані та наявність викидів впливають на розбиття не менше, ніж сам алгоритм.
Висока розмірність шкодить усім. З ростом
Підсумок лекції
Без міток задача змінює природу. Замість відтворення відомої відповіді ми шукаємо структуру, і критерію правильності ззовні немає.
K-means мінімізує внутрішньокластерну суму квадратів алгоритмом Ллойда: крок призначення й крок оновлення — обидва точні мінімізації за однією групою змінних. Звідси незростання цілі й скінченна збіжність, але лише до локального мінімуму.
Слабкі місця K-means системні: залежність від старту лікується рестартами й k-means++, вибір
DBSCAN замінює означення кластера на щільнісне, тому знаходить групи довільної форми, не потребує
Суміш гаусіанів — це K-means із вільною коваріацією та м'якими призначеннями. EM чергує оцінку ймовірностей належності й перерахунок параметрів; на Iris це підняло ARI з 0,620 до 0,904.
Оцінювати результат треба обережно: ARI вимагає міток, силует міряє тільки геометрію, а остаточне слово — за задачею, задля якої кластеризацію робили.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекції 10b і 11a
- UBC CPSC 340 — лекції 8 і 9
- Stanford CS229 — розділи 10–11
Статті
- k-means++: The Advantages of Careful Seeding — Arthur, Vassilvitskii, SODA 2007
- A Density-Based Algorithm for Discovering Clusters — Ester та ін., KDD 1996
Підручники
- Bishop. Pattern Recognition and ML — розділ 9
- Hastie та ін. Elements of Statistical Learning — розділ 14
Документація й дані