Тема
Лекція 06 · Найближчі сусіди, дерева рішень та ансамблі
У попередній лекції межу між класами задавало рівняння прямої. Сьогодні розглянемо методи, які рівняння не пишуть узагалі: одні запам'ятовують дані й вирішують за схожістю, інші розрізають простір ознак послідовністю простих питань. Наприкінці об'єднаємо сотні таких моделей в ансамбль і побачимо, чому саме він виграє на табличних даних.
Зміст лекції
Логістична регресія з лекції 05 описувала межу рішення (decision boundary) одним рівнянням із вектором ваг. Методи цієї лекції влаштовані інакше: метод найближчих сусідів зберігає всю таблицю й для нового об'єкта дивиться, на кого той схожий, а дерево рішень будує послідовність простих перевірок «ознака більша за поріг чи ні». Такі методи називають непараметричними (non-parametric): розмір моделі росте разом із вибіркою, а межа може бути як завгодно нелінійною.
"Non-parametric models: number of parameters grows with n; size of model depends on n." — UBC CPSC 340, лекція 6
Шлях лекції — від ідеї «подивись на сусідів» до ансамблів, які сьогодні є стандартним вибором для табличних даних.
- Метод k найближчих сусідів. Прогноз за схожістю — покроково на одному вині, вибір k, роль масштабу ознак.
- Дерево рішень. Вкладені перевірки, домішка й приріст інформації, вибір порога для числової ознаки, рекурсивна побудова дерева на десяти пасажирах, регресійний пеньок.
- Перенавчання й обрізання дерева. Глибина, кількість листків, обрізання за складністю.
- Беггінг і випадковий ліс. Бутстреп, випадкові ознаки у вузлах — покроково на тих самих десяти пасажирах, гіперпараметри, важливість ознак.
- Бустинг. Градієнтний бустинг, AdaBoost і XGBoost — кожен покроково на маленькому прикладі, — регуляризація, рання зупинка і LightGBM.
Кожен блок закриває слабке місце попереднього: сусідам потрібна вдала відстань між об'єктами — дерево обходиться без неї й розглядає ознаки по одній; одне дерево нестабільне — ліс усереднює багато дерев; ліс не вміє цілеспрямовано виправляти власні помилки — бустинг будує дерева одне за одним саме заради цього.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, як метод k найближчих сусідів робить прогноз, і чому в нього немає фази навчання;
- обґрунтувати вибір k через компроміс зміщення й дисперсії та показати його на кривій похибки;
- побудувати дерево рішень, прочитати його правила вголос і простежити шлях конкретного об'єкта до листа;
- порахувати ентропію або індекс Джині вузла, перебрати пороги числової ознаки, обрати найкраще правило і пройти рекурсивну побудову дерева на маленькому прикладі;
- пройти вручну навчання беггінгу, випадкового лісу, AdaBoost і градієнтного бустингу на кількох прикладах і перевірити числа кодом;
- розпізнати перенавчене дерево й зменшити його обрізанням за складністю;
- пояснити, чому беггінг знижує дисперсію, а бустинг — зміщення, і коли який доречніший;
- прочитати важливість ознак за зменшенням домішки та пермутаційну важливість і сказати, коли перша обманює;
Дані лекції: вина, пасажири «Титаніка» і пухлини
Три набори, кожен показує свій бік теми.
Wine — 178 зразків вина трьох сортів, 13 хімічних вимірів: вміст спирту, флаваноїдів, магнію, проліну, інтенсивність кольору. Передбачаємо сорт. Ознаки виміряні в різних одиницях, тому набір добре показує, що робить масштабування з методом сусідів.
Titanic — 891 пасажир, ознаки змішані: числові (вік, вартість квитка), категоріальні (стать, порт посадки) і з пропусками (вік невідомий у 177 випадках). Передбачаємо, чи вижив пасажир. Саме тут дерево показує свою сильну сторону.
Breast Cancer Wisconsin — 569 пухлин, 30 числових ознак; на ньому наприкінці порівняємо всі методи лекції між собою.
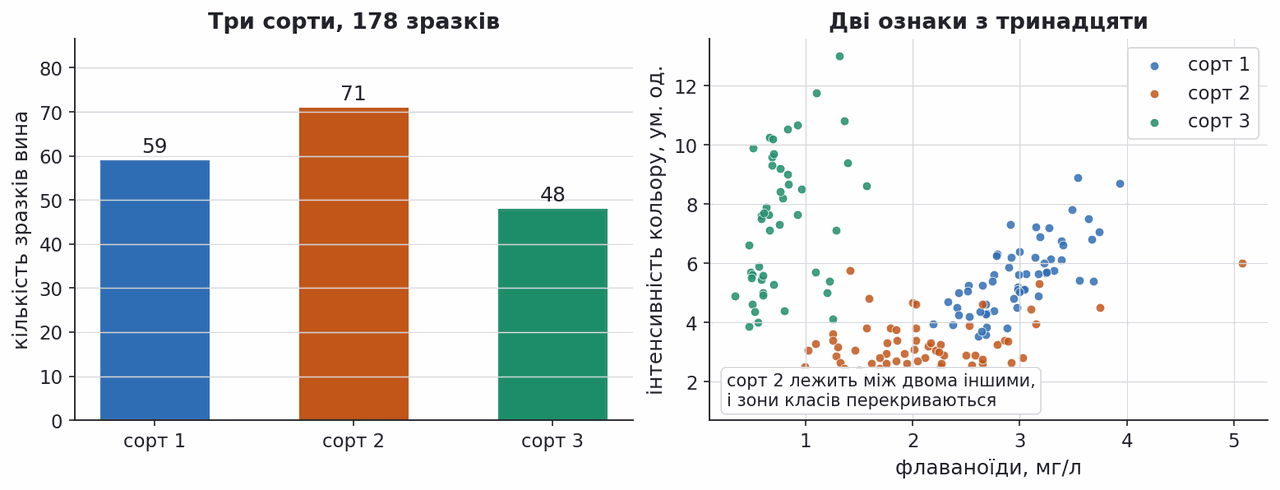
Джерела даних: Wine, UCI · Titanic, seaborn-data · Breast Cancer, UCI
Метод k найближчих сусідів
Ідея вкладається в одне речення: щоб класифікувати новий об'єкт, знайди в тренувальній вибірці k найсхожіших на нього і віддай найпоширенішу серед них мітку.
"To classify an example: 1. Find the 'k' training examples that are 'nearest' to it. 2. Classify using the most common label of 'nearest' training examples." — UBC CPSC 340, лекція 6
Метод спирається на одне припущення: об'єкти зі схожими ознаками мають схожі мітки. Фази навчання тут немає взагалі — алгоритм просто зберігає таблицю, тому його називають лінивим навчанням (lazy learning): уся робота відкладена на момент запиту.
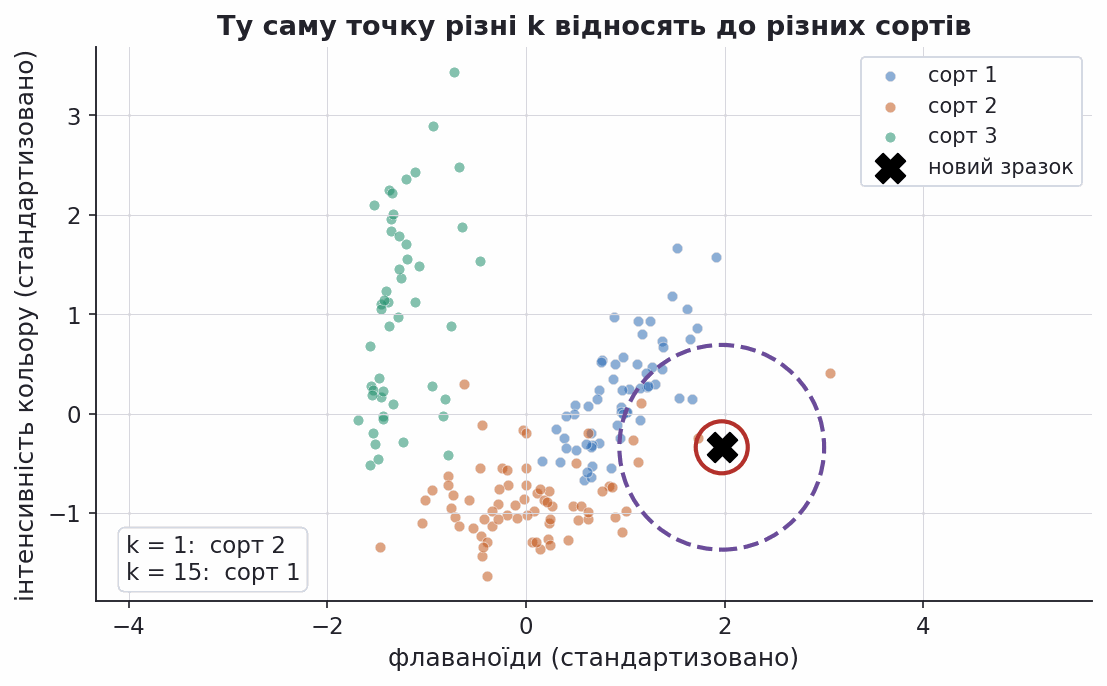
На рисунку одна й та сама точка, позначена хрестиком, при k = 1 отримує мітку «сорт 2», бо саме такий її найближчий сусід, а при k = 15 — «сорт 1», бо в ширшому колі переважають сині зразки. Прогноз залежить від k не менше, ніж від самих даних.
Формула прогнозу і міра близькості
Позначимо тренувальну вибірку
| Позначення | Значення |
|---|---|
| кількість зразків і кількість ознак | |
| скільки сусідів беремо до уваги | |
| самі сусіди: k найближчих точок вибірки | |
| евклідова відстань; коштує |
Дві дрібниці, які видно лише на практиці. Множина сусідів визначена неоднозначно, коли кілька точок лежать на однаковій відстані; за парного k можлива нічия в голосуванні, тому k беруть непарним. Замість простого голосу сусідам часто дають ваги, обернені до відстані — ближчий сусід важить більше.
Прогноз методу сусідів покроково: одне вино
Розберімо один прогноз від початку до кінця. Ознаки ті самі, що на рисунках вище, — флаваноїди й інтенсивність кольору; розбиття 70/30 зі збереженням часток сортів, яке далі використовуємо всю лекцію: 124 вина для навчання, 54 для перевірки. Нове вино — зразок 52 тестової частини, обраний як приклад біля межі сортів.
«Навчання» тут зводиться до запам'ятовування: зберегти 124 вина й обчислити для кожної ознаки середнє
Прогноз для нового вина — чотири кроки:
- Стандартизувати його ознаки тими самими
і . - Порахувати евклідову відстань до кожного з 124 вин.
- Відсортувати відстані й узяти
найменших. - Віддати сорт, за який серед цих
сусідів найбільше голосів.
Вивід код запущено, вивід не редагувався
text
μ = [2.064 5.09 ]  s = [1.019 2.36 ]
нове вино: [2.68 4.6 ] → z = [ 0.604 -0.207]
1. z = [ 0.575 -0.207], відстань 0.029, сорт 2
2. z = [ 0.555 -0.309], відстань 0.113, сорт 1
3. z = [ 0.614 -0.326], відстань 0.119, сорт 1
4. z = [ 0.604 -0.343], відстань 0.136, сорт 1
5. z = [ 0.457 -0.377], відстань 0.224, сорт 1
k = 1: голоси за сорти 1–3 [0 1 0] → сорт 2
k = 3: голоси за сорти 1–3 [2 1 0] → сорт 1
k = 5: голоси за сорти 1–3 [4 1 0] → сорт 1
scikit-learn, k = 5: сорт 1 | справжній: 1
На що дивитися: найближче вино, на відстані 0,029, належить до сорту 2, а наступні чотири — до сорту 1; тому один сусід помиляється, а три й п'ять дають правильний сорт 1.
Перевірмо руками перший рядок виводу. Для флаваноїдів
Один сусід — це одна випадковість. Найближче вино виявилося сортом 2, і при
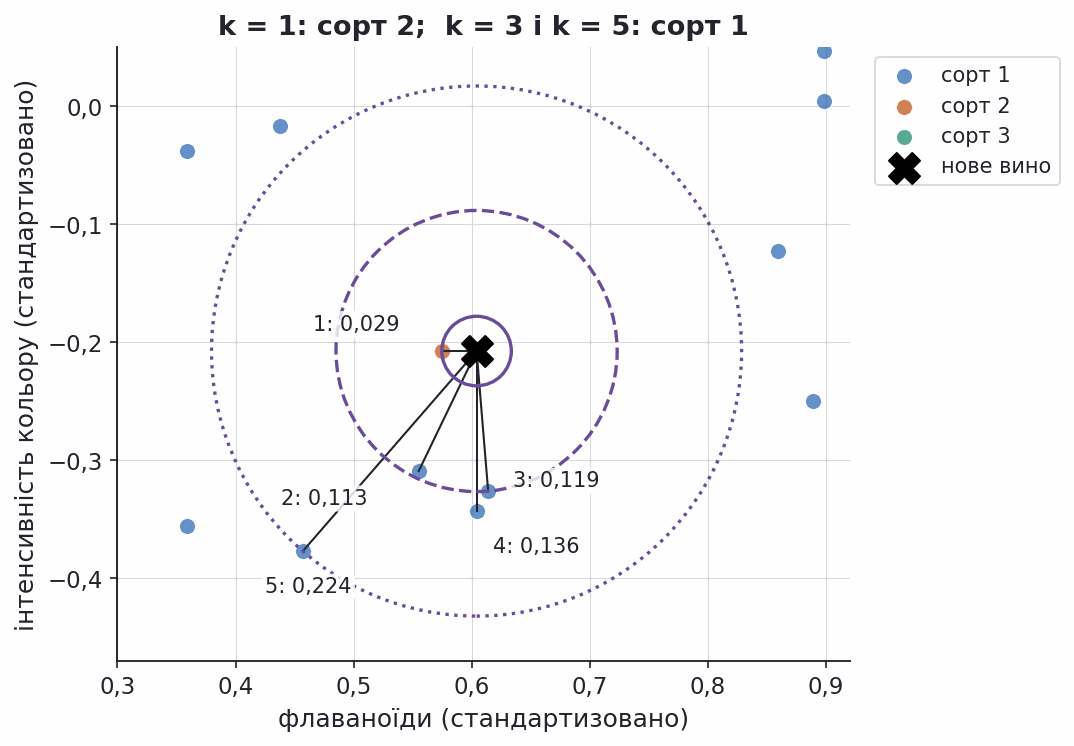
Нове вино (хрестик) і п'ять його найближчих сусідів у стандартизованих ознаках; числа біля ліній — відстані; кола — межі околиці: суцільне для k = 1, штрихове для k = 3, пунктирне для k = 5.
Мале k дає рвану межу, велике — гладку
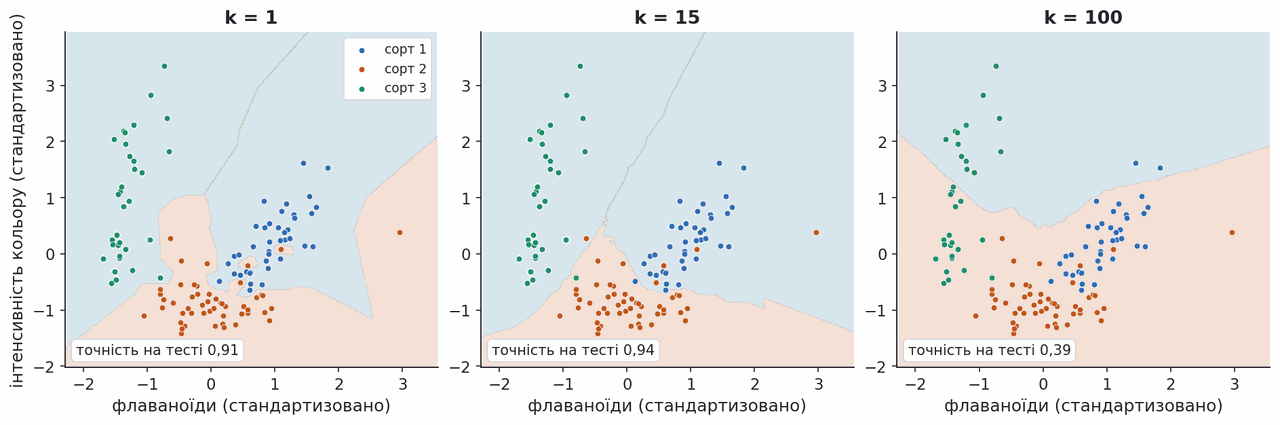
Параметр k керує складністю моделі, причому в незвичний бік: чим менше k, тим складніша модель. При k = 1 межа проходить точно між точками різних класів, утворюючи острівці навколо окремих зразків, а тренувальна похибка дорівнює нулю: найближчий сусід кожної тренувальної точки — вона сама. Це перенавчання (overfitting): низьке зміщення, висока дисперсія. У протилежній крайності, коли k дорівнює розміру вибірки, модель усім ставить найпоширенішу мітку.
На даних Wine (124 вина для навчання, 54 для перевірки): при k = 1 усередині синьої зони видно помаранчеві острівці; при k = 15 межа згладжується, і точність на тесті навіть зростає — з 0,91 до 0,94; при k = 100 сусідами стають майже всі вина, один клас поглинає решту, і точність падає до 0,39 — рівня найбільшого класу.
Тому k підбирають, а не вгадують, і роблять це на даних, яких модель не бачила. Крива похибки для всіх k від 1 до 60 (десятиразова перехресна перевірка з десятьма повтореннями): при k = 1 модель помиляється на нових даних у 4,4 % випадків, оптимум — k = 34 з похибкою 2,0 %, а до k = 60 похибка знову зростає до 4,1 %, бо модель стає надто грубою.
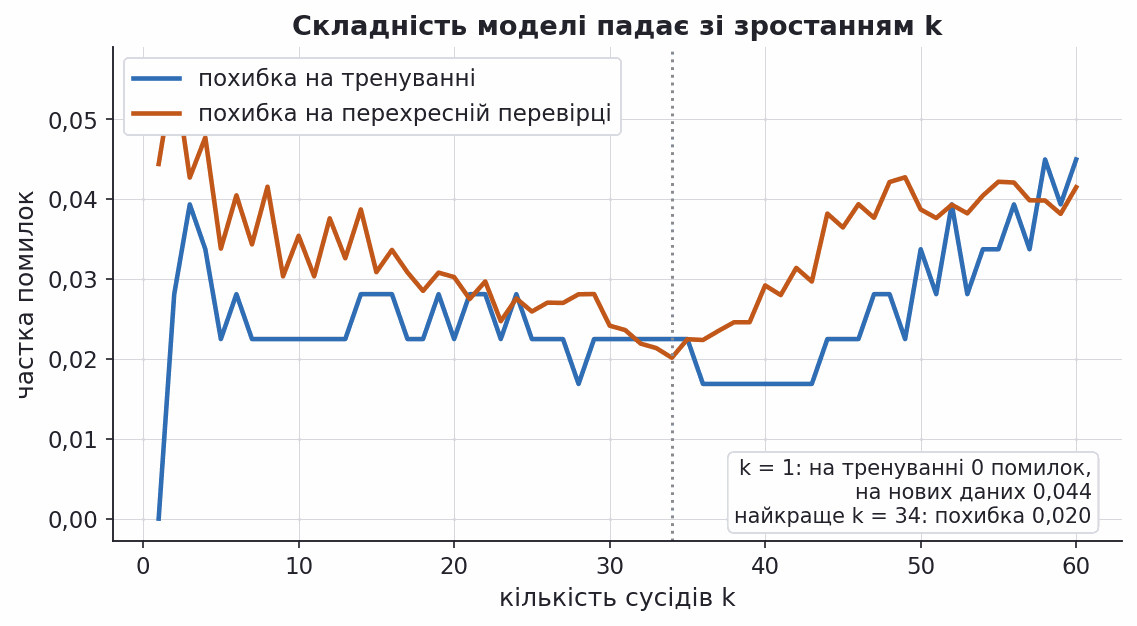
Крім k = 1, тренувальна й перевірочна криві майже збігаються: метод нічого не підганяє під тренувальні дані, він їх просто зберігає.
k керує гладкістю межі
Ті самі дані, що на рисунку: три сорти вина у двох ознаках, 124 зразки для навчання і 54 відкладених. Межа рішень перераховується просто тут — для будь-якого k, не лише для трьох показаних.
сорт 1сорт 2сорт 3
0,94точність на 54 відкладених
0,94точність на навчальних
15сусідів голосує за клас
При k = 1 регіони рвані: всередині чужої зони стоять острівці навколо окремих зразків, а точність на навчальних даних дорівнює одиниці — модель просто пам'ятає їх. При k = 15 межа згладжується, і точність на відкладених навіть зростає, від 0,91 до 0,94. Тягніть повзунок далі: при k = 100 сусідами стають майже всі навчальні зразки, найбільший клас поглинає решту, і точність падає до 0,39 — рівня найбільшого класу. Отже, k підбирають, а не вгадують, і робити це треба на окремій вибірці.
Тепер вимкніть «стандартизувати». На парі «флаваноїди + інтенсивність кольору» зміна невелика — 0,94 проти 0,91, — бо обидві ознаки міряються одиницями й відстань лишається розумною. Перемкніться на пару з проліном і подивіться ще раз: 0,87 проти 0,63. Пролін міряють сотнями, флаваноїди одиницями, тому в сирих даних відстань між винами визначає майже виключно пролін: другої ознаки для методу фактично не існує, а межа стає смугами. Це та сама теза, що на рисунку про масштаб, тільки її тут можна вимкнути й увімкнути. Зверніть увагу й на те, як рахується масштаб: середнє і стандартне відхилення взято лише з навчальної частини, інакше у відстані просочилася б інформація про відкладені зразки.
Масштаб ознак вирішує, хто вважається сусідом
Евклідова відстань додає квадрати різниць по всіх ознаках. Якщо одна ознака виміряна в сотнях, а решта — в одиницях, вона одна визначить суму, і сусідами стануть об'єкти, схожі лише за нею.
У наборі Wine вміст проліну лежить у межах від 278 до 1680, а вміст флаваноїдів — від 0,34 до 5,08. Розмах відрізняється в триста разів, тому на сирих даних відстань фактично рахується по одному проліну.
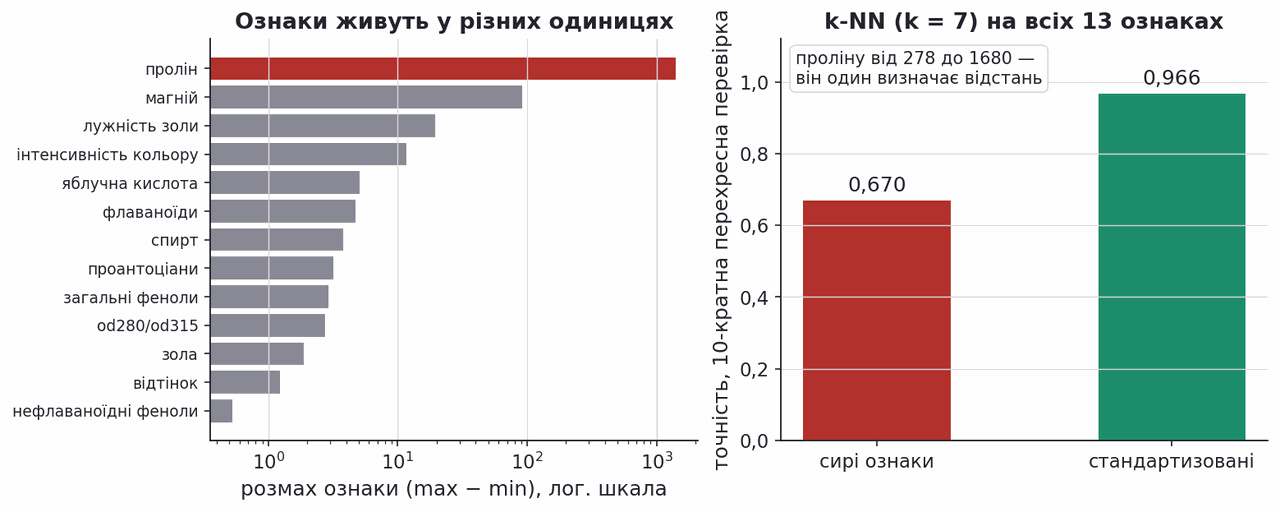
Наслідок вимірюється прямо: на сирих ознаках точність десятиразової перехресної перевірки становить 0,670, після стандартизації — 0,966. Це той самий алгоритм і ті самі дані; змінилися тільки одиниці виміру. Для методів, що спираються на відстань, масштабування ознак не косметика, а обов'язковий крок.
Стандартизацію обов'язково загортаємо в конвеєр: інакше середнє й стандартне відхилення порахуються по всій вибірці разом із тестовою частиною, і в модель просочиться інформація про тест.
Вивід код запущено, вивід не редагувався
text
зі стандартизацією: 0.963
без стандартизації: 0.685
перехресна перевірка: 0.966
На що дивитися: без стандартизації точність падає з 0,963 до 0,685: відстань між винами визначає ознака з найбільшим масштабом, а не найкорисніша.
Джерело: scikit-learn · Nearest Neighbors
Дерево рішень: програма з вкладених перевірок
Перейдемо до другої родини. Дерево рішень не рахує відстаней узагалі: воно ставить об'єкту послідовність простих питань про окремі ознаки.
"Decision trees are simple programs consisting of: a nested sequence of 'if-else' decisions based on the features (splitting rules); a class label as a return value at the end of each sequence." — UBC CPSC 340, лекція 3
Найпростіше дерево з одним правилом називають пеньком рішення (decision stump). Повне дерево будують жадібно: навчають пеньок, ділять дані на дві частини й повторюють процедуру в кожній із них, доки не спрацює критерій зупинки.
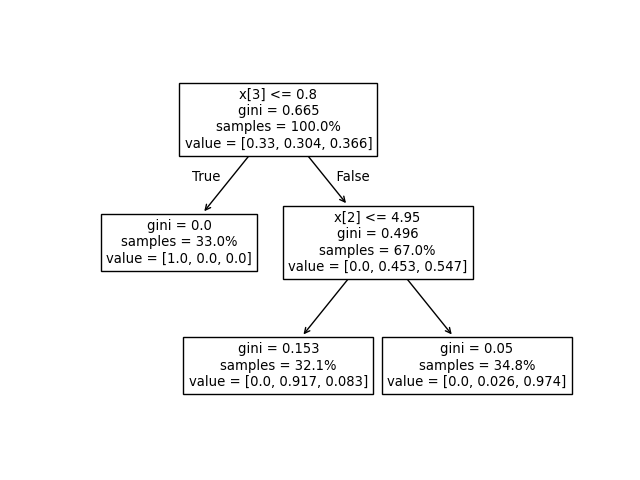
У кожному вузлі рисунка написано те саме: правило розбиття, домішка вузла, скільки зразків до нього дійшло і як вони розподілені між класами. У листках правила вже немає — там лише прогноз.
Джерело: scikit-learn · Understanding the decision tree structure
Дані «Титаніка»: пропуски, категорії й дисбаланс
Дерево показуємо на даних, які виглядають як типова робоча таблиця, а не як чистий навчальний приклад.
З 891 пасажира вижили 342, тобто 38 %. Вік невідомий для 177 осіб, номер палуби — для 688; стать і порт посадки записані текстом. Метод сусідів на таких даних без серйозної підготовки не запустиш: пропуски треба заповнити, категорії закодувати, ознаки масштабувати.
Дереву потрібне тільки кодування категорій. Пропуски у віці заповнимо медіаною — 28 років — і скажемо про це вголос: заповнення медіаною занижує розкид віку й трохи згладжує роль цієї ознаки.
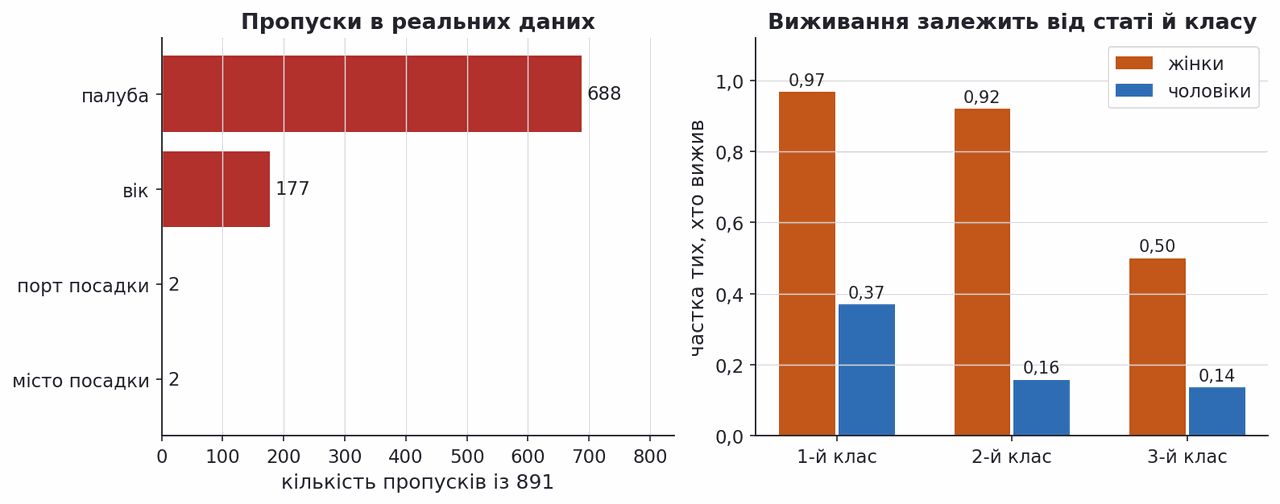
Права панель уже підказує, що знайде дерево: серед жінок першого класу вижили 97 %, серед чоловіків третього — 14 %. Стать і клас квитка виявляться двома найпершими питаннями.
Ось підготовка, на яку спираються всі наступні фрагменти коду цієї лекції:
Вивід код запущено, вивід не редагувався
text
навчальна (623, 6) · тестова (268, 6)
точність дерева на тесті: 0.832
На що дивитися: 623 пасажири йдуть на навчання, 268 — на перевірку, і дерево з трьох рівнів вгадує долю 83,2 % тестових пасажирів.
Джерело даних: seaborn-data · titanic.csv
Дерево глибини 3 на даних «Титаніка»
Навчимо дерево з обмеженням глибини трьома рівнями на 623 пасажирах, а 268 залишимо для перевірки. Точність на відкладеній вибірці — 0,832 проти 0,616 у примітивного правила «всі загинули».
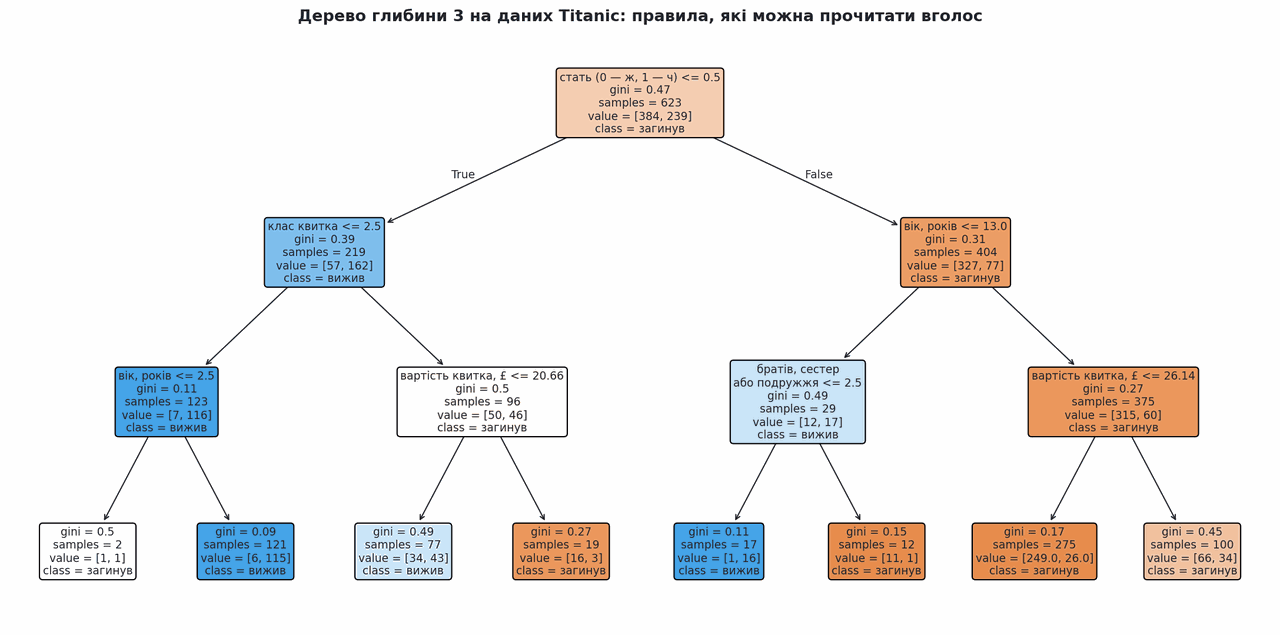
Правила читаються вголос майже літературно. Перше питання — стать. Жінки з першого та другого класу вижили майже всі: у відповідному листку 121 пасажирка, з них вижили 115. Чоловіки старші за 13 років гинули майже поголовно: найбільший листок дерева зібрав 275 таких пасажирів із дешевшими квитками, і вижили з них 26.
Саме ця прозорість — головна перевага дерева. Модель не просто видає число: вона видає правило, яке лікар, слідчий або кредитний комітет можуть прочитати й оскаржити.
Шлях одного пасажира по вузлах дерева
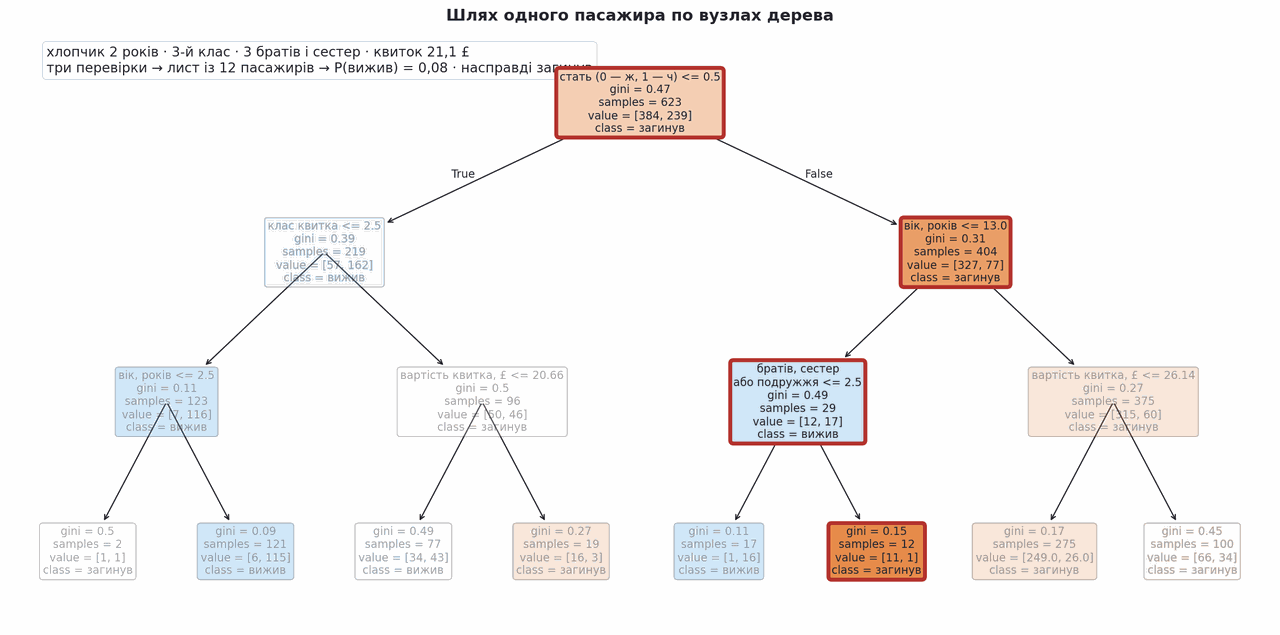
Прогноз для конкретного об'єкта — це шлях від кореня до листка. Візьмімо хлопчика двох років, який плив третім класом із трьома братами й сестрами, квиток коштував 21,1 £.
Вивід код запущено, вивід не редагувався
text
вузол 0: sex = 1  > 0.5
вузол 8: age = 2  <= 13.0
вузол 9: sibsp = 3  > 2.5
лист 11 → P(вижив) = 0.083
На що дивитися: кожен рядок — одне правило вузла; хлопчик потрапив у «дитячу» гілку, але через трьох братів і сестер опинився в листку з імовірністю виживання лише 0,083.
У цьому листку 12 пасажирів, вижив один. Пасажир справді загинув.
Пошук найкращого розбиття: домішка й приріст інформації
Дерево шукає питання, після якого в кожній гілці лишаються схожі пасажири: в ідеалі ліворуч лише ті, хто вижив, праворуч — лише ті, хто загинув. Щоб порівнювати питання, потрібне число, яке показує, наскільки змішані класи у вузлі, — домішка вузла (impurity): нуль у чистому вузлі, найбільша — у суміші 50 на 50.
Індекс Джині має простий сенс. Витягніть із вузла випадкового пасажира й вгадайте його долю навмання, у тих самих пропорціях, що у вузлі; Джині — імовірність помилитися:
де
Ентропія міряє те саме в бітах: скільки в середньому питань «так чи ні» треба поставити, щоб дізнатися клас випадкового пасажира:
Три вузли для прикладу:
- А: 10 пасажирів, вижили 5:
, біт; - Б: 4 пасажирки, вижили всі:
, ; - В: 6 пасажирів, вижив один:
, біта.
Розбиття оцінюють зваженою домішкою гілок — кожну множать на її частку пасажирів, — а її падіння відносно батьківського вузла називають приростом інформації (information gain):
Тут
Ваги не дають крихітній чистій гілці перетягнути рішення. Правило, що відрізає одного пасажира, який вижив, від дев'ятьох, серед яких вижили четверо (їхній Джині
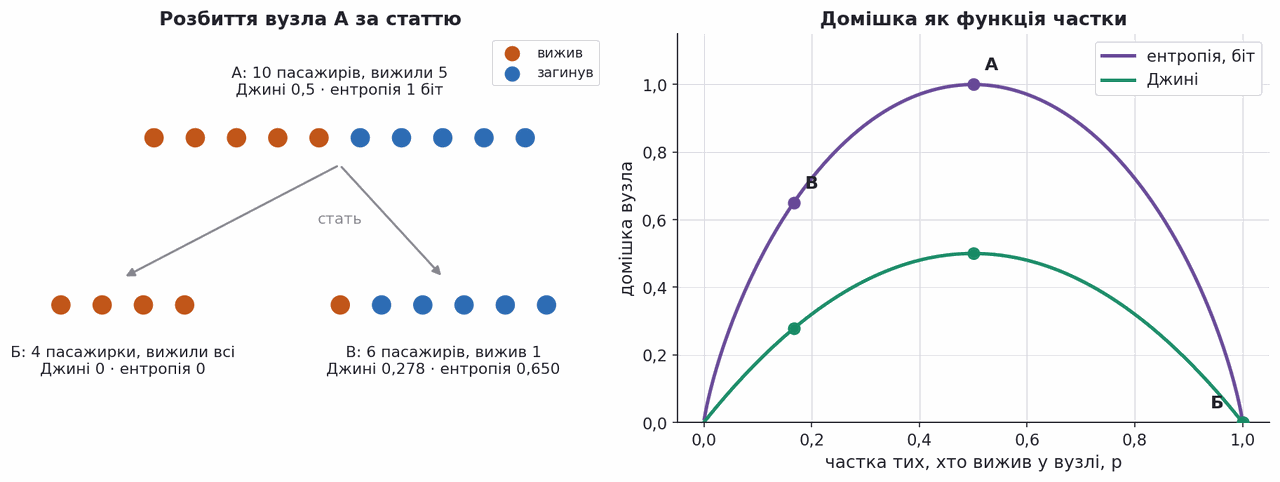
Ліворуч — вузол А і його розбиття на Б і В (помаранчеві — вижили, сині — загинули) з домішкою кожного вузла. Праворуч — Джині й ентропія як функції частки тих, хто вижив; точки — ті самі три вузли.
Обидві міри дають майже однакові розбиття; scikit-learn за замовчуванням бере дешевший Джині — без логарифма. Означення — за ESL, розділ 9.2 (алгоритм CART).
Десять пасажирів: перше розбиття вручну
Щоб пройти навчання дерева від першого кроку до останнього, візьмімо десять випадкових пасажирів навчальної частини і чотири ознаки: стать, клас квитка, вік і вартість квитка. Ті самі десять пасажирів далі навчать беггінг, випадковий ліс і AdaBoost — так ці алгоритми можна простежити на одних числах.
У корені вижили 5 із 10 — це вузол А з попереднього розділу. Стать ділить його саме на вузли Б і В: 4 жінки, усі вижили, і 6 чоловіків, з яких вижив один (Джині 0,278), — зважений Джині 0,167. Код перебирає так само всі чотири ознаки і для кожної друкує найкраще правило; перемагає найменша зважена домішка.
Вивід код запущено, вивід не редагувався
text
 1: чол, клас 3, 30 р.,  16.10 £ → загинув
 2: жін, клас 3, 16 р.,   7.73 £ → вижила
 3: чол, клас 3, 32 р.,   7.90 £ → загинув
 4: чол, клас 3, 26 р.,  56.50 £ → вижив
 5: чол, клас 3, 24.5 р.,   8.05 £ → загинув
 6: жін, клас 1, 36 р., 120.00 £ → вижила
 7: чол, клас 1, 45 р.,  35.50 £ → загинув
 8: жін, клас 2, 24 р.,  14.50 £ → вижила
 9: чол, клас 3, 17 р.,   7.12 £ → загинув
10: жін, клас 1, 30 р.,  86.50 £ → вижила
корінь: Джині 0.500
  sex    <=   0.50: зважена Джині 0.167
  pclass <=   2.50: зважена Джині 0.417
  age    <=  16.50: зважена Джині 0.444
  fare   <=  46.00: зважена Джині 0.286
На що дивитися: стать дає найменшу зважену домішку, 0,167; друге місце в розбиття «вартість квитка ≤ 46 £», 0,286, а клас і вік розплутують дані значно гірше.
Віджет нижче робить той самий перебір на всіх 623 пасажирах навчальної частини, але з ентропією. На десяти пасажирах стать дає приріст 0,610 біта, на 623 — 0,214 біта, і вона знову найкраща — тому й стоїть у корені дерева глибини 3.
Перебір правил у корені
Усі 623 пасажирів навчальної частини: вижили 239, тож ентропія кореня дорівнює 0,961 біта. Оберіть ознаку й поріг — приріст інформації рахується тут-таки.
умова виконується
219 пасажирів · вижили 74 % ентропія 0,827
умова не виконується
404 пасажирів · вижили 19 % ентропія 0,703
0,961ентропія до розбиття
0,746зважена ентропія після
0,214приріст інформації
0,214найкраще з усіх ознак: стать
Чотири кнопки зверху — найкращі правила для чотирьох ознак. Далі спробуйте самі: оберіть ознаку, і поріг одразу стане найкращим для неї, а крива покаже, як приріст залежить від порога. Дві речі варто побачити власноруч. Перша: жодна ознака навіть близько не підходить до статі. Найкращий поріг віку — «менше року» — дає всього 0,013, найкращий поріг вартості квитка трохи більше; стать дає 0,214. Саме тому вона й стоїть у корені дерева, і тепер це не твердження зі слайда, а результат перебору на ваших очах. Друга: подивіться, де крива притискається до нуля. Це краї, де в одній гілці лишається кілька десятків людей: хоч би якою чистою вона була, її внесок зважується на розмір групи. Корисне розбиття має бути водночас чистим і достатньо великим — саме цей компроміс і зашитий у формулу приросту.
Пороги для числових ознак: середини між сусідніми значеннями
Для статі питання одне — «жінка чи чоловік». Вартість квитка — число, і поріг у правилі «квиток ≤ t» можна поставити будь-де. Перебирати нескінченно багато
- Відсортувати різні значення ознаки:
. - Кандидати в пороги — середини між сусідами,
; їх . - Для кожного
порахувати зважену домішку й узяти найменшу.
У десяти пасажирів десять різних цін квитка, тож порогів дев'ять. Для віку їх лише вісім: двоє пасажирів мають однаковий вік, і між ними поріг не поставиш.
Вивід код запущено, вивід не редагувався
text
квиток, £: [  7.12   7.73   7.9    8.05  14.5   16.1   35.5   56.5   86.5  120.  ]
вижив:     [0 1 0 0 1 0 0 1 1 1]
  поріг   7.43: ліворуч 1 (вижили 0), праворуч 9 (вижили 5) → Джині 0.444
  поріг   7.81: ліворуч 2 (вижили 1), праворуч 8 (вижили 4) → Джині 0.500
  поріг   7.97: ліворуч 3 (вижили 1), праворуч 7 (вижили 4) → Джині 0.476
  поріг  11.28: ліворуч 4 (вижили 1), праворуч 6 (вижили 4) → Джині 0.417
  поріг  15.30: ліворуч 5 (вижили 2), праворуч 5 (вижили 3) → Джині 0.480
  поріг  25.80: ліворуч 6 (вижили 2), праворуч 4 (вижили 3) → Джині 0.417
  поріг  46.00: ліворуч 7 (вижили 2), праворуч 3 (вижили 3) → Джині 0.286
  поріг  71.50: ліворуч 8 (вижили 3), праворуч 2 (вижили 2) → Джині 0.375
  поріг 103.25: ліворуч 9 (вижили 4), праворуч 1 (вижили 1) → Джині 0.444
scikit-learn на одній ознаці: поріг 46.00
На що дивитися: найменший зважений Джині, 0,286, дає поріг 46,00 — посередині між 35,50 і 56,50 £: ліворуч семеро, з них вижили двоє, праворуч троє, вижили всі; scikit-learn обрав той самий поріг.
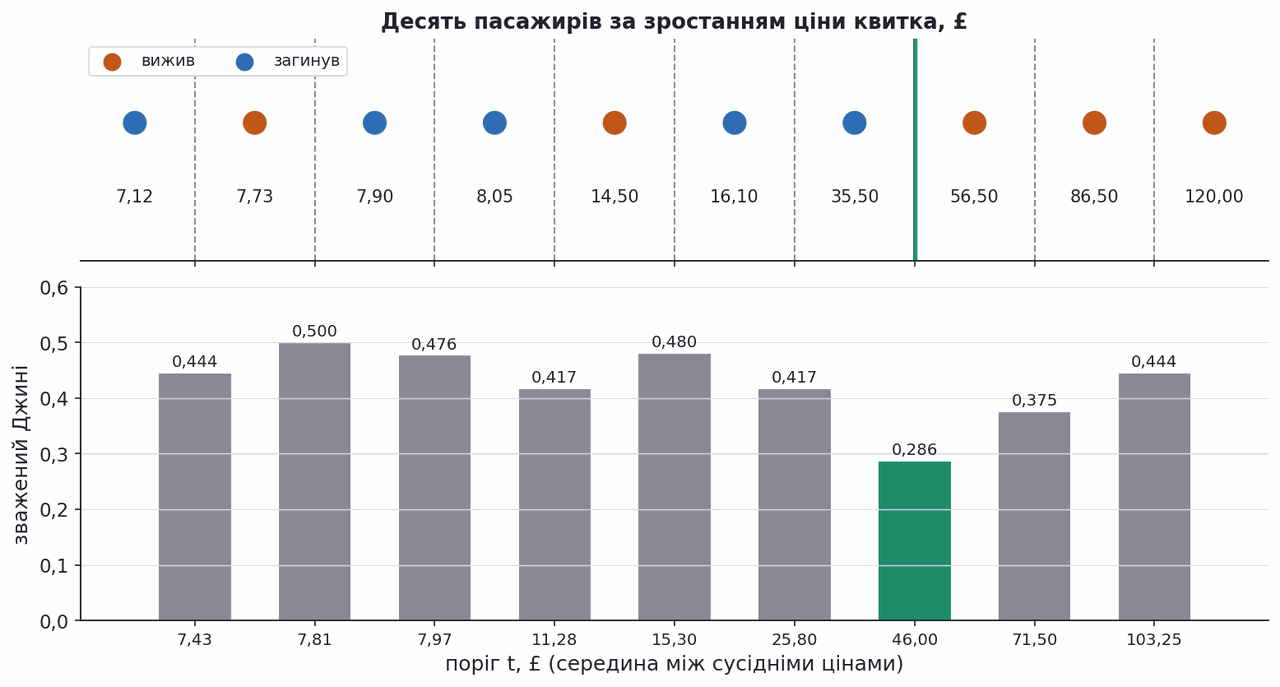
Угорі — десять пасажирів за зростанням ціни квитка (помаранчеві — вижили, сині — загинули) і дев'ять порогів між ними; зеленим — найкращий, 46,00 £. Унизу — зважений Джині для кожного порога.
Середина — домовленість: поріг однаково віддалений від обох сусідів, тож нові пасажири з цінами між ними розподіляються симетрично. Перебір дешевий: ознаку сортують один раз, а коли поріг зсувається на одну позицію, через нього переходить один пасажир, і лічильники класів у гілках оновлюються одним додаванням. На мільйонах рядків і цього забагато — тоді пороги шукають між кошиками гістограми, як у LightGBM.
Дерево росте рекурсивно, доки вузли не стануть чистими
Після першого розбиття алгоритм повторює те саме окремо в кожній частині. Функція, що будує вузол, викликає сама себе для двох нащадків — це рекурсія (recursion). Зупиняється вона, коли вузол чистий (усі пасажири одного класу), коли досягнуто межі глибини або коли розбивати вже нічого.
Покроково на наших десяти пасажирах:
- Корінь: 10 пасажирів, Джині 0,5. Найкраще правило — стать: жінки ліворуч, чоловіки праворуч.
- Ліва гілка: 4 жінки, усі вижили, Джині 0. Це листок із прогнозом «вижила».
- Права гілка: 6 чоловіків, Джині 0,278. Перебір лише серед них знаходить «вартість квитка ≤ 46 £»: п'ятеро з дешевшими квитками загинули, єдиний чоловік із квитком за 56,50 £ вижив.
- Обидві нові гілки чисті, і рекурсія зупиняється. Дерево готове: дві перевірки й три листки.
Вивід код запущено, вивід не редагувався
text
вузол: 10 пас., Джині 0.500 → sex <= 0.50
    листок: 4 пас., вижили 4
    вузол: 6 пас., Джині 0.278 → fare <= 46.00
        листок: 5 пас., вижили 0
        листок: 1 пас., вижили 1
|--- sex <= 0.50
|   |--- class: 1
|--- sex >  0.50
|   |--- fare <= 46.00
|   |   |--- class: 0
|   |--- fare >  46.00
|   |   |--- class: 1
На що дивитися: наша рекурсія і DecisionTreeClassifier будують те саме дерево — стать у корені і вартість квитка 46 £ серед чоловіків; у листках scikit-learn пише клас: 1 — вижив, 0 — загинув.
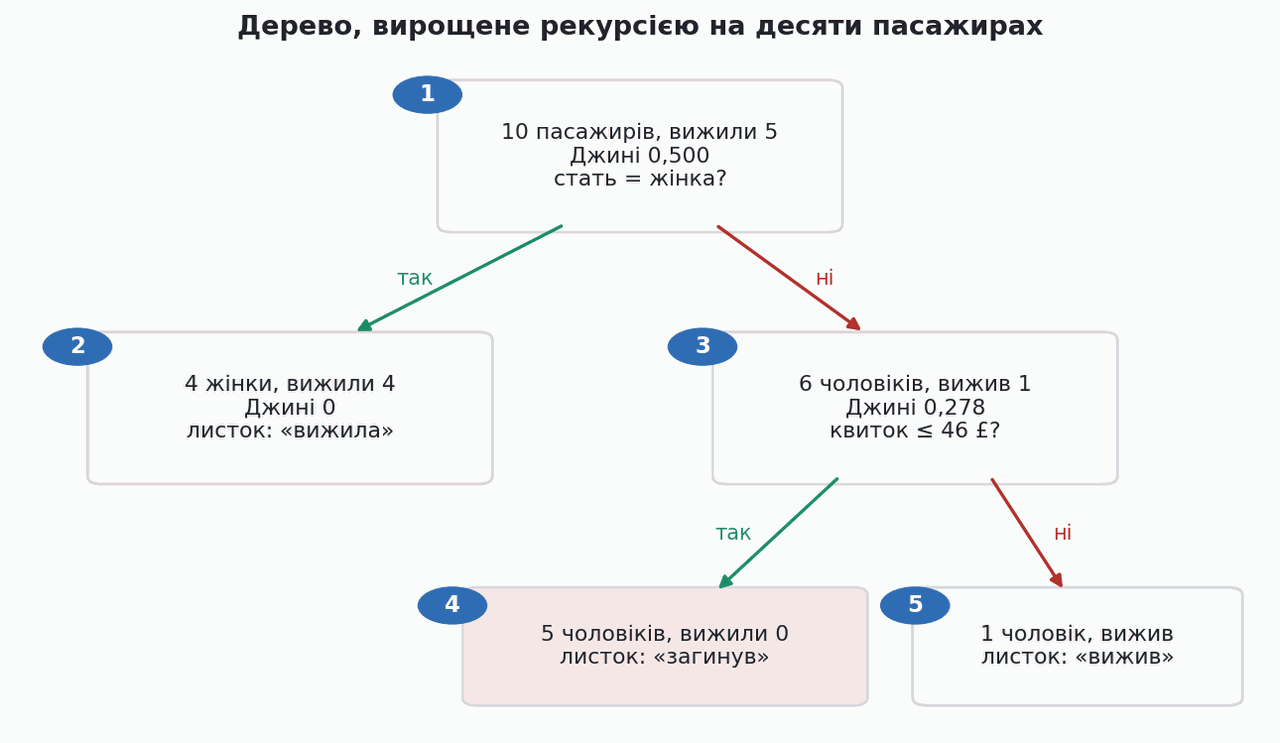
Дерево, вирощене на десяти пасажирах: у кожному вузлі — скільки пасажирів до нього дійшло, скільки вижили, домішка Джині і правило; цифри в кружках — порядок, у якому рекурсія відвідує вузли.
Прогноз для нового пасажира — шлях від кореня до листка, як у розділі «Шлях одного пасажира по вузлах дерева», а в листку — частка тих, хто вижив.
Дерево розрізає простір на прямокутники
Кожна перевірка виду «ознака
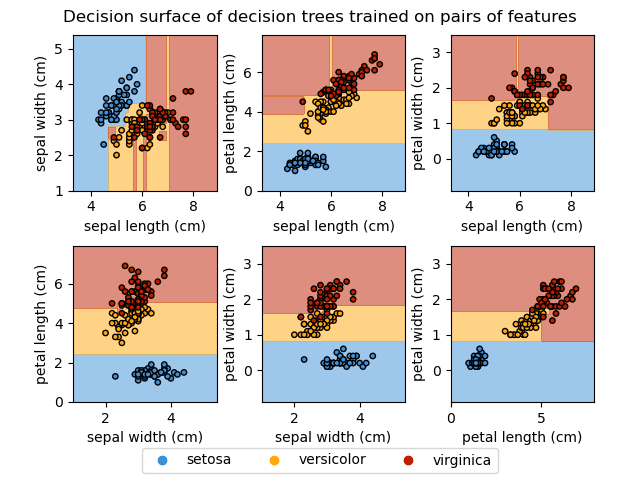
Джерело: scikit-learn · Decision surface of decision trees on iris
Звідси випливають дві протилежні властивості. З одного боку, дереву байдуже до масштабу ознак: поріг однаково добре знаходиться і в міліграмах, і в кілограмах, тому стандартизація йому не потрібна. З іншого боку, похилу межу дерево змушене апроксимувати сходинками, і на просто повернутих даних воно програє лінійній моделі.
Дерево в задачі регресії: поріг за сумою квадратів
Той самий алгоритм працює і з числовою ціллю: у листку зберігається середнє значення, а мірою безладу стає сума квадратів відхилень. Візьмімо вісім випадкових районів із California Housing (лекції 02–04): ознака — медіанний дохід району в десятках тисяч доларів, ціль — медіанна вартість будинку в сотнях тисяч доларів. Пеньок перебирає сім порогів посередині між сусідніми значеннями доходу і для кожного рахує суму квадратів відхилень (sum of squared errors) від середнього в кожній частині:
Тут
Вивід код запущено, вивід не редагувався
text
дохід:    [1.78 2.76 3.01 3.25 4.09 6.77 6.87 8.61]
вартість: [0.63 1.95 1.3  1.77 2.25 3.11 2.9  3.07]
  поріг 2.270: SSE  3.006
  поріг 2.885: SSE  3.704
  поріг 3.130: SSE  2.252
  поріг 3.670: SSE  1.519
  поріг 5.430: SSE  1.628
  поріг 6.820: SSE  3.568
  поріг 7.740: SSE  4.526
найкращий поріг 3.670: листки 1.4125 і 2.8325
scikit-learn: 3.67 [1.4125 2.8325]
На що дивитися: найменша сума квадратів, 1,519, — у порога 3,67; пеньок scikit-learn обрав той самий поріг і ті самі значення листків.
Найкращий поріг 3,67 ділить райони навпіл. Чотири бідніші отримують прогноз — середнє своєї вартості,
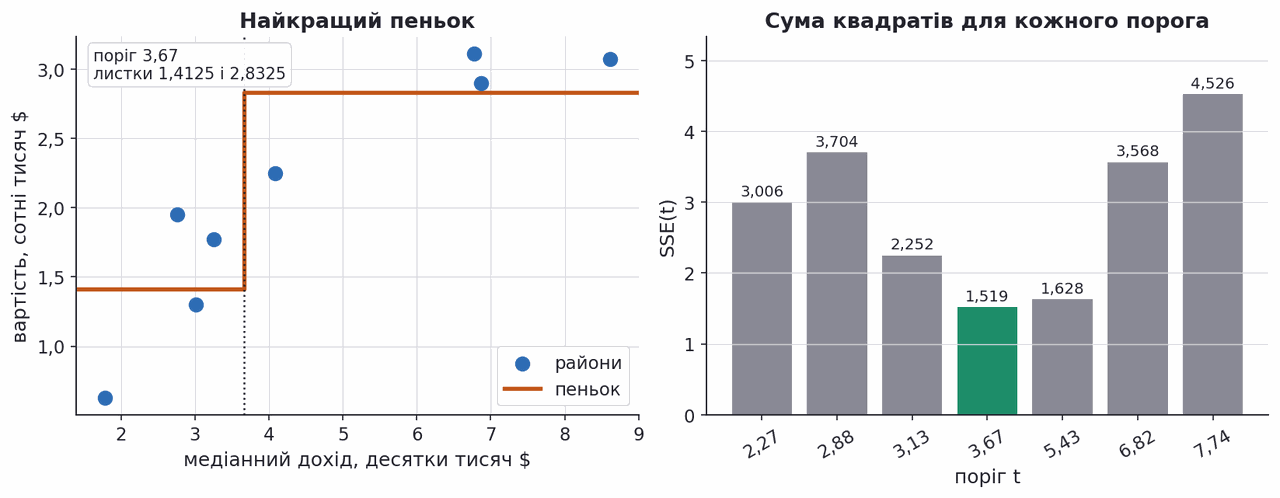
Ліворуч — вісім районів і пеньок із найкращим порогом: дві сходинки на рівні середніх. Праворуч — SSE для кожного з семи порогів; зеленим — найменша.
Глибоке дерево запам'ятовує вибірку, обрізання це виправляє
Без обмежень дерево росте, доки кожен листок не стане чистим. На «Титаніку» це 143 листки й окремі правила для окремих пасажирів. Точність на тренувальній вибірці зростає до 0,986 — дерево вивчило майже кожного пасажира напам'ять, — а на відкладеній досягає максимуму 0,836 при глибині 5 і далі падає до 0,780.
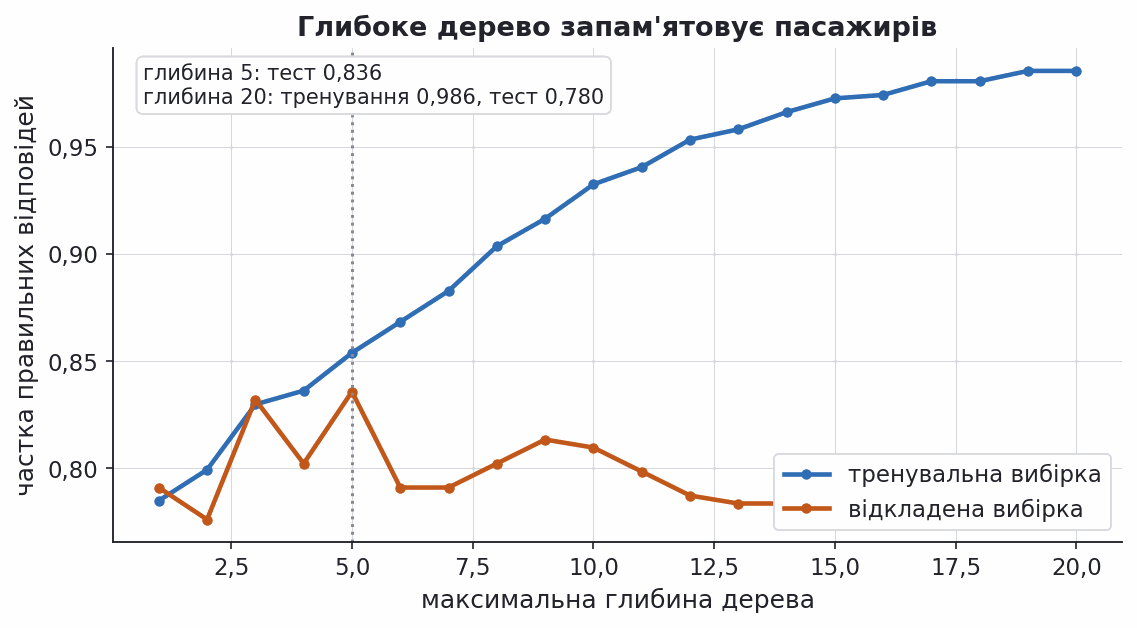
Обмежити глибину наперед — грубо: зупинившись зарано, дерево не побачить корисного розбиття, яке відкрилося б рівнем нижче. Акуратніше виростити дерево повністю, а потім обрізати зайве. Обрізання за складністю (cost-complexity pruning) шукає піддерево
Тут
Вивід код запущено, вивід не редагувався
text
alpha = 0.0038
листків: 143 → 13
точність на тесті: 0.780 → 0.843
На що дивитися: з α = 0,0038 дерево скорочується зі 143 листків до 13, а точність на тесті при цьому зростає з 0,780 до 0,843.
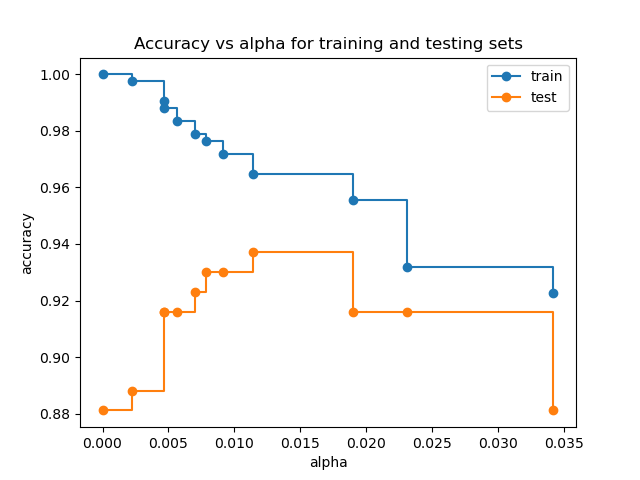
Джерело: scikit-learn · Post pruning decision trees with cost complexity pruning
Одне дерево нестабільне
У дерева є вада, яку не лікує ні обмеження глибини, ні обрізання: висока дисперсія. Оскільки розбиття обирається жадібно, зміна кількох зразків біля порога змінює правило в корені, а разом із ним і все дерево нижче.
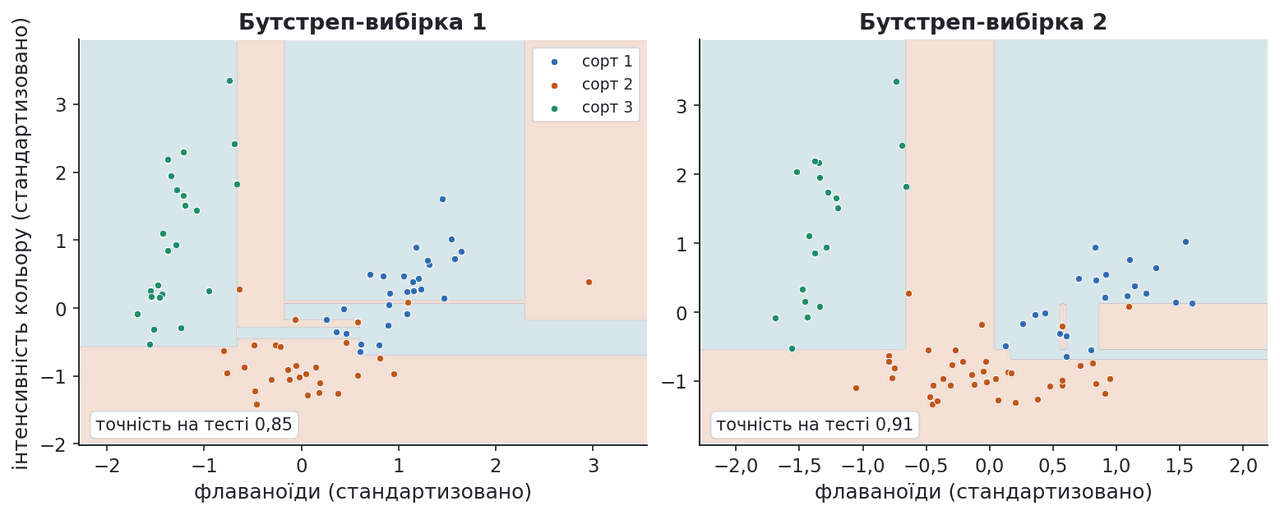
На рисунку два дерева навчено на двох випадкових вибірках з тих самих даних Wine. Алгоритм один, дані відрізняються лише перетасовкою з поверненням, а межі рішення вийшли помітно різними: точність 0,85 проти 0,91.
Нестабільність — погана новина для інтерпретації: правило, яке ми щойно читали вголос, могло б виглядати інакше на трохи інших даних. Але вона ж відкриває дорогу до головної ідеї другої половини лекції. Якщо модель сильно залежить від випадковості вибірки, її помилки теж випадкові — а випадкові помилки можна усереднити.
Беггінг знижує дисперсію, не чіпаючи зміщення
Нехай є
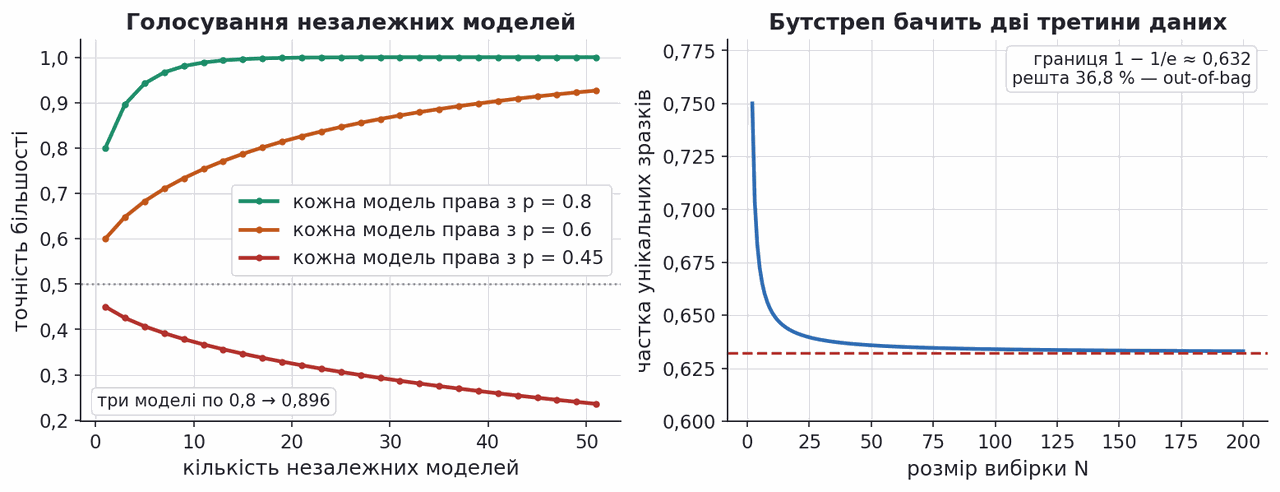
Ліворуч — точність голосу більшості залежно від кількості незалежних моделей: якщо кожна краща за вгадування, вона зростає, якщо гірша (червона крива) — падає. Праворуч — частка унікальних зразків у бутстреп-вибірці, що прямує до 0,632.
Ключове слово — незалежні: однакові моделі усереднення не покращує. Тому кожна модель вчиться на своїй бутстреп-вибірці (bootstrap sample) —
Для
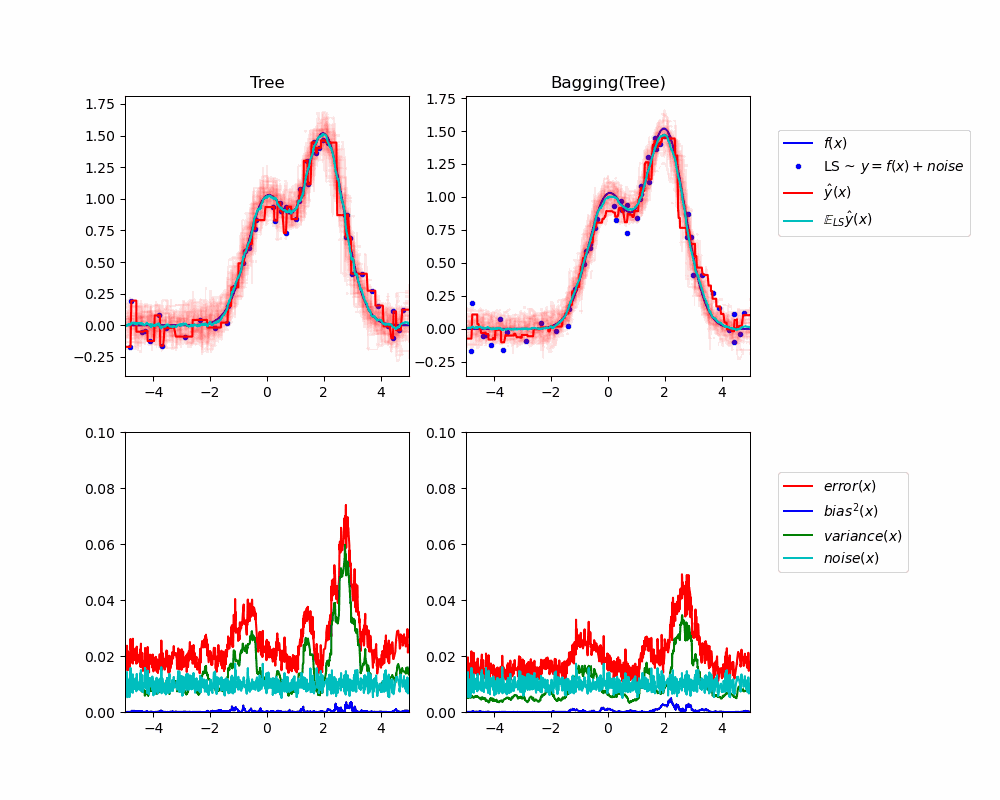
Тому в беггінг беруть глибокі дерева: у них мале зміщення й велика дисперсія, і саме дисперсію усереднення вміє прибирати.
Беггінг покроково: п'ять бутстреп-вибірок
Пройдімо беггінг руками на тих самих десяти пасажирах. Алгоритм:
- Для кожного з
дерев витягнути номерів із поверненням — бутстреп-вибірку. Хтось потрапить у неї двічі чи тричі, хтось жодного разу; ті, кого немає, — поза мішком (out-of-bag) для цього дерева. - Навчити дерево на цій вибірці — тут пеньок, найкраще розбиття за перебором із розділу «Десять пасажирів: перше розбиття вручну».
- Для нового об'єкта усереднити ймовірності всіх дерев або порахувати голоси.
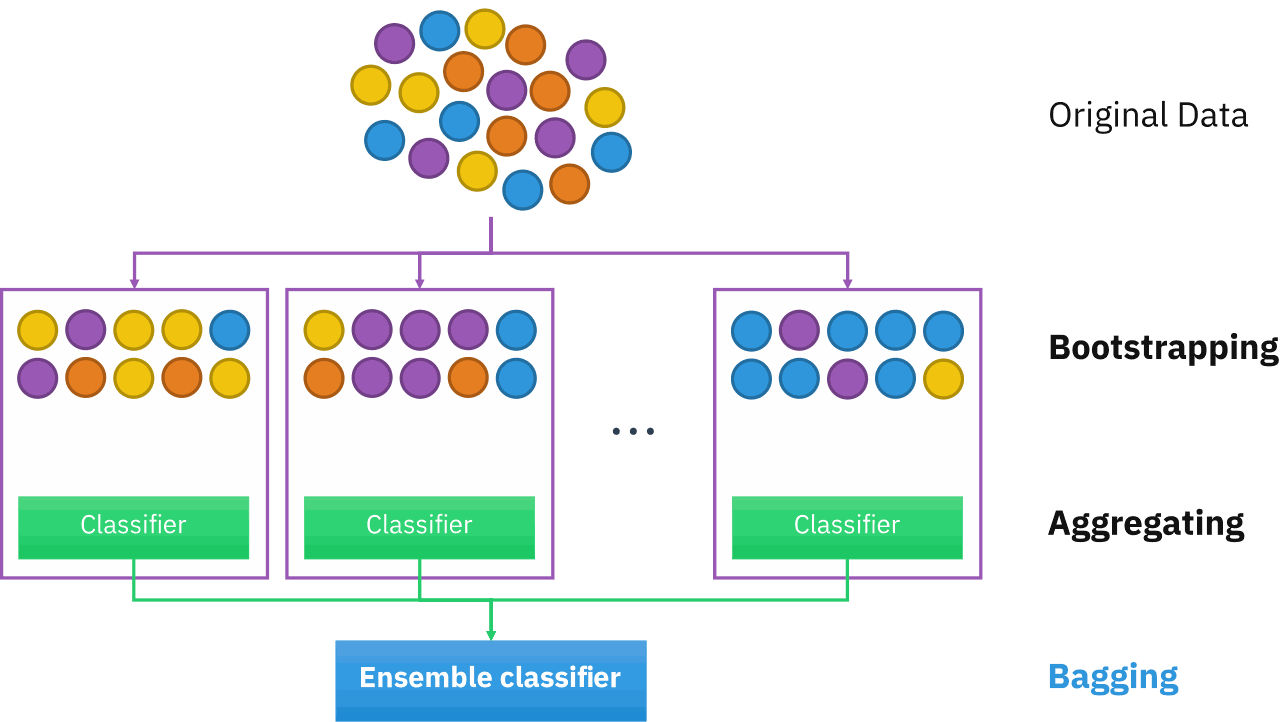
Англійські підписи: Original Data — вихідні дані, Bootstrapping — бутстреп-вибірки, Classifier — модель, навчена на одній вибірці, Aggregating — об'єднання прогнозів, Ensemble classifier — ансамбль, Bagging — беггінг. На схемі вибірки менші за вихідні дані; в алгоритмі розмір кожної — N.
Джерело: Sirakorn · Ensemble Bagging, Wikimedia Commons, ліцензія CC BY-SA 4.0
Вивід код запущено, вивід не редагувався
text
дерево 1: [1, 5, 6, 7, 8, 9, 10, 10, 10, 10], поза мішком [2, 3, 4]
    sex <= 0.50: вижили ліворуч 1.000, праворуч 0.000
дерево 2: [2, 3, 3, 4, 6, 6, 7, 7, 9, 9], поза мішком [1, 5, 8, 10]
    sex <= 0.50: вижили ліворуч 1.000, праворуч 0.143
дерево 3: [1, 2, 4, 5, 5, 8, 9, 10, 10, 10], поза мішком [3, 6, 7]
    sex <= 0.50: вижили ліворуч 1.000, праворуч 0.200
дерево 4: [2, 4, 5, 6, 6, 7, 8, 10, 10, 10], поза мішком [1, 3, 9]
    sex <= 0.50: вижили ліворуч 1.000, праворуч 0.333
дерево 5: [1, 2, 3, 4, 5, 5, 6, 7, 8, 10], поза мішком [9]
    sex <= 0.50: вижили ліворуч 1.000, праворуч 0.167
пасажир 3: дерева [1, 3, 4] → середнє 0.178
оцінка поза мішком: 9 правильних із 10
На що дивитися: у вибірці 1 пасажир 10 трапився чотири рази, а пасажири 2, 3 і 4 не потрапили жодного разу; усі п'ять пеньків обрали стать, змінилася лише частка вцілілих чоловіків — від 0 до 0,333.
Бутстреп змінив числа в листках, але не саме правило: п'ять пеньків — майже копії, і усереднювати копії мало сенсу. Саме цю ваду лікує випадковий ліс у наступному розділі.
Оцінка поза мішком перевіряє ансамбль без окремої вибірки. Пасажира 3 не бачили дерева 1, 3 і 4; їхні ймовірності для чоловіка — 0, 0,2 і 0,333, середнє 0,178, тож прогноз «загинув», і це правда. Так по кожному з десяти пасажирів: 9 правильних, помилка лише щодо пасажира 4 — чоловіка, який вижив.
Випадковий ліс: алгоритм навчання і прогнозу
Беггінг упирається в те, що ми щойно бачили: найсильніша ознака стоїть у корені майже кожного дерева, і дерева схожі одне на одне. Випадковий ліс (random forest) додає другий механізм випадковості — у самі розбиття.
Навчання. Для кожного з
- Витягнути бутстреп-вибірку з
прикладів із поверненням. - Вирощувати дерево рекурсивно, але в кожному вузлі спершу випадково обрати
із ознак і шукати найкраще розбиття лише серед них. У scikit-learn для класифікації (параметр max_features="sqrt"), для регресії за замовчуванням — усіознак. - Рости до чистих листків, без обрізання: зміщення окремого дерева мале, а дисперсію прибере усереднення.
Прогноз. Кожне дерево проводить об'єкт від кореня до листка і дає частку класу в цьому листку. scikit-learn усереднює ці частки й обирає клас із найбільшою середньою; в оригінальному алгоритмі кожне дерево голосувало класом, і перемагала більшість.
На «Титаніку»
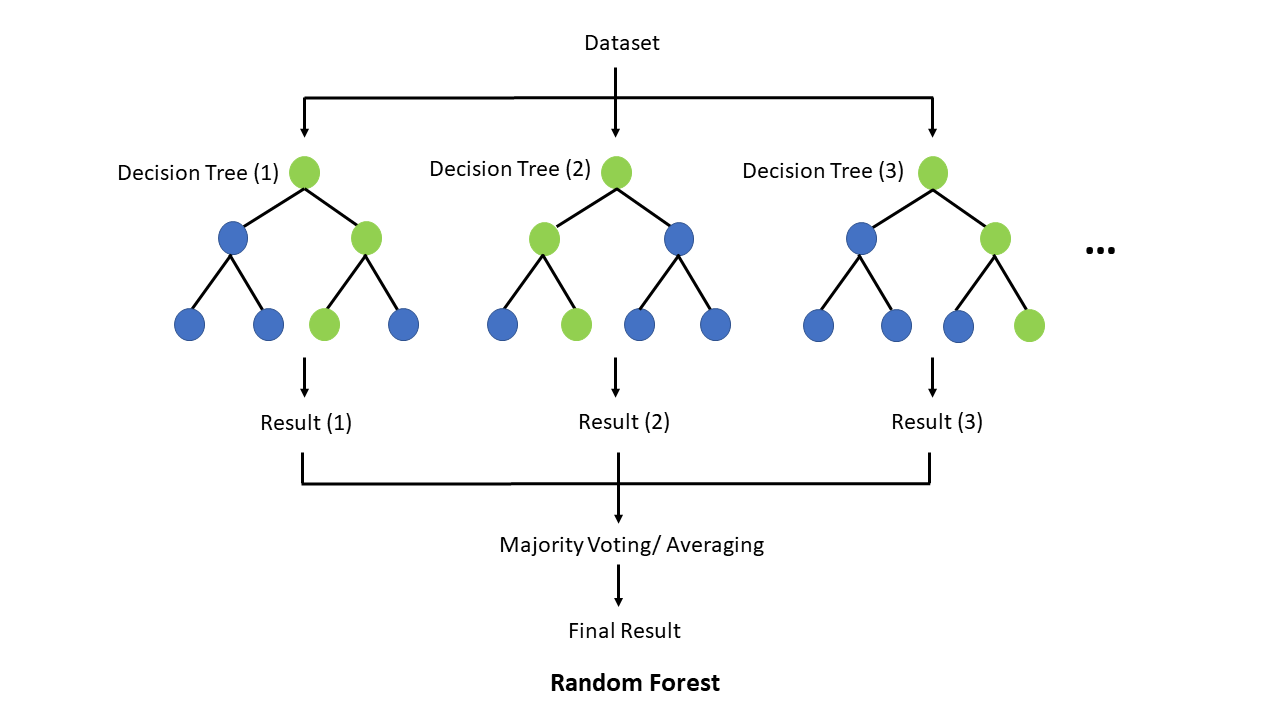
Англійські підписи: Dataset — дані, Decision Tree (1)–(3) — дерева лісу, Result — прогноз одного дерева, Majority Voting / Averaging — голосування більшості або усереднення, Final Result — прогноз лісу. Зелені вузли — шлях об'єкта від кореня до листка; бутстреп на схемі не показано.
Джерело: TseKiChun · Random forest explain, Wikimedia Commons, ліцензія CC BY-SA 4.0 · метод: Breiman L. Random Forests, 2001
Крок 2 — головна відмінність від беггінгу: нова пара ознак тягнеться в кожному вузлі, а не раз на дерево. Виростимо одне дерево лісу глибини 3 на тих самих десяти пасажирах, дозволивши кожному вузлу дві випадкові ознаки з чотирьох:
Вивід код запущено, вивід не редагувався
text
вузол: випали pclass і age → pclass <= 2.50
    вузол: випали sex і age → sex <= 0.50
        листок: 3 пас., вижили 3
        листок: 1 пас., вижили 0
    вузол: випали fare і sex → fare <= 36.30
        вузол: випали pclass і age → age <= 16.50
            листок: 1 пас., вижили 1
            листок: 4 пас., вижили 0
        листок: 1 пас., вижили 1
На що дивитися: корінь отримав клас і вік і розбив за класом; лівий вузол — стать і вік, правий — квиток і стать, і він обрав квиток, хоча стать була поруч; кожен вузол обирає лише з власної пари.
Випадковий ліс покроково: ті самі вибірки, випадкові ознаки
Візьмімо ті самі п'ять бутстреп-вибірок, що в беггінгу, і змінимо одне: кожен пеньок шукає розбиття лише серед двох із чотирьох ознак, випадково витягнутих саме для нього, —
Вивід код запущено, вивід не редагувався
text
дерево 1: випали pclass і fare   → fare <= 61.00: 0.200 / 1.000
дерево 2: випали pclass і fare   → fare <= 46.00: 0.143 / 1.000
дерево 3: випали pclass і age    → pclass <= 2.50: 1.000 / 0.333
дерево 4: випали sex і fare      → sex <= 0.50: 1.000 / 0.333
дерево 5: випали pclass і age    → age <= 24.25: 1.000 / 0.375
нова: стать 0, клас 2, вік 23, квиток 13.79 £;
    насправді вижила
беггінг  дерева [1. 1. 1. 1. 1.] → середнє 1.000, «так» 5 з 5
ліс      дерева [0.2   0.143 1.    1.    1.   ] → середнє 0.669, «так» 3 з 5
На що дивитися: пеньки тепер різні — двічі за вартістю квитка, по разу за класом і віком, і лише дерево 4, якому випала стать, повторює беггінг; для нової пасажирки ліс дає 0,669 і три голоси з п'яти «так».
Прогноз для нової пасажирки з тестової частини, обраної як приклад, — жінки 23 років із квитком другого класу за 13,79 £; вона вижила. Кожен пеньок проводить її до свого листка. Дерева 1 і 2 бачать лише дешевий квиток і дають 0,2 і 0,143; дерева 3, 4 і 5 — по 1,0. Ліс усереднює:
Прогноз — «вижила»; голосування класами дає той самий результат, три голоси з п'яти. Беггінг дає 1,0: усі п'ять його пеньків розбивають за статтю, і жінка щоразу потрапляє в листок, де вижили всі.
На десяти пасажирах ліс не виграє: кожен його пеньок свідомо слабший, бо інколи не бачить найсильнішої ознаки. Виграш з'являється, коли дерев сотні, вони глибокі, а ознак багато, — це вимірюємо двома розділами нижче. Віджет показує кожне дерево окремо, зокрема для будь-кого з десяти пасажирів.
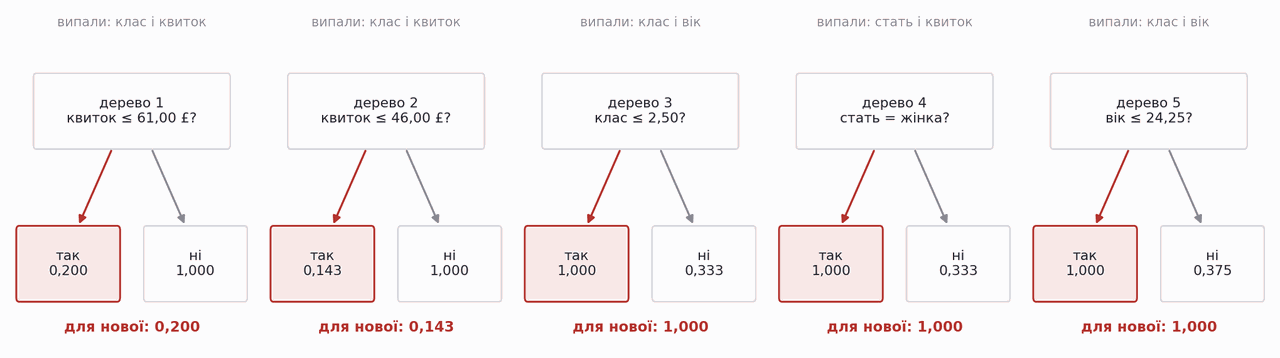
П'ять пеньків випадкового лісу: над кожним — ознаки, які йому випали, у листках — частка тих, хто вижив, у його бутстреп-вибірці; червоним — куди потрапляє нова пасажирка і яку ймовірність дає кожне дерево.
Беггінг і ліс на десяти пасажирах
П'ять пеньків на тих самих бутстреп-вибірках. У беггінгу кожен пеньок бачить усі чотири ознаки, у випадковому лісі — лише дві, випадково витягнуті для нього.
пасажир:
Нова пасажирка з тестової частини: жінка, клас 2, 23 р., квиток 13,79 £; насправді вижила.
Дерево 1
12345678910×4
випали: клас і квиток
квиток ≤ 61,00 £?
так
0,200
0,200
ні
1,000
1,000
Дерево 2
123×2456×27×289×210
випали: клас і квиток
квиток ≤ 46,00 £?
так
0,143
0,143
ні
1,000
1,000
Дерево 3
12345×2678910×3
випали: клас і вік
клас ≤ 2,50?
так
1,000
1,000
ні
0,333
0,333
Дерево 4
123456×278910×3
випали: стать і квиток
стать = жінка?
так
1,000
1,000
ні
0,333
0,333
Дерево 5
12345×2678910
випали: клас і вік
вік ≤ 24,25?
так
1,000
1,000
ні
0,375
0,375
0,669середня ймовірність вижити
3 з 5дерев дають «вижив» (імовірність ≥ 0,5)
вижилапрогноз ансамблю
У беггінгу всі п'ять пеньків обирають стать — бутстреп змінює лише числа в листках. Перемкніть на випадковий ліс: дерева 1 і 2 без статі розбивають за вартістю квитка, дерево 3 — за класом, дерево 5 — за віком, і для нової пасажирки середнє падає з 1,000 до 0,669. Номери в рядку — бутстреп-вибірка дерева: «×3» означає, що пасажира витягнуто тричі, сірі номери — поза мішком. Оберіть пасажира 3: його не бачили дерева 1, 3 і 4, і в беггінгу саме вони дають оцінку поза мішком 0,178.
Кореляція помилок вирішує, чи виграє ліс у беггінгу
Похибка дерева на пасажирі
де
Спершу на пеньках із розділів «Беггінг покроково: п'ять бутстреп-вибірок» і «Випадковий ліс покроково: ті самі вибірки, випадкові ознаки».
Вивід код запущено, вивід не редагувався
text
беггінг
  дерево 1: +0.00 +0.00 +0.00 -1.00 +0.00 +0.00 +0.00 +0.00 +0.00 +0.00
  дерево 2: +0.14 +0.00 +0.14 -0.86 +0.14 +0.00 +0.14 +0.00 +0.14 +0.00
  ρ(1, 2) = 0.972, середня ρ по 10 парах = 0.961
ліс
  дерево 1: +0.20 -0.80 +0.20 -0.80 +0.20 +0.00 +0.20 -0.80 +0.20 +0.00
  дерево 2: +0.14 -0.86 +0.14 +0.00 +0.14 +0.00 +0.14 -0.86 +0.14 +0.00
  ρ(1, 2) = 0.817, середня ρ по 10 парах = 0.607
На що дивитися: пеньки беггінгу розбивають за статтю й помиляються однаково — обидва найсильніше на пасажирі 4, тож ρ(1, 2) = 0,972, а середня ρ — 0,961; пеньки лісу дивляться на різні ознаки, і середня ρ падає до 0,607.
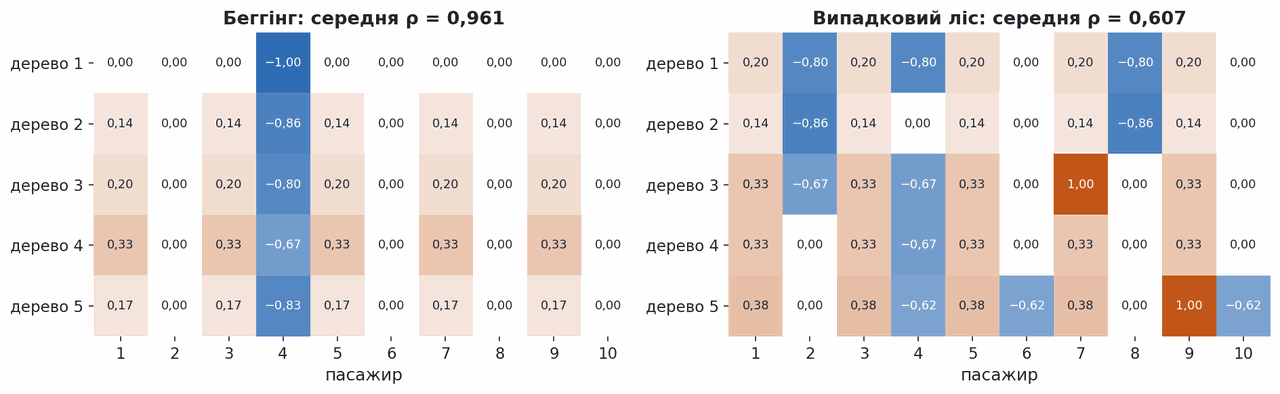
Похибки
На справжніх даних механізм той самий: випадкові ознаки збивають
Гіперпараметри випадкового лісу
У scikit-learn ліс — це RandomForestClassifier. Він добре працює зі стандартними налаштуваннями, але кожен його параметр має зрозумілий сенс.
n_estimators— кількість дерев. Зайві дерева точності не шкодять: середнє лише стабілізується. Ціна — час і пам'ять; зазвичай вистачає кількох сотень.max_features— скільки ознак розглядати у вузлі. Менше — дерева різноманітніші, але кожне слабше; більше — сильніші, але схожі. ЗначенняNone(усі ознаки) перетворює ліс на беггінг.max_depth,min_samples_leaf— обмеження росту. За замовчуванням дерева ростуть до чистих листків; на зашумлених даних більший мінімум прикладів у листку, наприклад 5–20, інколи допомагає.bootstrap,max_samples— чи брати бутстреп і якого розміру вибірки.class_weight— ваги класів при дисбалансі, як у лекції 05.
Навчимо ліс зі стандартними параметрами на «Титаніку» — його важливість ознак розберемо в наступному розділі. Якість оцінимо ще й поза мішком: кожного пасажира перевіряють лише ті дерева, у чиїй бутстреп-вибірці його не було.
Вивід код запущено, вивід не редагувався
text
тест 0.828, поза мішком 0.814На що дивитися: оцінка поза мішком, 0,814, близька до тестової точності, 0,828, — ліс оцінює сам себе без окремої вибірки.
Оцінка поза мішком — безкоштовна заміна перевірочної вибірки. На «Титаніку» ліс не побив обрізане дерево (0,843): на маленькій таблиці з шістьма ознаками ансамблю немає де розгорнутися.
Важливість ознак: за зменшенням домішки і перестановкою
Ліс уміє сказати, які ознаки він використовував. Найдешевший спосіб — важливість за зменшенням домішки (mean decrease in impurity, MDI): для кожної ознаки додаємо зменшення домішки Джині в усіх розбиттях, де вона брала участь, зважене на частку зразків у вузлі, усереднюємо по деревах і нормуємо до суми 1. Рахується вона на тренувальних даних і завищує ознаки з багатьма різними значеннями: у неперервного шуму завжди знайдеться поріг, що випадково трохи очистить вузол.
Чесніша важливість перестановкою (permutation importance) питає, наскільки впаде точність на відкладеній вибірці, якщо значення однієї ознаки перемішати між об'єктами:
де
Вивід код запущено, вивід не редагувався
text
точність 0.828; після одного перемішування статі 0.627
ознака    MDI  перестановка
  sex    0.264    0.192
  age    0.251    0.081
  pclass 0.091    0.044
  fare   0.305    0.041
  sibsp  0.050    0.008
  parch  0.039    0.006
На що дивитися: одне перемішування статі опускає точність з 0,828 до 0,627, а в середньому за 30 перемішувань стать коштує 0,192; MDI ж ставить першою вартість квитка, 0,305, хоча її перемішування коштує лише 0,041.
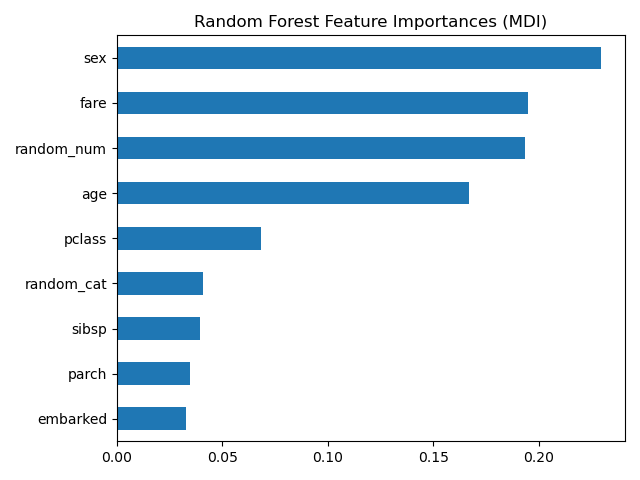
Джерело: scikit-learn · Permutation Importance vs Random Forest Feature Importance
Рисунок із документації на тій самій задачі про «Титанік» показує, чому MDI не можна вірити наосліп: туди навмисне додано випадкове число random_num, і MDI ставить його третім, а перестановка на тесті дає йому нуль. Обидві міри ламаються на корельованих ознаках: перемішування однієї з двох майже однакових модель переживає без втрат, дочитуючи інформацію з двійника. Правило: MDI — для швидкого погляду, рішення — за важливістю перестановкою на даних, яких модель не бачила.
Бустинг: кожне наступне дерево вчиться на залишках
Беггінг будує дерева паралельно й незалежно. Бустинг заходить з іншого боку: дерева навчаються послідовно, і кожне наступне виправляє те, що не вдалося попереднім.
"Each tree is trying to predict residuals of the current prediction." — UBC CPSC 340, лекція 23
У градієнтному бустингу прогноз — це не середнє, а сума дерев:
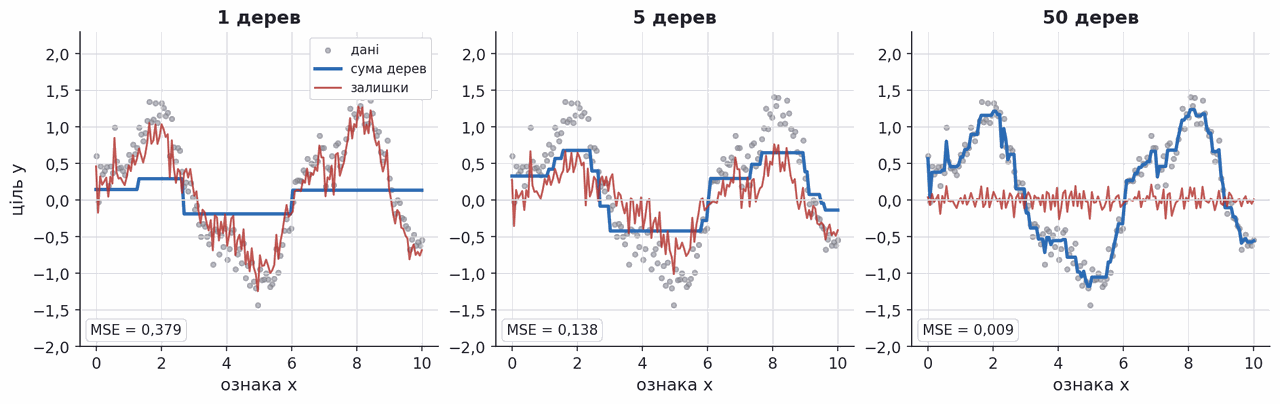
На рисунку — одновимірна регресія, дерева глибини 2, темп навчання 0,3. Після одного дерева синя крива — це дві сходинки, а червоні залишки майже повторюють дані: середньоквадратична похибка 0,379. Після п'яти дерев з'являється форма, похибка 0,138. Після п'ятдесяти сума сходинок відтворює криву, залишки сплющуються в шум, похибка 0,009.
Джерело методу: Friedman J. Greedy Function Approximation, 2001
Градієнтний бустинг покроково: залишки на восьми районах
Повернімося до восьми районів Каліфорнії і побудуймо бустинг із пеньків руками. Алгоритм:
- Крок 0. Почати з константи — середньої вартості всіх районів:
. - Залишки. Для кожного району
— те, чого поточна модель ще не пояснила. - Пеньок на залишках. Навчити регресійний пеньок (розділ «Дерево в задачі регресії: поріг за сумою квадратів») передбачати не
, а . - Оновлення.
, де — новий пеньок, — темп навчання. Повернутися до кроку 2.
Чому «градієнтний»: для квадратичної втрати
Числами, з
Вивід код запущено, вивід не редагувався
text
крок 0: прогноз 2.122 для всіх, MSE 0.6940
        залишки: [-1.492 -0.172 -0.822 -0.352  0.128  0.988  0.778  0.948]
крок 1: поріг 3.670, листки -0.710 / +0.710, MSE 0.3159
крок 2: поріг 2.270, листки -1.137 / +0.163, MSE 0.1773
крок 3: поріг 5.430, листки -0.281 / +0.468, MSE 0.0787
прогноз після 3 кроків: [1.058 1.708 1.708 1.708 2.418 2.793 2.793 2.793]
GradientBoostingRegressor дає те саме: True
На що дивитися: кожен пеньок навчається на нових залишках і ставить новий поріг — 3,67, потім 2,27, потім 5,43; MSE падає 0,694 → 0,316 → 0,177 → 0,079, а GradientBoostingRegressor дає точно ті самі прогнози.
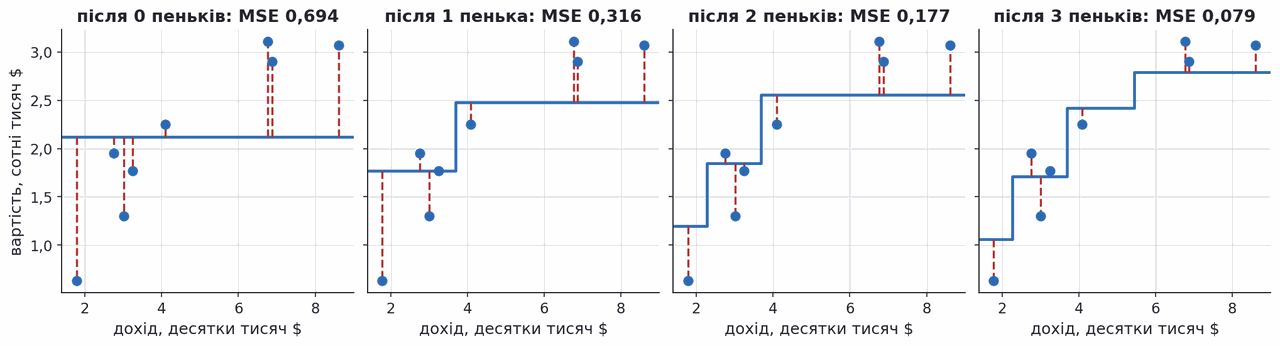
Вісім районів (точки) і прогноз бустингу (синя сходинкова лінія) після 0, 1, 2 і 3 пеньків; червоні відрізки — залишки, які навчатиме наступний пеньок. У заголовках — MSE.
Віджет нижче дозволяє робити кроки самому і змінювати темп навчання
Градієнтний бустинг на восьми районах
Крок: залишки r = y − F → пеньок за найменшою сумою квадратів → F ← F + ν·пеньок. Ознака — медіанний дохід району, ціль — вартість будинку в сотнях тисяч доларів.
темп навчання ν:
0пеньків у сумі
0,6940MSE на восьми районах
—поріг останнього пенька
—листки останнього пенька
| дохід | вартість y | прогноз F | залишок y − F |
|---|---|---|---|
| 1,78 | 0,63 | 2,1225 | −1,4925 |
| 2,76 | 1,95 | 2,1225 | −0,1725 |
| 3,01 | 1,30 | 2,1225 | −0,8225 |
| 3,25 | 1,77 | 2,1225 | −0,3525 |
| 4,09 | 2,25 | 2,1225 | +0,1275 |
| 6,77 | 3,11 | 2,1225 | +0,9875 |
| 6,87 | 2,90 | 2,1225 | +0,7775 |
| 8,61 | 3,07 | 2,1225 | +0,9475 |
Із ν = 0,5 три кроки повторюють розділ: пороги 3,67, 2,27 і 5,43, MSE 0,6940 → 0,3159 → 0,1773 → 0,0787. Червоні відрізки — залишки, на яких навчиться наступний пеньок. З ν = 1 перший крок одразу ставить сходинку на рівень середніх, з ν = 0,1 модель підкрадається до даних повільно. Натисніть «+5 кроків» кілька разів: MSE на цих восьми районах прямує до нуля — бустинг вивчає кожну точку. На нових районах така модель помилялася б більше: це перенавчання, і помітити його можна лише на даних, яких модель не бачила.
AdaBoost покроково: ваги переходять на важкі приклади
AdaBoost — історично перший успішний бустинг: він будує слабкі моделі (weak learners) — пеньки, трохи кращі за вгадування, — один за одним, але не рахує залишків, а перезважує приклади. Мітки кодуємо як
- Ваги. Спочатку всі однакові:
. - Пеньок навчається на зважених даних (у scikit-learn — за зваженою домішкою Джині) і має зважену помилку
. - Голос пенька:
— що менше помилок, то вагоміший голос. - Перезважування:
, потім нормування до суми 1. Помилки важчають у разів, правильні відповіді легшають. - Прогноз — знак зваженої суми
.
Раунд 1: пеньок «стать» помиляється лише на пасажирі 4, чоловіку, що вижив:
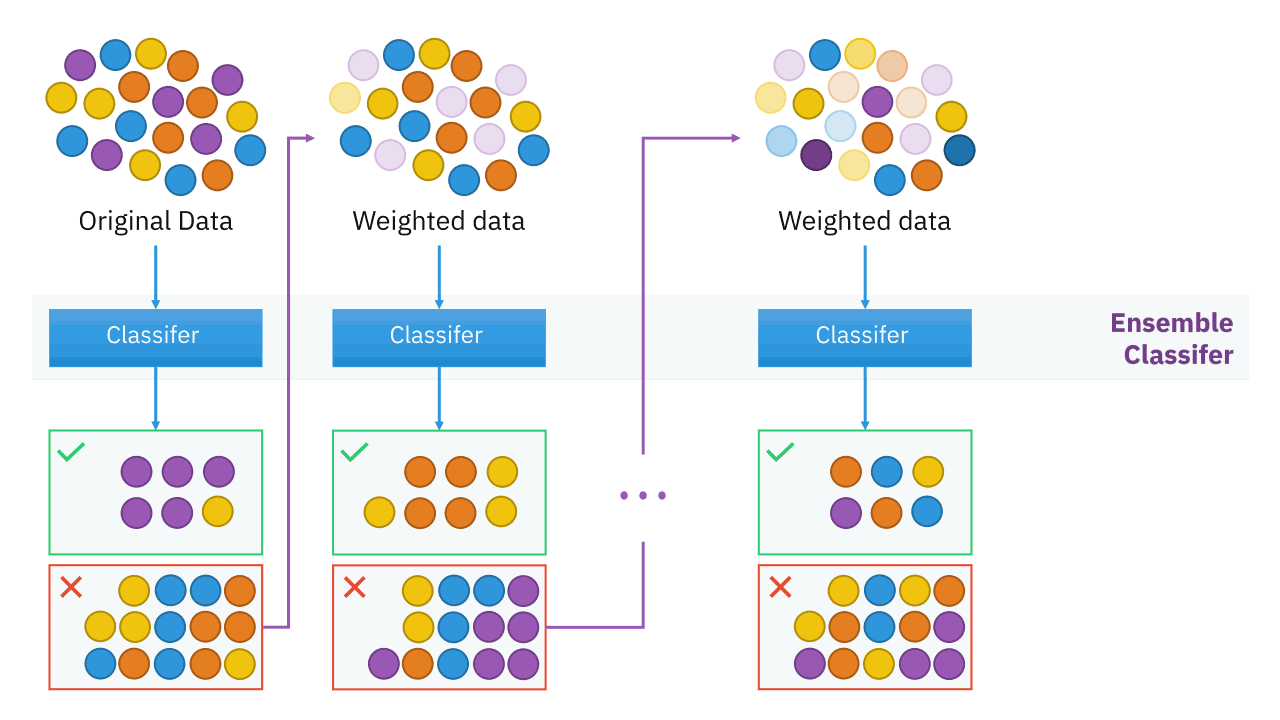
Англійські підписи: Original Data — вихідні дані, Classifier — модель раунду, Weighted data — дані з новими вагами (насиченіший колір — більша вага); зелена рамка — правильні відповіді, червона — помилки, які важчають у наступному раунді; Ensemble Classifer (з помилкою в оригіналі) — ансамбль.
Джерело: Sirakorn · Ensemble Boosting, Wikimedia Commons, ліцензія CC BY-SA 4.0
Вивід код запущено, вивід не редагувався
text
раунд 1: sex <= 0.50, помилки [4], ε = 0.100, α = 1.099
    ваги: [0.056 0.056 0.056 0.5   0.056 0.056 0.056 0.056 0.056 0.056], вага помилок 0.500
раунд 2: fare <= 46.00, помилки [2, 8], ε = 0.111, α = 1.040
    ваги: [0.031 0.25  0.031 0.281 0.031 0.031 0.031 0.25  0.031 0.031], вага помилок 0.500
раунд 3: age <= 28.00, помилки [5, 6, 9, 10], ε = 0.125, α = 0.973
    ваги: [0.018 0.143 0.018 0.161 0.125 0.125 0.018 0.143 0.125 0.125], вага помилок 0.500
правильно на навчанні: 10 із 10; нова пасажирка: сума +1.032
scikit-learn: ε [0.1   0.111 0.125] голоси [2.197 2.079 1.946]
На що дивитися: у кожному раунді пеньок помиляється на інших пасажирах — 4, потім 2 і 8, потім 5, 6, 9 і 10, — а після перезважування помилки щоразу важать рівно 0,5; три пеньки разом правильні для всіх десяти.
Раунд 2: пасажир 4 тепер важить половину, тож пеньок за статтю мав би помилку 0,5. Перемагає «квиток ≤ 46 £»: пасажира 4 він класифікує правильно, а помиляється на двох жінках із дешевими квитками, 2 і 8:
Прогноз — зважена сума голосів. Для нової пасажирки з розділу про ліс — жінки 23 років із квитком за 13,79 £ — пеньки голосують «+1» (жінка), «−1» (дешевий квиток) і «+1» (молодша за 28):
У AdaBoostClassifier голоси вдвічі більші (варіант SAMME) — знак суми від цього не змінюється.
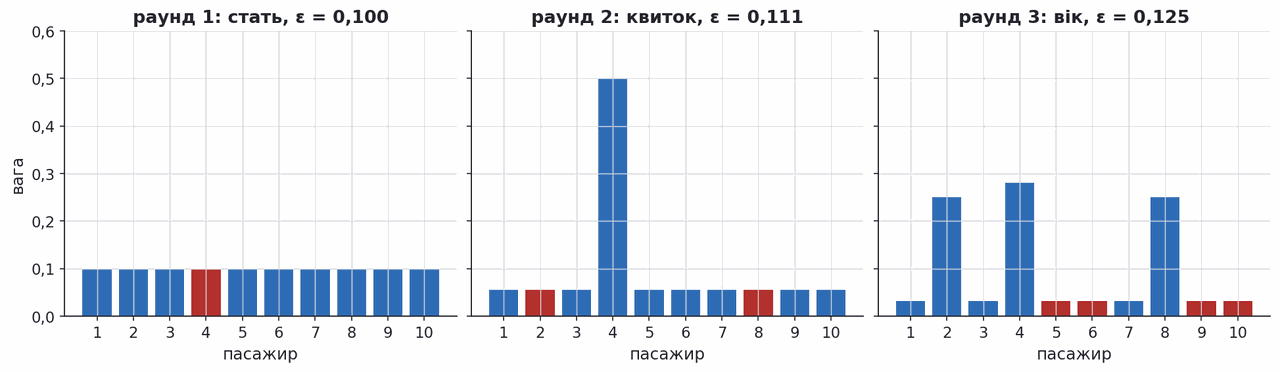
Ваги десяти пасажирів перед кожним із трьох раундів; червоним — пасажири, на яких помилився пеньок цього раунду. Після перезважування їхня сумарна вага стає рівно 0,5.
Бустинг перенавчається: рання зупинка і три важелі
У випадкового лісу зайві дерева нешкідливі: усереднення лише стабілізується. У бустингу навпаки — кожне нове дерево свідомо зменшує похибку на тренувальних даних, тож рано чи пізно починає підганяти шум. Тому кількість дерев — гіперпараметр, який зупиняють вчасно (рання зупинка, early stopping), а не «чим більше, тим краще».
Другий важіль — темп навчання
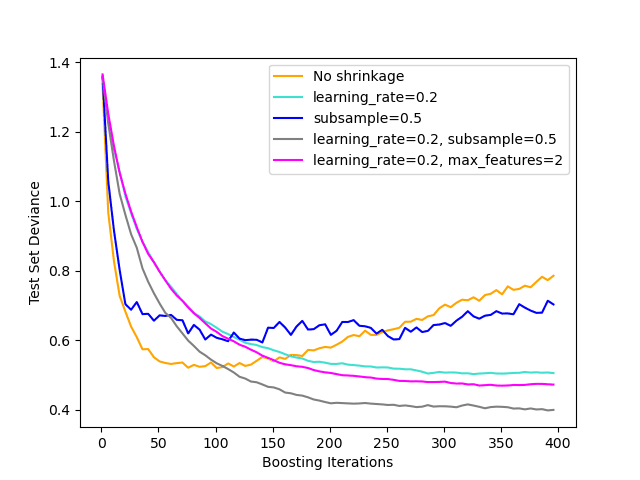
Помаранчева крива без регуляризації досягає мінімуму на відкладеній вибірці й починає повзти вгору — класичне перенавчання. Малий темп навчання прибирає це зростання, але вимагає більше дерев; найнижче лежить сіра крива, де темп навчання й підвибірка застосовані разом.
XGBoost: штраф стискає значення листка
XGBoost — той самий градієнтний бустинг: кожне дерево вчиться на залишках попередніх. Відмінність — у тому, як рахуються значення листка й виграш розбиття.
Значення листка. У нашому бустингу руками листок дорівнював середньому залишку. XGBoost додає до знаменника штраф
де
Виграш розбиття — наскільки розбиття зменшує втрату, мінус плата
Тут
Вивід код запущено, вивід не редагувався
text
λ =  0: формула [-0.71  0.71], XGBoost [-0.71  0.71], виграш 2.016
λ =  1: формула [-0.568  0.568], XGBoost [-0.568  0.568], виграш 1.613
λ = 10: формула [-0.203  0.203], XGBoost [-0.203  0.203], виграш 0.576
На що дивитися: XGBoost дає ті самі значення листків, що формула, — ±0,71 без штрафу, ±0,568 при λ = 1 і ±0,203 при λ = 10; виграш розбиття теж падає: 2,016 → 1,613 → 0,576.
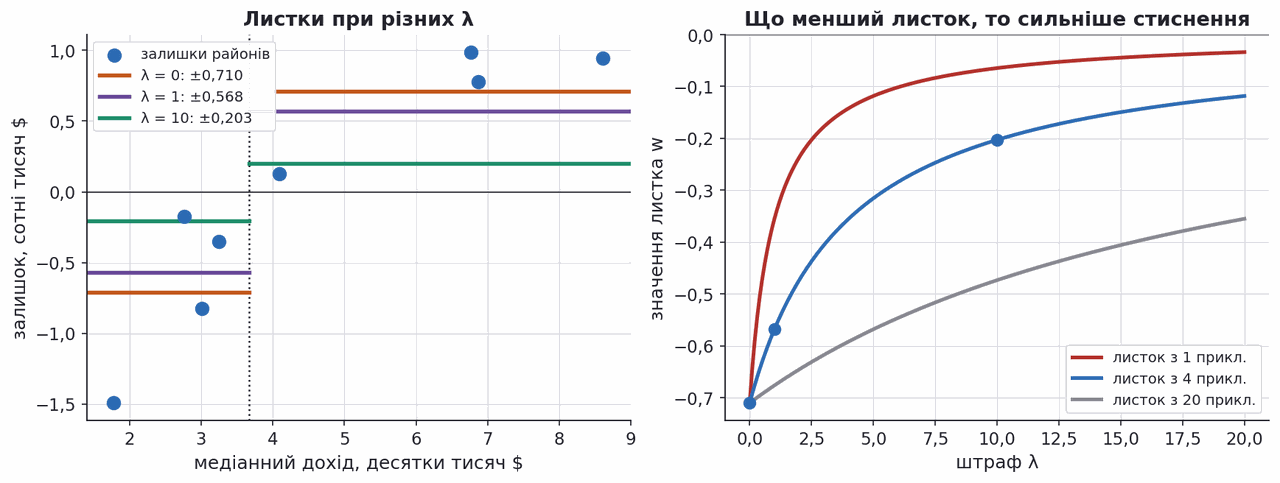
Ліворуч — залишки восьми районів після кроку 0 і значення двох листків при λ = 0, 1 і 10. Праворуч — значення листка з середнім залишком −0,71 як функція λ для листків з 1, 4 і 20 прикладів (умовні розміри): що менший листок, то швидше він стискається.
Для інших функцій втрат замість суми залишків стоїть сума перших похідних втрати за прогнозом з протилежним знаком, а замість кількості прикладів — сума других похідних; для класифікації це
LightGBM: пороги між кошиками й ріст по листках
LightGBM рахує ті самі листки й виграші, що XGBoost, але швидше — завдяки двом ідеям.
Гістограми. Точний перебір пробує поріг між кожними двома сусідніми значеннями (розділ «Пороги для числових ознак: середини між сусідніми значеннями»), і на мільйоні різних значень це мільйон кандидатів у кожному вузлі. LightGBM заздалегідь розкладає значення кожної ознаки в кошики — до 255 — і пробує пороги лише між кошиками. Умовний приклад на восьми районах: якщо розкласти доходи в чотири кошики по два, кандидатів лишається 3 замість 7, і серед них той самий найкращий, 3,67. Так тепер за замовчуванням робить і XGBoost.
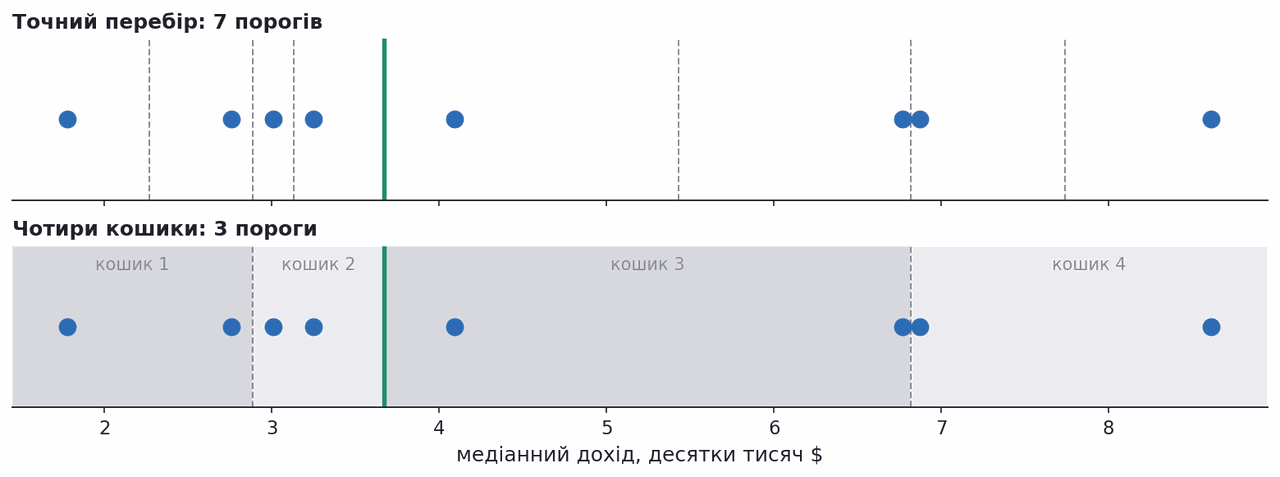
Угорі — точний перебір: сім порогів між вісьмома доходами. Унизу — ті самі доходи в чотирьох кошиках (сірі смуги): порогів три, найкращий, 3,67, серед них (зелений). Розбиття на кошики тут умовне — LightGBM будує їх за квантилями всієї вибірки.
Ріст по листках. Звичайне дерево росте по рівнях (level-wise): розбиває всі листки поточної глибини, навіть ті, де виграш мізерний. LightGBM росте по листках (leaf-wise): щоразу розбиває один листок — той, що дає найбільший виграш. За тієї самої кількості листків дерево виходить точнішим, але глибшим і легше перенавчається, тому в LightGBM обмежують кількість листків num_leaves, а не глибину. А категоріальні ознаки LightGBM приймає напряму, без one-hot-кодування: сам шукає, як поділити категорії на дві групи.
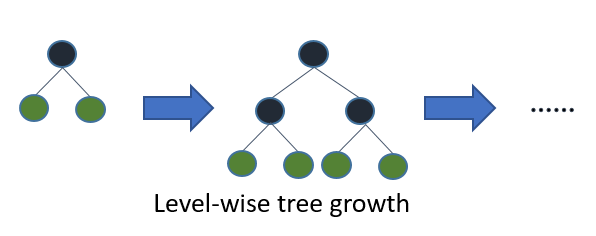
Англійські підписи: Level-wise tree growth — ріст по рівнях: розбиваються всі листки рівня.
Джерело: LightGBM · Features, ліцензія MIT
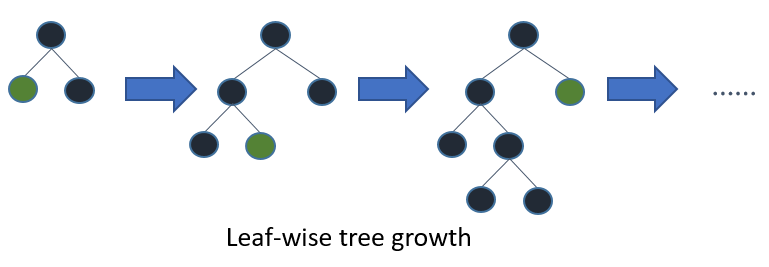
Англійські підписи: Leaf-wise tree growth — ріст по листках; зелений — листок, який розбивається наступним.
Джерело: LightGBM · Features, ліцензія MIT
Беггінг і бустинг вирішують різні задачі
| Аспект | Беггінг і випадковий ліс | Бустинг |
|---|---|---|
| Порядок навчання | незалежно, паралельно | послідовно, кожне дерево залежить від попередніх |
| Що зменшує | дисперсію | зміщення |
| Які дерева | глибокі, з малим зміщенням | мілкі, слабкі моделі |
| Агрегація | середнє або голос більшості | зважена сума внесків |
| Реакція на зайві дерева | нешкідливі | перенавчання |
| Налаштування | працює майже без підбору | потребує темпу навчання й ранньої зупинки |
Практичний висновок такий. Випадковий ліс — розумний перший вибір: він дає добрий результат зі стандартними параметрами й майже не має способів зіпсувати результат. Бустинг за акуратного підбору майже завжди виграє в лісу, але вимагає часу на налаштування й уваги до кількості дерев.
Порівняння методів на діагностиці пухлин
Візьмімо Breast Cancer Wisconsin, повторімо розбиття на тренувальну й тестову частини двадцять разів із різними випадковими станами й подивімось не лише на середнє, а й на розкид.
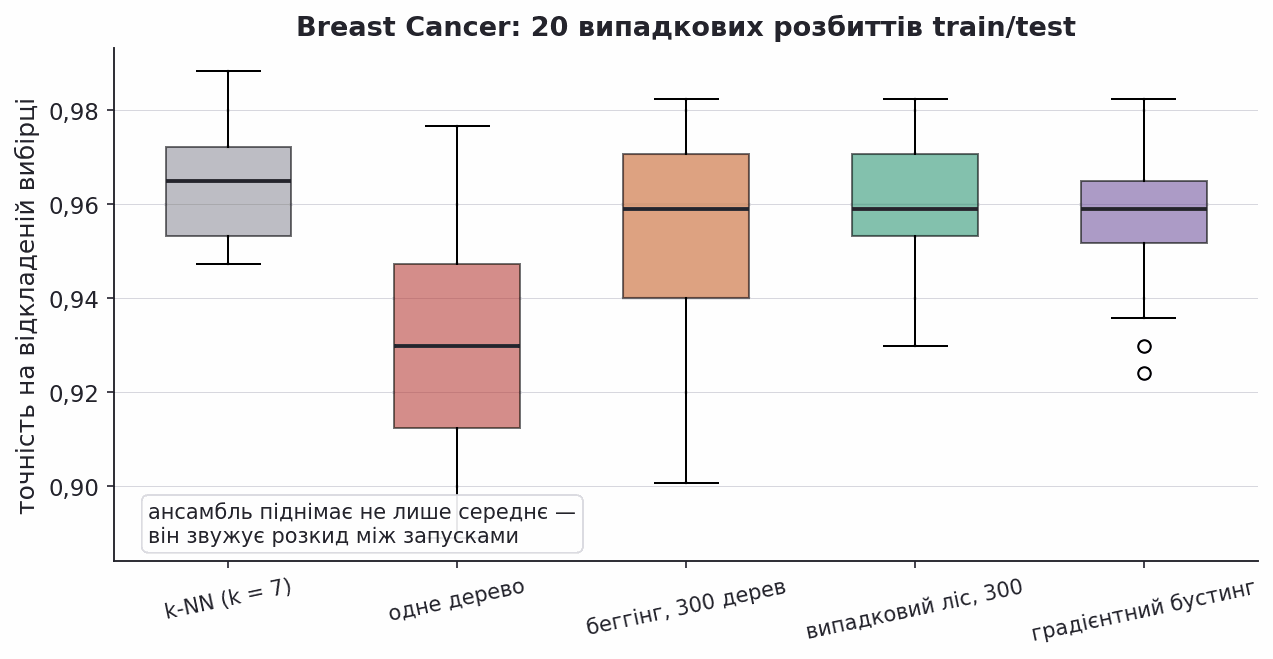
Одне дерево дає в середньому 0,930 з розкидом 0,023 — найгірший результат і найширша коробка водночас. Беггінг піднімає середнє до 0,953, випадковий ліс — до 0,960 і водночас звужує розкид до 0,014, градієнтний бустинг — до 0,956.
Найцікавіше в цій картинці ліворуч: метод сусідів зі стандартизацією дає 0,965 і обходить усі ансамблі. Тридцять ознак цього набору справді описують геометрію клітинних ядер, тож близькі за ними пухлини схожі й за діагнозом — рівно те припущення, на якому метод побудований. Універсально найкращого алгоритму не існує, і це не фігура мови, а спостережуваний факт.
Підсумок лекції
Сусіди й дерева не мають рівняння межі. Перші зберігають дані й вирішують локально, другі розрізають простір послідовністю простих перевірок; обидва легко описують нелінійність. Метод сусідів платить на кожному запиті —
Параметр k і глибина дерева керують складністю. В обох випадках працює той самий компроміс: занадто гнучка модель запам'ятовує вибірку, занадто груба нічого не бачить, і потрібну точку шукають на відкладених даних.
Ансамблі перетворюють нестабільність на перевагу. Беггінг і випадковий ліс зменшують дисперсію, усереднюючи багато глибоких дерев; бустинг послідовно зменшує зміщення, додаючи мілкі. Платять ансамблі інтерпретовністю, а бустинг — ще й чутливістю до кількості дерев, темпу навчання й шуму в мітках.
Кожен ансамбль — кілька простих кроків. Беггінг: бутстреп і усереднення. Випадковий ліс: те саме плюс випадкові ознаки в кожному вузлі. Градієнтний бустинг: пеньок на залишках і крок
Важливість ознак треба читати обережно. Міра за зменшенням домішки завищує ознаки з багатьма значеннями, а пермутаційна важливість занижує корельовані.
Усі ці методи працюють з ознаками, які їм дали. Будувати ознаки з сирих зображень або тексту вони не вміють — цим займуться нейронні мережі в лекціях 10–13.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекція 06b: сусіди й розмірність
- UBC CPSC 340 — лекції 3, 6, 7, 23: дерева й ансамблі
- Stanford CS231n — сусіди на зображеннях
Оригінальні статті
Підручник
- Hastie, Tibshirani, Friedman. The Elements of Statistical Learning — розділи 9.2, 10, 15
Документація scikit-learn