Тема
Лекція 14 · Генеративні та відповідальні моделі
Тринадцять лекцій ми вчили моделі відповідати на питання про дані. Сьогодні модель сама створюватиме дані — і саме тут стає видно, чому питання про відповідальність не можна відкладати наостанок.
Зміст лекції
Лекція складається з двох половин, і друга є прямим наслідком першої.
- Породжувальні моделі. Чим моделювання
відрізняється від і які родини методів для цього існують. - Варіаційний автокодувальник. Латентна змінна, нижня оцінка правдоподібності, репараметризація; повний робочий приклад на MNIST.
- Змагальні мережі. Гра генератора й дискримінатора, рівновага і чому таке навчання нестабільне.
- Дифузійні моделі. Зашумлення як прямий процес і передбачення шуму як навчальна задача.
- Змагальні приклади. Непомітне збурення входу, метод FGSM і ціна стійкості.
- Справедливість і відповідальність. Три формальні критерії, аудит моделі за групами та їхня взаємна несумісність.
Зв'язок між половинами прямий: та сама здатність моделі точно вловити розподіл даних дає і реалістичні зразки, і вразливість до збурень, і відтворення упереджень, які в даних уже були.
Чого ви навчитеся
Після цієї лекції ви зможете:
- відрізнити розрізняльну модель від породжувальної та назвати, що саме кожна з них моделює;
- пояснити будову варіаційного автокодувальника: латентну змінну, дві частини цільової функції та роль репараметризації;
- навчити VAE на MNIST і прочитати його латентний простір;
- записати мінімаксну мету змагальних мереж і назвати значення дискримінатора в рівновазі;
- пояснити прямий і зворотний процеси дифузійної моделі та довести, що навчання зводиться до передбачення доданого шуму;
- побудувати змагальний приклад методом FGSM і виміряти, як падає точність зі зростанням бюджету збурення;
- назвати три критерії справедливості, перевірити їх на реальних даних і пояснити, чому вони несумісні;
- пояснити, чому вилучення чутливої ознаки не робить модель справедливою.
Розпізнавання проти породження
Уся попередня частина курсу розв'язувала одну задачу: за спостереженням
"Given a data sample x, a discriminative model aims at predicting its label y, hence it models the conditional distribution p(y|x). Generative models instead model the distribution p(x) defined over the datapoints x." — EPFL CS-433, лекція «Generative Models»
Розрізняльна модель (discriminative model) вчить
Друга задача суттєво важча. Щоб відрізнити сімку від одиниці, досить кількох ознак; щоб намалювати нову сімку, треба знати все про те, як виглядають рукописні цифри. Зате й результат інший: модель, яка вміє породжувати, вміє і доповнювати, і прибирати шум, і оцінювати, наскільки новий об'єкт незвичний.
Джерело: EPFL CS-433 Machine Learning
Дані лекції: рукописні цифри MNIST
Практична частина лекції побудована на одному наборі даних.
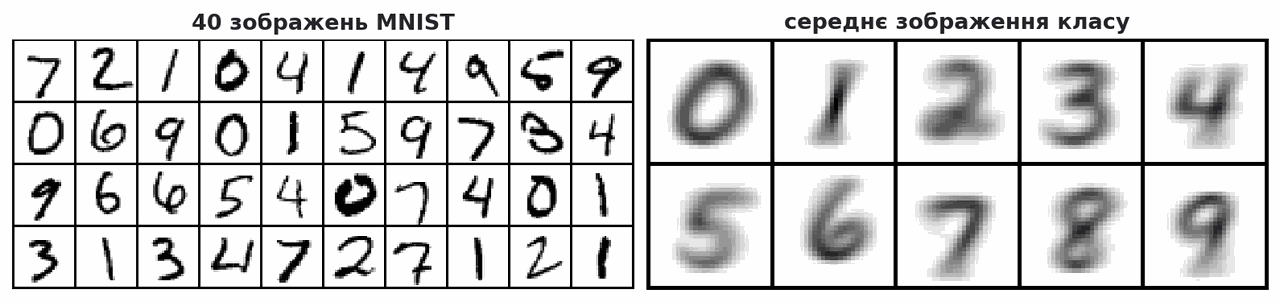
MNIST. 70 000 зображень рукописних цифр 28×28 пікселів у відтінках сірого, десять класів. Ми беремо 20 000 зображень для навчання і 2000 для перевірки. Розмірність одного зображення — 784 числа, тобто розподіл
Праворуч — найпростіша спроба вловити цей розподіл: усереднити всі зображення кожного класу. Виходять розмиті плями, впізнавані, але непридатні: усереднення руйнує саме те, що робить цифру цифрою, — чіткий контур.
Джерело даних: MNIST на OpenML
Явна оцінка густини
Перш ніж переходити до нейромереж, варто побачити класичний підхід. Ядрова оцінка густини (kernel density estimation) будує
Тут
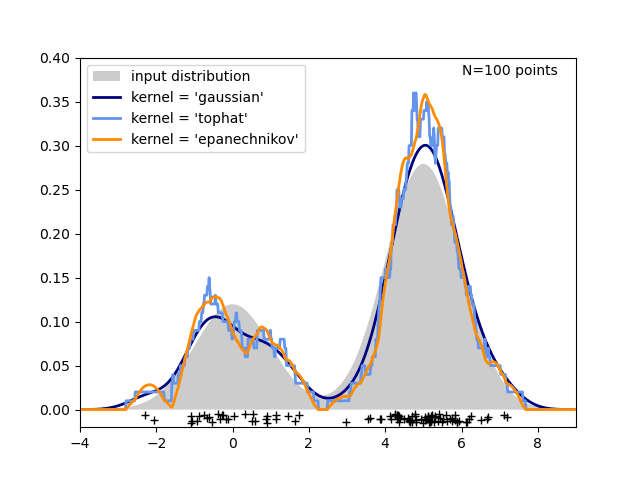
Це явна (explicit) модель густини: ми можемо обчислити
Джерело: scikit-learn · Simple 1D kernel density estimation
Ядрова оцінка вже породжує цифри
Той самий метод працює і на зображеннях. Знизити розмірність методом головних компонент, оцінити густину в отриманому просторі ядрами, взяти з неї випадкову точку й повернутися назад у простір пікселів.
Угорі рисунка — справжні цифри, унизу — сорок чотири нові, яких у навчальному наборі не було.
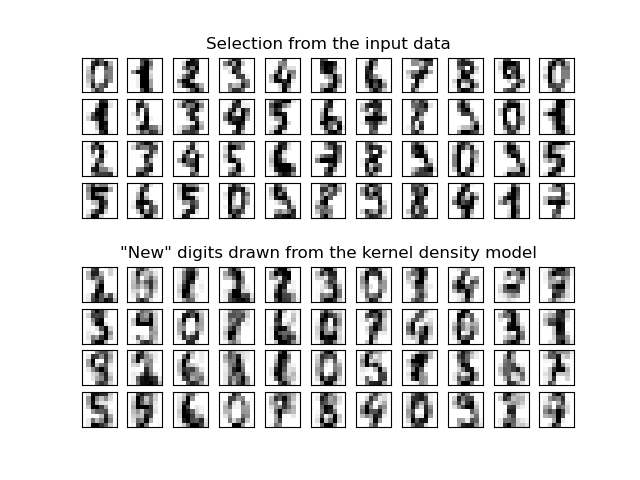
Результат несподівано пристойний для методу без жодної нейромережі, і водночас показує межу підходу: ядрова оцінка по суті інтерполює між сусідніми навчальними прикладами. У просторі з 784 вимірами сусідів надто мало, тому модель не стільки вигадує, скільки злегка розмиває наявне. Далі ми побачимо методи, які будують стиснене подання й породжують уже в ньому.
Джерело: scikit-learn · Kernel density estimation
Родини породжувальних моделей
Сучасні методи діляться за тим, чи моделюють вони густину явно й чи можна її обчислити точно.
| Родина | Густина | Сильна сторона | Слабкість |
|---|---|---|---|
| Змагальні мережі, GAN | неявна | різкі реалістичні зразки, швидке породження | нестабільне навчання, колапс мод |
| Авторегресивні моделі | точна | точна правдоподібність, зрозуміла будова | повільне послідовне породження |
| Нормалізуючі потоки | точна | і породження, і оцінювання густини швидкі | дороге навчання, жорсткі обмеження на архітектуру |
| Варіаційні автокодувальники | наближена | стабільне навчання, осмислений латентний простір | розмиті зразки |
| Дифузійні моделі | гібридна | найкраща якість зображень і покриття розподілу | повільне породження, сотні кроків |
Неявна (implicit) модель не вміє відповісти, чому дорівнює
Джерело: EPFL CS-433 Machine Learning
Трилема породжувального моделювання
Від породжувальної моделі хочеться трьох речей одразу: щоб зразки були якісні, щоб отримувати їх швидко і щоб модель покривала все різноманіття даних, а не кілька зручних типів об'єктів. Жодна з наявних родин не дає всіх трьох.
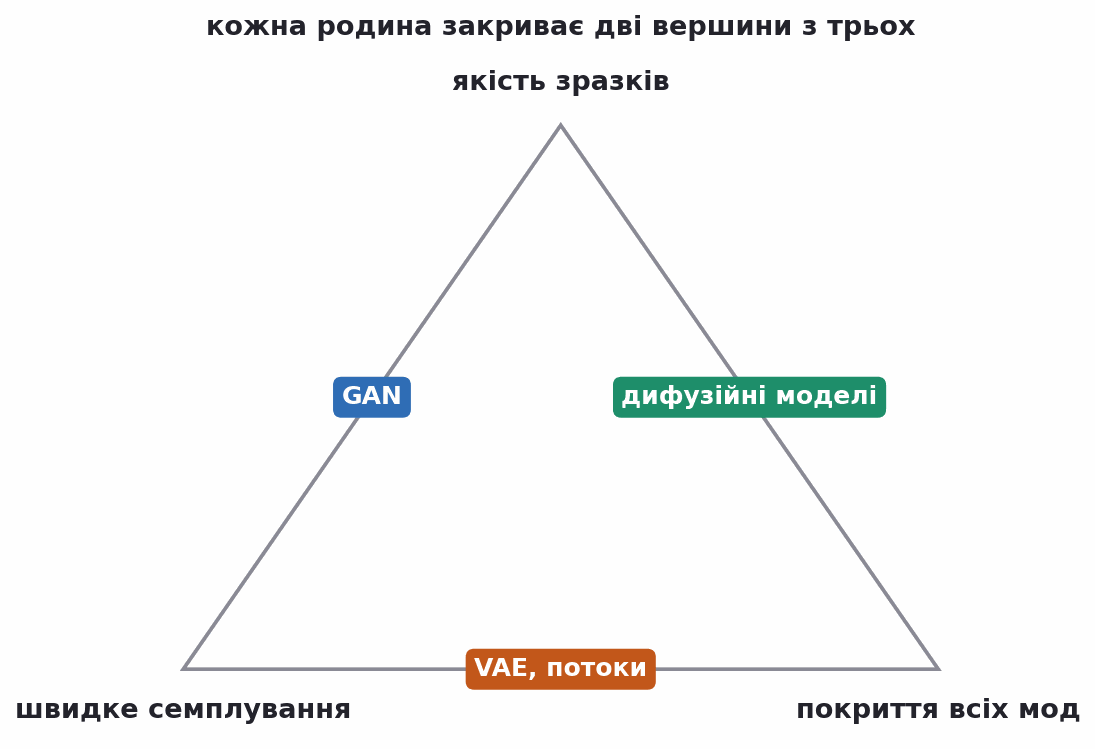
Це емпіричні тенденції, а не гарантії. На практиці GAN дає різкі зразки миттєво, але схильний втрачати частину розподілу. VAE і потоки семплюють швидко й покривають розподіл повніше, проте зразки виходять розмиті. Дифузійні моделі зазвичай дають найкращу якість і покриття, розплачуючись сотнями кроків на кожне зображення.
Практичний висновок простий: перед вибором методу треба знати, яка з трьох вершин у вашій задачі не обговорюється.
Автокодувальник: стиснути й відновити
Почнімо з простої конструкції. Автокодувальник (autoencoder) складається з двох мереж: енкодер стискає зображення до короткого коду, декодер відновлює зображення з коду. Навчають їх разом, мінімізуючи різницю між входом і виходом.
Ми стискаємо 784 пікселі до 16 чисел — у сорок дев'ять разів. Мітки при цьому не потрібні: ціль навчання — сам вхід.
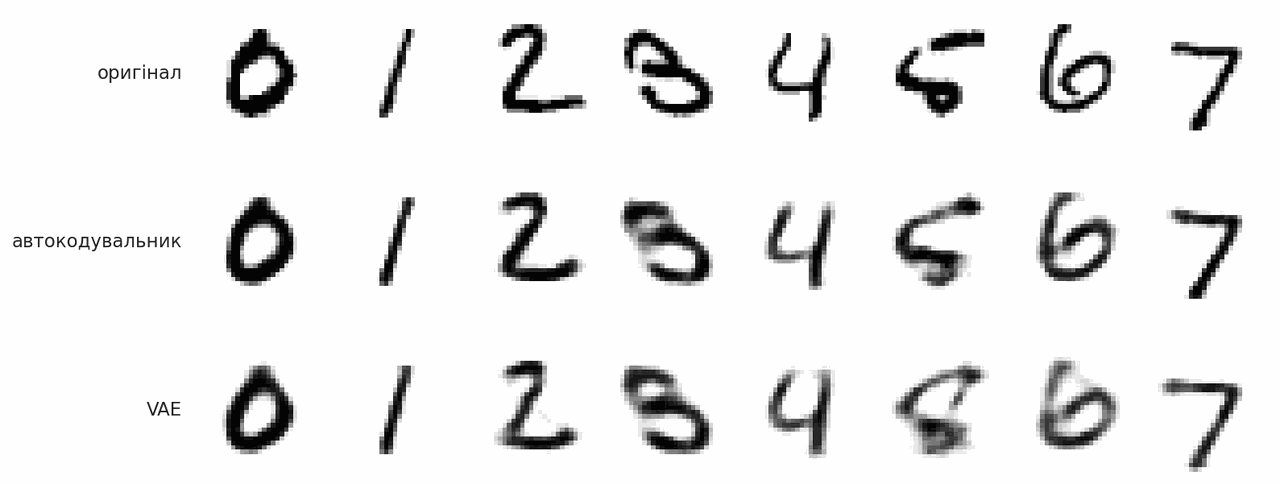
Верхній рядок — оригінали, середній — відновлення звичайного автокодувальника, нижній — відновлення варіаційного, до якого ми перейдемо далі. Обидва відновлюють цифру впізнавано; звичайний робить це точніше, бо ніщо не заважає йому просто запам'ятати код.
Звичайний автокодувальник породжувати не вміє
Здається, декодер уже є породжувальною моделлю: подай йому будь-який вектор із 16 чисел — отримаєш зображення. Спробуймо.
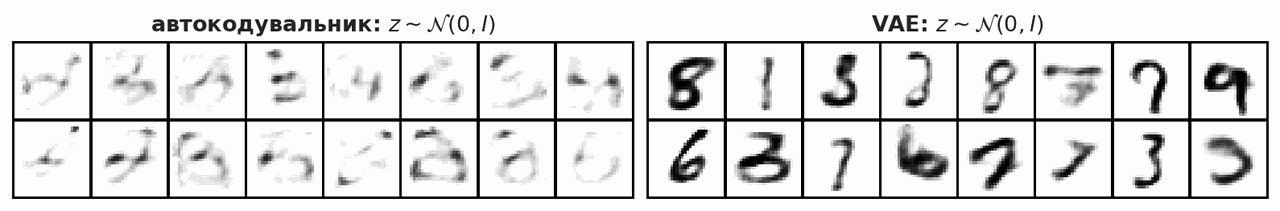
Ліворуч результат для звичайного автокодувальника: беззмістовні плями. Причина в тому, що ніхто не казав енкодеру, де саме в 16-вимірному просторі розміщувати коди. Він розкидав їх як завгодно, і випадковий вектор із
Праворуч — той самий експеримент із VAE: цифри. Різниця одна — VAE навчено так, щоб коди заповнювали простір за наперед відомим розподілом. Саме це й перетворює декодер на породжувальну модель.
VAE: латентна змінна та нижня оцінка
Варіаційний автокодувальник (variational autoencoder, VAE) припускає, що кожне зображення породжується у два кроки: спочатку з простого розподілу береться латентний вектор
Замість нього максимізують нижню оцінку (evidence lower bound, ELBO):
| Позначення | Значення |
|---|---|
| енкодер: видає середнє й дисперсію гаусіана, а не одну точку | |
| декодер: розподіл зображень за заданим кодом | |
| наперед заданий розподіл кодів | |
| розбіжність Кульбака — Лейблера, міра відмінності двох розподілів |
Перший доданок тягне модель до точного відновлення, другий — до того, щоб коди лягали за розподілом
Джерело: Kingma, Welling. Auto-Encoding Variational Bayes (2013)
Репараметризація: як пропустити градієнт крізь випадковість
У формулі ELBO є крок «взяти випадкове
Прийом репараметризації (reparameterisation trick) розв'язує це переписуванням:
Тепер випадковість живе в
Числовий приклад для одного виміру: якщо енкодер видав
Код: VAE на PyTorch
Вивід код запущено, вивід не редагувався
text
епоха  0   відновлення  233.4   KL   1.5
епоха 29   відновлення   86.5   KL  18.8
На що дивитися: помилка відновлення падає з 233,4 до 86,5, а штраф KL зростає з 1,5 до 18,8: модель дедалі більше користується латентним простором.
Модель поступово заповнює латентний простір, замість того щоб тиснути всі коди в нуль.
Латентний простір, у якому класи розділились самі
Візьмімо той самий VAE, але з латентним простором розмірності два — тоді його можна намалювати цілком. На рисунку кожна точка є тестовим зображенням, покладеним у координати свого коду; колір показує справжню цифру.
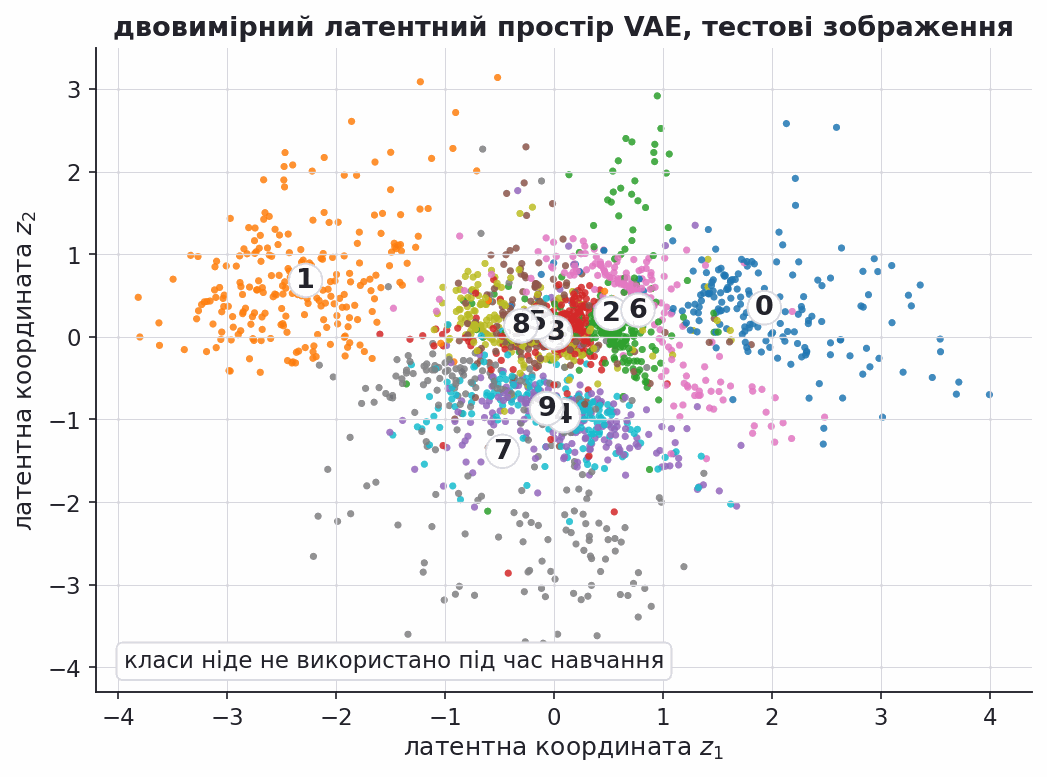
Класи зайняли різні ділянки простору, хоча жодної мітки під час навчання не використано. Одиниці стоять окремо і компактно, четвірки з дев'ятками перекриваються — так само, як і на папері. Хмара точок загалом схожа на двовимірний гаусіан: саме цього й вимагав доданок KL.
Обхід латентного простору
Якщо простір заповнений щільно, то будь-яка точка в ньому має відповідати правдоподібному зображенню. Перевіримо це прямо: побудуємо рівномірну сітку в межах
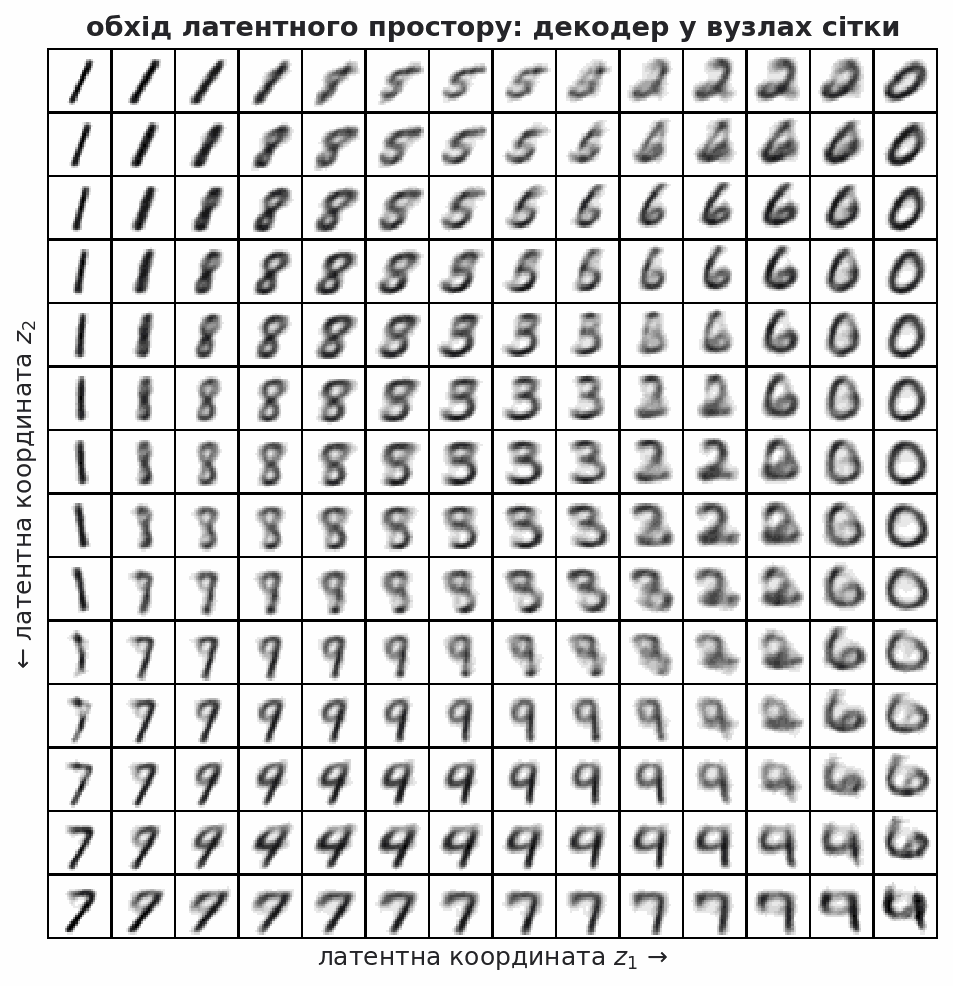
Порожніх клітинок немає. Рухаючись сіткою, ми бачимо плавні переходи: одиниця витягується й стає сімкою, сімка округлюється в дев'ятку, дев'ятка замикається в нуль. Це показує, що вздовж обраного зрізу простір форм неперервний. Строгим доказом відсутності запам'ятовування така картинка не є — для цього дивляться на найближчих сусідів у навчальній вибірці.
Такий рисунок — стандартний спосіб перевірити VAE очима. Розриви, повторення однієї цифри на великій ділянці або порожнечі означають, що навчання пішло не так.
Обмеження варіаційного автокодувальника
Порівняйте нижній рядок реконструкцій із верхнім: контури VAE помітно м'якші за оригінали. Це не дефект навчання, а властивість методу.
Розмитість закладена в цільову функцію. Декодер моделює розподіл, а не одне зображення, і мінімум досягається на чомусь середньому між усіма правдоподібними варіантами. Середнє двох різних написань сімки — розмита сімка.
Оцінка знизу лишається оцінкою. Ми максимізуємо ELBO, а не
Латентні виміри можуть відмерти. Якщо доданок KL занадто сильний, частина координат сходиться до наперед заданого розподілу й перестає нести інформацію. Ефект відомий як posterior collapse.
Практичний висновок: VAE варто брати, коли потрібен осмислений латентний простір — для інтерполяції, пошуку аномалій, стиснення. Коли потрібна фотографічна різкість, беруть інші родини.
FID: «розмито» — це вимірювана величина
Досі якість генерації ми оцінювали очима, а в статтях і в продукті її міряють числом. Найпоширеніша міра — FID (Fréchet inception distance): зображення проганяють крізь inception_v3 і рахують відстань між гаусовими наближеннями двох хмар ознак.
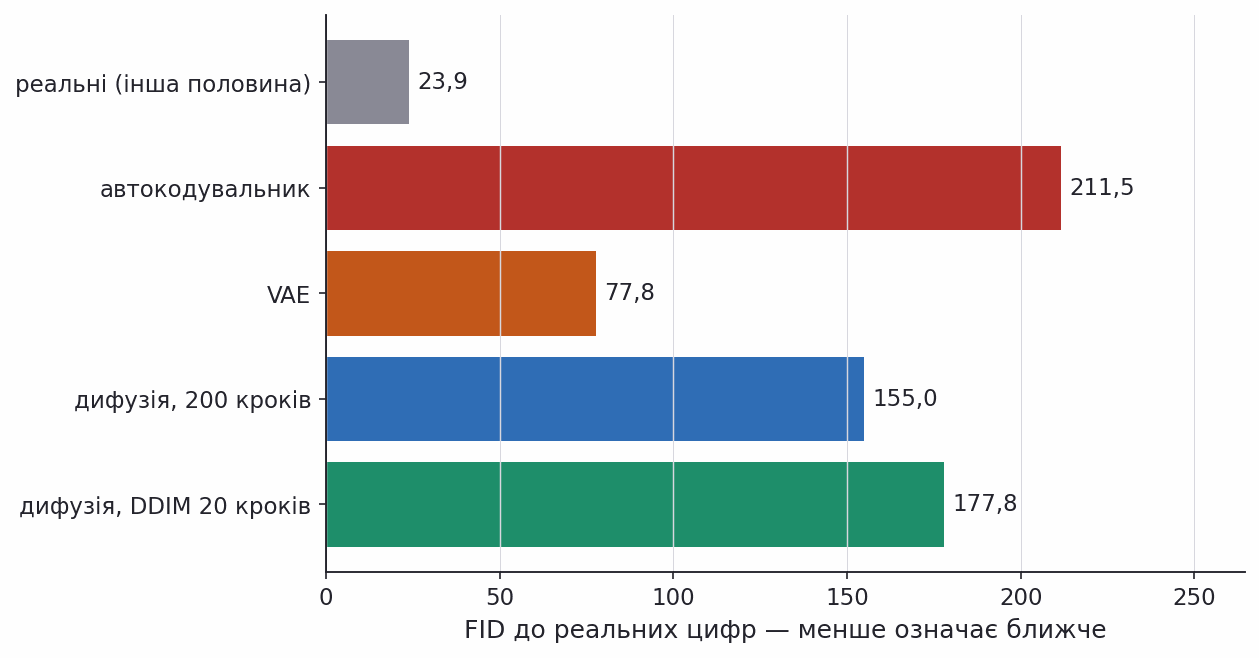
Перше число рахують не для моделі, а для самих даних: FID між двома половинами справжнього MNIST по 500 зображень дорівнює 23,9, а не нулю — скінченна вибірка має власну похибку, і без цієї підлоги решта чисел не має сенсу.
Далі наші моделі: автокодувальник 211,5, VAE 77,8, дифузія на 200 кроків 155,0.
Що це число не означає
Наша дифузійна модель має FID гірший за VAE — 155,0 проти 77,8, тоді як у статтях співвідношення протилежне. Причина не в родинах: ми порівняли дві конкретні мережі, і дифузійний UNet навчався дванадцять епох проти тридцяти у VAE, тобто недонавчений.
Це і є головна пастка FID: число міряє відстань між двома хмарами ознак і нічого більше. Три правила звідси:
Завжди рахуйте підлогу. Наші 23,9 при 500 зразках — це той нуль, від якого відлічують. У статтях беруть 50 000 зразків, і підлога опускається до одиниць; порівнювати FID між роботами з різними обсягами вибірки не можна.
FID сліпий до різноманіття всередині класу. Модель, яка навчилася малювати одну ідеальну трійку й нічого більше, дістане пристойний FID, якщо ознаки збіглися. Колапс мод із розділу про GAN так і не виявляється.
Число не замінює очей. Дивитися на зразки все одно треба — FID лише робить враження «розмито» відтворюваним і придатним для порівняння двох версій однієї моделі.
Змагальні мережі: гра двох гравців
GAN (generative adversarial network) відмовляється від будь-якої формули густини. Замість неї — два гравці з протилежними цілями.
Генератор
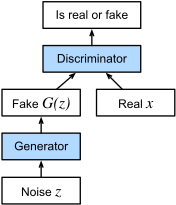
Позначення тут інші, ніж у решті курсу:
Генератор ніколи не бачить реальних даних напряму. Єдиний його навчальний сигнал — градієнт, що приходить від дискримінатора.
Джерело: Dive into Deep Learning · Generative Adversarial Networks
Мінімаксна мета та рівновага
Гру записують однією формулою:
| Позначення | Значення |
|---|---|
| справжній розподіл даних | |
| розподіл, який породжує генератор | |
| оцінка ймовірності того, що | |
| перший доданок | дискримінатор має впевнено казати «справжнє» про реальні дані |
| другий доданок | дискримінатор має впевнено казати «підробка» про |
Для фіксованого генератора оптимальний дискримінатор дорівнює
У цій точці
Що видно в реальному прогоні GAN
Теорію легко перевірити. На рисунку — навчання GAN на двовимірних даних із підручника Dive into Deep Learning.
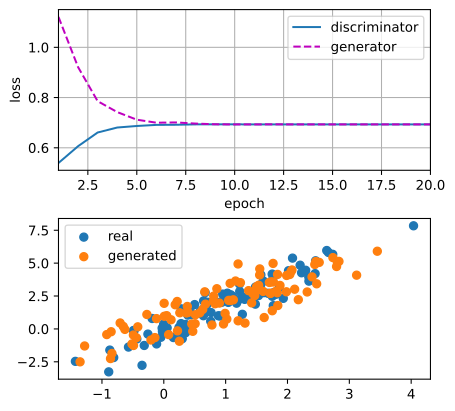
Угорі втрати обох мереж у тому вигляді, як їх рахує підручник — усереднена бінарна перехресна ентропія; обидві сходяться приблизно до 0,69. Це число не випадкове:
Унизу — справжні точки та породжені генератором. Хмари накладаються, тобто
Джерело: Dive into Deep Learning · Generative Adversarial Networks
Колапс мод і нестабільність навчання
Двовимірний приклад збігся охайно. На зображеннях усе значно гірше, і причин дві.
Колапс мод (mode collapse). Генератору вигідно знайти кілька зразків, які обманюють поточний дискримінатор, і видавати лише їх. Глобальну мінімаксну мету це не виконує — при оптимальному дискримінаторі неповний
Градієнт зникає, коли розподіли не перетинаються. Якщо носії
Ліки шукають у заміні міри відстані: WGAN використовує відстань Вассерштейна, у якої градієнт визначений і тоді, коли розподіли рознесені. Ціною є обмеження на дискримінатор — обрізання ваг, штраф на градієнт або спектральна нормалізація.
Джерело: Goodfellow та ін. Generative Adversarial Nets (NeurIPS 2014)
Дифузійні моделі: одна мережа замість двох гравців
Дифузійні моделі прибирають саме джерело нестабільності — змагання.
"Unlike GANs, which train two separate models for data generation and discrimination, diffusion models work by progressively adding noise to input data and training one single model to estimate the added noise and recover the data." — EPFL CS-433, лекція «Generative Models»
Ідея в трьох реченнях. Візьмімо зображення й будемо крок за кроком підмішувати до нього гаусів шум, доки від картинки не залишиться нічого. Навчімо мережу робити один крок назад. Тоді, стартувавши з чистого шуму й повторивши зворотний крок сотні разів, отримаємо нове зображення.
Прямий процес не містить жодних параметрів — це просто фіксована процедура псування. Учиться лише зворотний.
Джерело: EPFL CS-433 Machine Learning
Прямий процес: від цифри до чистого шуму
Прямий процес — марковський ланцюг із гаусовими переходами:
Зручність у тому, що будь-який крок можна отримати з нульового одразу, не проходячи ланцюг:
Сигнал згасає як
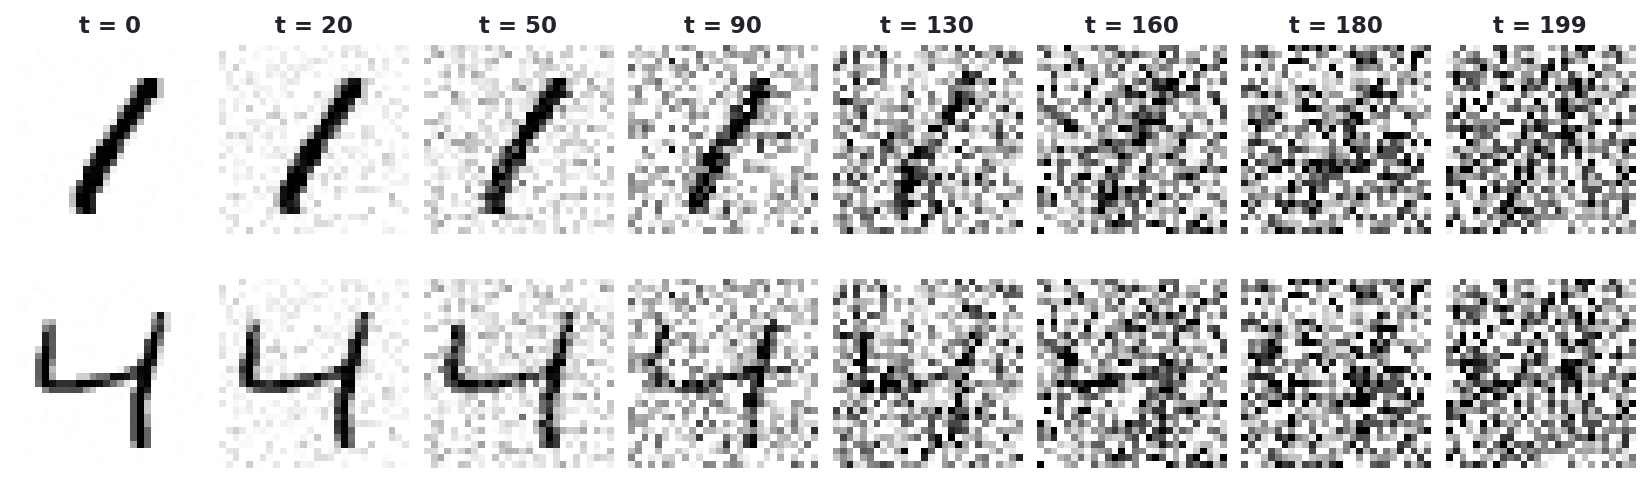
На рисунку дві цифри проходять 200 кроків такого зашумлення. Приблизно до сотого кроку форма ще вгадується, після сто п'ятдесятого — вже ні.
Як цифра перетворюється на шум
Прямий процес рахується за формулою вище, одним кроком із нуля:
x_t = α^t · x₀ + √(1 − α^2t) · ξ. Ліворуч видно кожен доданок окремо, праворуч — їхню суму, тобто те, що бачить модель на кроці t. +
=
1,000частка сигналу αt
0,000рівень шуму
100,0 %дисперсії ще від зображення
Сигнал згасає як αt, шум накопичується — і сума завжди лишається з тією самою дисперсією, бо коефіцієнти підібрано так навмисно. Візьміть α = 0,9: цифра зникає за пару десятків кроків. Візьміть 0,995 — ланцюг доводиться тягнути в рази довше. Саме цей компроміс і задає розклад шуму в дифузійних моделях: чим повільніше руйнування, тим легше навчити зворотний крок, але тим дорожче семплування. Натисніть «інший шум» — картинка зміниться, а числа ні: вони залежать тільки від t і α.
Зворотний процес зводиться до передбачення шуму
Зворотний перехід
Мережу
Прямо це порахувати теж неможливо, бо істинний скор невідомий. Але оскільки
"…which has the illuminating interpretation of learning to predict the added noise ξt from the noised data Xt." — EPFL CS-433, лекція «Generative Models»
Тобто навчання дифузійної моделі — це звичайна регресія: подаємо зашумлене зображення й номер кроку, вимагаємо назвати доданий шум. Жодного змагання, звичайна середньоквадратична втрата.
Семплування: з шуму в зображення
Породження — це зворотний хід ланцюга. Стартуємо з
Це саме наближення, а не точний зворотний перехід: множник
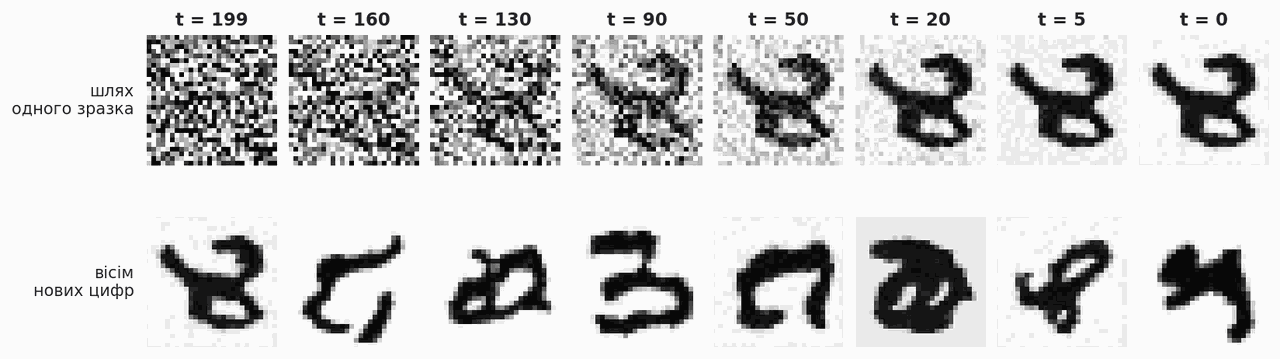
Верхній рядок — шлях одного зразка від чистого шуму до цифри: спершу проступають темні плями, потім вони збираються у штрихи, і лише на останніх кроках форма стає визначеною. Нижній рядок — вісім незалежних зразків із моделі, навченої дванадцять епох на процесорі.
Якість помітно нижча за ту, яку показують у статтях: там навчання триває дні на графічних прискорювачах. Але сама схема працює й на такому бюджеті, і головна ціна методу видно одразу — щоб отримати одне зображення, потрібно 200 проходів через мережу замість одного в VAE.
Джерело: Ho, Jain, Abbeel. Denoising Diffusion Probabilistic Models (NeurIPS 2020)
DDIM: двадцять кроків замість двохсот
Двісті проходів через мережу заради одного зображення — ціна, яку довго вважали неминучою. Вона такою не є. DDIM робить зворотний процес детермінованим: якщо на кожному кроці не додавати свіжого шуму, послідовність кроків перестає бути марковським ланцюгом, і по ній можна йти рідше, пропускаючи проміжні моменти часу.
Ключовий рядок — передостанній: маючи оцінку шуму, ми відновлюємо припущення про чисте зображення
Виграш у часі прямий: 500 зразків за 5,2 секунди проти 52,2 — рівно вдесятеро. Плата теж є, і її варто назвати чесно: FID гіршає зі 155,0 до 177,8. Обіцянку «майже та сама якість» на нашій маленькій моделі підтвердити не вдалося — двадцять кроків із двохсот коштують приблизно п'ятнадцяти відсотків FID. У великих моделях розрив менший, але сам обмін «кроки проти якості» лишається, і саме його налаштовують у продукті.
Змагальні приклади: непомітне збурення ламає модель
Тепер про зворотний бік точності. Виявляється, що модель, яка дає 97 % правильних відповідей, можна впевнено обманути зміною входу, якої людина не помічає.
"NNs have struggle with imperceptible yet very specific inputs known as adversarial examples." — EPFL CS-433, лекція «Adversarial Machine Learning»
Змагальний приклад (adversarial example) — це вхід
Це не екзотика лабораторії. Та сама вразливість означає, що систему розпізнавання дорожніх знаків, обличчя або спаму можна цілеспрямовано ввести в оману, і зробити це так, щоб оператор нічого не побачив.
Джерело: EPFL CS-433 Machine Learning
Стандартний і змагальний ризик
Різницю між звичайною і змагальною постановками видно у формулах. Звичайний ризик — частка помилок на даних як вони є:
Змагальний ризик (adversarial risk) вимірює помилку в найгіршій точці околу кожного спостереження:
Внутрішній максимум і робить задачу іншою: тепер модель має бути правильною не в точці, а в цілій кулі навколо неї. Радіус
Норма
FGSM: один крок уздовж градієнта
Найпростіший спосіб знайти точку максимуму всередині кулі — зробити один крок у бік зростання втрати. Метод називають FGSM (fast gradient sign method).
У постановці курсу для міток
Для багатокласової задачі, як наш MNIST, зручніше еквівалентний запис через втрату:
Ключова деталь: градієнт береться за входом, а не за вагами. Механізм той самий — зворотне поширення, — але зупиняємось на один крок раніше й читаємо похідну на вхідному шарі. Функція
Ітеративна версія, PGD, робить кілька дрібніших кроків із поверненням у кулю після кожного; крок атаки позначимо
Джерело: Goodfellow, Shlens, Szegedy. Explaining and Harnessing Adversarial Examples (ICLR 2015)
Код: FGSM на навченій мережі
Атакуємо не VAE, а окремий класифікатор — згорткову мережу того самого типу, що в лекції 11, тільки трохи ширшу, навчену на тих самих даних; позначимо її cnn, а тестові зображення у формі (N, 1, 28, 28) — X4_test.
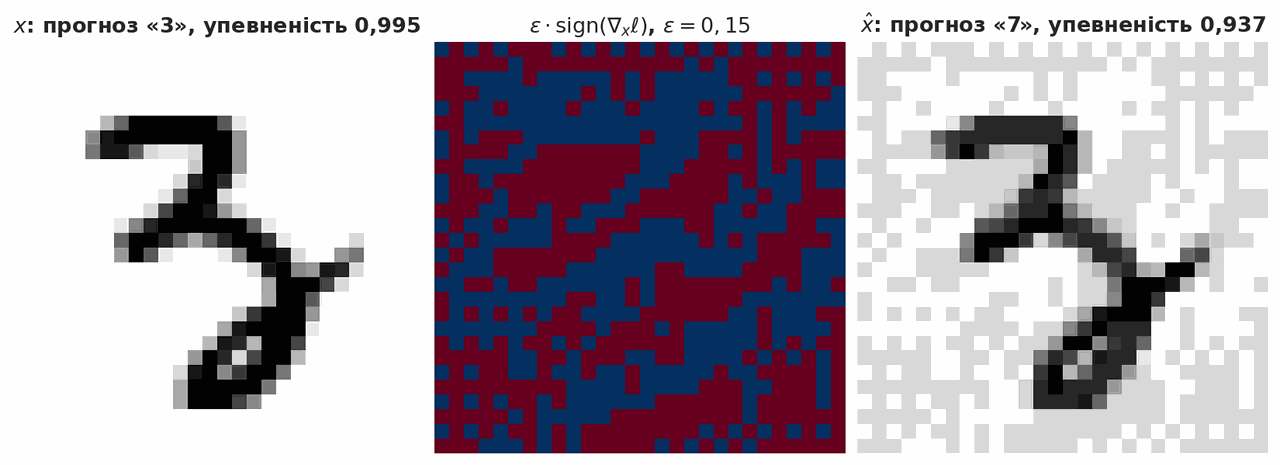
Згорткова мережа з точністю 97,6 % на тесті впевнено називає це зображення трійкою. Після додавання збурення з бюджетом 0,15 у шкалі 0…1 вона так само впевнено називає його сімкою. Для людського ока зображення не змінилося. (Через обрізання clamp(0, 1) пікселі біля країв діапазону зсуваються менше ніж на
Стійкість під атакою і її ціна
Один приклад міг бути випадковим. Порахуймо частку правильних відповідей на всіх 2000 тестових зображеннях як функцію бюджету збурення.
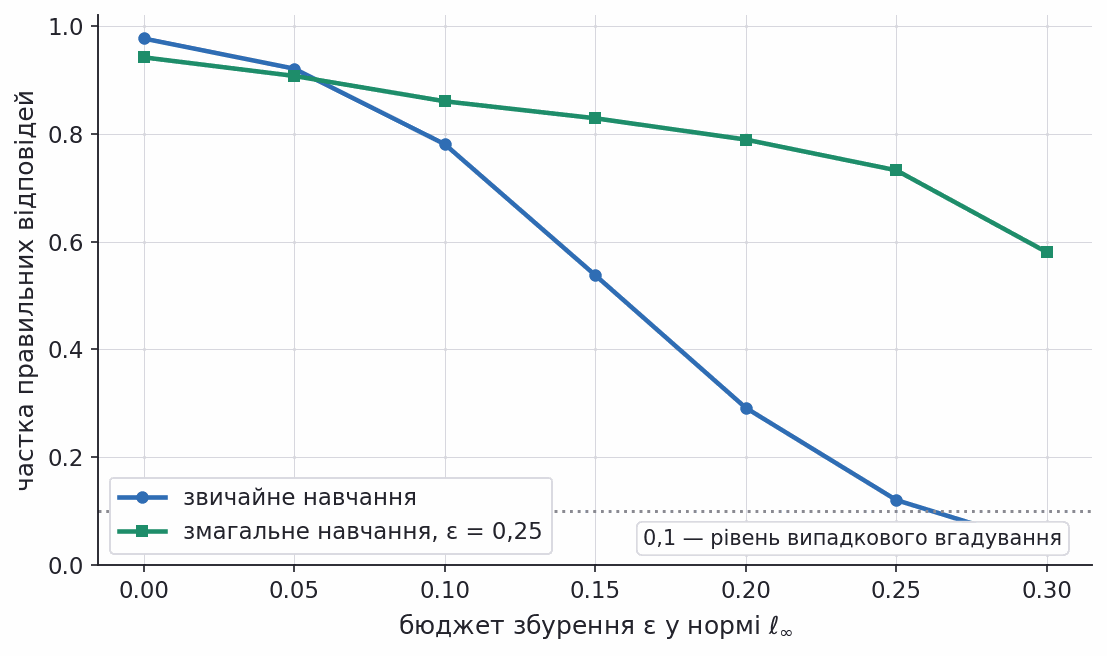
Звичайно навчена мережа (синя крива) розсипається дуже швидко: 97,6 % без атаки, 53,8 % при
Зелена крива — та сама архітектура, навчена змагально (adversarial training): на кожному кроці приклади спершу псуються атакою, а вже потім подаються моделі. Формально це задача
Результат подвійний. При
Що знає атакувальник
Сила атаки залежить від доступу до моделі. Повний доступ — не єдиний і навіть не найпоширеніший випадок.
| Режим | Що доступно атакувальнику | Метод |
|---|---|---|
| Білий ящик | уся модель і її градієнти | FGSM за один крок, PGD ітеративно |
| Чорний ящик за оцінками | лише число | скінченні різниці замість градієнта, 10–100 тисяч запитів |
| Чорний ящик за рішеннями | лише передбачений клас | рух уздовж межі рішення, найдорожче за запитами |
| Перенесення | нічого, але є схожі дані | навчити сурогатну модель і атакувати її, приклади часто переносяться |
Останній рядок найнеприємніший: щоб зламати закриту систему, часто достатньо навчити власну модель на схожих даних. Крім того, атаки бувають фізичними: наклейки на дорожньому знаку, надруковані за спеціальним візерунком, збивають систему розпізнавання, знятий на камеру знак при цьому лишається зрозумілим людині.
Джерело: Eykholt та ін. Robust Physical-World Attacks (CVPR 2018)
Цикл машинного навчання і походження упереджень
Модель не існує окремо від світу. Стан світу вимірюють — виходять дані; на даних навчають модель; модель приймає рішення; рішення змінюють життя людей; змінений світ дає нові дані. Це замкнене коло, і викривлення на будь-якому його етапі повертається у вхід посиленим.
Джерела упереджень розкладаються на чотири типи. Вимірювання: ознака є лише грубим замінником того, що цікавить насправді. Історичні дані: минулі рішення були несправедливими, і модель вчиться їх відтворювати. Розмір вибірки: меншу групу представлено гірше, тож і точність на ній нижча. Надлишкове кодування: чутлива ознака відновлюється з інших ознак.
"Discrimination is domain-specific: concerned with opportunities that affect people's lives. Discrimination is group-specific: concerned with social categories that have served as the basis for unjustified and systematically adverse treatment in the past." — EPFL CS-433, лекція «Ethics and Fairness»
Джерело: Barocas, Hardt, Narayanan. Fairness and Machine Learning
Вилучення чутливої ознаки не розв'язує проблеми
Перший інстинкт — прибрати чутливу ознаку зі входу. Перевірмо це на реальних даних.
Titanic. 891 пасажир, ознаки: клас квитка, вік, кількість родичів на борту, вартість квитка, порт посадки. Передбачаємо, чи пасажир вижив; чутлива ознака — стать, у моделі її немає. Тест — 312 пасажирів.
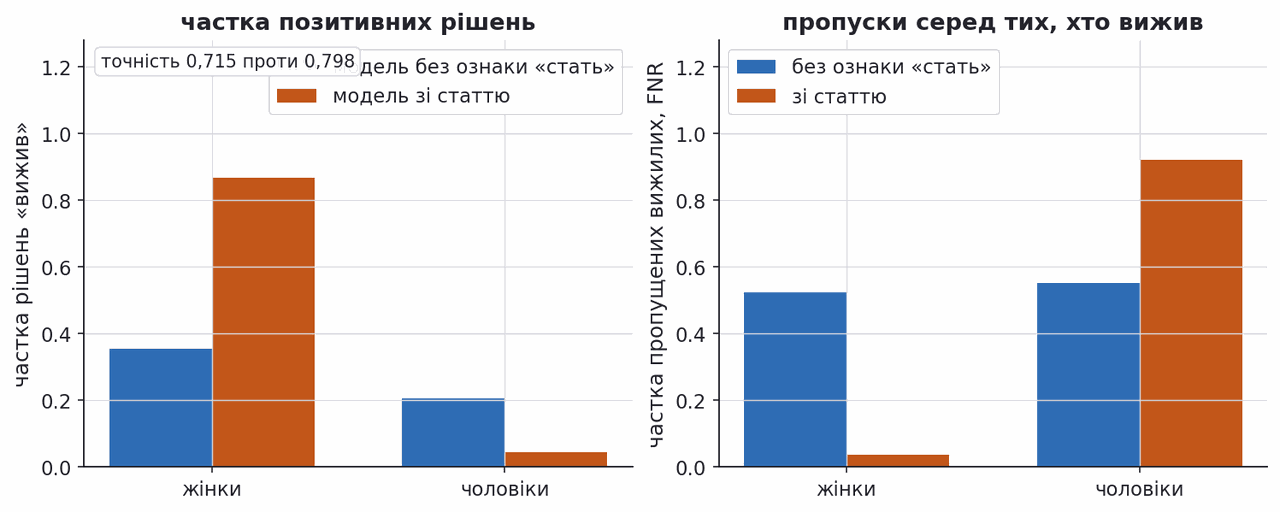
Сліпа модель має точність 0,715 і оголошує вижилими 35,4 % жінок проти 20,6 % чоловіків — розрив лишився. Модель, яка бачить стать, точніша (0,798), але розрив у неї катастрофічний: 86,7 % проти 4,5 %, а серед чоловіків, які насправді вижили, вона пропускає 92,1 %.
"Removing or ignoring sensitive attributes is not solving the problem." — EPFL CS-433, лекція «Ethics and Fairness»
Цікава деталь: відновити стать із решти ознак майже не вдається — випадковий ліс дає 0,654 за базового рівня 0,638. Тобто справа тут не в надлишковому кодуванні, а в тому, що частки вижилих у групах різні за самою природою даних, і жодна сліпота моделі цього не змінює.
Три критерії справедливості
Щоб говорити про справедливість предметно, потрібні означення. Нехай
| Критерій | Формально | Що вимагає |
|---|---|---|
| Незалежність | однаковий розподіл оцінки в групах; для рішення | |
| Сепарація | однаковий розподіл оцінки в групах при кожному | |
| Достатність | однакова оцінка означає однакову ймовірність в обох групах |
Достатність тісно пов'язана з калібруванням.
"A score R is calibrated if ℙ(Y=1 | R=r) = r → you can interpret your score as a probability." — EPFL CS-433, лекція «Ethics and Fairness»
Якщо оцінка калібрована окремо в кожній групі, достатність виконано автоматично. Кожен критерій відповідає своєму уявленню про справедливість, і, як побачимо, задовольнити всі три одночасно неможливо.
Джерело: Barocas, Hardt, Narayanan. Fairness and Machine Learning
Аудит моделі за групами
Прикладімо всі три критерії до нашої сліпої моделі. Це і є аудит справедливості: три вимірювання, які треба зробити перед тим, як модель почне приймати рішення про людей.
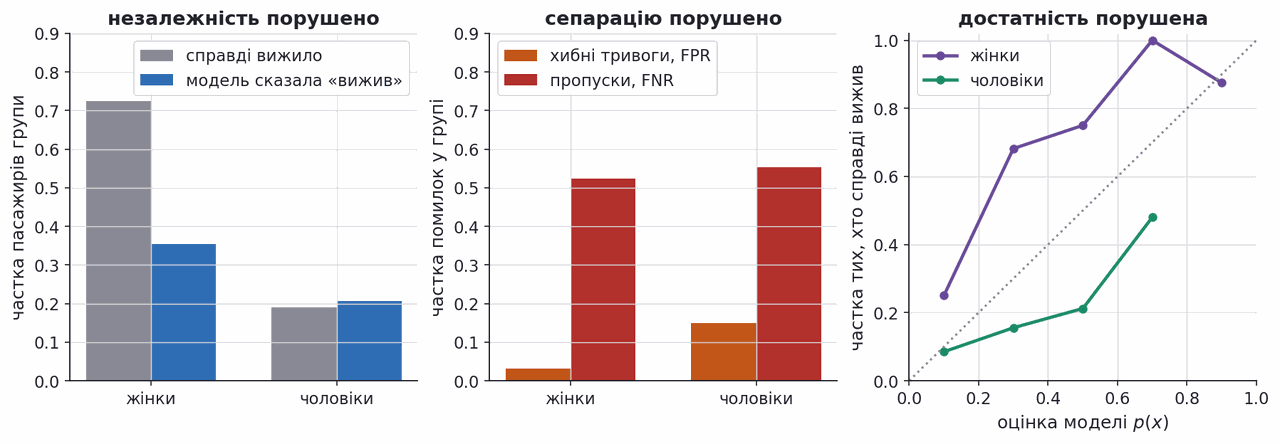
Незалежність порушено: позитивне рішення отримують 35,4 % жінок і 20,6 % чоловіків.
Сепарацію порушено: хибних тривог серед жінок 3,2 %, серед чоловіків 14,9 % — різниця майже в п'ять разів. Пропусків приблизно порівну, 52,4 % і 55,3 %.
Достатність порушена найгрубіше: серед пасажирів, яким модель дала оцінку між 0,4 і 0,6, справді вижили 75 % жінок і лише 21 % чоловіків. Одне й те саме число на виході моделі означає для двох груп зовсім різні речі, тож використовувати спільний поріг не можна.
Жоден із цих трьох дефектів не видно в загальній точності 0,715. Саме тому аудит роблять окремо.
Критерії несумісні між собою
Природне бажання — виконати всі три критерії одразу. Це неможливо, і не через брак алгоритмів.
"Informal theorem: any of these criteria are mutually exclusive — except in degenerate cases!" — EPFL CS-433, лекція «Ethics and Fairness»
Точніше: якщо
Наші дані дають це в чистому вигляді: серед жінок вижило 72,6 %, серед чоловіків 19,1 %. Із такою різницею базових часток жоден недосконалий класифікатор не буде одночасно однаково каліброваним у групах і мати однакові частки помилок. Виняток лише вироджений — ідеальний прогноз.
Висновок: критерій обирають під конкретне рішення й обґрунтовують змістовно. Технічно його домагаються на трьох етапах: ознаки, незалежні від
Інтерпретовність: на що модель насправді спирається
Аудит показує наслідки, але не причини. Щоб побачити, які ознаки керують рішенням, вимірюють важливість перестановкою (permutation importance): перемішують значення однієї ознаки й дивляться, наскільки впала якість.
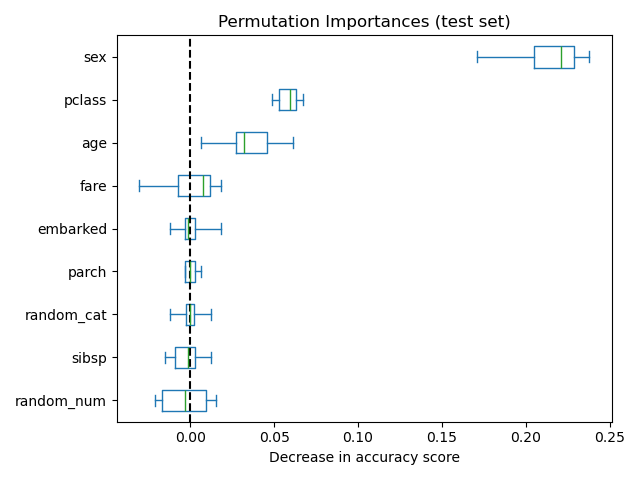
На рисунку з документації scikit-learn — та сама задача про Titanic, але з доступною ознакою статі. Вона домінує: перемішування статі забирає близько 0,22 точності, тоді як спеціально доданий випадковий стовпець дає рівно нуль, як і має бути.
Важлива методична деталь: вбудована важливість дерев рішень на тих самих даних ставить випадковий числовий стовпець на третє місце, бо оцінює її на навчальній вибірці, де ознака з багатьма унікальними значеннями дозволяє перенавчитися. Важливість перестановкою треба міряти на відкладеній вибірці.
Джерело: scikit-learn · Permutation importance
Обмеження й відкриті питання
Матеріал цієї лекції молодший за решту курсу, і чесно позначити межі знання тут важливіше, ніж деінде.
Породжувальні моделі оцінюють погано. Візуальна якість зразків не є метрикою, а наявні числові показники слабко узгоджуються з людською оцінкою і майже нічого не кажуть про покриття розподілу.
Стійкість не досягнута. Змагальне навчання підвищує стійкість до конкретної моделі загрози й коштує звичайної точності. Гарантованого захисту від довільної атаки немає.
Справедливість не є технічною задачею. Формальні критерії лише перекладають на мову статистики те рішення, яке вже ухвалено змістовно; вибір між ними математика не робить.
Пояснення моделей ненадійні. Методи на кшталт важливості перестановкою показують, від чого залежить прогноз, а не чому модель так вирішила; на корельованих ознаках вони прямо оманливі.
Ширші наслідки поза межами курсу. Витрати енергії на навчання великих моделей, упевнені вигадки мовних моделей, вплив на ринок праці, авторське право на навчальні дані — усе це реальні питання, на які курс відповіді не дає.
Підсумок лекції
Породжувальна модель учить
VAE будує латентний простір, придатний для породження. Доданок KL змушує коди лягати за розподілом
GAN не має формули густини й навчається як гра. У рівновазі дискримінатор видає одну другу, а втрати обох мереж сходяться до
Дифузійна модель зводить породження до регресії шуму. Змагання немає, якість найвища, розплата — сотні кроків на одне зображення.
Висока точність не означає надійності. Збурення в 0,15 на піксель перетворює впевнену трійку на впевнену сімку; змагальне навчання допомагає, але коштує 3,4 пункту звичайної точності.
Справедливість вимірюють, а не декларують. Вилучення чутливої ознаки не прибрало розриву; три критерії на наших даних порушені всі три й одночасно виконаними бути не можуть.
Карта курсу
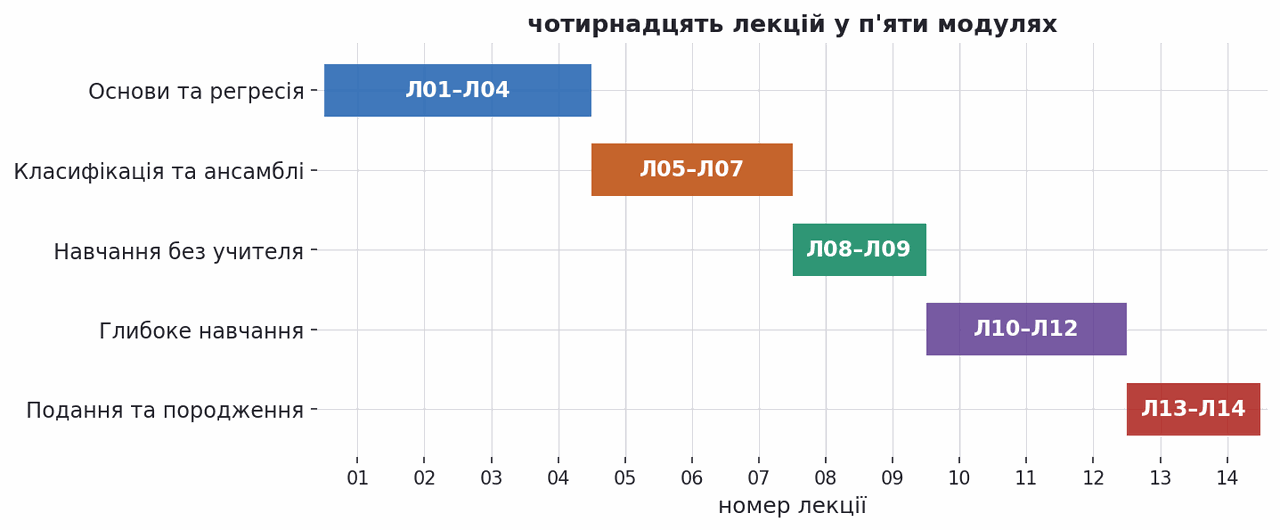
Курс пройшов повне коло. Ми почали з передбачення числа й побачили, що для цього потрібні функція втрат, оптимізація та контроль перенавчання. Класифікація додала до цього ймовірності та вимірювання якості; ансамблі показали, що з простих моделей будують сильні. Навчання без учителя зняло вимогу мати мітки: кластеризація знайшла структуру, зниження розмірності — стиснуте подання.
Нейронні мережі забрали в людини останній ручний етап — конструювання ознак; згорткові й трансформерні архітектури зробили це для зображень і тексту. Дві останні лекції замкнули коло: модель навчилася будувати подання без міток і породжувати самі дані.
Наскрізна лінія одна: кожен крок курсу передавав машині ще одне рішення, яке доти приймала людина — спершу підбір коефіцієнтів, потім вибір ознак, потім і саму постановку навчальної задачі. Остання лекція показує, чому разом із цим до інженера переходить і відповідальність за наслідки.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — Generative Models, Adversarial ML, Ethics and Fairness
- Dive into Deep Learning — розділ про GAN
Статті
- Kingma, Welling, 2013 — VAE · Goodfellow та ін., 2014 — GAN
- Ho та ін., 2020 — DDPM
- Goodfellow та ін., 2015 — FGSM · Eykholt та ін., 2018
Підручники
- Fairness and Machine Learning — Barocas, Hardt, Narayanan
- Deep Learning — розділи 14 і 20
Інструменти