Тема
Лекція 02 · Лінійна регресія та оптимізація
У першій лекції ми розібрали, з яких задач складається машинне навчання. Сьогодні побудуємо першу повноцінну модель — лінійну регресію — і три різні способи її навчити. Робочий матеріал: 20 640 округів Каліфорнії, для кожного треба передбачити медіанну вартість житла.
Зміст лекції
Лекція проходить один повний цикл: від сирих даних до навченої моделі та розбору її помилок.
- Дані й задача регресії. Набір California Housing, розподіли ознак і цільової змінної, вади реальних даних.
- Модель. Лінійна регресія з однією та багатьма ознаками, залишки, матричний запис.
- Функція втрат. MSE і MAE як два різні погляди на ціну помилки, стійкість до викидів, опуклість.
- Оптимізація. Перебір по сітці, градієнтний спуск, вибір кроку навчання, роль масштабування ознак.
- Точний розв'язок. Нормальні рівняння, межі застосовності закритої формули.
- Стохастичний градієнтний спуск. Як навчатися, коли зразків мільйони.
Порядок не випадковий: спершу з'являється модель, потім міра її помилки, і лише тоді — способи цю помилку мінімізувати.
Чого ви навчитеся
Після цієї лекції ви зможете:
- записати лінійну регресію в матричній формі й пояснити роль стовпця одиниць;
- пояснити, чим квадратична втрата відрізняється від абсолютної та в якій ситуації доречна кожна;
- вивести градієнт середньоквадратичної втрати й реалізувати градієнтний спуск на numpy;
- дібрати крок навчання і розпізнати за кривою втрат, що він завеликий або замалий;
- пояснити, чому стандартизація ознак скорочує кількість ітерацій у десятки разів;
- розв'язати нормальні рівняння через
numpy.linalg.solveі назвати випадки, коли єдиного розв'язку немає; - обґрунтувати перехід до стохастичного градієнтного спуску на великих вибірках;
- прочитати графік залишків і побачити на ньому систематичну ваду моделі.
Регресія: коли відповідь є числом
У задачі регресії (regression) модель має повернути число: ціну квартири, температуру завтра, час доставки, дозу препарату. Це відрізняє її від класифікації, де відповідь — одна з кількох категорій.
Формально нам дано
| Позначення | Значення |
|---|---|
| кількість спостережень у вибірці | |
| кількість ознак одного спостереження | |
| вектор ознак | |
| справжня відповідь для нього | |
| прогноз моделі |
Ця нотація витримана в усіх чотирнадцяти лекціях курсу. У багатьох підручниках ваги позначають через
Дані лекції: 20 640 округів Каліфорнії
Увесь матеріал лекції побудований на одному наборі даних, щоб було видно повний шлях від сирих чисел до оціненої моделі.
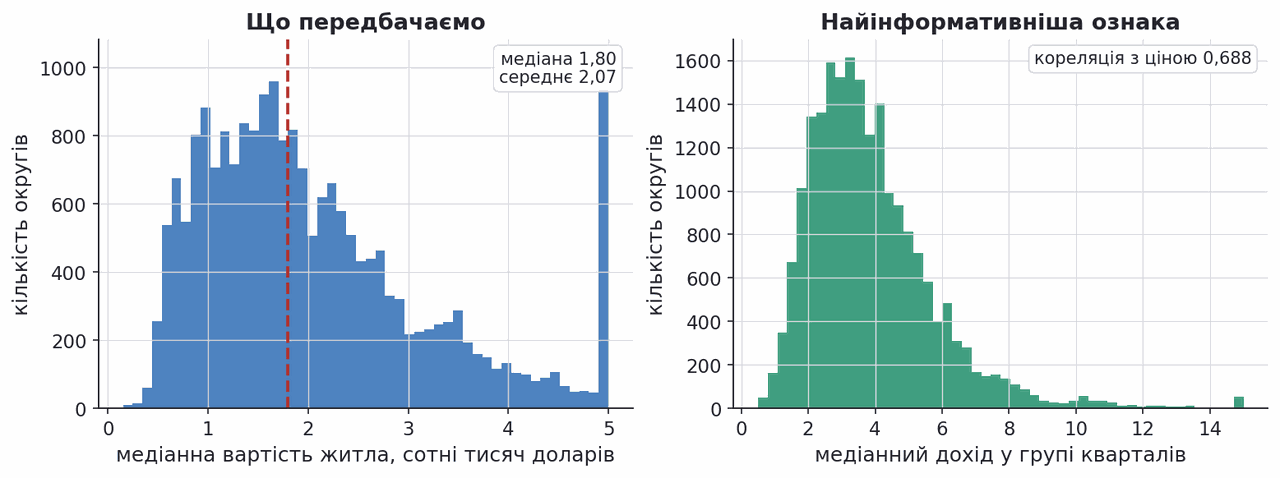
California Housing. 20 640 груп кварталів («переписних округів») за переписом населення США 1990 року, вісім числових ознак на кожну: медіанний дохід мешканців, медіанний вік будинків, середня кількість кімнат і спалень на домогосподарство, населення, середня кількість мешканців на домогосподарство, широта й довгота. Передбачаємо медіанну вартість житла в окрузі, виміряну в сотнях тисяч доларів.
Розподіл цільової змінної скошений праворуч: медіана 1,80, тобто 180 тисяч доларів, а середнє помітно вище — 2,07. Медіанний дохід — найсильніше пов'язана з ціною ознака, кореляція 0,688.
Джерело даних: scikit-learn · California Housing
Стеля 5,0: цільову змінну обрізано зверху
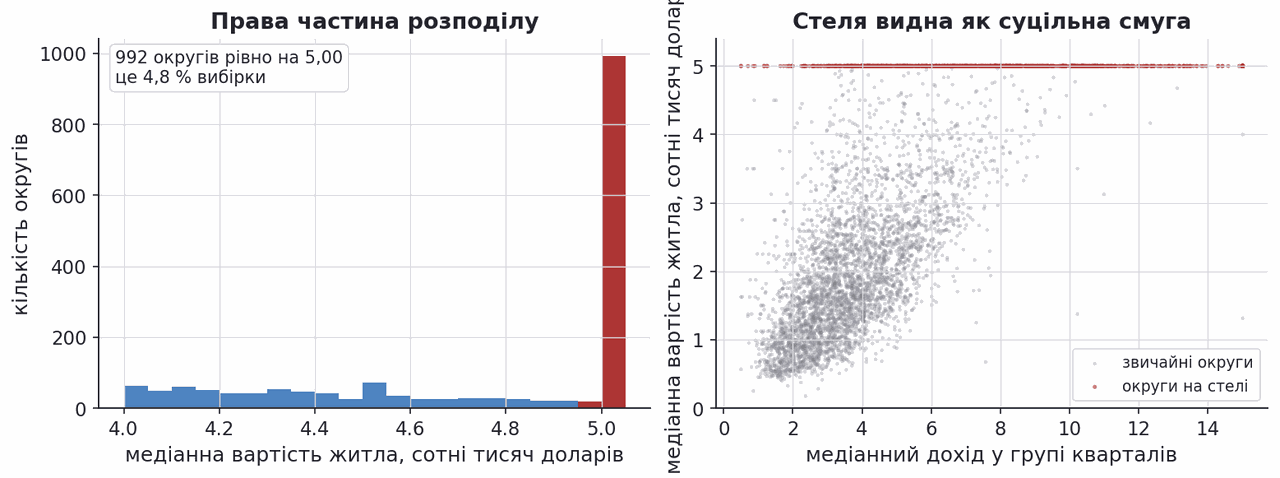
Перш ніж навчати будь-що, варто подивитися на праву частину розподілу. Там видно вертикальну стіну: 992 округи, тобто 4,8 % вибірки, впираються у стелю 5,00.
Це не природна властивість ринку, а наслідок способу збирання даних: усі округи, дорожчі за півмільйона доларів, записані одним значенням. Такий ефект називають цензуруванням (censoring), і він означає, що для найдорожчих округів справжня відповідь нам просто невідома.
Наслідок буде видно наприкінці лекції: модель систематично занижує ціну там, де вона впирається у стелю, і жодне покращення оптимізації цього не виправить. Медіанний дохід обрізано так само — 51 округ сидить на максимумі 15,0. (У сирому файлі стеля записана двома близькими значеннями, 5,0 і 5,00001, — це артефакт округлення під час підготовки набору, а не два різні рівні цін.)
Викиди: округи, яких майже не буває
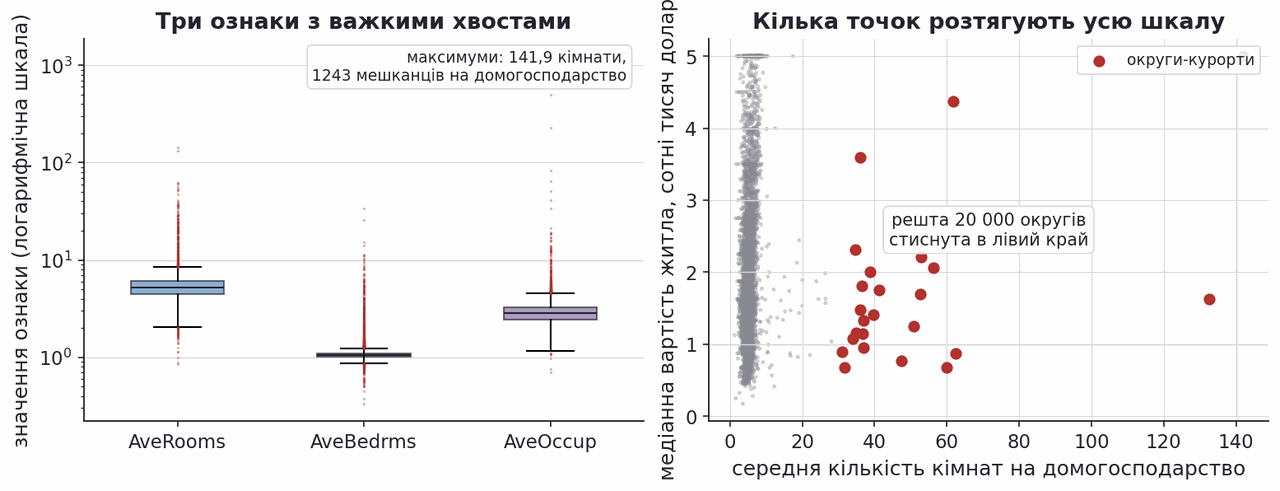
Три ознаки набору мають дуже важкі хвости. Середня кількість кімнат на домогосподарство сягає 141,9, а середня кількість мешканців — 1243. Обидва числа не є помилками: перше походить від курортного селища з тридцятьма мешканцями і майже порожнім житловим фондом, друге — від гуртожитку, де сім із половиною тисяч людей припадають на шість домогосподарств.
Викид (outlier) — це спостереження, що лежить далеко від більшості інших. Для методу найменших квадратів воно небезпечне подвійно: воно і саме дає велику помилку, і сидить далеко по осі ознаки, тому сильно тягне пряму на себе. Праворуч видно, як десяток таких округів розтягує шкалу настільки, що решта двадцять тисяч точок стискається в лівий край.
Порада «подивіться на них очима» на цьому й закінчується, а в роботі потрібне рішення. Що саме з викидами роблять — за два розділи, на тих самих даних і в числах.
Кореляційна матриця: що з чим пов'язано
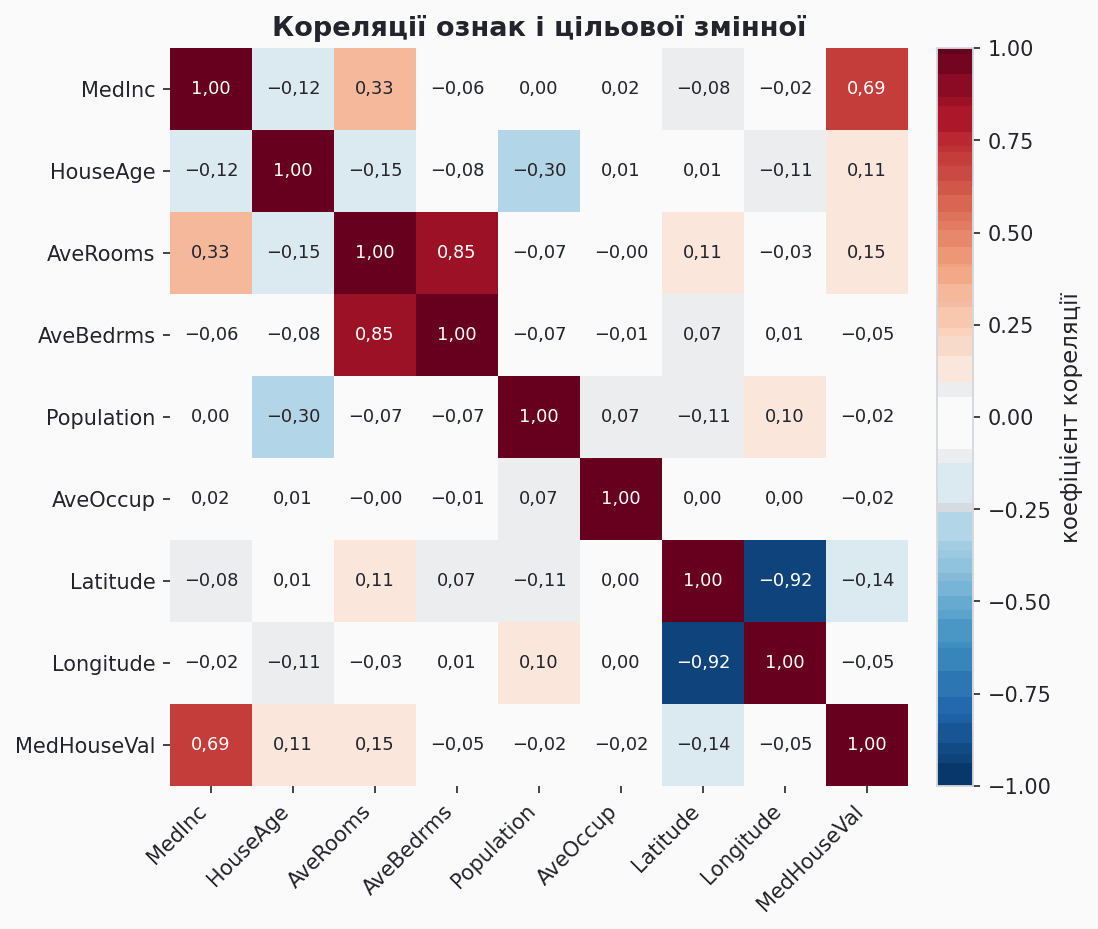
Наступний обов'язковий крок — подивитися на попарні зв'язки. Матриця кореляцій відповідає одразу на два питання: які ознаки варті уваги і які з них дублюють одна одну.
Ціна найсильніше пов'язана з медіанним доходом, 0,69. Решта ознак поодинці пояснюють мало: вік будинків дає 0,11, кількість кімнат 0,15.
Важливіші за це дві пари всередині самих ознак. Кількість кімнат і кількість спалень корелюють на 0,85, широта й довгота — на −0,92 (Каліфорнія витягнута з північного заходу на південний схід). Такі пари створюють мультиколінеарність (multicollinearity), через яку ваги моделі стають нестійкими; до цього ми повернемось після нормальних рівнянь.
Модель з однією ознакою
Найпростіша модель проводить через хмару точок пряму.
"Linear regression is a model that assumes a linear relationship between inputs and the output." — EPFL CS-433, лекція 01c
Тут
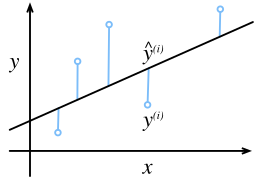
Різницю між справжнім значенням і прогнозом називають залишком (residual):
Пряма найменших квадратів на реальних даних
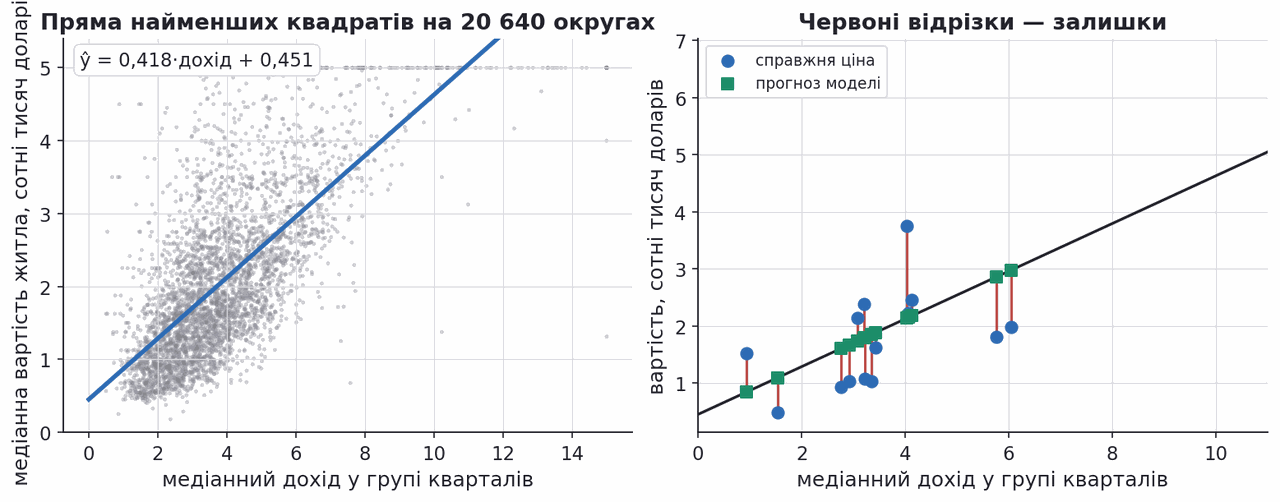
Проведемо пряму через усі 20 640 округів, узявши єдину ознаку — медіанний дохід. Результат:
Читається це так: кожна додаткова одиниця медіанного доходу піднімає прогноз ціни на 0,418 сотні тисяч доларів, тобто приблизно на 42 тисячі. Середня абсолютна помилка такої моделі — 0,626, або 63 тисячі доларів на округ.
Праворуч показано чотирнадцять випадкових округів зблизька: сині кружки — справжні ціни, зелені квадрати — прогнози, червоні відрізки між ними — залишки. Пряму підібрано так, щоб сумарна довжина цих відрізків у квадраті була якнайменшою; чому саме в квадраті — розберемо далі.
Модель із кількома ознаками
Одна ознака пояснює далеко не все. Додамо решту сім:
Компактний запис праворуч отримано простим трюком: до вектора ознак дописують одиницю,
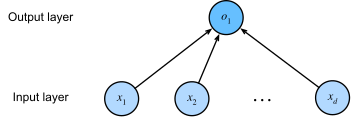
Схема праворуч показує ту саму модель у мові нейронних мереж: входи
Лінійна за параметрами, а не за ознаками
Слово «лінійна» стосується ваг, а не вхідних змінних. Ніщо не заважає подати в ту саму модель квадрат ознаки, її логарифм чи добуток двох ознак: модель залишиться лінійною за
На рисунку одну й ту саму процедуру найменших квадратів застосовано до поліноміальних ознак різного степеня і до сплайнів. Крива згинається як завгодно, хоча всередині — звичайна лінійна регресія по перетворених ознаках.
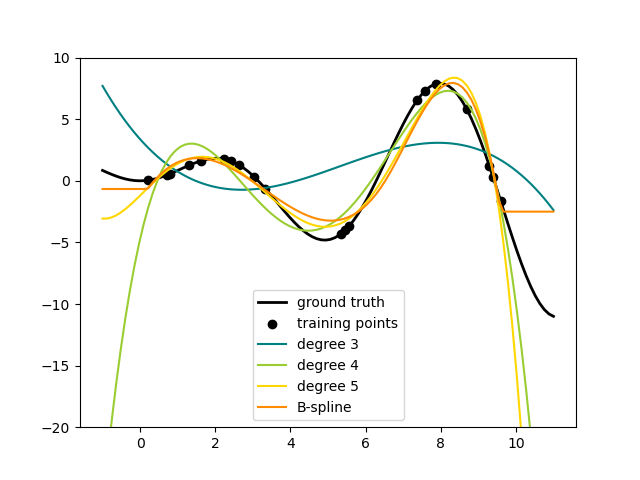
Плата за гнучкість видна вже тут: криві високого степеня починають повторювати шум замість закономірності. Це перенавчання (overfitting), і воно є темою лекції 03.
Джерело: scikit-learn · Polynomial and Spline interpolation
Функція втрат задає, що означає «добра модель»
Модель у нас є, але поки що немає жодного критерію, за яким одна пряма краща за іншу. Такий критерій називають функцією втрат.
"A loss function (or energy, cost, training objective) is used to learn parameters that explain the data well. The loss function quantifies how well our model does — or in other words how costly our mistakes are." — EPFL CS-433, лекція 01d
Від функції втрат розумно вимагати двох статистичних властивостей. По-перше, симетричності: помилка на 50 тисяч угору має коштувати стільки ж, скільки на 50 тисяч униз. По-друге, поміркованості до великих помилок: одне дике спостереження не повинно визначати всю модель.
Ці дві вимоги виконуються не одночасно, і вибір між ними визначає, яку саме модель ми отримаємо.
Середньоквадратична втрата
Найуживаніша функція втрат бере залишки, підносить до квадрата й усереднює.
| Позначення | Значення |
|---|---|
| вектор залишків, по одному на спостереження | |
| сума квадратів залишків | |
| усереднення, щоб втрата не залежала від розміру вибірки | |
| зручність: двійка скоротиться при диференціюванні |
Множник одна друга — суто технічна деталь. У частині джерел середньоквадратичну втрату (mean squared error, MSE) пишуть без нього; на положення мінімуму це не впливає, тому далі скрізь використовуємо запис із
Числовий приклад на трьох округах із залишками
Форма штрафу вирішує все
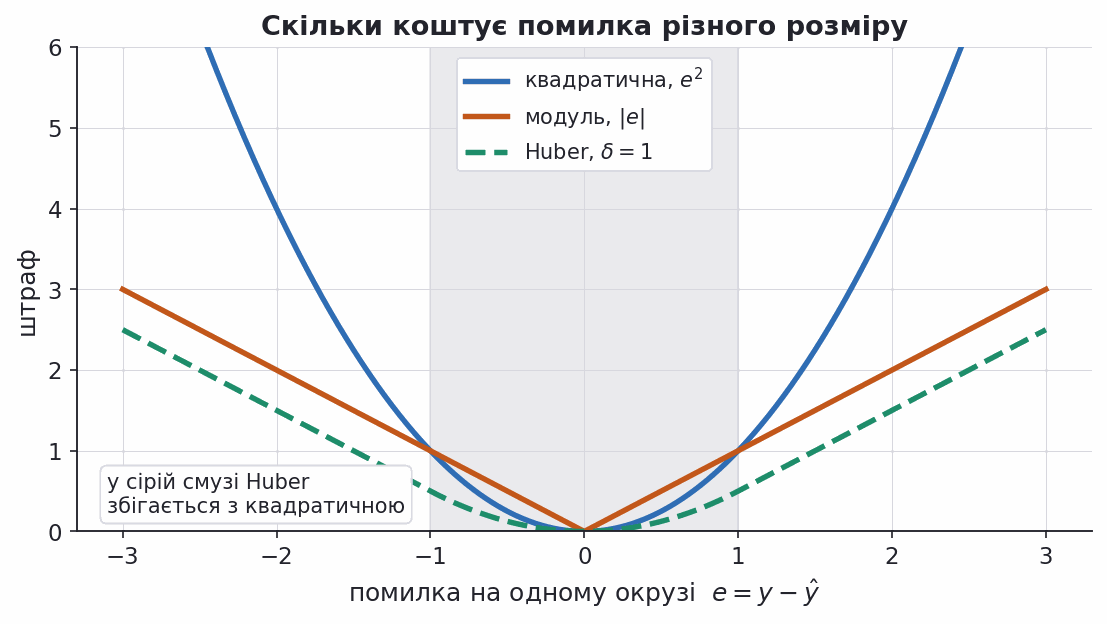
Порівняємо три способи перетворити залишок на штраф. Квадратична втрата
При
Середня абсолютна втрата (mean absolute error, MAE) від цієї вади вільна, але має свою: у нулі вона не диференційовна, тому звичайний градієнт для неї не визначений і доводиться користуватися субградієнтом.
Один викид зсуває мінімум
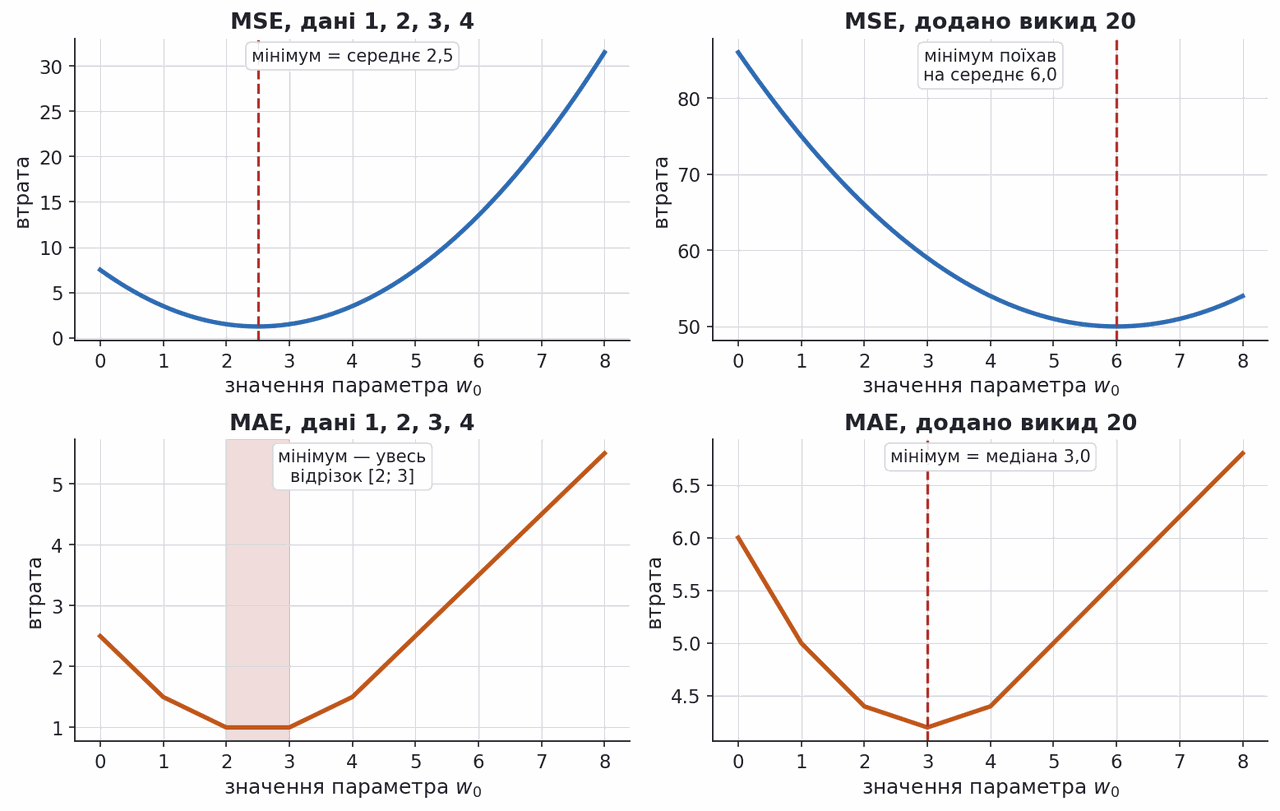
Найпростіша модель узагалі не має ознак: вона всім передбачає одне й те саме число
Квадратична втрата мінімальна в точці 2,5 — це середнє арифметичне. Абсолютна втрата має мінімумом весь відрізок від 2 до 3, і будь-яка точка з нього однаково добра; за домовленістю беруть медіану.
Тепер додамо п'яте значення 20. Мінімум квадратичної втрати їде на 6,0 — модель відходить від усіх чотирьох звичайних спостережень, аби трохи наблизитися до одного дикого. Мінімум абсолютної втрати зсувається лише до 3,0 і залишається серед даних.
Куди поїде мінімум, якщо потягнути викид
Чотири спостереження — 1, 2, 3, 4 — і п'яте, яке ви пересуваєте самі. Модель без ознак: усім передбачає одне число, тож уся задача — знайти мінімум втрати по цьому числу.
MSEMAEХубер
6,00мінімум MSE — середнє
3,00мінімум MAE — медіана
3,00мінімум Хубера, δ = 1,00
Тягніть п'яте значення від 4 до 20 і дивіться на перші два числа. Мінімум квадратичної втрати їде слідом за викидом: він завжди дорівнює середньому, а середнє тягнеться за будь-яким одним спостереженням як завгодно далеко. Мінімум абсолютної втрати дорівнює медіані й лишається серед даних — на 3,0, хоч би куди поїхав викид. Хубер стоїть посередині: при малому δ він майже повторює MAE, при великому зливається з MSE. Саме тому вибір функції втрат — це рішення про те, скільки влади ви віддаєте найдальшій точці.
Стійка пряма на даних із викидами
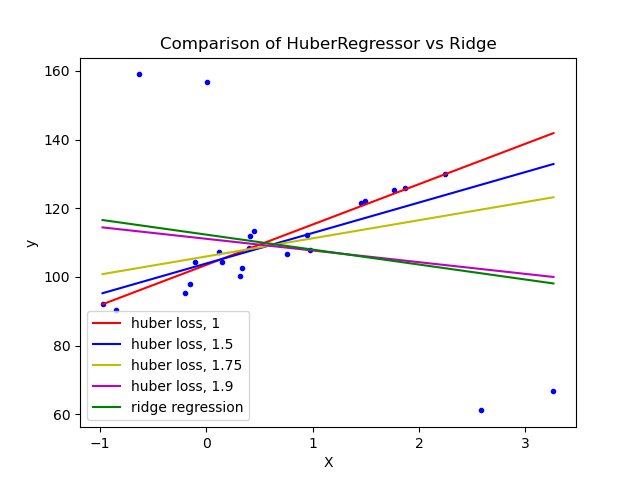
Той самий ефект на двовимірних даних. Зелена пряма — звичайні найменші квадрати — розвертається до чотирьох викидів; прямі за втратою Хубера тримаються тренду. Параметр epsilon) задає, з якої помилки починається аномалія.
Тепер те саме на наших двадцяти тисячах округів — чотири способи поруч:
| Спосіб | MAE на тесті | Вага при AveOccup |
|---|---|---|
| МНК | 0,535 | −0,031 |
| Хубер | 0,533 | −0,761 |
| RANSAC | 0,530 | −0,370 |
| обрізання 1 % | 0,623 | −0,271 |
Точність майже не змінилася, і це головне: стійкі методи купують тут не якість, а правильну інтерпретацію. МНК каже, що кількість мешканців на домогосподарство на ціну майже не впливає — вага −0,031. Але цю вагу він отримав, підлаштовуючись під гуртожиток із 1243 мешканцями; щойно Хубер зменшує внесок таких округів, проступає справжня залежність — чим тісніше живуть, тим дешевше житло.
Останній рядок застерігає: обрізання хвостів прибрало 330 округів і погіршило помилку до 0,623.
Джерело: scikit-learn · HuberRegressor vs Ridge
Опуклість прибирає погані локальні мінімуми
Те, що ми щойно виміняли на стійкість, має точну назву. Функція
"A strictly convex function has a unique global minimum. For convex functions, every local minimum is a global minimum." — EPFL CS-433, лекція 01d
Для нас це означає таке: у лінійної регресії з квадратичною втратою немає поганих локальних мінімумів — кожен локальний мінімум є глобальним. Сума опуклих функцій опукла, а квадрат лінійної функції опуклий, тому вся втрата опукла за
Обережність: опуклість не дає єдиності точки мінімуму — для цього потрібен повний стовпцевий ранг
Абсолютна втрата теж опукла; втрачається лише гладкість.
Перебір по сітці не масштабується
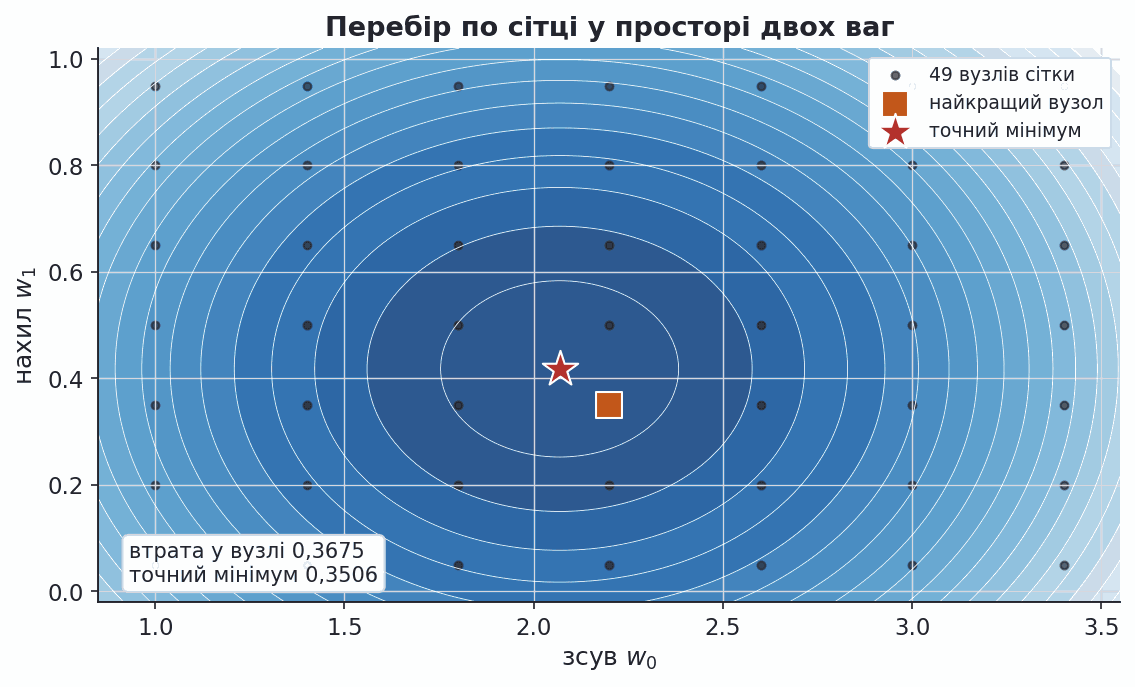
Найпряміший спосіб знайти ваги — перебрати їх: накриваємо простір параметрів сіткою, рахуємо втрату в кожному вузлі й беремо найкращий. На рисунку так шукають дві ваги моделі з однією ознакою: сітка 7 × 7 дає 49 вузлів і втрату 0,3675 проти точного мінімуму 0,3506.
Проблема в тому, що десять значень на кожен вимір при
Йдеться про перебір самих ваг моделі, а не гіперпараметрів — це різні речі з однаковою назвою.
Градієнт вказує напрям найшвидшого зростання
Замість перебору скористаємося похідними.
"A gradient (at a point) is the slope of the tangent to the function (at that point). It points to the direction of largest increase of the function." — EPFL CS-433, лекція 02a
Якщо градієнт показує вгору, то щоб спускатися, треба йти проти нього. Звідси градієнтний спуск (gradient descent):
Тут
Зупиняються тоді, коли норма градієнта стає малою: це означає, що ми біля критичної точки, а для опуклої задачі критична точка і є глобальним мінімумом.
Градієнт середньоквадратичної втрати
Для лінійної моделі градієнт рахується в один рядок. Продиференціюємо
Покомпонентно це виглядає ще прозоріше:
Вартість одного кроку —
Ця сама структура «прогноз мінус мітка, зважена на ознаки» повториться в логістичній регресії в лекції 05 і в нейронних мережах у лекції 10.
Градієнтний спуск на numpy
Двадцять рядків, у яких немає нічого, крім формул із попереднього розділу.
Вивід код запущено, вивід не редагувався
text
крок   0   втрата 2.8052
крок  50   втрата 0.2637
крок 100   втрата 0.2622
крок 150   втрата 0.2622
крок 200   втрата 0.2622
На що дивитися: втрата падає з 2,8052 до 0,2637 уже за 50 кроків, а далі змінюється лише четвертий знак — спуск дійшов до мінімуму.
Початкове значення 2,8052 — це втрата моделі з нульовими вагами, яка всім передбачає нуль.
Спуск у просторі ваг і в просторі даних
Один і той самий процес корисно бачити з двох боків одразу.
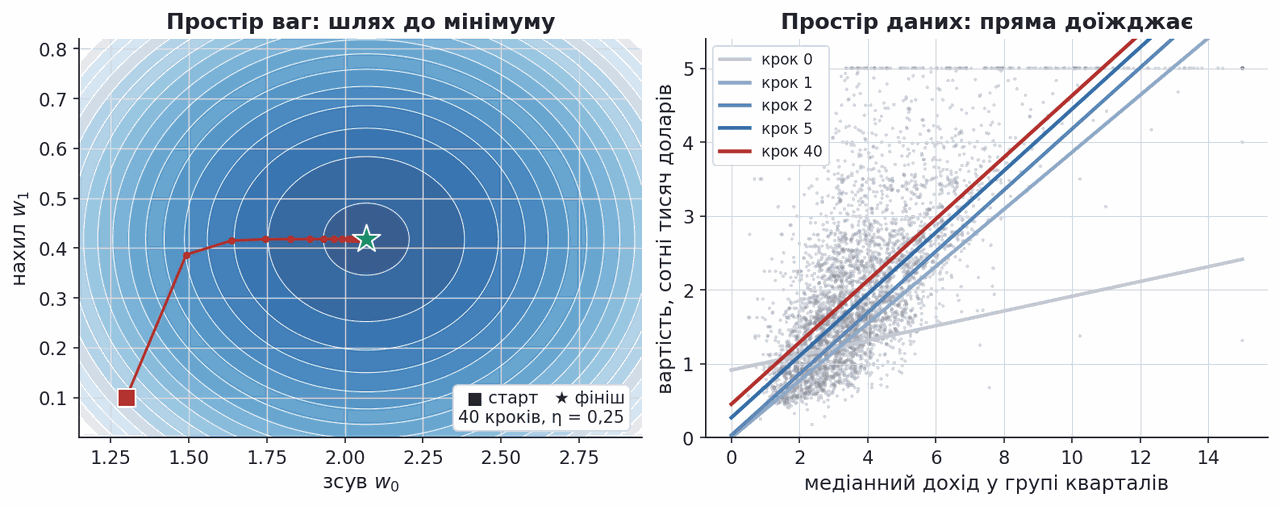
Ліворуч — простір параметрів. Кожна точка площини є парою
Праворуч — простір даних. Кожній точці лівого рисунка відповідає своя пряма. Початкова пряма майже горизонтальна, після першого кроку вона різко піднімається, а далі лише доводиться до кінцевого положення.
Втрата за ці сорок кроків впала з 0,828 до 0,3506 — того самого значення, яке дає точна формула.
Завеликий крок розхитує спуск
Крок навчання не можна взяти навмання. Класична демонстрація на функції
На рисунку показано третій випадок,
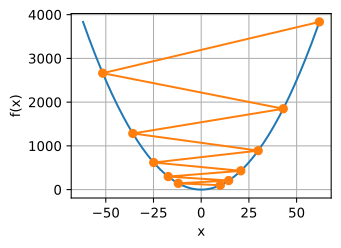
Межа стійкості залежить від кривини функції втрат, а та — від даних. Універсального «правильного» значення
Джерело: Dive into Deep Learning · Gradient Descent
Темп навчання на власних очах
Та сама демонстрація, що на рисунку: парабола f(x) = x², старт у точці x = 10. Крок спуску —
x ← x − η·f′(x) = x(1 − 2η). 0,06x після 10 ітерацій
0,60множник |1 − 2η| за крок
збігаєтьсяумова: |1 − 2η| < 1, тобто η < 1
Спуск збігається, поки множник за крок менший від одиниці. Для параболи це дає точну межу η < 1; за η = 0,5 мінімум береться за один крок, а далі кожен крок перестрибує його все далі. Для реальної функції втрат кривина залежить від даних — перемкніть режим і подивіться, що з цього виходить.
Крива втрат показує, чи вдалий крок
Підбирати
Замалий крок дає повільне, майже пряме спадання, яке не встигає дійти до мінімуму. Вдалий крок дає швидке падіння з виходом на пласке плато. Завеликий крок спричиняє передчасну зупинку на високому рівні: спуск скаче через мінімум і не може в нього потрапити. Зовсім великий крок веде до зростання втрати аж до переповнення.
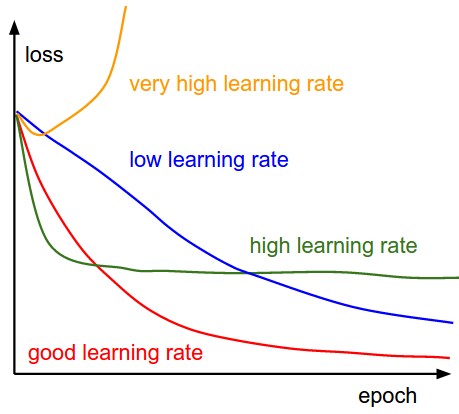
Практичне правило: будувати цю криву завжди, з першого ж запуску. Вона коштує один рядок коду і рятує години здогадок про те, чому модель не вчиться.
Джерело: Stanford CS231n · Neural Networks 3
Масштаб ознак вирішує, скільки кроків потрібно
Градієнтний спуск однаково чутливий до того, у яких одиницях виміряні ознаки. Візьмімо дві ознаки нашого набору: медіанний дохід зі значеннями порядку одиниць і вік будинків зі значеннями порядку десятків.
Ліворуч показано лінії рівня втрати для сирих ознак. Вони витягнуті у вузьку долину: число обумовленості (condition number) дорівнює 44, тобто вздовж однієї осі поверхня в сорок чотири рази крутіша, ніж уздовж іншої. Градієнт майже не має складової вздовж плаского напрямку, і спуск повзе по дну — 305 ітерацій.
Праворуч ті самі дані після стандартизації (standardization): кожну ознаку поділено на її стандартне відхилення, тож обидві мають однаковий розмах. Середнє віднято в обох випадках, тому різниця між панелями стосується саме масштабу. Лінії рівня стали майже колами, число обумовленості впало до 1,27, і того самого результату спуск досягає за 5 ітерацій.
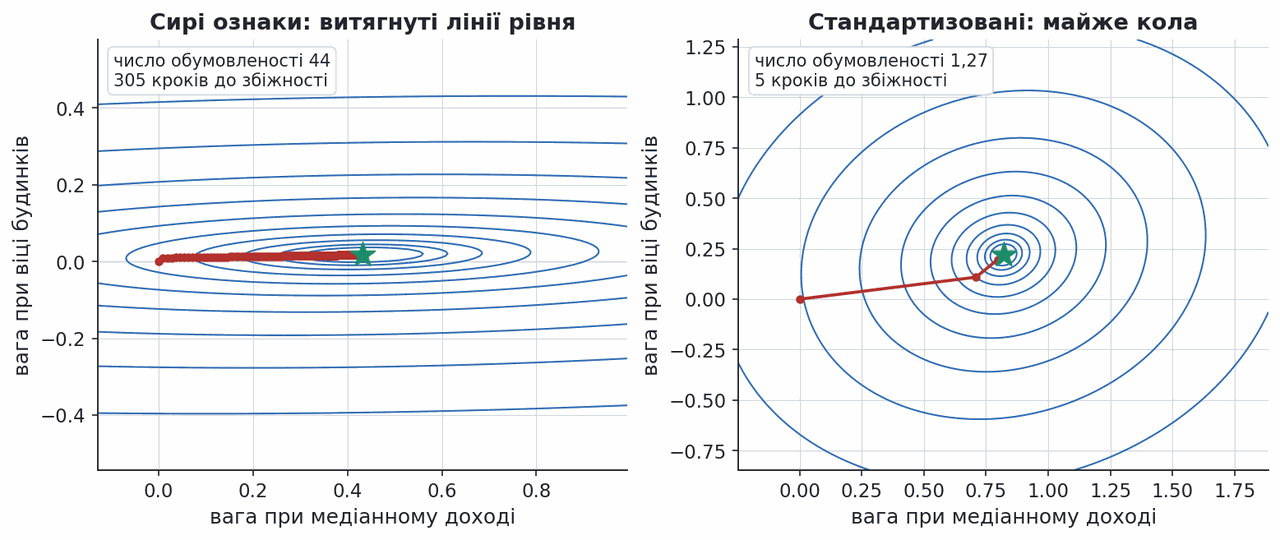
Стандартизацію завжди навчають на тренувальній частині даних і лише потім застосовують до тестової.
Нормальні рівняння: точна відповідь без ітерацій
Лінійна регресія з квадратичною втратою — рідкісний випадок, коли мінімум виписується формулою. Прирівняємо градієнт до нуля:
Ці рівності називають нормальними рівняннями (normal equations), а метод, який на них спирається, — методом найменших квадратів (least squares). Матрицю
Якщо матриця Грама оборотна, розв'язок єдиний:
Метод має довгу історію. Першим його опублікував Лежандр 1805 року. Гаусс 1809-го застосував його до обчислення орбіт небесних тіл і додав імовірнісне обґрунтування, заявивши при цьому, що користувався методом іще з 1795 року, — звідси й давня суперечка про пріоритет.
Межі застосовності закритої формули
Матриця Грама оборотна тоді й лише тоді, коли стовпці
Ознак більше, ніж спостережень. При
Ознаки майже дублюють одна одну. Формально ранг повний, але задача погано обумовлена: ваги розподіляються між схожими ознаками довільно. На рисунку показано саме це — коефіцієнти при віці й стажі, які тісно пов'язані між собою, стрибають по різних розбиттях вибірки, компенсуючи один одного.
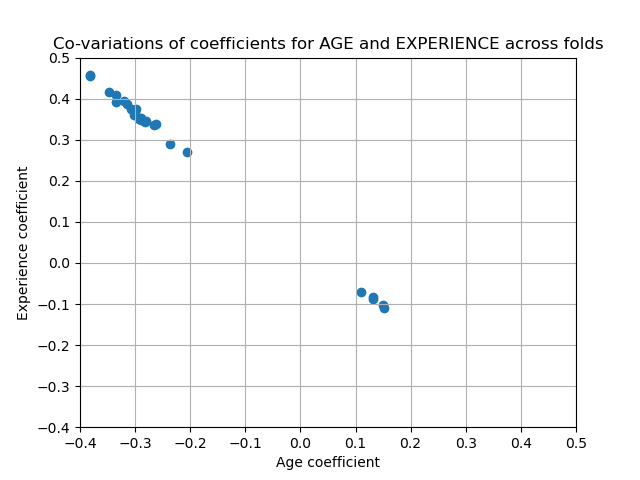
У нашому наборі така пара теж є: широта й довгота з кореляцією −0,92.
Джерело: scikit-learn · Common pitfalls in the interpretation of coefficients
Нормальні рівняння на numpy
Головне правило реалізації: ніколи не обертати матрицю явно. Лінійний солвер розв'язує систему через розклад матриці, він точніший і щонайменше втричі дешевший за обчислення оберненої.
Вивід код запущено, вивід не редагувався
text
ранг X: 9 з 9 стовпців
втрата в оптимумі: 0.2622
  MedInc      +0.830
  HouseAge    +0.119
  AveRooms    -0.266
  AveBedrms   +0.306
  Population  -0.005
  AveOccup    -0.039
  Latitude    -0.900
  Longitude   -0.871
  зсув w0     +2.069
На що дивитися: втрата 0,2622 збігається з тією, до якої дійшов спуск, а найбільші за модулем ваги мають дохід і координати округу.
Та сама модель через scikit-learn
У робочому коді ніхто не збирає матрицю Грама руками. Бібліотечна реалізація розв'язує задачу через сингулярний розклад, який коректно поводиться і з виродженими матрицями.
Вивід код запущено, вивід не редагувався
text
MSE: 0.529
MAE: 0.535
На що дивитися: MAE 0,535 означає, що прогноз ціни помиляється в середньому на 53,5 тисячі доларів; MSE 0,529 — середній квадрат тієї самої помилки.
Для порівняння: прогноз-константа, що всім видає середню ціну, дає MAE 0,907.
make_pipeline тут не косметика: стандартизація навчається лише на тренувальній частині, інакше відомості про тестову вибірку просочилися б у модель.
Джерело: scikit-learn · LinearRegression
Прогноз проти факту на відкладених округах
Кожна точка — один з 4 128 округів, яких модель не бачила; пунктир — лінія ідеального прогнозу. Хмара витягнута вздовж нього, отже головний зв'язок уловлено. Але 19 округів дістали від'ємну ціну, окремі прогнози сягають 7,16, а вздовж верхнього краю тягнеться смуга з 185 обрізаних округів.
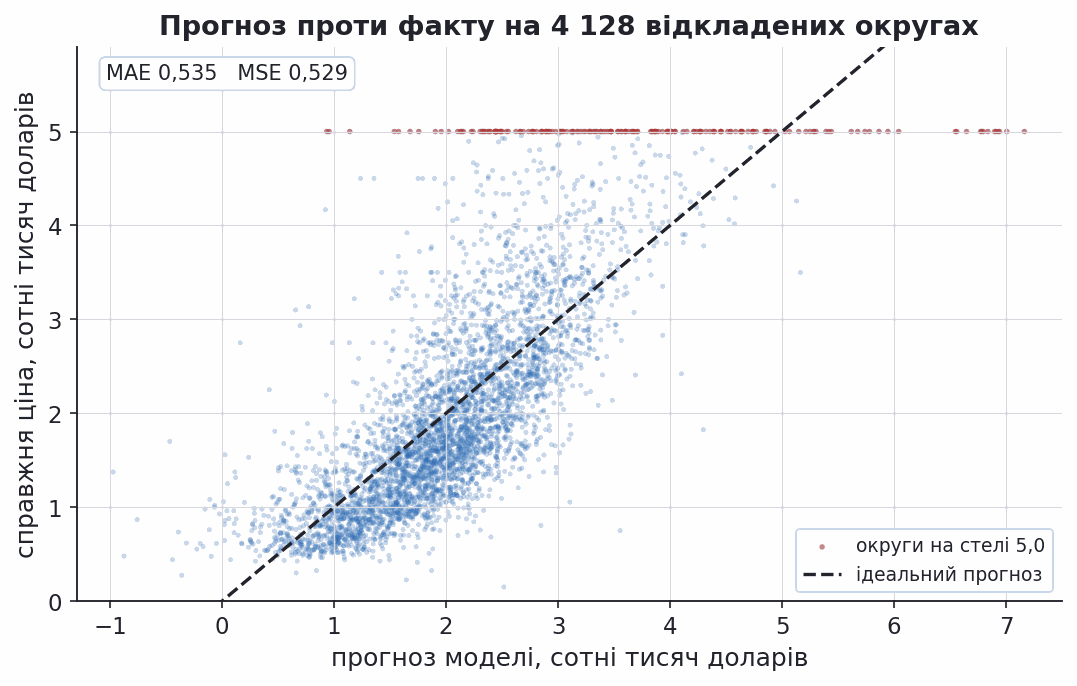
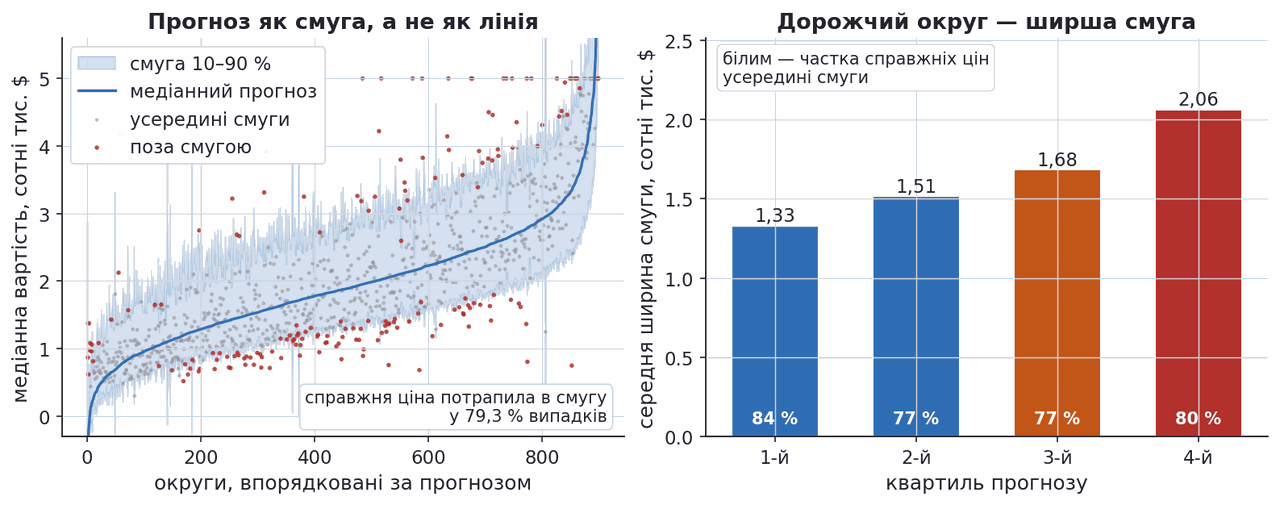
Замовникові зазвичай потрібне не одне число, а межі, у яких воно тримається. Їх дає квантильна регресія (quantile regression): замість квадрата помилки мінімізується асиметричний модуль, тож модель наближає свій квантиль ціни, а не середнє. Три моделі — на 10-му, 50-му і 90-му квантилях — дають смугу, у яку ціна має потрапляти у 80 % випадків.
Вивід код запущено, вивід не редагувався
text
покриття смуги 10-90 : 0.793
середня ширина смуги : 1.647
MAE медіанної моделі : 0.535
На що дивитися: смуга між 10-м і 90-м квантилями накрила 79,3 % тестових округів при обіцяних 80 %, а медіанна модель помиляється так само, як МНК.
Покриття 0,793 при обіцяних 0,80 — і жодного припущення про форму розподілу помилок для цього не знадобилося. MAE медіанної моделі 0,535, стільки ж, скільки в МНК: смуга дістається не ціною точності, а ціною втричі довшого навчання. Ширина смуги росте з прогнозом — 1,33 у найдешевшій чверті округів проти 2,06 у найдорожчій.
Графік залишків виявляє системну ваду
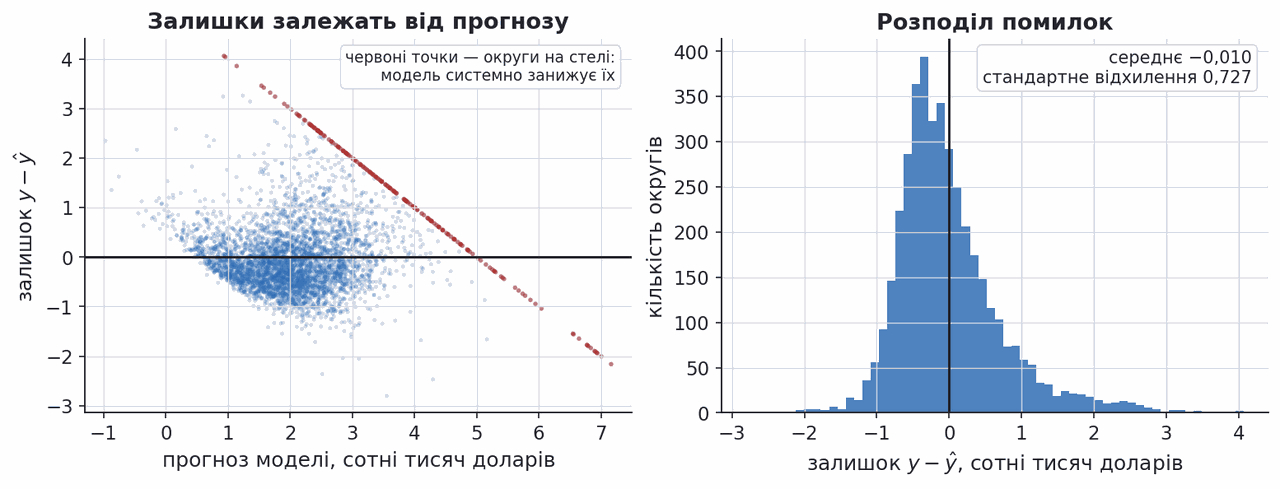
Той самий результат у координатах «прогноз проти залишку». Ідеальна картина — безструктурна хмара навколо нуля однакової товщини по всій ширині.
Ми бачимо інше. Ліворуч, де прогнози малі, залишки переважно додатні; праворуч вони йдуть у мінус — ознака того, що лінійної залежності недостатньо. Червоні точки на чіткій спадній прямій — обрізані округи: у них справжнє значення завжди 5,0, тому залишок дорівнює
Розподіл помилок праворуч має середнє
Головне тут те, що товщина хмари неоднакова: біля дешевих округів вона вужча, біля дорогих ширша. Це гетероскедастичність (heteroscedasticity), і саме через неї одне число «промахується в середньому на 53,5 тисячі» описує ситуацію погано — для дешевого округу похибка менша, для дорогого більша, а середнє не стосується жодного з них. Смуга з попереднього розділу відповідає на це прямо.
Стохастичний градієнтний спуск
Кожен крок повного градієнта коштує проходу по всій вибірці. На двадцяти тисячах округів це непомітно, на мільярді записів — неприйнятно: перш ніж зробити один-єдиний крок, треба переглянути всі дані.
Вихід підказує сама структура втрати: вона є середнім по спостереженнях,
Ціна — шум. На рисунку показано квадратичну функцію
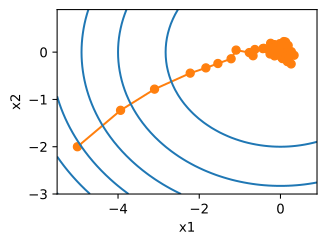
Джерело: Dive into Deep Learning · Stochastic Gradient Descent
Крок мусить спадати, але повільно
Щоб блукання припинилося, крок роблять спадним. Проте занадто швидке спадання шкодить не менше, ніж його відсутність: якщо кроки вичерпаються раніше, ніж процес дійде до мінімуму, він застрягне на півдорозі.
Саме це показано на рисунку: при експоненційному спаданні
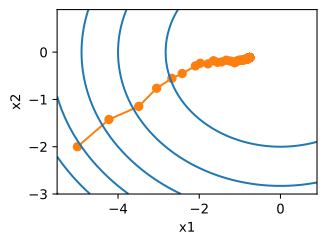
Правильний баланс задає умова Роббінса — Монро: сума кроків має розбігатися, а сума їхніх квадратів — збігатися.
Перша умова гарантує, що запасу кроків вистачить дійти куди завгодно; друга — що шум зрештою згасне. Обом задовольняє степеневе спадання
Джерело: Dive into Deep Learning · Stochastic Gradient Descent
Міні-батч: компроміс, який лягає на відеокарту
Між одним спостереженням і всією вибіркою є природна середина. Міні-батч (mini-batch) — випадкова підмножина
Обидві крайності — окремі випадки:
Головна перевага не математична, а апаратна:
Виграш від збільшення батча спадний: перехід від 1 до 2 дає багато, від 100 до 101 — майже нічого. Типові розміри — від кількох десятків до кількох сотень, і обмежує їх здебільшого обсяг пам'яті пристрою.
Повний і стохастичний градієнт на California Housing
Порівняємо обидва методи на нашій задачі чесно — за обсягом обчислень, а не за кількістю ітерацій.
Ліворуч по горизонталі відкладено проходи по всій вибірці. За цією міркою методи майже нерозрізненні: після дванадцяти проходів повний градієнт дає втрату 0,2779, стохастичний — 0,2625 при точному мінімумі 0,2617.
Праворуч по горизонталі відкладено кількість оброблених окремих зразків у логарифмічній шкалі, і картина міняється. Стохастичний спуск встигає збити втрату до 0,768 за перші тисячу зразків — на цей момент повний градієнт ще не зробив жодного кроку, бо йому потрібні всі 16 512 записів навчальної частини.
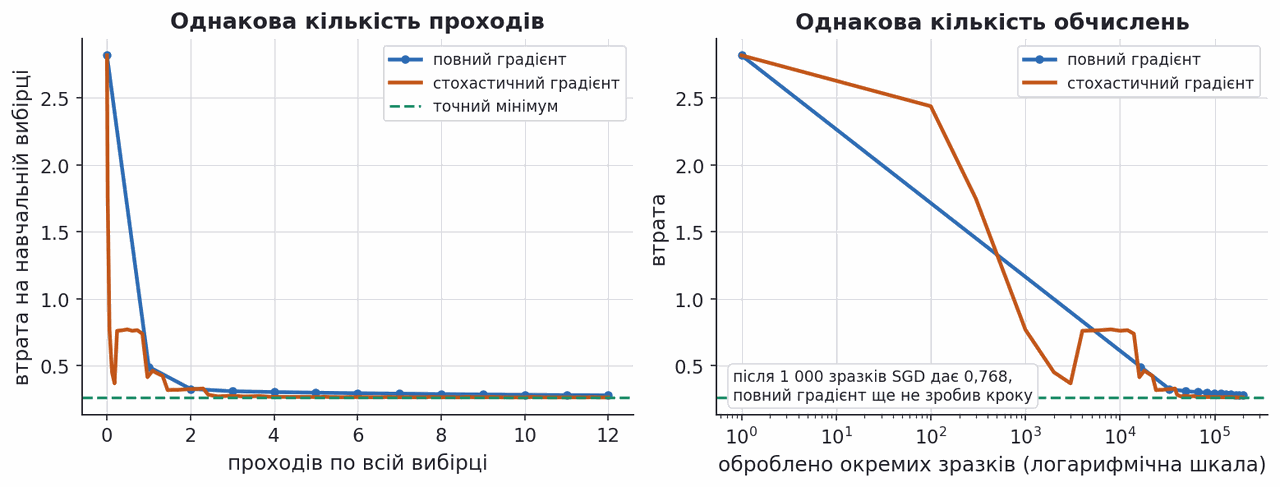
Пакетний спуск має переглянути всю вибірку, перш ніж зробити хоч один крок; стохастичний починає просуватися одразу.
Чотири способи знайти ваги
| Метод | Коли застосовний | Вартість | Слабке місце |
|---|---|---|---|
| Перебір по сітці | будь-яка втрата, один-два параметри | не масштабується, відповідь наближена | |
| Нормальні рівняння | лише лінійна модель із квадратичною втратою | вимагає повного стовпцевого рангу, важкий при великому | |
| Градієнтний спуск | будь-яка диференційовна втрата, будь-який | потрібно дібрати | |
| Стохастичний спуск | втрата у вигляді середнього по зразках | шум, потрібен розклад кроку |
Правило вибору просте. Кілька десятків ознак і кілька тисяч спостережень — беріть закриту формулу. Багато ознак або багато даних — градієнтний спуск. Дані не поміщаються в пам'ять або надходять потоком — стохастичний спуск.
Реальні ландшафти втрат не опуклі
Усе, що дала нам опуклість — єдиний мінімум і байдужість до початкової точки, — є розкішшю лінійної моделі.
На рисунку градієнтний спуск працює на функції
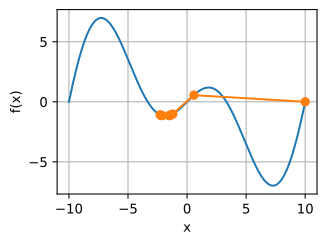
Саме з такими ландшафтами доведеться мати справу в нейронних мережах, починаючи з лекції 10. Інструментарій при цьому залишиться тим самим: градієнт, крок навчання, міні-батч. Змінюється лише те, що на гарантії глобального оптимуму більше не можна розраховувати.
Джерело: Dive into Deep Learning · Gradient Descent
Обмеження лінійної регресії
Модель бачить лише лінійні зв'язки. Криволінійну залежність вона опише тільки якщо нелінійність внести руками, через перетворені ознаки.
Квадратична втрата нестійка до викидів. Один аномальний округ здатен помітно зрушити пряму; ліки — втрата Хубера або відсів аномалій до навчання.
Прогноз нічим не обмежений. На дешевих округах наша модель видає від'ємні ціни, бо про невід'ємність вартості житла їй ніхто не казав.
Коефіцієнти важко тлумачити при корельованих ознаках. Ваги при широті й довготі великі за модулем,
Модель не виправляє вад даних. Стеля 5,0 залишиться стелею за будь-якого оптимізатора: якщо справжня відповідь у даних відсутня, вивчити її неможливо.
Підсумок лекції
Лінійна модель — це
Функція втрат — це рішення, а не даність. Квадратична зручна для обчислень, абсолютна стійка до викидів, Хубера поєднує обидві. Один викид зсунув мінімум квадратичної втрати з 2,5 на 6,0 — це й є ціна зручності.
Опуклість — головна причина, чому лінійна регресія навчається надійно. Поганих локальних мінімумів немає, тож початкова точка не важить; єдиність мінімуму дає повний стовпцевий ранг
Крок навчання і масштаб ознак важать не менше за сам алгоритм. Стандартизація скоротила шлях з 305 ітерацій до 5, не змінивши в задачі нічого, крім одиниць виміру.
Стохастичний градієнт міняє точність кроку на його ціну — і саме цей обмін робить можливим навчання на великих даних.
Гарна оптимізація не рятує від поганих даних. Наша модель промахується в середньому на 53,5 тисячі доларів, і найбільша частина цієї помилки походить не від алгоритму, а від стелі 5,0.
Джерела й додаткові матеріали
Курси, на яких побудовано лекцію
- EPFL CS-433 — лекції 01c, 01d, 02a, 03a
- UBC CPSC 340 — лекції 11, 13, 22
- Stanford CS229 — розділ 1
Підручники
- Dive into Deep Learning — розділ 3
- Bishop. Pattern Recognition and ML — розділ 3
- Boyd, Vandenberghe. Convex Optimization — розділи 3, 9
Документація й дані
- scikit-learn · лінійні моделі
- numpy.linalg.solve
- California Housing — Pace, Barry, 1997