Тема
Лекція 05 · Класифікація та логістична регресія
У попередніх лекціях модель передбачала число. Тепер вона має відповісти на питання іншого типу: до якого класу належить об'єкт. Розберемо це на реальних медичних даних — 569 пухлин молочної залози, для кожної треба вирішити, доброякісна вона чи злоякісна.
Зміст лекції
Лекція побудована як один наскрізний шлях від задачі до працюючої моделі та її оцінювання.
- Задача класифікації. Чим категоріальна мітка відрізняється від числової і що таке межа рішення.
- Чому лінійна регресія тут не працює. Три конкретні поломки і функції втрат, придатні для класифікації.
- Логістична регресія. Ланцюжок «ймовірність → шанси → логарифм шансів → лінійна модель» і сигмоїда.
- Навчання моделі. Перехресна ентропія з принципу максимальної правдоподібності, градієнт, градієнтний спуск.
- Оцінювання якості. Матриця похибок, точність і повнота, поріг, ROC-крива й AUC як частка правильно впорядкованих пар, крива точність–повнота.
- Дисбаланс класів. Метрики для рідкісного класу, поріг за ціною помилок, ваги класів, передискретизація і SMOTE, недодискретизація, фокальна втрата (focal loss) — і порівняння всіх способів на одних даних.
- Чесні ймовірності. Крива калібрування і міра Брайєра, як зважування класів псує ймовірності і як метод Платта та ізотонічна регресія їх лагодять.
- Мультиклас. One-vs-rest і softmax як узагальнення на кілька класів.
Кожен наступний блок спирається на попередній: спершу з'ясуємо, чому потрібна нова модель, потім побудуємо її, навчимо і лише тоді навчимося вимірювати, наскільки вона добра.
Чого ви навчитеся
Після цієї лекції ви зможете:
- назвати три причини, чому лінійна регресія з порогом погано розв'язує задачу класифікації;
- пояснити ланцюжок «ймовірність → шанси → логарифм шансів» і роль сигмоїди в ньому;
- пояснити, звідки береться перехресна ентропія: з принципу максимальної правдоподібності для розподілу Бернуллі;
- записати градієнт логістичної регресії і пояснити, чому він має той самий вигляд, що в методі найменших квадратів;
- побудувати матрицю похибок, ROC-криву і криву точність–повнота, прочитати їх і пояснити AUC як частку правильно впорядкованих пар;
- обрати поріг класифікації, виходячи з ціни помилки, а не за замовчуванням 0,5;
- обрати метрику для незбалансованих класів (Fβ, MCC, збалансована частка правильних, AP) і обчислити поріг за ціною помилок;
- пояснити, що змінюють ваги класів, SMOTE, недодискретизація і фокальна втрата, і порівняти їх на даних;
- перевірити калібрування кривою і мірою Брайєра та відкалібрувати модель методом Платта;
- розрізнити one-vs-rest і softmax та обрати підхід для задачі з кількома класами.
Задача: коли відповідь категоріальна
Лікар вирішує, чи є пухлина злоякісною. Банк вирішує, чи є транзакція шахрайською. Поштовий сервер вирішує, чи є лист спамом. У всіх трьох випадках відповідь не число, а одна з кількох категорій, і між категоріями немає природного порядку: «шахрайство» не більше і не менше за «норму».
Класифікація (classification) пов'язує вхід із категоріальною міткою: за новим спостереженням
"Classification relates input to a categorical variable. Goal: given a new observation x, we want to predict its label y." — EPFL CS-433, лекція 05a
Джерело: EPFL CS-433 Machine Learning
Дані лекції: діагностика пухлин молочної залози
Увесь курс лекції побудований на одному наборі даних, щоб було видно повний шлях від сирих чисел до рішення.
Breast Cancer Wisconsin (Diagnostic). 569 спостережень, 30 числових ознак. Ознаки обчислені з оцифрованого зображення пункційної біопсії: радіус, текстура, периметр, площа ядер клітин, симетрія, кількість увігнутих точок контуру та інші. Передбачаємо діагноз: доброякісна пухлина чи злоякісна.
Класи незбалансовані — доброякісних майже вдвічі більше. Це знадобиться, коли дійдемо до метрик якості.
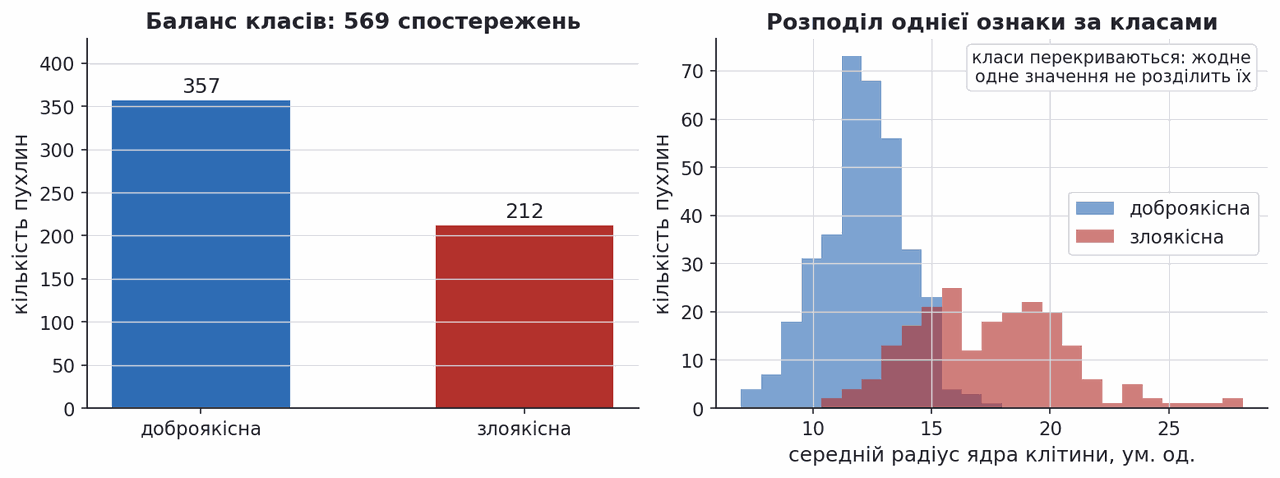
Ліворуч — скільки пухлин кожного класу, праворуч — розподіл середнього радіуса ядра в кожному класі.
Джерело даних: UCI Machine Learning Repository
Двох ознак із тридцяти вже майже досить
Перш ніж будувати модель, варто подивитися на дані очима. Візьмімо дві ознаки з тридцяти: середній радіус ядра клітини і середню кількість увігнутих точок контуру.
Злоякісні пухлини зосереджені вгорі праворуч — вони більші й мають порізаніший контур. Класи майже розділяються прямою лінією, і саме цю лінію шукатиме логістична регресія. «Майже» тут ключове слово: в зоні перекриття лежать пацієнтки, щодо яких будь-яка модель буде невпевнена, і далі ми побачимо, що з цією невпевненістю робити.
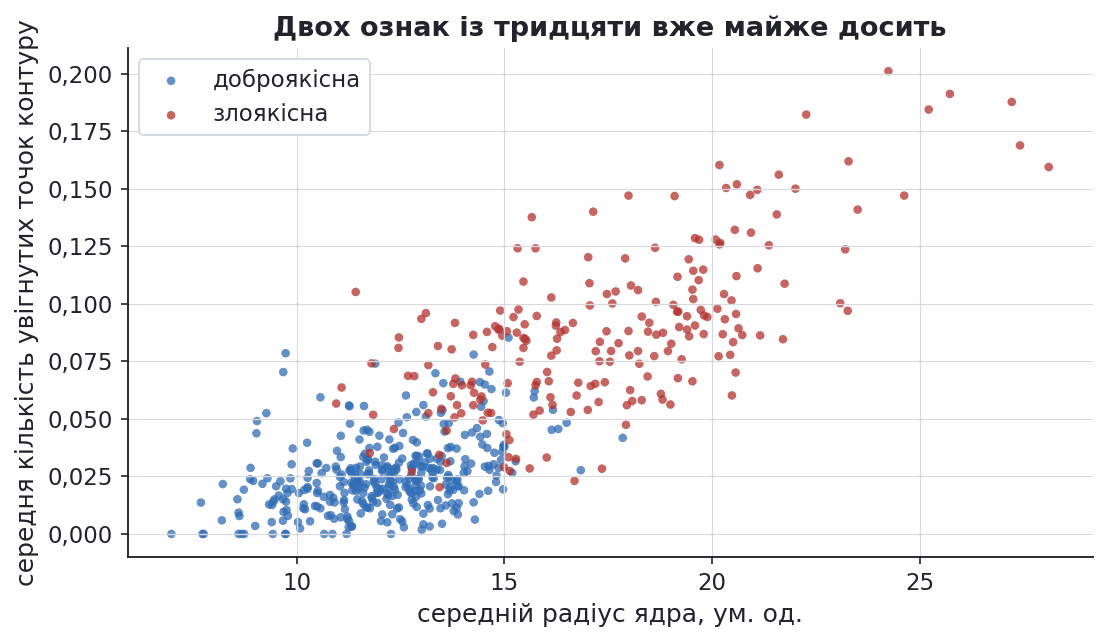
569 пухлин у координатах двох ознак; синім — доброякісні, червоним — злоякісні.
Класифікатор ділить простір ознак на регіони
Класифікатор
На рисунку нижче десять різних класифікаторів працюють на трьох однакових наборах даних. Логістичної регресії серед них немає, але лінійна SVM (Linear SVM) проводить таку саму пряму межу. Видно головне: універсального методу немає, форма межі має відповідати формі даних.
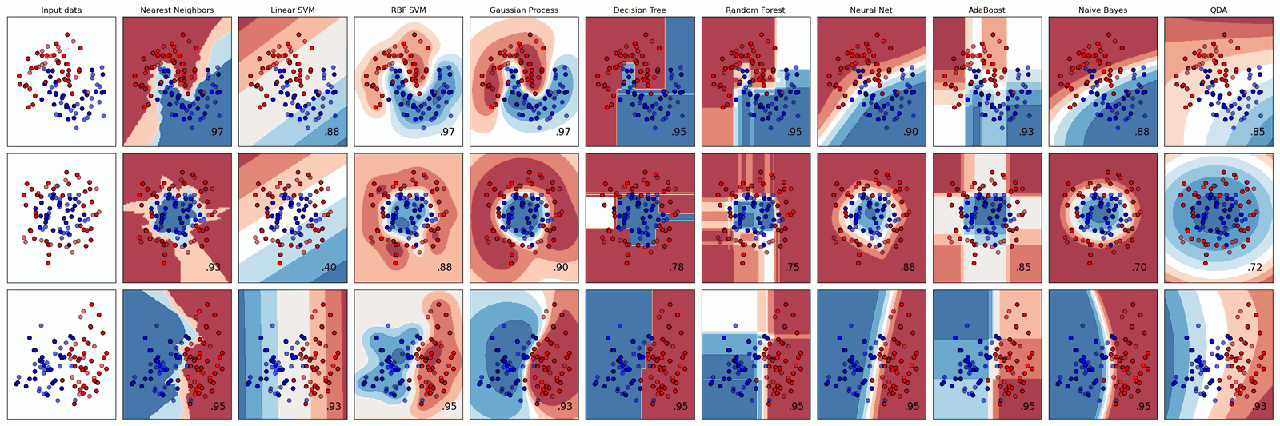
Англійські підписи: Nearest Neighbors — k найближчих сусідів, Linear SVM і RBF SVM — метод опорних векторів з лінійним і RBF-ядром, Decision Tree — дерево рішень, Random Forest — випадковий ліс, Neural Net — нейронна мережа, Naive Bayes — наївний Баєс, QDA — квадратичний дискримінантний аналіз; число в куті — частка правильних відповідей на тесті.
Джерело: scikit-learn · Classifier comparison
Спроба перша: лінійна регресія з порогом
Мітки 0 і 1 — теж числа. Найпростіша ідея: навчити звичайну лінійну регресію і оголосити клас 1 там, де прогноз перевищує 0,5.
Ліворуч видно першу поломку: прогноз лінійної моделі виходить за межі відрізка
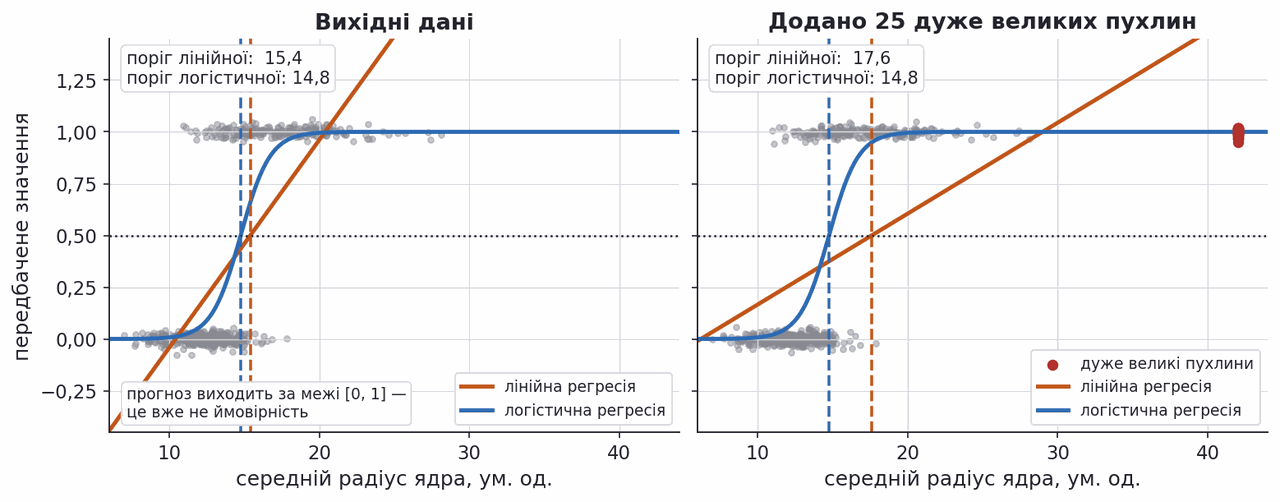
Сірі точки — пацієнтки (0 — доброякісна, 1 — злоякісна), червоні — 25 доданих дуже великих пухлин; пунктир — поріг кожної моделі.
Квадратична втрата карає впевненість
Третя поломка — і корінь двох перших — у функції втрат. Нехай істинна мітка
| Прогноз | Мітка | Втрата | Як це читати |
|---|---|---|---|
| 0,9 | +1 | 0,01 | розсудливо і правильно |
| −0,8 | +1 | 3,24 | помилка, штраф доречний |
| 100 | +1 | 9801 | правильно й дуже впевнено — а штраф найбільший |
Останній рядок і є вироком: модель, яка вгадала клас із запасом, карається сильніше за ту, що помилилася. Потрібна функція втрат, яка дивиться на бік від межі, а не на відстань від конкретного числа.
Джерело числового прикладу: UBC CPSC 340, лекція 18
Функції втрат, придатні для класифікації
Що ми насправді хочемо мінімізувати — це частку помилок, тобто нуль-одиничну втрату (zero-one loss). Вона розривна й неопукла, тому напряму мінімізувати її неможливо. Замість неї беруть опуклу сурогатну втрату (surrogate loss), яка з точністю до сталого множника не нижча за нуль-одиничну, тобто є верхньою оцінкою частки помилок: зменшуючи її, ми опускаємо цю оцінку.
Усі такі втрати зручно записати через одну величину. Нехай
У клітинках — значення втрати для двох прикладів відступу; це не мітки класів.
| Втрата | Формула | втрата при | втрата при |
|---|---|---|---|
| нуль-одинична | 0 — помилки немає | 1 — помилка | |
| логістична | 0,127 | 1,313 | |
| hinge | 0 | 2 | |
| квадратична | 1 | 4 |
Тут
При
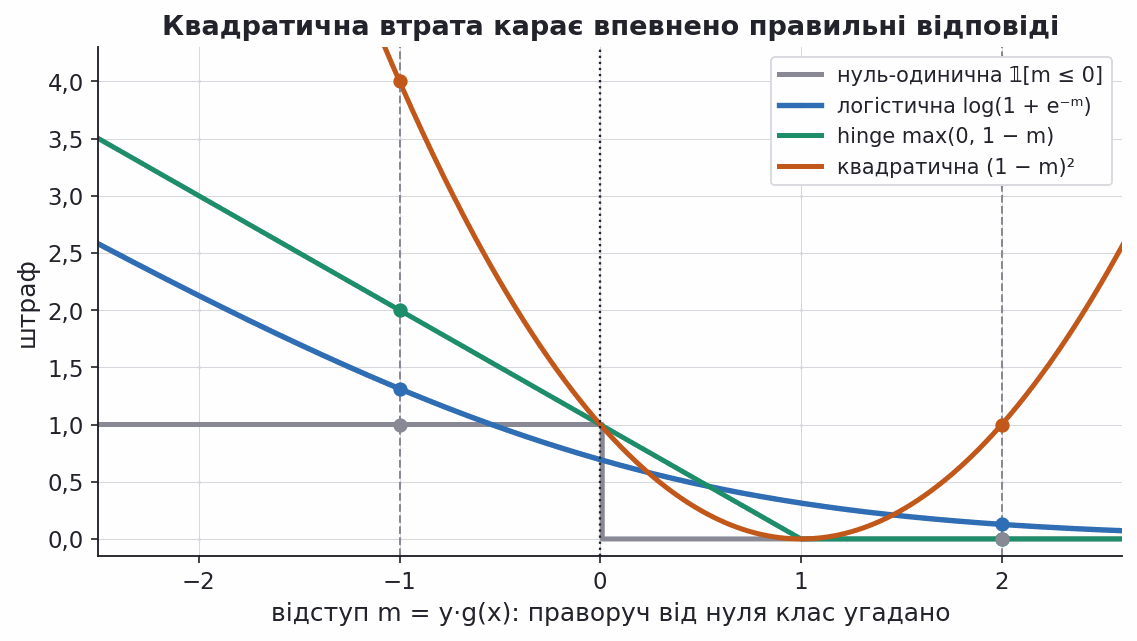
Вертикальні пунктири — відступи 2 і −1 із таблиці. У нулі логістична втрата дорівнює log 2 ≈ 0,693: стільки ж дає модель, яка всім ставить імовірність 0,5.
Логістична втрата веде до логістичної регресії, hinge — до методу опорних векторів, який розберемо в лекції 07. Віджет нижче рахує всі чотири втрати для будь-якого відступу.
Чотири втрати для одного відступу
Відступ m = y·g(x) додатний, коли клас угадано, а його модуль — упевненість. Посуньте повзунок і подивіться, яка втрата скільки штрафує.
| втрата | формула | значення втрати при m = 2,00 |
|---|---|---|
| нуль-одинична | 𝟙[m ≤ 0] | 0,000 |
| логістична | log(1 + e⁻ᵐ) | 0,127 |
| hinge | max(0, 1 − m) | 0,000 |
| квадратична | (1 − m)² | 1,000 |
Поставте m = 2: відповідь правильна й упевнена, логістична втрата майже нуль (0,127), hinge — рівно нуль, а квадратична все одно штрафує на 1. Далі праворуч квадратична тільки росте — вона карає модель за зайву впевненість. При m = −1 модель помилилася, і штрафують усі чотири. На самій межі, m = 0, логістична втрата дорівнює log 2 ≈ 0,693 — тій самій втраті, з якої починає спуск у коді «з нуля», коли всім приписано ймовірність 0,5.
Від імовірності до необмеженої шкали
Лінійна модель
Шанси (odds)
Логарифм переводить додатні шанси, тобто інтервал
Тепер лінійна модель і величина, яку вона моделює, живуть на одній шкалі:
"Trick: don't deal with probabilities ∈ [0,1], but with log odds ∈ ]−∞,∞[." — EPFL CS-433, лекція 05b
Сигмоїда повертає нас до ймовірності
Розв'язавши рівняння логіта відносно
| Позначення | Значення |
|---|---|
| лінійна комбінація ознак, логарифм шансів | |
| ймовірність класу 1 | |
| ймовірність класу 0 | |
| похідна, знадобиться в градієнті |
Сигмоїда монотонна, гладка і симетрична відносно точки
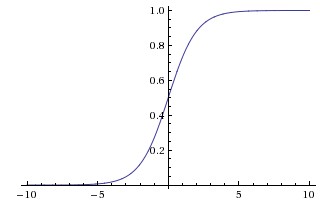
Джерело: Stanford CS231n · Neural Networks
Модель логістичної регресії
Складаємо все разом. Логістична регресія (logistic regression) задає ймовірність класу так:
Клас 1 обирають, коли
Попри назву, логістична регресія — метод класифікації. Назва історична: регресією тут є моделювання логарифма шансів.
Геометрія: напрям вектора ваг і впевненість
Три властивості моделі, які варто бачити очима.
Межа рішення — гіперплощина
Вектор
Перевіримо це на моделі з рисунка: логістична регресія на двох стандартизованих ознаках — радіусі й увігнутих точках, — навчена на 398 пацієнтках навчальної частини.
Вивід код запущено, вивід не редагувався
text
w = (1.808; 3.323), w0 = -0.389, ‖w‖ = 3.783
A = (-1.000; 0.661), B = (1.000; -0.427), w·(B − A) = 0.0e+00
пацієнтка: g(x) = 2.744, d = 0.725, p = 0.940
на відстані d = 0,5 від межі: p = 0.869
На що дивитися: w = (1,808; 3,323) і w₀ = −0,389 задають межу 1,808·x₁ + 3,323·x₂ − 0,389 = 0; добуток w·(B − A) дорівнює нулю — w перпендикулярний межі; вибрана пацієнтка лежить на відстані 0,725 від межі й отримує p = 0,940.
Звідки перпендикулярність. Межа — це множина точок, де
і код показує це числом: добуток дорівнює нулю з точністю до похибки округлення. Отже,
Пацієнтка, позначена на рисунку, лежить по злоякісний бік:
Модуль
На рисунку ліворуч — дискретне рішення, праворуч — неперервна карта ймовірності тієї самої моделі. У віджеті під рисунком можна пройти весь ланцюжок «відстань → логіт → шанси → імовірність» і змінити
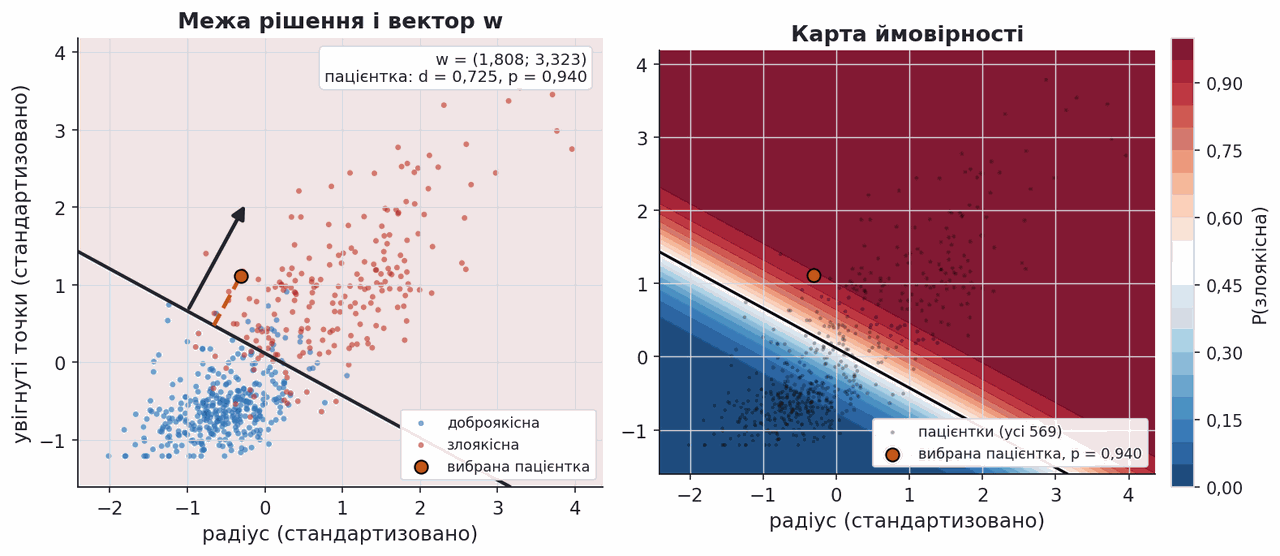
Модель на двох стандартизованих ознаках — радіусі й увігнутих точках; показано всіх 569 пацієнток. Чорна лінія — межа, де ймовірність дорівнює 0,5; стрілка — напрям вектора w (довжину вкорочено), пунктир — перпендикуляр від вибраної пацієнтки до межі.
Від відстані до ймовірності
Точка на відстані d від межі отримує логіт z = ‖w‖·d, шанси ez й імовірність σ(z). Логарифм шансів повертає назад той самий z.
2,000логіт z = ‖w‖·d
7,389шанси ez = p/(1 − p)
0,881імовірність p = σ(z)
2,000log(p/(1 − p)) — знову z
Сіра крива — ‖w‖ = 1, синя — поточна довжина. Натисніть «p = 0,9»: шанси дорівнюють 9, а логіт — log 9 = 2,197. «z = 2» і «z = −2» дають 0,881 і 0,119 — симетрично відносно 0,5. Тепер лишіть d = 1 і збільшуйте ‖w‖: при ‖w‖ = 1 точка отримує 0,731, при ‖w‖ = 5 — уже 0,993. Межа рішення (d = 0) при цьому не рухається: довжина вектора ваг змінює лише те, як різко модель перемикається з «ні» на «так», тобто її впевненість. Остання кнопка ставить довжину вектора ваг нашої моделі з рисунка, 3,783: уже на відстані 0,5 від межі ймовірність 0,869.
Максимальна правдоподібність задає функцію втрат
У лекції 04 ми бачили загальний принцип: обираємо параметри, за яких спостережені дані найімовірніші. Мітка тут приймає два значення, тому природна модель — розподіл Бернуллі з параметром
Множник читається просто: якщо
Добутки з сотень співмножників незручні чисельно, тому переходять до логарифма і міняють знак — максимізація перетворюється на мінімізацію.
Перехресна ентропія
Логарифм добутку дає суму, а зміна знака робить із неї функцію втрат — перехресну ентропію (cross-entropy, вона ж негативна логарифмічна правдоподібність):
| Позначення | Значення |
|---|---|
| кількість спостережень у вибірці | |
| справжня мітка | |
| ймовірність класу 1, яку дала модель | |
| штраф: прямує до нуля при впевненій правильній відповіді і до нескінченності при впевненій помилковій |
Це та сама логістична втрата з розділу про функції втрат: при
На кожному спостереженні працює рівно один доданок — той, що відповідає справжній мітці. Модель, яка сказала «ймовірність злоякісності 0,99» для злоякісної пухлини, отримує штраф
Числовий приклад: перехресна ентропія на п'яти пухлинах
Візьмімо п'ять спостережень з умовними прогнозами — числа підібрано для прикладу, а не взято з моделі — і подивимось, як рахується втрата. Справжні мітки: 1, 1, 0, 0, 0 (одиниця — злоякісна).
| Пухлина | Мітка | Прогноз | Внесок у втрату |
|---|---|---|---|
| 1 | 1 | 0,97 | |
| 2 | 1 | 0,82 | |
| 3 | 0 | 0,38 | |
| 4 | 0 | 0,08 | |
| 5 | 0 | 0,01 |
Середнє значення:
Для орієнтиру: модель, яка нічого не вивчила і всім ставить 0,5, дає втрату
Градієнт має той самий вигляд, що в методі найменших квадратів
Щоб мінімізувати перехресну ентропію, потрібна її похідна за вагами. Викладка коротка, бо в сигмоїди зручна похідна. Із
наприклад, при
Множник
Порівняйте з градієнтом методу найменших квадратів із лекції 02:
Перевіримо формулу числом на пацієнтці з попереднього розділу: порахуємо
Вивід код запущено, вивід не редагувався
text
σ(z) = 0.9396, σ′(z) = σ(1 − σ) = 0.0568
аналітичний (σ − y)·x: [ 0.019  -0.0673 -0.0604]
чисельний:             [ 0.019  -0.0673 -0.0604]
На що дивитися: аналітичний градієнт (σ − y)·x і чисельна похідна збігаються до четвертого знака; σ′ у цій точці лише 0,0568, бо пацієнтка далеко від межі, а найбільша похідна сигмоїди, 0,25, — у нулі.
Є й важлива відмінність: рівняння
Функція втрат опукла, тому градієнтний спуск працює
Перехресна ентропія логістичної регресії — опукла функція ваг: її поверхня має форму чаші без западин збоку. Тому в неї немає поганих локальних мінімумів — кожен локальний мінімум є глобальним.
Практичний наслідок важливий: градієнтний спуск не застрягає в поганій точці, і «невдалих ініціалізацій», з якими ми зіткнемось у нейронних мережах, тут немає.
Дві обережності. Опуклість не гарантує, що мінімум досягається в одній-єдиній точці. І сам мінімум може взагалі не досягатися за скінченних ваг — саме цей випадок розбирає розділ «Лінійно роздільні дані ламають оптимізацію».
На рисунку — справжня поверхня втрат моделі на двох стандартизованих ознаках, радіусі й увігнутих точках, без зсуву. Кожен крок градієнтного спуску зсуває ваги проти градієнта:
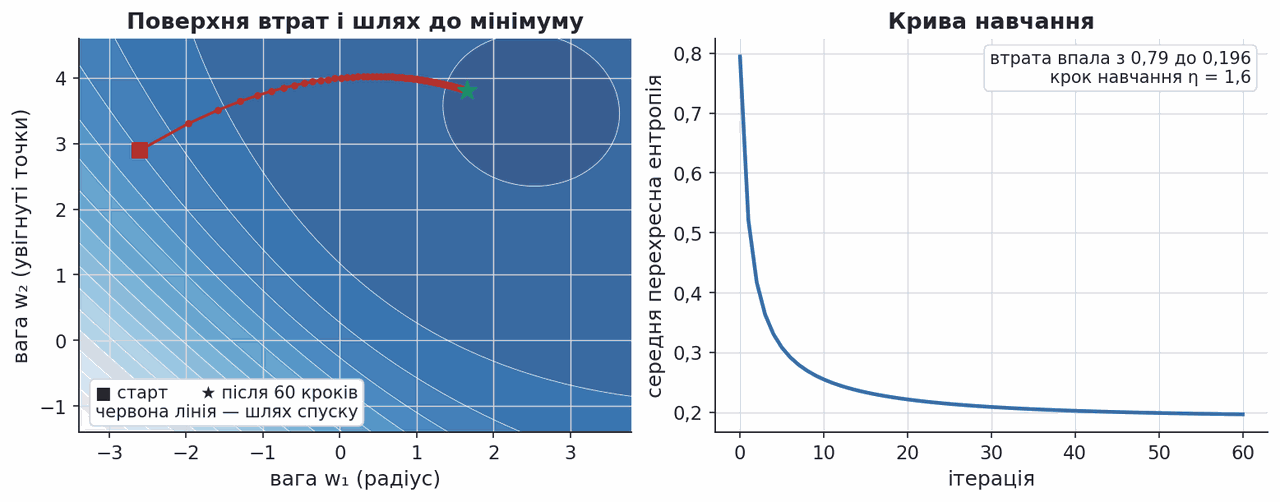
Ліворуч — лінії рівня втрат і шлях спуску, праворуч — та сама втрата по ітераціях.
Градієнтний спуск на справжній поверхні втрат
Модель на двох стандартизованих ознаках (середнє 0, відхилення 1) — радіусі й увігнутих точках, без зсуву. Кожен крок: w ← w − η·∇𝓛(w). Старт і крок η = 1,6 — ті самі, що на рисунку.
крок навчання η:
0крок
(−2,600; 2,900)ваги w
0,794втрата 𝓛(w)
(−0,391; −0,253)градієнт ∇𝓛(w)
Натисніть «крок» один раз: із (−2,6; 2,9) і градієнта (−0,391; −0,253) спуск переходить у (−1,974; 3,304), а втрата падає з 0,794 до 0,521 — ті самі числа, що в тексті. «До 60-го кроку» дає 0,196, як на рисунку. Тепер поставте η = 0,3: спуск іде тим самим напрямом, але вп'ятеро повільніше, і за 60 кроків втрата лише 0,252. При η = 5 уже за 60 кроків маємо 0,192 — нижче, ніж при 1,6: ця поверхня полога, і великий крок їй не шкодить. Так буває не завжди: на крутішій поверхні завеликий крок перескакує мінімум, і втрата починає рости, — у лекції 10 це видно на нейронній мережі.
Два способи дійти до мінімуму
| Метод | Що робить один крок | Вартість кроку | Поведінка |
|---|---|---|---|
| Градієнтний спуск | стабільний, але повільний на великих даних | ||
| Стохастичний градієнтний спуск | крок дешевий, траєкторія шумна |
Тут
Код: логістична регресія з нуля
Кілька десятків рядків numpy, щоб було видно, що всередині немає магії — лише формули з попередніх розділів.
Вивід код запущено, вивід не редагувався
text
крок   0   втрата 0.6931
крок 100   втрата 0.0685
крок 200   втрата 0.0605
крок 300   втрата 0.0568
крок 30000 втрата 0.0325, помилок на навчанні 7, ‖w‖ = 16.2
На що дивитися: втрата стартує з 0,6931 = ln 2, коли всім приписано ймовірність 0,5, і за 300 кроків падає до 0,0568, але спуск на цьому не зійшовся — див. останній рядок.
Спуск із кроком 0,5 за 300 кроків не зійшовся: навіть після 30 000 кроків втрата лише 0,0325, на навчанні лишається 7 помилок, а довжина вектора ваг ‖w‖ — усього 16,2. Це повільна збіжність, а не розбігання ваг. Розбігання — окрема тема розділу «Лінійно роздільні дані ламають оптимізацію»: воно проявляється лише за дуже довгого навчання без штрафу, і на наших даних ми його побачимо в розділі про регуляризацію.
Код: те саме через scikit-learn
У робочому коді ніхто не пише градієнтний спуск руками. Бібліотечна реалізація додає регуляризацію, кращий оптимізатор і перевірки коректності.
Вивід код запущено, вивід не редагувався
text
              precision    recall  f1-score   support

 доброякісна       0.96      0.96      0.96       107
   злоякісна       0.94      0.94      0.94        64

    accuracy                           0.95       171
   macro avg       0.95      0.95      0.95       171
weighted avg       0.95      0.95      0.95       171

ROC-AUC: 0.992
прогнозів між 0,1 і 0,9: 21 із 171
На що дивитися: рядок accuracy — частка правильних відповідей на 171 відкладеній пацієнтці, 0,95; стовпці precision, recall, f1-score і рядок ROC-AUC розберемо в розділах про оцінювання нижче.
make_pipeline тут не косметика: стандартизація має навчатися тільки на тренувальній частині, інакше інформація про тест просочиться в модель.
Джерело: scikit-learn · LogisticRegression
Масштабування ознак впливає на результат
Середній радіус лежить у межах від 7 до 28, а середня площа — від 144 до 2501. Масштаб діє двома різними шляхами, і їх варто розрізняти.
У методах, що спираються на відстані (сусіди з лекції 06, кластеризація з лекції 08), масштаб змінює саму геометрію: ознака з великим розмахом визначає, хто вважається близьким.
У лінійній моделі без регуляризації розтягнення ознаки компенсується стисненням її ваги, тож межа не змінюється — псується лише обумовленість. Але з регуляризацією (у scikit-learn вона ввімкнена за замовчуванням) масштаб визначає силу штрафу на ознаку — і межа зсувається.
Стандартизація переводить кожну ознаку в
На рисунку — перший шлях: метод k найближчих сусідів на наборі Wine, ліворуч навчений на сирих ознаках, праворуч — на стандартизованих. Той самий алгоритм, ті самі дані, інша межа. Другий шлях — через регуляризацію — рисунок не показує.
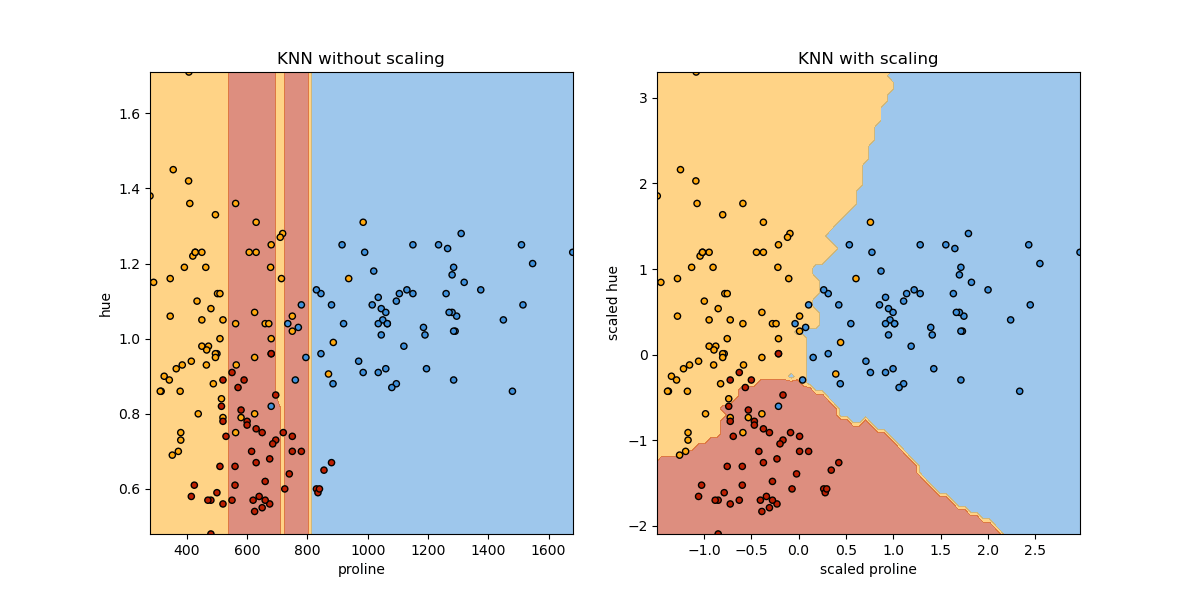
Англійські підписи: KNN without / with scaling — метод сусідів без стандартизації і з нею; осі — ознаки proline і hue набору Wine (scaled — стандартизовані).
Лінійно роздільні дані ламають оптимізацію
Якщо класи можна розділити прямою без жодної помилки, у перехресної ентропії з'являється неприємна властивість: її нижня межа нуль не досягається на жодному скінченному
Причина в тому, що модель завжди може стати ще впевненішою. Помножимо всі ваги на 10 — межа рішення залишиться тією самою, але сигмоїда стане крутішою, ймовірності наблизяться до 0 і 1, а втрата зменшиться. Оптимізатор буде нескінченно збільшувати
Наслідки практичні: ваги розбігаються до величезних значень, модель стає гранично самовпевненою і будь-яке нове спостереження біля межі отримує ймовірність 0 або 1 без жодних підстав. Чи роздільні наші тридцять ознак, перевіримо в наступному розділі.
Регуляризація зупиняє розбігання ваг
Ліки прямі: додати до функції втрат штраф за довжину вектора ваг.
Тут
У scikit-learn задають не C: у формулі вище C означає сильнішу регуляризацію.
Перевіримо це на наших тридцяти стандартизованих ознаках: навчимо ту саму модель із дедалі слабшим штрафом.
Вивід код запущено, вивід не редагувався
text
C = 1      помилок на навчанні  7   ‖w‖ =     3.8
C = 10000  помилок на навчанні  4   ‖w‖ =   137.3
C = 1e+08  помилок на навчанні  0   ‖w‖ =  7726.8
На що дивитися: що слабший штраф, то менше помилок на навчанні і то довший вектор ваг: майже без штрафу (C = 10⁸) модель розділяє всі 569 пухлин без жодної помилки, а ‖w‖ сягає 7726,8 — наші дані лінійно роздільні, і ваги розбігаються.
На рисунку — коефіцієнти логістичної регресії, що відрізняє цифри 0–4 від 5–9 на зображеннях 8×8 з набору Digits: кожен квадрат — 64 ваги, по одній на піксель. Видно, як зменшення C обнуляє дедалі більше коефіцієнтів при штрафі
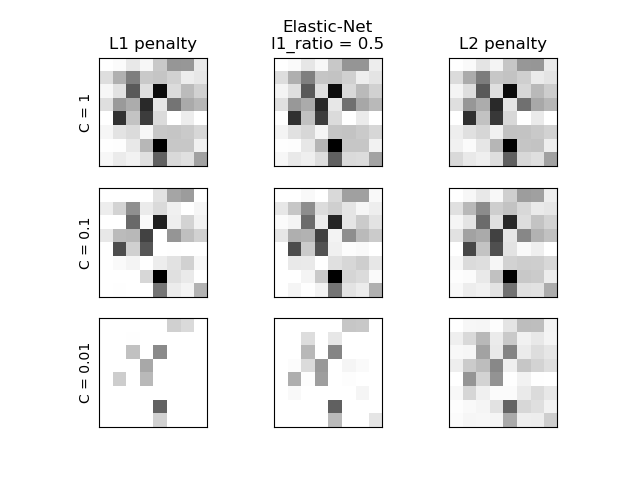
Англійські підписи: L1 / L2 penalty — штраф ℓ₁ / ℓ₂, Elastic-Net, l1_ratio = 0.5 — їхня суміш навпіл; темніший піксель — більша за модулем вага, білий — нульова.
Джерело: scikit-learn · L1 Penalty and Sparsity in Logistic Regression
Частка правильних відповідей — оманлива метрика
Модель навчено. Тепер треба виміряти, наскільки вона добра, і тут перша ж очевидна метрика підводить.
Уявімо скринінг, де злоякісних пухлин 1 %. Модель, яка завжди відповідає «доброякісна», має частку правильних відповідей (accuracy) 99 % і при цьому абсолютно даремна: вона не знайшла жодного хворого. Чим сильніший дисбаланс класів, тим менше значить ця метрика.
Тому оцінювання починають не з одного числа, а з таблиці, яка розкладає відповіді моделі за типами помилок.
Порахуймо той самий скринінг на 1000 пацієнтках, серед яких 10 злоякісних пухлин. Числа в таблиці умовні: третя модель — гіпотетична, щоб показати механіку метрики.
| Модель | Знайдено злоякісних | Хибних тривог | Частка правильних | Придатність |
|---|---|---|---|---|
| «завжди доброякісна» | 0 з 10 | 0 | 99,0 % | нульова |
| «завжди злоякісна» | 10 з 10 | 990 | 1,0 % | нульова |
| добра модель (умовна) | 9 з 10 | 12 | 98,7 % | висока |
Найвищу частку правильних відповідей має модель, яка не знайшла жодної хворої, а найкорисніша з трьох виглядає за цією метрикою гірше за неї.
Матриця похибок розкладає відповіді за типами
Матриця похибок (confusion matrix) зіставляє справжній клас із передбаченим. Для бінарної задачі в ній чотири клітинки:
- TP — злоякісну пухлину визначено як злоякісну;
- TN — доброякісну визначено як доброякісну;
- FP — хибна тривога: доброякісну названо злоякісною;
- FN — пропуск: злоякісну названо доброякісною.
Ці дві помилки нерівноцінні. Хибна тривога означає зайве обстеження, пропуск — невиявлений рак. Звичайні метрики, що зводять матрицю до одного числа, цієї різниці не бачать, поки ми самі не задамо ціну кожної помилки, — тому дивитись треба саме на матрицю.
На рисунку — матриця нашої моделі на 171 тестовій пацієнтці при порозі 0,5. Частка правильних відповідей — це діагональ, поділена на все:
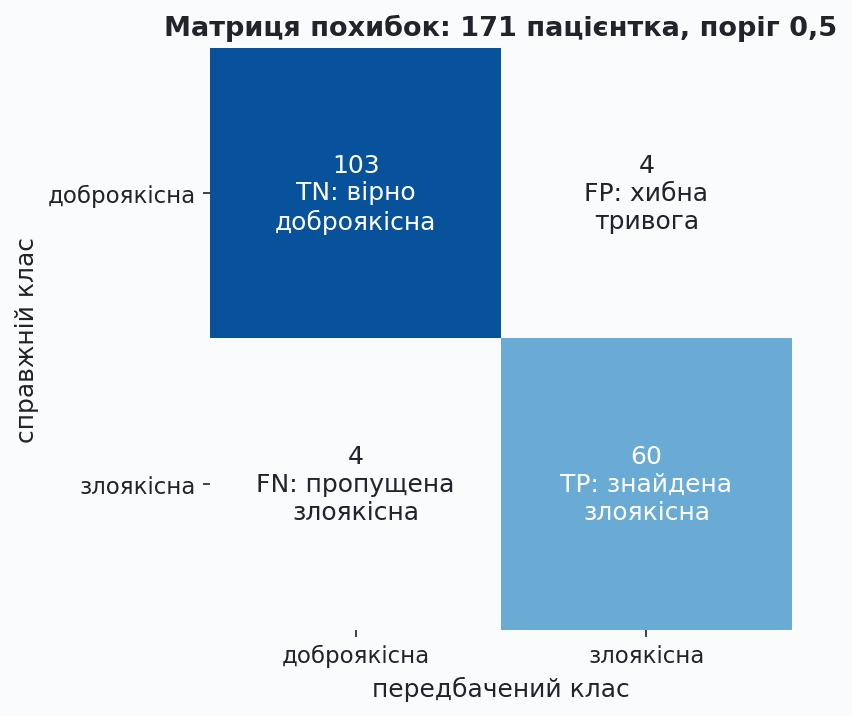
Рядки — справжній клас, стовпці — передбачений; на діагоналі правильні відповіді, поза нею — два типи помилок.
Точність і повнота відповідають на різні питання
З чотирьох клітинок матриці будують дві метрики.
Точність (precision): серед тих, кого модель назвала злоякісними, скільки справді злоякісні — це надійність тривоги. Повнота (recall, або чутливість): серед усіх справді злоякісних, скільки модель знайшла — це охоплення. На матриці точність читають у стовпці «передбачено злоякісна», повноту — у рядку «справді злоякісна»: чисельник спільний, 60 TP, а знаменники різні.
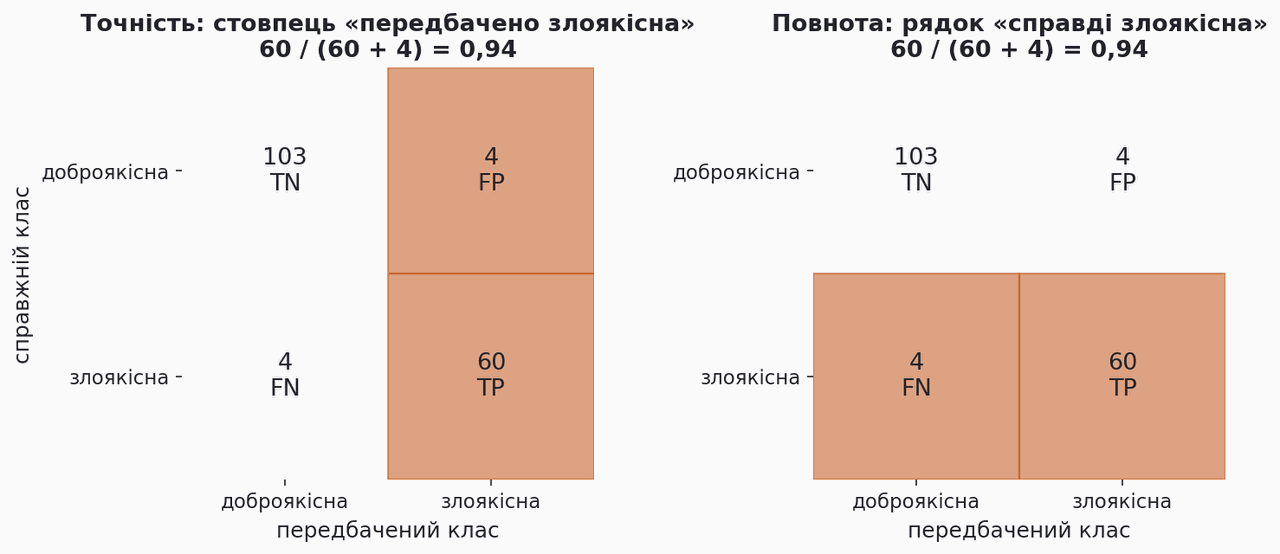
Та сама матриця двічі: ліворуч підсвічено стовпець, з якого рахують точність, праворуч — рядок, з якого рахують повноту.
Зазвичай між ними компроміс: оголосивши всіх злоякісними, отримаємо повноту 100 %, а точність упаде до частки злоякісних,
Поріг рухає матрицю похибок
Модель видає ймовірність, а клас вирішує поріг. Та сама модель на 171 пацієнтці при трьох порогах:
Вивід код запущено, вивід не редагувався
text
поріг   TN  FP  FN  TP  точність  повнота
  0.1   93  14   1  63     0.818    0.984
  0.5  103   4   4  60     0.938    0.938
  0.9  107   0   8  56     1.000    0.875
На що дивитися: знизивши поріг з 0,5 до 0,1, ми пропускаємо одну пухлину замість чотирьох, але хибних тривог стає 14 замість чотирьох; при 0,9 хибних тривог немає зовсім, зате пропусків вісім.
Чи вигідний обмін, вирішує клініка: якщо пропуск, скажімо, удесятеро дорожчий за зайве обстеження, 10 додаткових тривог за 3 знайдені пухлини окупаються,
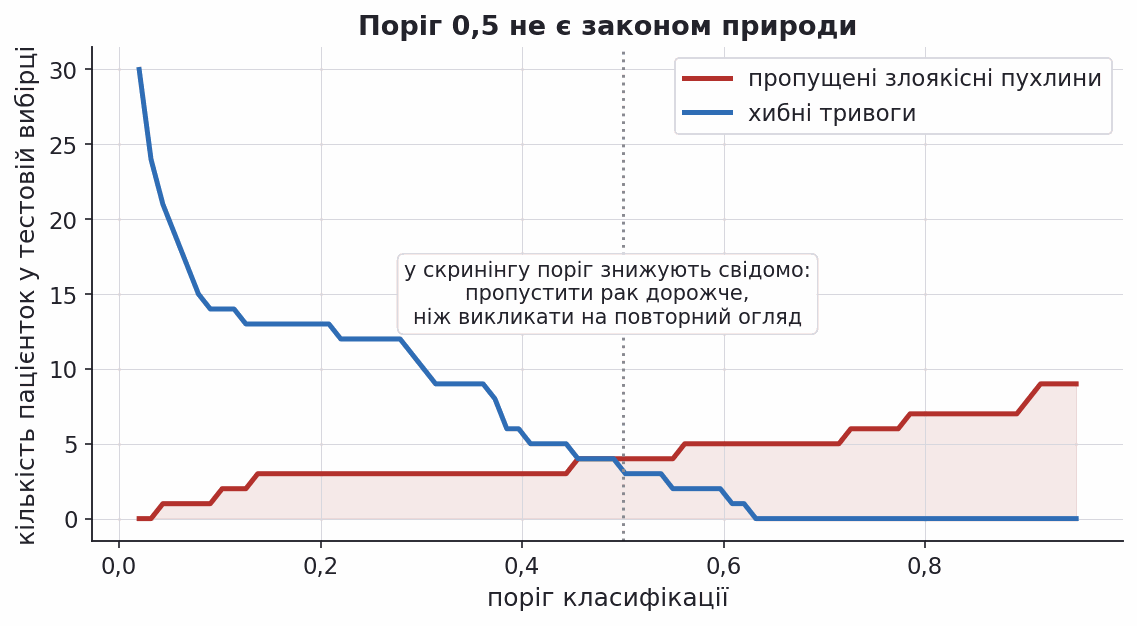
Червона крива — пропущені злоякісні пухлини, синя — хибні тривоги на тих самих 171 пацієнтці; пунктир — поріг 0,5.
ROC-крива показує модель на всіх порогах одразу
ROC-крива (receiver operating characteristic) збирає такі матриці для всіх порогів, по точці на поріг. По горизонталі —
Ідеальна модель проходить через лівий верхній кут, діагональ — випадкове вгадування.
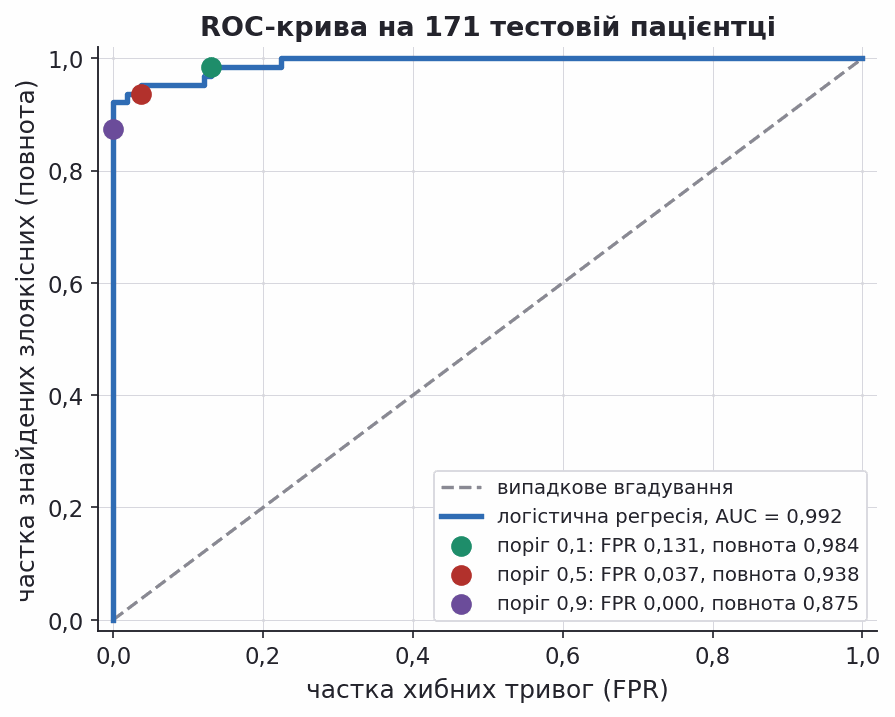
Кожна точка кривої — один поріг; кольорові точки — пороги 0,1, 0,5 і 0,9 з попереднього розділу.
AUC — частка правильно впорядкованих пар
Площу під ROC-кривою, AUC, читають так: візьмемо випадкову злоякісну й випадкову доброякісну пацієнтку — як часто модель дасть злоякісній вищу оцінку? Шість пацієнток для прикладу (оцінки умовні):
| Пацієнтка | Оцінка | Клас | Доброякісні з нижчою оцінкою |
|---|---|---|---|
| А | 0,95 | злоякісна | В, Д, Е — 3 з 3 |
| Б | 0,80 | злоякісна | В, Д, Е — 3 з 3 |
| В | 0,60 | доброякісна | — |
| Г | 0,40 | злоякісна | Д, Е — 2 з 3; пару з В переплутано |
| Д | 0,20 | доброякісна | — |
| Е | 0,05 | доброякісна | — |
Пар «злоякісна — доброякісна» тут
Вивід код запущено, вивід не редагувався
text
пар «злоякісна — доброякісна»: 64 × 107 = 6848
частка правильно впорядкованих: 0.9917
roc_auc_score:                  0.9917
На що дивитися: перебір 6848 пар і бібліотечна функція дають те саме число, 0,9917, — це одна величина, порахована двома способами.
Отже, AUC залежить лише від порядку оцінок: піднесіть усі до квадрата — AUC не зміниться. Чи правдиві самі ймовірності, він не бачить; це перевіряє калібрування.
Крива точність–повнота чесніша при дисбалансі
Крива точність–повнота (precision-recall curve) будується так само, лише в інших осях: кожен поріг дає точку (повнота; точність). При порозі 0,9 це
Наприклад, якщо дві злоякісні пухлини стоять у рейтингу на першому й третьому місцях, то
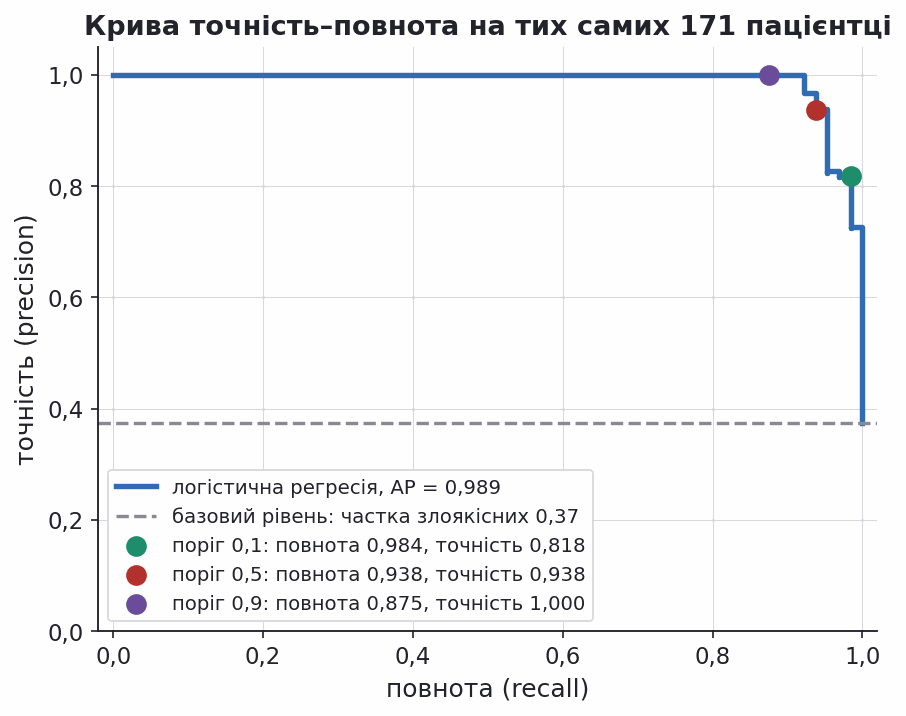
Ті самі пороги 0,1, 0,5 і 0,9, що на ROC-кривій; пунктир — базовий рівень 0,37.
Поріг вирішує, яким буде діагноз
Справжні передбачення моделі з коду scikit-learn: логістична регресія на Breast Cancer Wisconsin, відкладені 171 спостереження. Модель не змінюється — змінюється лише поріг, і разом із ним матриця похибок, точка на ROC-кривій і точка на кривій точність–повнота.
Матриця похибок
| прогноз: доброякісна | прогноз: злоякісна | |
|---|---|---|
| факт: доброякісна | 103правильно | 4хибна тривога |
| факт: злоякісна | 4пропущено | 60виявлено |
ROC-крива: AUC = 0,992
Точність–повнота: AP = 0,989
0,938повнота: скільки злоякісних знайдено
0,938точність: скільки тривог справдилися
0,938F1 — гармонічне середнє точності й повноти
4пропущено злоякісних пухлин
44сумарна ціна помилок; мінімум на цих 171 пацієнтках — 24
Зсуньте поріг до 0,1 — пропусків стане один замість чотирьох, а хибних тривог чотирнадцять замість чотирьох. Це той самий обмін, що в розділі «Поріг рухає матрицю похибок». Точка на ROC-кривій при цьому повзе вправо й угору, а на кривій точність–повнота — вправо й униз: повнота росте, точність падає. Жодна метрика не скаже, який поріг правильний: це вирішує ціна помилки в клініці, а не модель. AUC і AP при цьому не змінюються взагалі — криві описують модель на всіх порогах одразу, тому вибір порога вони не підказують. Поріг 0,43 для максимуму F1 пораховано нижче, у розділі «Поріг можна підбирати автоматично», а формулу порога за Баєсом виведено в розділі «Поріг за ціною помилок».
Тепер задайте ціну помилок числами — і поріг перестане бути справою смаку. Якщо пропустити злоякісну пухлину вдесятеро дорожче за хибну тривогу, теорія дає поріг C_FP / (C_FP + C_FN), тобто 0,091: саме там очікувані втрати від двох рішень зрівнюються. Друга кнопка ставить поріг, найкращий на цих конкретних 171 спостереженні, — тут це 0,030. Це підбір на тестовій вибірці: так робити не можна, кнопка лише показує, наскільки оптимістичною виходить така оцінка. Сумарні втрати виходять однакові, 24, хоча матриці похибок різні: один пропуск і чотирнадцять тривог проти жодного пропуску і двадцяти чотирьох. Баєсів поріг оптимальний для справжніх імовірностей, емпіричний підлаштовується під випадковість маленької вибірки: його оцінка оптимістична, і перевага на нових даних не гарантована. І головне: зрівняйте обидві ціни. Баєсів поріг стане рівно 0,5 — тим самим, який бібліотека ставить за замовчуванням. Отже, 0,5 — не константа, а мовчазне припущення, що обидві помилки коштують однаково.
На рідкісному класі ROC-крива оманлива
Візьмімо набір операцій за банківськими картками, де шахрайських лише 0,17 % (докладно — у розділі «Дисбаланс класів: у чому проблема»). Логістична регресія на ньому має ROC-AUC 0,976 — майже як на пухлинах, 0,992. Крива точність–повнота показує правду: AP лише 0,728 проти 0,989.
Причина в знаменниках. FPR ділить хибні тривоги на всі звичайні операції тесту, а їх 85 295: навіть 1000 хибних тривог (умовний приклад) — це лише
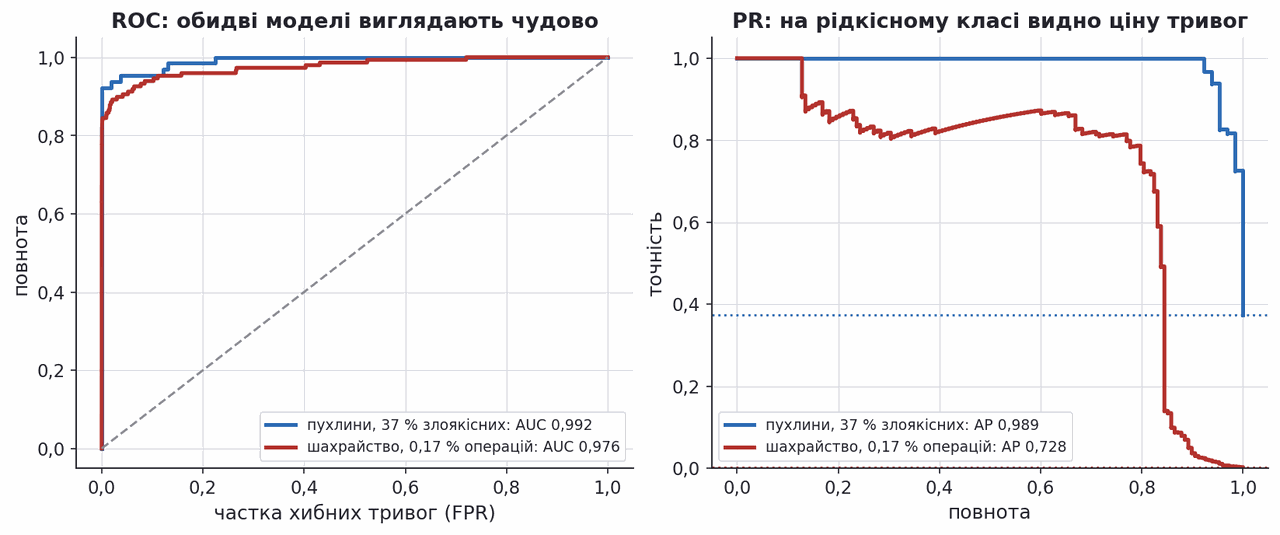
Синім — пухлини, червоним — шахрайство (у тесті 148 шахрайських і 85 295 звичайних операцій); точкові лінії праворуч — базові рівні кривих точність–повнота, 0,37 і 0,0017.
Правило: класи збалансовані й помилки однаково важливі — ROC; цікавить рідкісний клас — крива точність–повнота.
Поріг можна підбирати автоматично
Поріг — гіперпараметр, і підбирають його так само, як інші: без тестової вибірки. TunedThresholdClassifierCV робить це за п'ять кроків:
| Крок | Що відбувається |
|---|---|
| 1 | ділить навчальну частину на 5 фолдів |
| 2 | для кожного фолду навчає модель на решті чотирьох і рахує ймовірності для нього |
| 3 | на кожному фолді рахує F1 для сітки порогів |
| 4 | усереднює F1 по фолдах і бере поріг із найбільшим середнім |
| 5 | навчає модель на всій навчальній частині й ставить цей поріг |
Вивід код запущено, вивід не редагувався
text
фолд 1: найкращий поріг 0.28
фолд 2: найкращий поріг 0.52
фолд 3: найкращий поріг 0.37
фолд 4: найкращий поріг 0.34
фолд 5: найкращий поріг 0.43
за середнім F1 по фолдах: 0.43
На що дивитися: найкращі пороги окремих фолдів розкидані від 0,28 до 0,52; середній F1 однаковий на плато від 0,43 до 0,49, і бібліотека бере його перший поріг, 0,43.
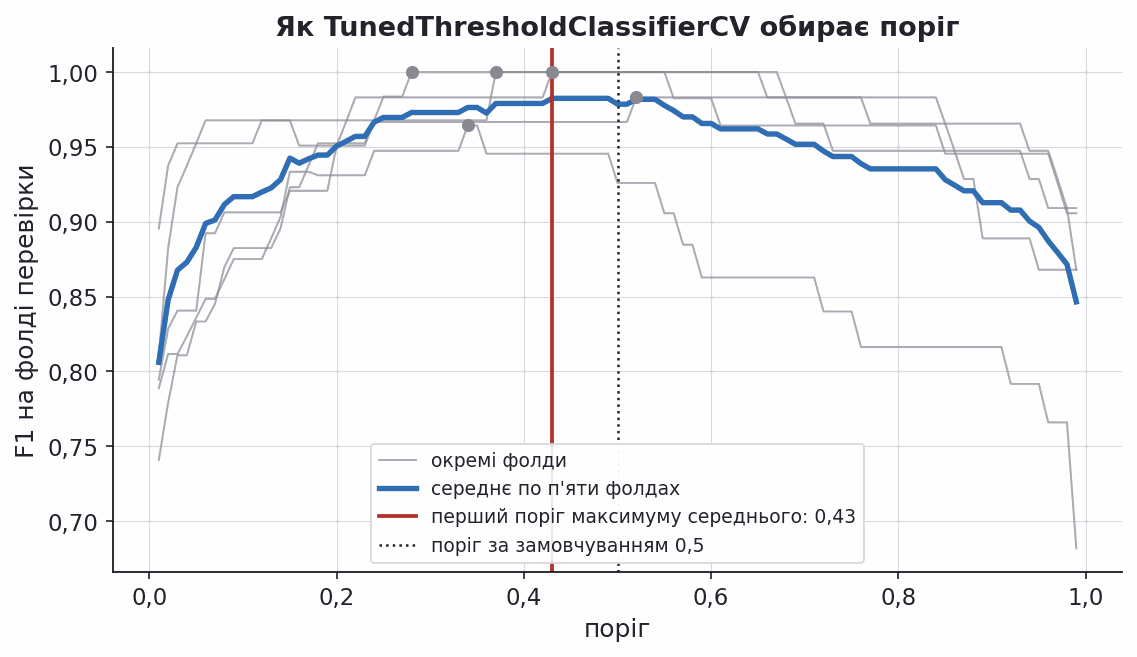
Сірі криві — F1 на кожному з п'яти фолдів, синя — їхнє середнє; червона лінія — обраний поріг 0,43.
Замість F1 можна задати ціну помилок — її розберемо в розділі «Поріг за ціною помилок».
Джерело: scikit-learn · Post-hoc tuning the cut-off point
Дисбаланс класів: у чому проблема
Дисбаланс класів (class imbalance) — ситуація, коли один клас набагато рідший за інший. Розберемо її на наборі Credit Card Fraud Detection (ULB, Kaggle): 284 807 операцій за картками європейських власників за два дні вересня 2013 року. Ознаки — 28 знеособлених компонент V1–V28 (автори набору, Worldline і ULB, перетворили справжні ознаки методом головних компонент, лекція 09) і сума операції Amount; ціль — чи була операція шахрайською. У версії OpenML 1597, яку ми завантажуємо, ознаки часу Time немає.
Біда не лише в метриці. Модель «усі звичайні» вгадує 99,83 % відповідей і не знаходить жодної шахрайської операції, але страждає й навчання: втрата — середнє по всіх прикладах, і 99,8 % її доданків дають звичайні операції. Мінімізуючи її, модель передусім вчиться не помилятися на них, а шахрайству приписує малі ймовірності.
Вивід код запущено, вивід не редагувався
text
навчальна частина: 199020 і 344, тобто 1 : 579
«усі звичайні» на тесті: частка правильних 0.9983
поріг 0,5: знайдено 89 шахрайських із 148, хибних тривог 14
На що дивитися: на одну шахрайську операцію припадає 579 звичайних; при порозі 0,5 модель знаходить 89 шахрайських операцій зі 148, а 59 пропускає.
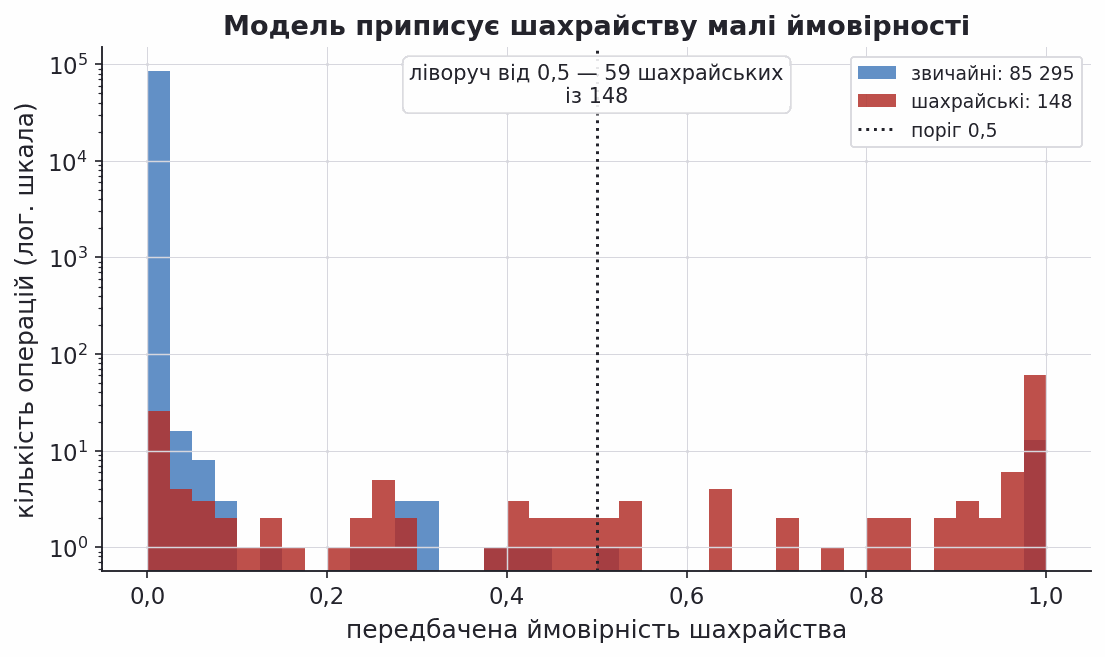
Розподіл передбаченої ймовірності шахрайства на тесті, кількість — у логарифмічній шкалі: звичайні операції синім, шахрайські червоним. Ліворуч від порога 0,5 лишається 59 шахрайських зі 148.
Боротися з дисбалансом можна на чотирьох рівнях, і кожному далі присвячено окремий розділ:
- оцінювання — метрики, які бачать рідкісний клас;
- рішення — поріг, обчислений із цін помилок;
- функція втрат — ваги класів і фокальна втрата (focal loss);
- дані — передискретизація, зокрема SMOTE, і недодискретизація.
Наприкінці порівняємо всі способи на тих самих даних.
Метрики для незбалансованих класів
Частка правильних відповідей тут марна: «усі звичайні» отримують 0,9983, наша модель — 0,9991. Потрібні метрики, що дивляться на рідкісний клас. Порахуємо кожну для моделі при порозі 0,5, де
Повнота і точність (розділ 27): у моделі
F-міра зводить їх в одне число, а параметр
При
Це нижче за F1, бо повнота в нас слабша за точність.
Збалансована частка правильних (balanced accuracy) — середнє повнот обох класів,
Коефіцієнт кореляції Метьюза (Matthews correlation coefficient, MCC) використовує всі чотири клітинки матриці:
Він змінюється від −1 до 1, а 0 означає рівень випадкового вгадування. У моделі
Середня точність (AP, розділ 31) не залежить від порога: 0,728 проти базового рівня 0,0017.
Вивід код запущено, вивід не редагувався
text
метрика              усі звичайні  модель, поріг 0,5
частка правильних          0.9983       0.9991
збалансована частка        0.5000       0.8006
точність                   0.0000       0.8641
повнота                    0.0000       0.6014
F1                         0.0000       0.7092
F2                         0.0000       0.6403
MCC                        0.0000       0.7205
AP: базовий рівень 0.0017, модель 0.728
На що дивитися: частка правильних у двох моделей майже однакова (0,9983 і 0,9991), а решта метрик розводить їх: від 0 (для збалансованої частки — 0,5) до 0,60–0,86.
Яку метрику обрати, вирішує задача: якщо головне — знайти якомога більше шахрайських операцій, беруть F2 або повноту за заданої точності; якщо ціни помилок відомі — сумарний збиток із наступного розділу.
Поріг за ціною помилок
Поріг за ціною помилок (cost-sensitive threshold) — поріг, обраний не за звичкою, а з того, скільки коштує кожна помилка. Для банку пропущене шахрайство коштує суму операції — у середньому
Нехай модель каже, що операція шахрайська з імовірністю
- мовчати — помилимося, якщо це шахрайство; очікувана втрата
; - підняти тривогу — помилимося, якщо операція звичайна; очікувана втрата
.
Тут припускаємо, що правильні рішення нічого не коштують, а ціна пропуску однакова для всіх операцій (насправді вона дорівнює сумі конкретної операції). Тривога вигідна, коли вона дешевша за мовчання,
Приклад: операція з
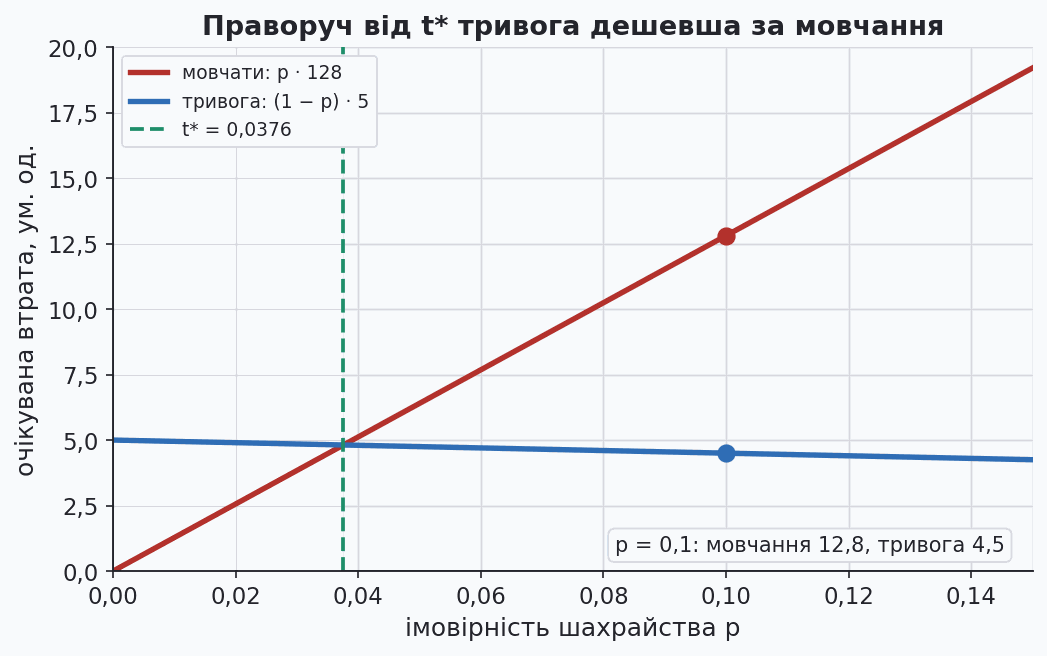
Очікувана втрата двох рішень залежно від імовірності шахрайства
Вивід код запущено, вивід не редагувався
text
C_FN = 128, C_FP = 5, поріг за ціною 0.0376
p = 0.1: мовчання коштує 12.8, тривога 4.5
поріг 0.5000: пропущено 59, хибних 14, збиток 7622
поріг 0.0376: пропущено 29, хибних 41, збиток 3917
На що дивитися: той самий класифікатор із порогом 0,0376 пропускає 29 шахрайських операцій замість 59 ціною 41 хибної тривоги замість 14, і збиток падає з 7622 до 3917.
Формула
Зважування класів
Зважування класів (class weighting) змінює не рішення, а навчання: кожен доданок функції втрат множать на вагу
де
Ваги задають двома способами.
class_weight='balanced'бере, де — розмір навчальної частини, — кількість класів, — кількість прикладів класу . Тоді : обидва класи разом важать однаково. У нас і , тож одна шахрайська операція важить як 579 звичайних. - Ваги за цінами помилок:
і , тобто class_weight={0: 5, 1: 128}; шахрайство важить як 25,6 звичайних.
Різниця принципова: balanced мовчки припускає, що пропущене шахрайство коштує як 579 хибних тривог, хоча насправді — як
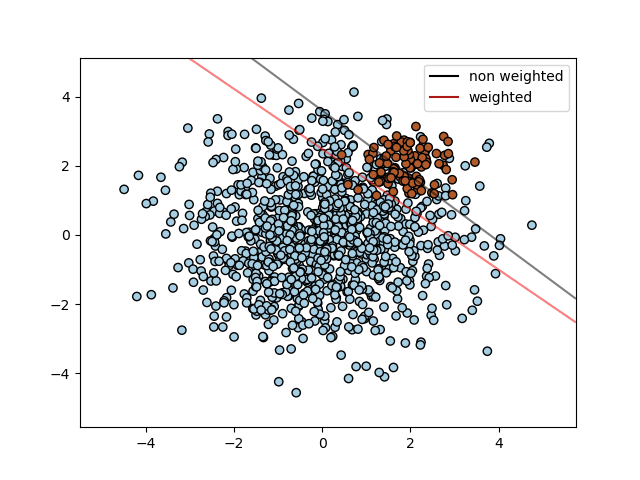
Англійські підписи: non weighted / weighted — межа без ваг і з більшою вагою рідкісного класу. Рисунок для методу опорних векторів (лекція 07), але параметр class_weight діє так само: межа відсувається від рідкісного класу (коричневі точки) вглиб частого.
Джерело: scikit-learn · SVM: Separating hyperplane for unbalanced classes
Вивід код запущено, вивід не редагувався
text
balanced: ваги 0.501 і 289.8, співвідношення 579
за цінами: ваги 5 і 128, співвідношення 25.6
balanced  повнота 0.899, точність 0.069, хибних 1804
за цінами повнота 0.824, точність 0.659, хибних 63
На що дивитися: balanced знаходить 133 шахрайські операції зі 148 (повнота 0,899), але піднімає 1804 хибні тривоги; ваги за цінами дають повноту 0,824 при 63 хибних тривогах.
Передискретизація: копії і синтетичні приклади SMOTE
Передискретизація (oversampling) змінює дані: до навчальної частини додають приклади рідкісного класу, доки класів не стане порівну. У нас треба додати
Випадкові копії дублюють наявні шахрайські операції — кожна в середньому повторюється 579 разів. Для логістичної регресії це майже те саме, що вага 579: втрата на копіях дорівнює втраті на одному прикладі з більшою вагою.
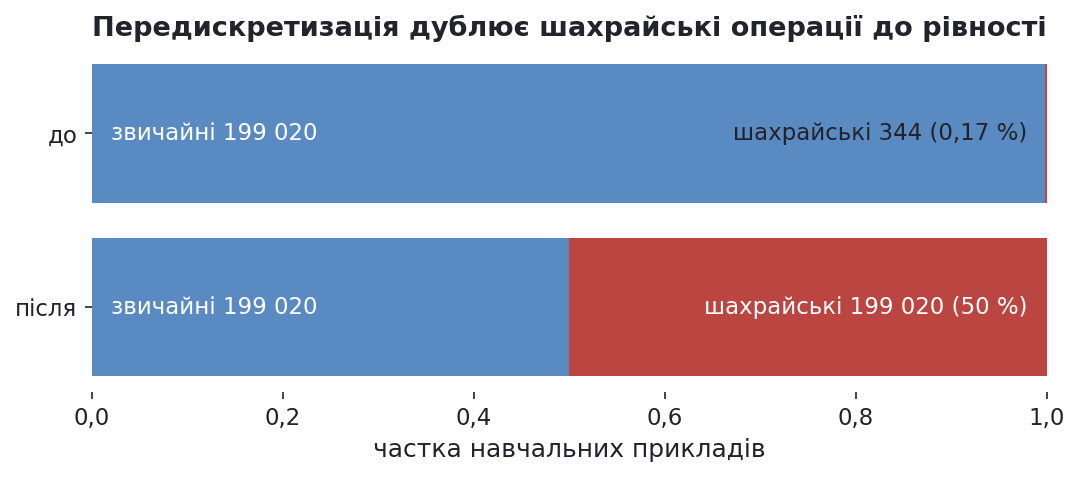
Навчальна частина до й після передискретизації: 344 шахрайські операції повторюються, доки їх не стане 199 020.
SMOTE (Synthetic Minority Over-sampling Technique, Chawla et al., 2002) не копіює, а створює нові точки між сусідами. Беруть шахрайську операцію
Нова точка лежить на відрізку між
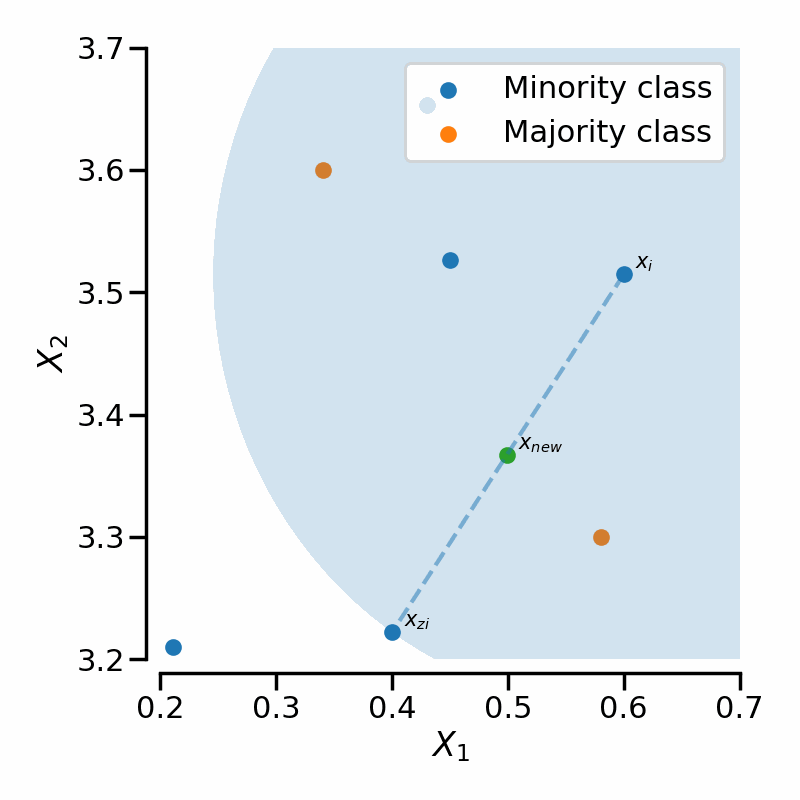
Англійські підписи: Minority / Majority class — рідкісний і частий клас; x_i — опорна точка, x_zi — обраний сусід (у тексті
Джерело: imbalanced-learn · Sample generator used in SMOTE-like samplers
Головне застереження — витік даних (data leakage). Передискретизацію роблять лише на навчальній частині і лише після розбиття, а при перехресній перевірці — окремо в кожному фолді. Якщо спершу розмножити шахрайство, а потім розбити, копії тієї самої операції потраплять і в навчання, і в тест, і метрики стануть оманливо добрими.
Вивід код запущено, вивід не редагувався
text
додано 198676 шахрайських операцій
копії  повнота 0.899, точність 0.069, хибних 1788
SMOTE  повнота 0.899, точність 0.069, хибних 1793
На що дивитися: обидва способи дають ту саму повноту 0,899 і майже стільки ж хибних тривог, скільки ваги balanced (1788 і 1793 проти 1804), — для лінійної моделі це три варіанти одного й того самого зсуву межі.
Сусідів ми шукаємо в стандартизованих ознаках, інакше близькість визначала б сума операції. У робочому коді SMOTE не пишуть руками: бібліотека imbalanced-learn дає SMOTE().fit_resample(X, y) і власний конвеєр, у якому SMOTE ставлять після StandardScaler і який робить передискретизацію всередині кожного фолду.
Недодискретизація: менше прикладів частого класу
Недодискретизація (undersampling) робить навпаки: з частого класу випадково лишає стільки прикладів, скільки є в рідкісному. Від 199 020 звичайних операцій лишається 344, і модель навчається на 688 прикладах замість 199 364.
Перевага — швидкість: на величезних даних це інколи єдиний спосіб навчити модель за розумний час. Ціна — 99,8 % звичайних операцій модель не бачить узагалі, тож погано знає, якими вони бувають. Розумніші варіанти відкидають приклади не навмання: наприклад, NearMiss лишає звичайні операції, найближчі до шахрайських, а Tomek links прибирає звичайну операцію з кожної пари найближчих сусідів різних класів (imbalanced-learn · Under-sampling).
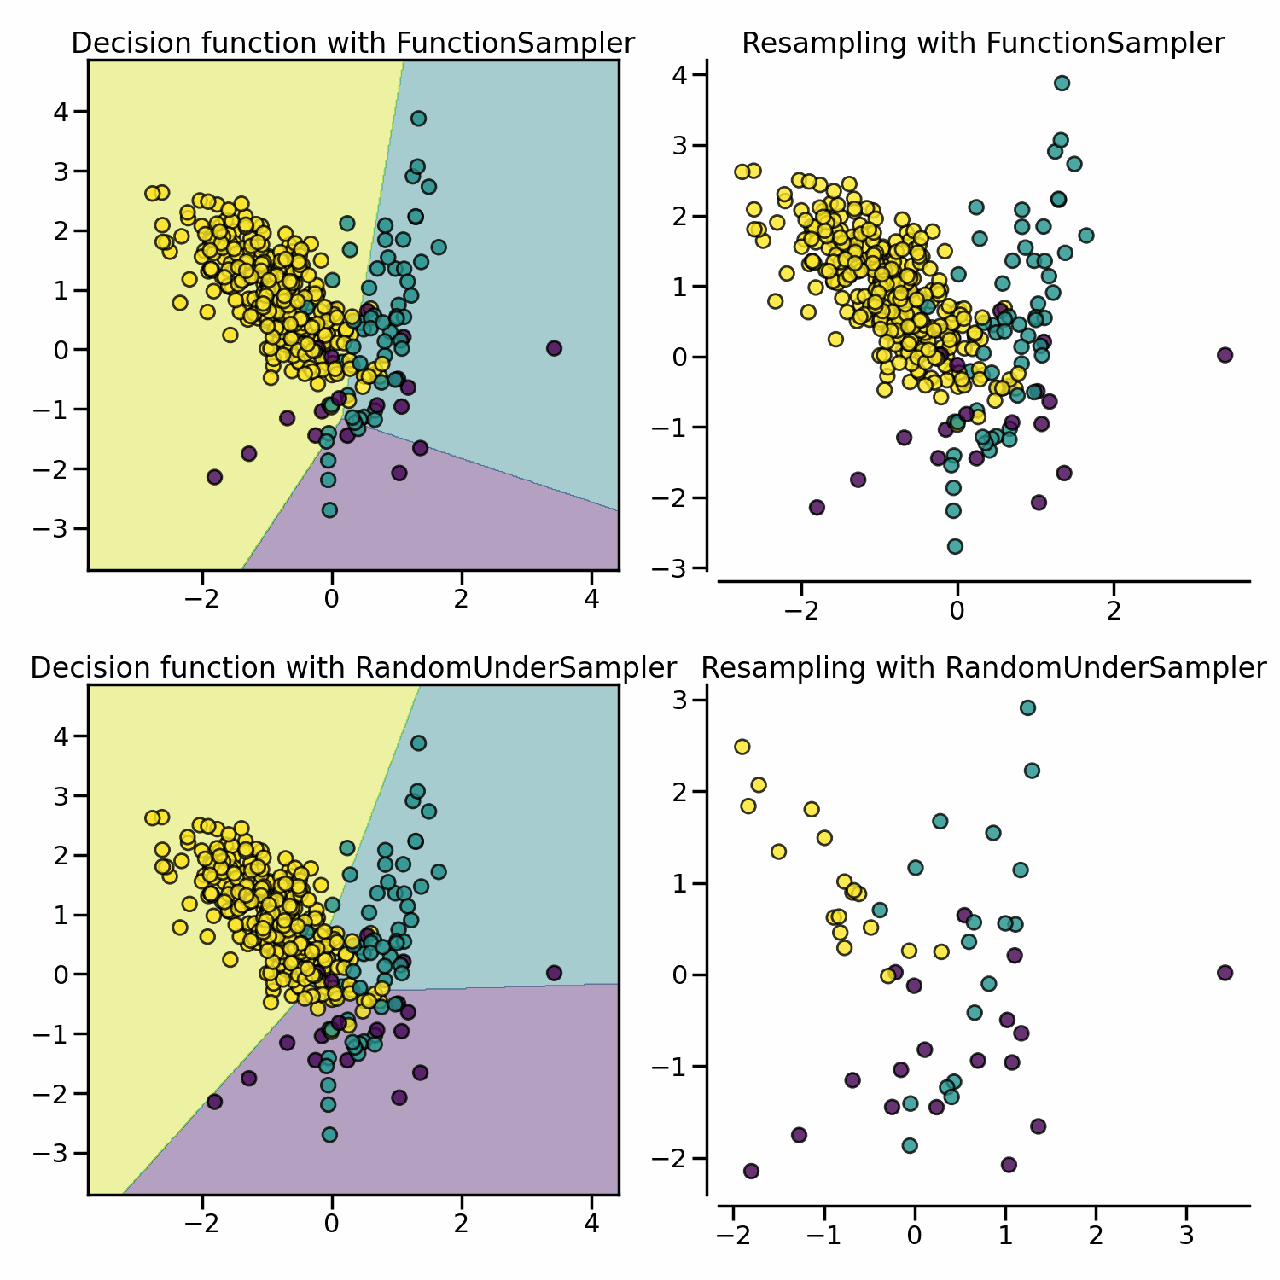
Англійські підписи: Decision function / Resampling — межі рішень і навчальні дані. Верхній ряд — вихідні дані (FunctionSampler тут нічого не відкидає), нижній — випадкова недодискретизація RandomUnderSampler: кожного класу лишилося стільки ж, скільки в найрідкіснішому. Три класи, логістична регресія.
Вивід код запущено, вивід не редагувався
text
лишаємо 688 прикладів із 199364: 0.35%
повнота 0.892, точність 0.049, хибних 2567
На що дивитися: повнота 0,892, але хибних тривог уже 2567 — більше, ніж у будь-якого іншого способу.
Фокальна втрата: увага до складних прикладів
У перехресній ентропії кожен приклад вносить
Тут
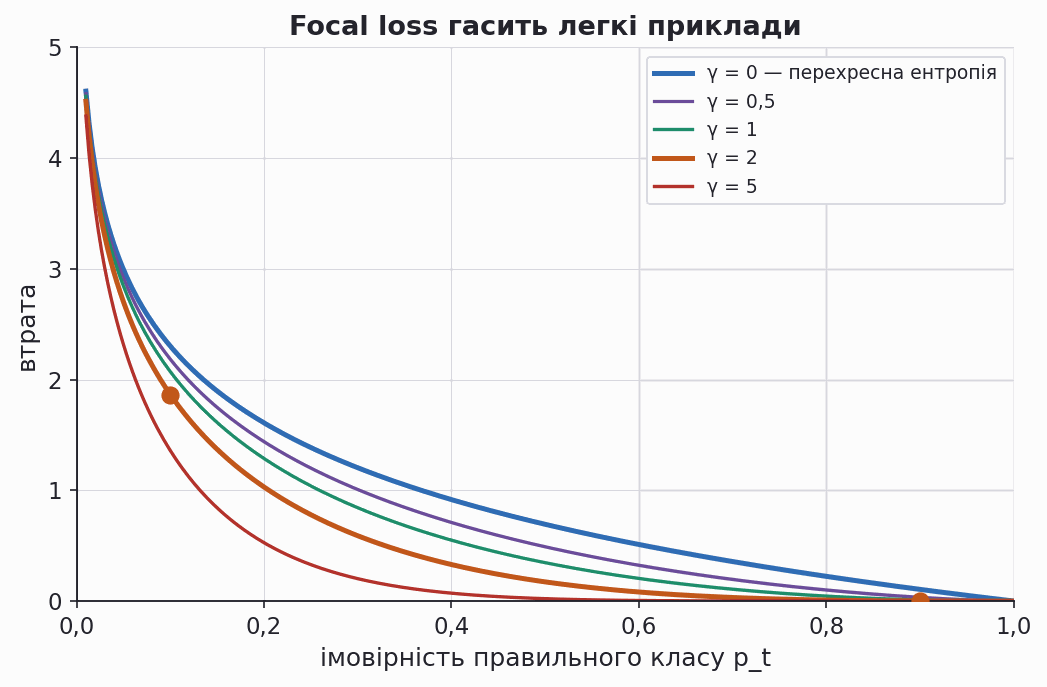
Фокальна втрата залежно від імовірності правильного класу
Вивід код запущено, вивід не редагувався
text
перехресна ентропія: [0.10536 2.30259] focal, γ = 2: [1.05000e-03 1.86509e+00]На що дивитися: на легкому прикладі фокальна втрата (0,00105) у 100 разів менша за перехресну ентропію (0,10536), на складному (1,865 проти 2,303) — майже та сама.
Перевіримо, що це дає на шахрайських операціях: навчимо ту саму логістичну регресію — один лінійний шар у PyTorch — із
Вивід код запущено, вивід не редагувався
text
γ = 0: повнота 0.622, точність 0.868, середня p 0.0017
γ = 2: повнота 0.574, точність 0.842, середня p 0.0444
На що дивитися: на наших даних модель із γ = 2 знаходить менше шахрайства, ніж із γ = 0 (повнота 0,574 проти 0,622), а середня ймовірність шахрайства зростає з 0,0017 до 0,0444.
Чесний висновок: на лінійній моделі фокальна втрата не допомагає — шахрайства вона знаходить менше, а ймовірності завищує в 26 разів (0,0444 при справжній частці 0,0017). Її придумали для нейронних мереж, що шукають об'єкти на зображеннях (RetinaNet): там на кожне зображення припадає близько 100 тисяч кандидатних ділянок, і майже всі вони — легкий фон. Модель із γ = 0 — це та сама логістична регресія, але без штрафу на ваги, тому її числа трохи відрізняються від scikit-learn.
Джерело: torchvision · sigmoid_focal_loss
Порівняння способів на шахрайських операціях
Зведемо всі способи в одну таблицю. Модель усюди та сама — логістична регресія на тих самих даних; змінюється лише спосіб боротьби з дисбалансом. Тест тут лише ілюструє різницю: обирати спосіб для реальної задачі треба так само, як поріг, — перехресною перевіркою на навчальній частині.
Вивід код запущено, вивід не редагувався
text
спосіб              повнота точність пропущ. хибні збиток    AP  сер. p
як є, поріг 0,5       0.601    0.864      59    14   7622 0.728 0.0017
ваги balanced         0.899    0.069      15  1804  10940 0.712 0.0748
ваги за цінами        0.824    0.659      26    63   3643 0.736 0.0082
копії                 0.899    0.069      15  1788  10860 0.711 0.0745
SMOTE                 0.899    0.069      15  1793  10885 0.712 0.0643
недодискретизація     0.892    0.049      16  2567  14883 0.599 0.0981
focal loss, γ = 2     0.574    0.842      63    16   8144 0.734 0.0444
поріг за ціною        0.804    0.744      29    41   3917 0.728 0.0017
справжня частка шахрайства в тесті: 0.0017
На що дивитися: за повнотою виграють balanced, копії й SMOTE (0,899), за збитком — ваги за цінами (3643) і поріг за ціною (3917); AP майже однакова, 0,71–0,74, крім недодискретизації (0,599); правильна середня ймовірність шахрайства, 0,0017, лишається лише у звичайної моделі.
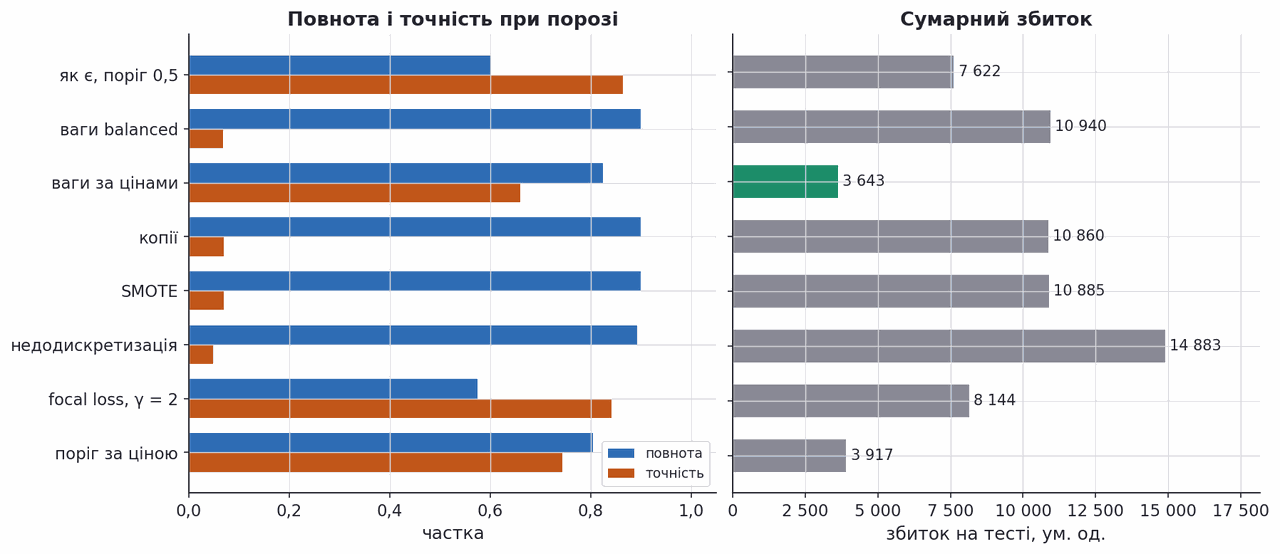
Ліворуч — повнота й точність, праворуч — сумарний збиток на тесті для восьми способів; зеленим — найменший збиток.
Із таблиці — три висновки.
- Більшість способів не покращує модель, а лише зсуває межу. AP — якість упорядкування операцій за ймовірністю — майже однакова в усіх, 0,71–0,74; помітно гірша лише в недодискретизації (0,599), яка викинула 99,8 % даних.
- «Найкращий» спосіб залежить від метрики. За повнотою виграють balanced, копії й SMOTE, але ціною майже 1800 хибних тривог; за збитком — ваги за цінами (3643) і поріг за ціною (3917): обидва вбудовують справжнє співвідношення цін 25,6, а не 579.
- Усі способи, що втручаються в навчання, псують імовірності. Середня передбачена ймовірність шахрайства в balanced — 0,0748, у 43 рази більша за справжню частку 0,0017; навіть ваги за цінами дають 0,0082. Чесними ймовірності лишаються лише у звичайної моделі — їй і ставлять поріг за ціною. Що робити з нечесними ймовірностями — у наступних розділах.
Чесні ймовірності і крива калібрування
Часто потрібне не лише рішення «так чи ні», а сама ймовірність як число: поріг
Перевіряють це кривою калібрування (calibration curve). Передбачення розкладають на кошики — групи з близькою ймовірністю. Для кожного кошика
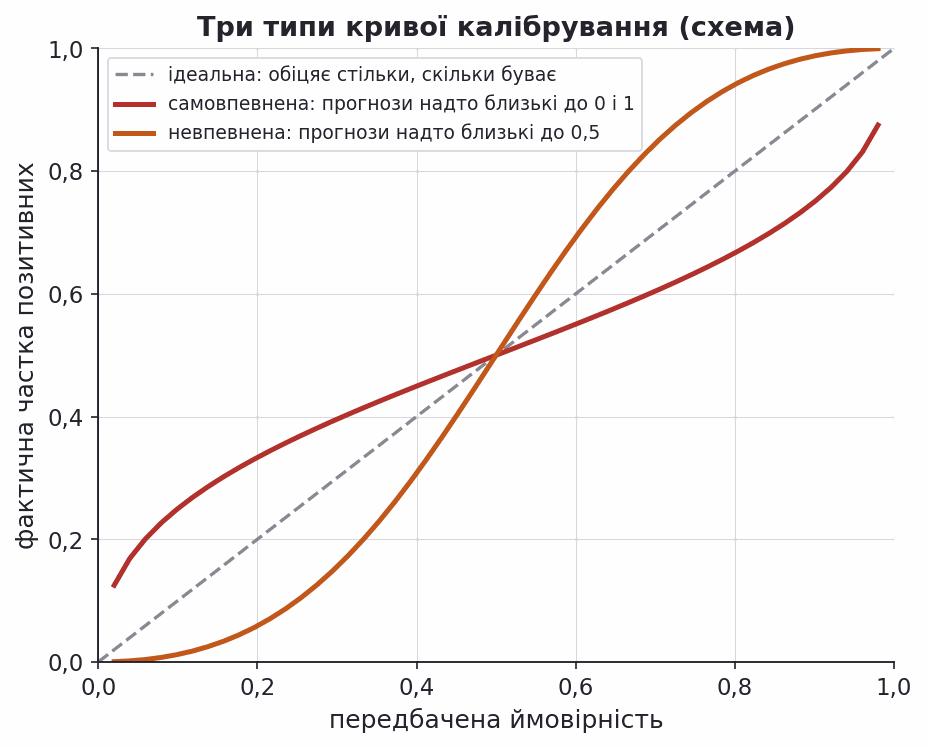
Схема трьох типів кривої. Самовпевнена модель (червона) дає ймовірності, надто близькі до 0 і 1: де вона обіцяє 0,9, подія трапляється рідше. Невпевнена (помаранчева) тисне прогнози до 0,5: де вона обіцяє 0,2, подія трапляється ще рідше.
На 171 пацієнтці криву надійно не побудувати: між 0,1 і 0,9 лежить лише 21 прогноз, тож кошики в середині шкали спиралися б на кілька пацієнток. Тому далі — більший набір.
Міра Брайєра і крива калібрування на банківських даних
Якість імовірностей одним числом підсумовує міра Брайєра (Brier score) — середній квадрат різниці між імовірністю і міткою:
Приклад на чотирьох клієнтах із прогнозами 0,9; 0,2; 0,6; 0,1 і мітками 1, 0, 0, 0: квадрати помилок
Дані — Bank Marketing (UCI): дзвінки португальського банку з пропозицією депозиту. Ознаки — вік, професія, сімейний стан, освіта, баланс рахунку, кредити, спосіб і дата контакту, історія попередніх кампаній; ціль — згода клієнта на депозит. Шість кошиків тут однакової наповненості.
Вивід код запущено, вивід не редагувався
text
приклад із 4 клієнтів: 0.105
у тесті 13564 клієнтів, згод 11.7%
кошик     n   p̄_B    ȳ_B
    1  2261  0.024  0.033
    2  2261  0.047  0.049
    3  2260  0.073  0.053
    4  2261  0.096  0.083
    5  2260  0.129  0.111
    6  2261  0.346  0.373
Брайєр: 0.0853
прогноз «усім 0.117»: Брайєр 0.1033
ROC-AUC: 0.773
На що дивитися: у тесті 13 564 клієнти й 11,7 % згод, у кожному кошику близько 2260; два останні стовпці майже збігаються — від 0,024 і 0,033 до 0,346 і 0,373. Брайєр моделі 0,0853 проти 0,1033 у прогнозу «усім 11,7 %», хоча впорядковує клієнтів модель посередньо: ROC-AUC 0,773.
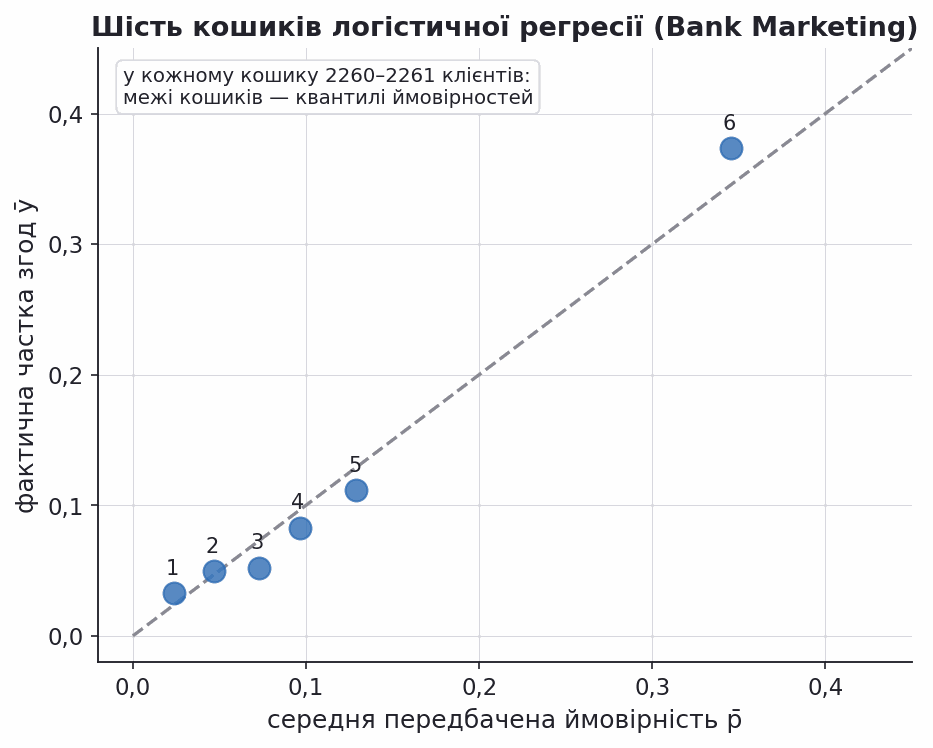
Шість кошиків логістичної регресії на тестових клієнтах, пронумерованих за зростанням імовірності; пунктир — ідеальне калібрування.
Кошики лягають майже на діагональ (найбільші відхилення — у третьому, 0,073 проти 0,053, і в шостому, 0,346 проти 0,373), і це не збіг: перехресна ентропія досягає мінімуму саме на справжній імовірності, тож модель, яка правильно описує дані, буде й каліброваною.
Зважування класів псує ймовірності
Контрприклад на тих самих банківських даних: та сама логістична регресія з class_weight='balanced' (розділ «Зважування класів»). Вона навчається так, ніби згод і відмов порівну, тож завищує ймовірність згоди.
Вивід код запущено, вивід не редагувався
text
модель    ROC-AUC  Брайєр  очікуваних згод
звичайна   0.7729  0.0853            1615
balanced   0.7748  0.1850            5666
насправді згод: 1587 із 13564
На що дивитися: ROC-AUC майже не змінився (0,7729 → 0,7748) — упорядковує клієнтів зважена модель так само добре; але Брайєр зріс з 0,0853 до 0,1850, гірше, ніж у прогнозу «усім 11,7 %», а сума її ймовірностей обіцяє 5666 згод при 1587 справжніх (у звичайної моделі — 1615).
Для банку, який за таким прогнозом планує роботу кол-центру, це помилка в 3,6 раза. Порядок клієнтів правильний, а числа — ні; саме таку модель і лікує калібрування.
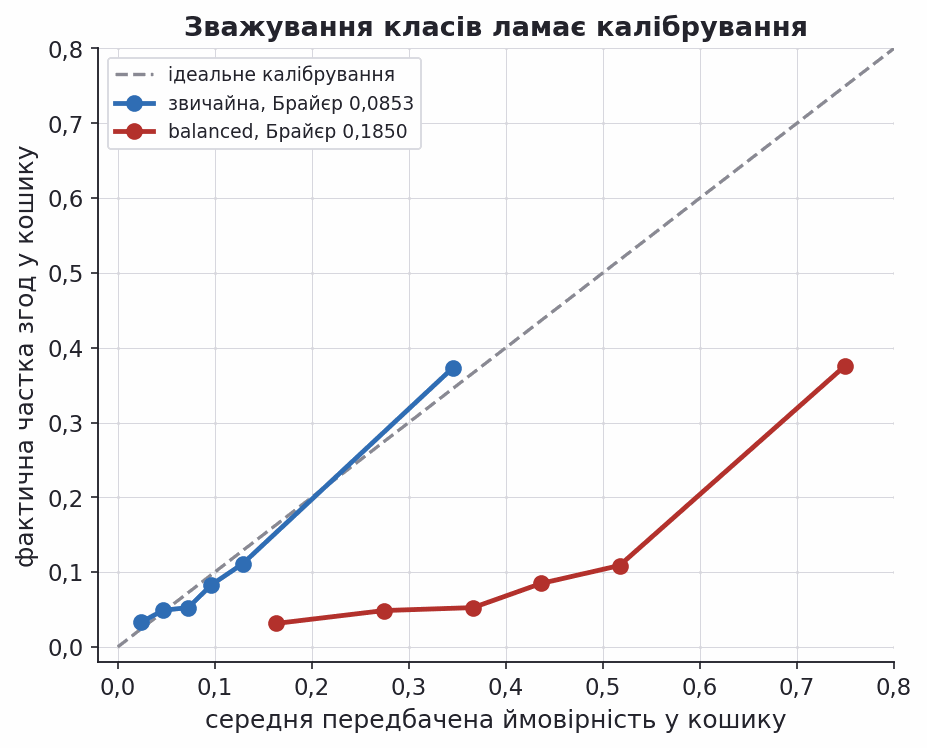
Кожна точка — кошик клієнтів: звичайна модель (синім) лежить на діагоналі, зважена (червоним) — далеко праворуч від неї: обіцяє більше згод, ніж буває.
Калібрування: метод Платта та ізотонічна регресія
Калібрування (calibration) — це маленька окрема модель поверх готової: вона вчиться перекладати вихід моделі
- Навчити модель як завжди.
- Отримати її оцінки
на даних, яких вона не бачила: на окремій калібрувальній вибірці або прогнозами поза фолдом перехресної перевірки. На навчальних даних не можна — там модель надто впевнена у своїх відповідях. - На парах «оцінка
— мітка » навчити функцію , що переводить оцінку в імовірність. - Для нового об'єкта видавати
.
Метод Платта (Platt scaling) бере
Це логістична регресія з однією ознакою
Ізотонічна регресія (isotonic regression) замість сигмоїди підбирає будь-яку неспадну функцію
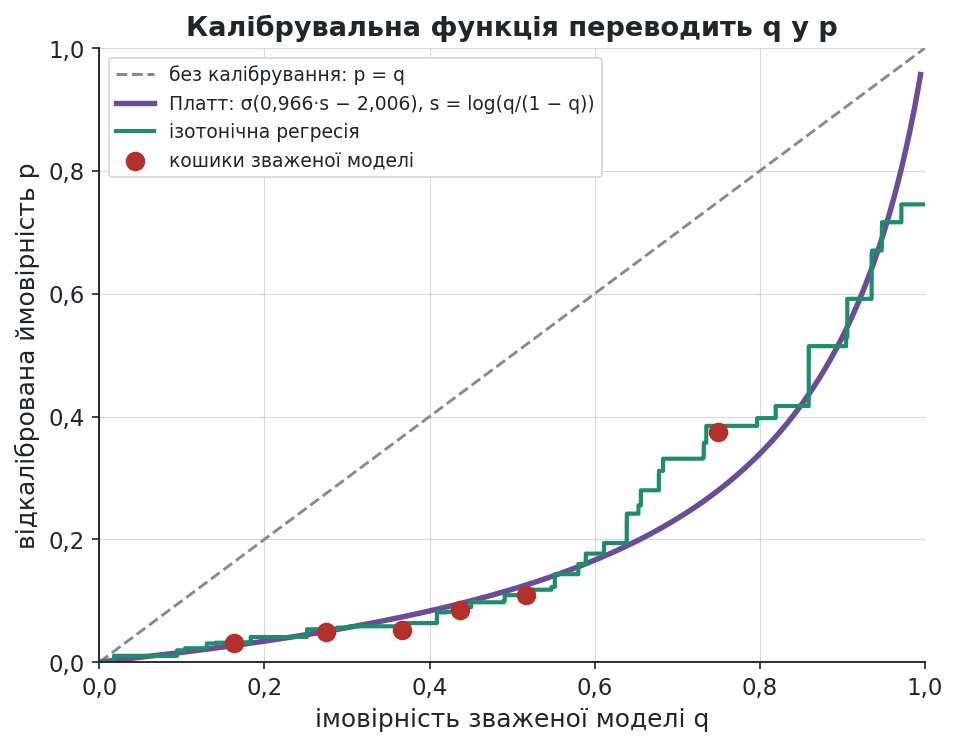
Калібрувальні функції для зваженої моделі: по горизонталі — її ймовірність
Калібрування лагодить зважену модель
Перевіримо на тих самих даних. Метод Платта напишемо з нуля — це чотири рядки — і порівняємо з бібліотечним CalibratedClassifierCV.
Вивід код запущено, вивід не редагувався
text
Платт з нуля: a = 0.966, b = -2.006
  логіт 0: було 0.500, стало 0.119
  логіт 2: було 0.881, стало 0.482
Платт, бібліотека: a = 0.966, b = -2.006
модель             ROC-AUC  Брайєр  середня p
Платт з нуля        0.7748  0.0857     0.119
Платт, бібліотека   0.7748  0.0857     0.119
ізотонічна          0.7746  0.0850     0.119
На що дивитися: Платт із нуля і бібліотека дають ті самі a = 0,966 і b = −2,006; Брайєр падає з 0,1850 до 0,0857, в ізотонічної — до 0,0850, середня ймовірність повертається до 0,119, а ROC-AUC лишається майже тим самим.
Калібрування — монотонне перетворення, тож ROC-AUC його майже не помічає; погане калібрування видно лише за мірою Брайєра чи кривою. Зверніть увагу:
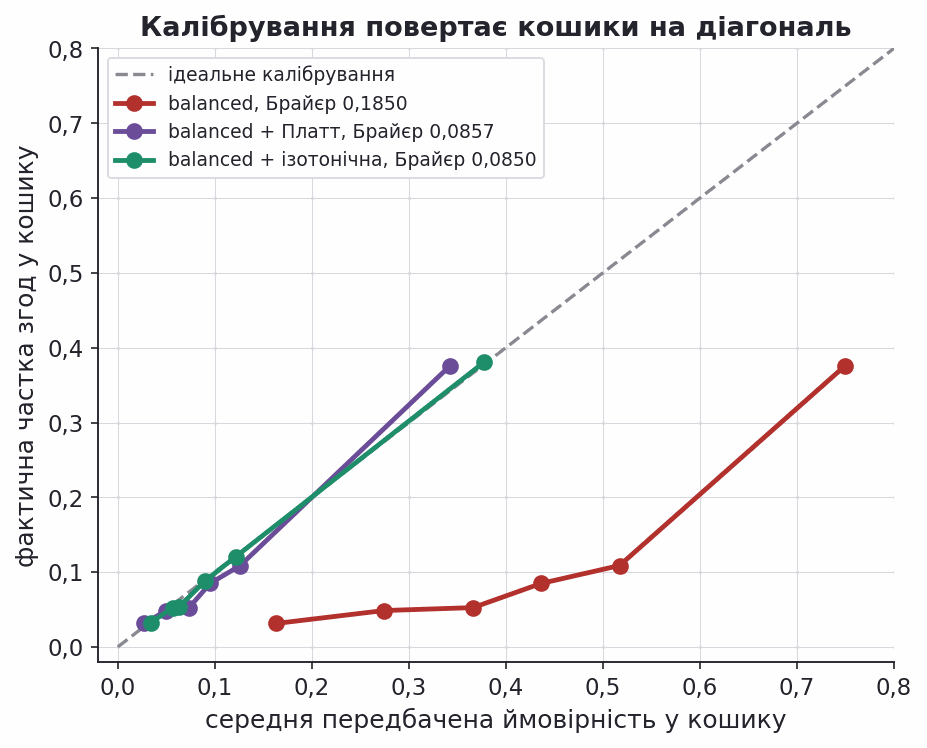
Зважена модель до калібрування (червоним) і після нього: метод Платта (фіолетовим) та ізотонічна регресія (зеленим) повертають кошики майже на діагональ.
Метод Платта: два числа лагодять імовірності
Зважена модель на 13 564 тестових клієнтах Bank Marketing. Кожен логіт s перетворюємо на p = σ(a·s + b) і дивимося, куди рушають шість кошиків і як змінюється міра Брайєра.
без калібрування поточні a і b пунктир — ідеальне калібрування
0,1850міра Брайєра
0,418середня p; частка згод 0,117
0,500p при s = 0, тобто σ(b)
0,7748ROC-AUC — однаковий при будь-якому a > 0
Без калібрування зважена модель обіцяє в середньому 0,418 при частці згод 0,117, і всі кошики лежать праворуч від діагоналі; Брайєр 0,1850. Кнопка «Платт» ставить ті a і b, які підібрав CalibratedClassifierCV у коді розділу: кошики лягають на діагональ, Брайєр 0,0857. Клієнт із логітом s = 0, якому зважена модель давала рівно 0,5, тепер отримує σ(−2,006) = 0,119. Третя кнопка лишає a = 1 і зсуває логіт лише на логарифм шансів згоди, log(0,117/0,883) = −2,021, — і дає той самий Брайєр 0,0857: зважування класів здебільшого просто зсунуло логіт на цю величину. Тепер посуньте a: кошики розходяться віялом, а ROC-AUC стоїть на місці — порядок клієнтів той самий.
Зважування класів не замінює правильного порога
Зважування не марне — воно робить непрямо те, що поріг робить прямо, але ламає калібрування, як ми щойно бачили на банківських даних.
Тому поріг 0,0376, обчислений із цін, до зваженої моделі застосовувати не можна — вона дасть 36 834 хибні тривоги. Кожній моделі потрібен свій поріг, підібраний на навчальній частині за прогнозами перехресної перевірки; тест — лише для підсумку.
Вивід код запущено, вивід не редагувався
text
зважена модель із порогом за ціною: збиток 184298, хибних тривог 36834
звичайна  поріг 0.0131 → збиток на тесті 3537
зважена   поріг 0.9763 → збиток на тесті 3665
На що дивитися: із порогом для чесних імовірностей зважена модель дає збиток 184 298, а з власним порогом, підібраним без тесту, майже наздоганяє звичайну — 3665 проти 3537; різниця 128 — це ціна одного пропущеного шахрайства.
Зверніть увагу й на звичайну модель: поріг, підібраний за даними (0,0131), дає менший збиток, ніж формула
Правило: спершу отримайте чесні ймовірності, потім окремо ухваліть рішення про поріг. Ваги за цінами помилок цьому не суперечать: вони вбудовують справжні ціни, тож рішення при порозі 0,5 виходить добрим, але ймовірності такої моделі вже не чесні, і для будь-якого іншого використання їх доведеться калібрувати.
Мультиклас: one-vs-rest і softmax
Класів може бути більше двох — у наборі Iris їх три. Є два шляхи.
One-vs-rest навчає
Softmax (мультиноміальна логістична регресія) навчає всі класи спільно: клас
Експонента робить кожну оцінку додатною, знаменник нормує їх у суму 1. Наприклад, оцінки
Джерело оцінок прикладу: Stanford CS231n · Linear Classification
Вивід код запущено, вивід не редагувався
text
softmax      правильно на тесті: 44 із 45
one-vs-rest  правильно на тесті: 38 із 45
На що дивитися: спільне навчання вгадує 44 квітки з 45 (0,978), незалежні класифікатори — 38 (0,844).
One-vs-rest програє на середньому класі: versicolor лежить між двома іншими, і одна пряма «versicolor проти решти» не відділить його з обох боків — шість його квіток іде до virginica.
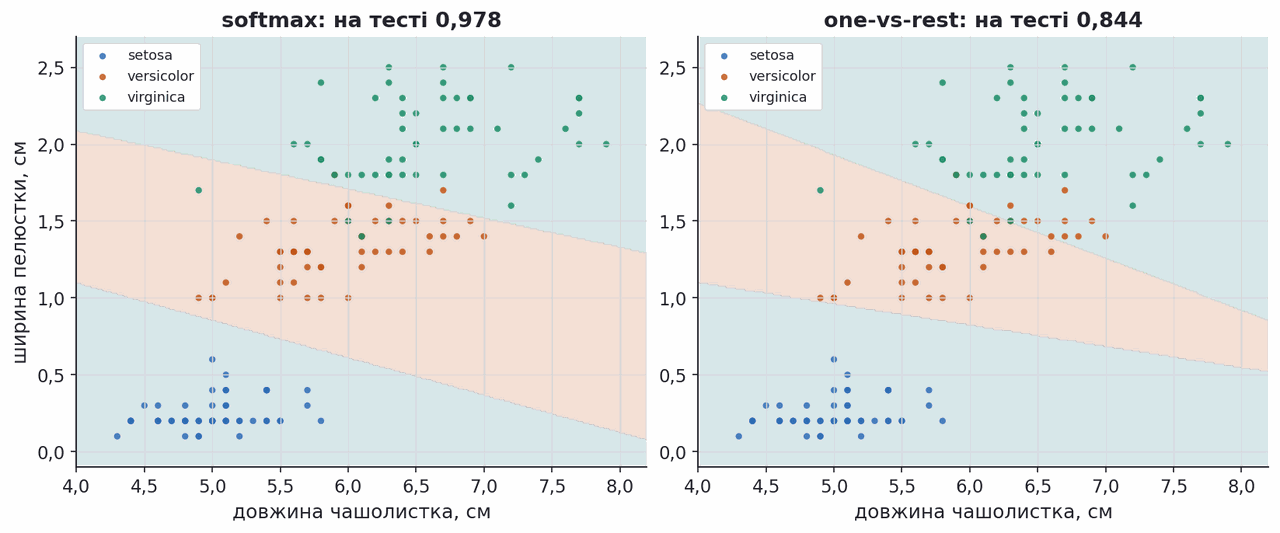
Області рішень обох підходів на двох ознаках Iris; точки — усі 150 квіток, у заголовку — частка правильних відповідей на тесті.
Softmax: від оцінок до ймовірностей
Три оцінки (логіти) zk = wk⊤x + bk. Експонента робить їх додатними, ділення на суму — імовірностями. Втрата — −log імовірності правильного класу.
| клас | оцінка z | ez | p = ez / сума | |
|---|---|---|---|---|
| 1 | −2,85 | 0,058 | 0,015 | |
| 2 | 0,86 | 2,363 | 0,631 | |
| 3правильний | 0,28 | 1,323 | 0,353 | |
| сума | 3,744 | 1,000 |
правильний клас:
1,040перехресна ентропія −log p3
0,641p₂ / (p₂ + p₃): лише класи 2 і 3
0,641σ(z₂ − z₃) = σ(0,58)
Стартові оцінки — з розділу: експоненти 0,058, 2,363 і 1,323 у сумі 3,744 дають імовірності 0,015, 0,631 і 0,353, і за правильного третього класу втрата −log 0,353 = 1,040. Натисніть «додати 2 до всіх»: експоненти зростуть у e² ≈ 7,39 раза, а ймовірності не зміняться — softmax бачить лише різниці оцінок. «Помножити всі на 2» робить розподіл різкішим, так само як довжина вектора ваг робила різкішою сигмоїду. Два останні числа завжди однакові: для пари класів softmax — це сигмоїда від різниці їхніх оцінок. Поверніться до прикладу розділу й оберіть правильним клас 1: модель дає йому лише 0,015, і втрата зростає до 4,17.
Softmax як одношарова мережа
Softmax-регресію зручно бачити як мережу з одного шару: кожен вхід з'єднаний із кожним виходом, а виходів рівно стільки, скільки класів.
У лекції 10 нейронна мережа для класифікації матиме ту саму будову, лише між входом і softmax-шаром з'являться приховані шари, які будують ознаки замість людини; останній шар і функція втрат лишаться тими самими.
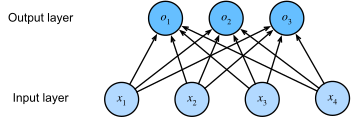
Англійські підписи: Input layer — вхідний шар (ознаки x₁–x₄), Output layer — вихідний шар (o₁–o₃, по виходу на клас).
Обмеження логістичної регресії
Межа рішення лише лінійна. Класи, розділені колом чи спіраллю, лінійна модель не розділить. Лікування — нелінійні ознаки вручну, ядрові методи (лекція 07) або нейронні мережі (лекція 10).
Чутливість до масштабу ознак. Без стандартизації результат залежить від того, у яких одиницях виміряна кожна ознака.
Проблеми при мультиколінеарності. Якщо дві ознаки майже дублюють одна одну, без регуляризації ваги між ними нестійкі: невелика зміна даних перерозподіляє їх, і окремий коефіцієнт важко тлумачити.
Імовірності потребують перевірки. Логістична регресія калібрована, лише якщо правильно описує дані, а зважування класів калібрування псує, — тож перевіряйте кривою калібрування.
Підсумок лекції
Класифікація не зводиться до регресії. Квадратична втрата карає впевнені правильні відповіді, тому потрібна інша функція втрат.
Ланцюжок «ймовірність → шанси → логарифм шансів» дозволяє моделювати лінійно логарифм шансів, а сигмоїда повертає з нього ймовірність в інтервалі
Перехресна ентропія — не довільний вибір, а прямий наслідок максимальної правдоподібності для розподілу Бернуллі. Її градієнт має ту саму форму «прогноз мінус мітка», що й у методі найменших квадратів, і повториться в нейронних мережах.
Оцінювання важливіше за навчання. Частка правильних відповідей обманює при дисбалансі; дивитись треба на матрицю похибок, точність, повноту й криві ROC або точність–повнота. AUC — частка правильно впорядкованих пар — бачить лише порядок оцінок.
Поріг — це рішення про ціну помилки, і в медичній задачі його свідомо зсувають від 0,5.
Дисбаланс лікують на чотирьох рівнях: метрики, поріг за ціною, ваги класів чи фокальна втрата, передискретизація. Більшість способів лише зсуває межу і псує ймовірності; найдешевше працюють поріг або ваги, що відповідають справжнім цінам помилок.
Спершу чесні ймовірності, потім поріг. Калібрування перевіряють кривою, якість імовірностей підсумовує міра Брайєра, а зіпсовані ймовірності лагодить метод Платта чи ізотонічна регресія.
Джерела й додаткові матеріали
Курси, на яких побудовано лекцію
- EPFL CS-433 — лекції 05a і 05b
- UBC CPSC 340 — лекції 18–19: сурогатні втрати, мультиклас
Підручники
- Hastie, Tibshirani, Friedman. The Elements of Statistical Learning — розділ 9: ROC
- Bishop. Pattern Recognition and Machine Learning — розділ 4
Документація
- scikit-learn · Logistic regression
- scikit-learn · Metrics and scoring
- Breast Cancer Wisconsin, UCI
- Bank Marketing, UCI
- Credit Card Fraud Detection, Kaggle
- scikit-learn · Probability calibration
- imbalanced-learn · User guide — передискретизація, SMOTE, недодискретизація
Статті
- Chawla et al. SMOTE: Synthetic Minority Over-sampling Technique, 2002
- Lin et al. Focal Loss for Dense Object Detection, 2017