Тема
Лекція 09 · Зниження розмірності та матричні розклади
Минулого разу ми шукали в даних групи схожих об'єктів. Сьогодні розв'язуємо суміжну задачу без учителя: не ділимо об'єкти на кластери, а стискаємо кожен із них до кількох чисел, які зберігають майже всю інформацію. Той самий апарат дасть нам і карту даних на площині, і рекомендаційну систему.
Зміст лекції
Уся лекція розкручується з однієї ідеї: замінити багато корельованих ознак невеликим набором спільних «частин».
- Прокляття розмірності. Чому в просторі з сотень ознак відстані втрачають зміст і навіщо стискати дані.
- Метод головних компонент. Розклад
, його геометрія та зв'язок дисперсії з помилкою реконструкції. - SVD і обчислення PCA. Сингулярний розклад, вибір числа компонент, роль масштабування, власні обличчя.
- Нелінійні розклади. Ядровий PCA і шумозаглушення зображень.
- Матричний розклад і рекомендації. Оцінки з пропусками, латентні фактори, SGD і ALS, приз Netflix.
- Візуалізація багатовимірних даних. Многовиди, t-SNE, UMAP і чесні межі таких карт.
Блоки 2–5 — це та сама модель
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, що саме ламається у високій розмірності і чому це шкодить методам, які спираються на відстані;
- записати PCA як матричний розклад
і назвати, що означає кожна з двох матриць; - довести собі, що максимізація дисперсії проєкцій і мінімізація помилки реконструкції — та сама задача;
- обчислити головні компоненти через сингулярний розклад і обрати число компонент за поясненою дисперсією;
- пояснити, чому перед PCA ознаки треба стандартизувати, і показати, що буде без цього;
- побудувати рекомендаційну систему як матричний розклад із пропусками та навчити її стохастичним градієнтним спуском;
- прочитати карту t-SNE й перелічити три речі, які на ній читати не можна.
Зі зростанням числа ознак відстані перестають розрізняти
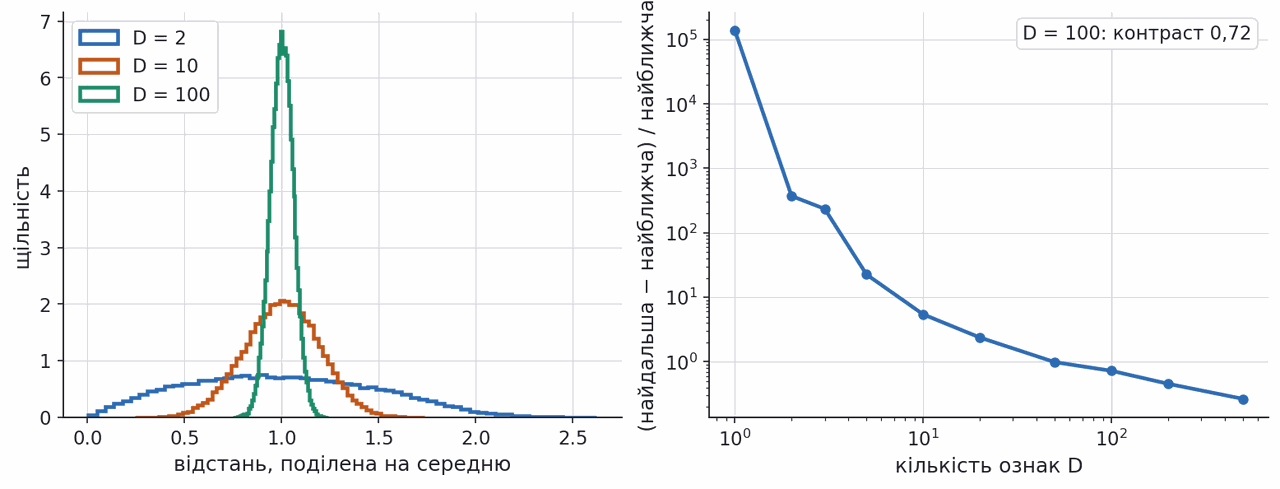
Уявімо, що об'єкти рівномірно розкидані в одиничному кубі. У двох вимірах є близькі й далекі пари: гістограма відстаней широка. У ста вимірах усі попарні відстані стискаються навколо одного значення — випадкові координати усереднюються, і кожна пара точок виявляється приблизно однаково далекою.
Праворуч те саме як число: відношення «найдальша мінус найближча, поділене на найближчу». При
Наслідок практичний: методи, побудовані на відстанях, — k найближчих сусідів, k-means, ядрові методи — у такому просторі перестають розрізняти об'єкти. Прокляття розмірності (curse of dimensionality) і є першою причиною стискати дані.
Дані лекції: 1797 рукописних цифр 8 × 8
Основний набір даних лекції — Optical Recognition of Handwritten Digits. Кожна цифра оцифрована як зображення 8 × 8 пікселів, яскравість пікселя — ціле число від 0 до 16. Розгорнувши зображення в рядок, отримуємо 1797 спостережень по 64 ознаки.
На рисунку показано фрагмент вибірки. Людина бачить тут цифру. Комп'ютер бачить 64 числа, і сусідні пікселі в них майже завжди схожі: контур цифри займає невелику частину клітинок, а кути зображення майже завжди порожні. Отже, справжніх «ступенів свободи» в цих даних значно менше за 64 — саме їх ми й шукатимемо.
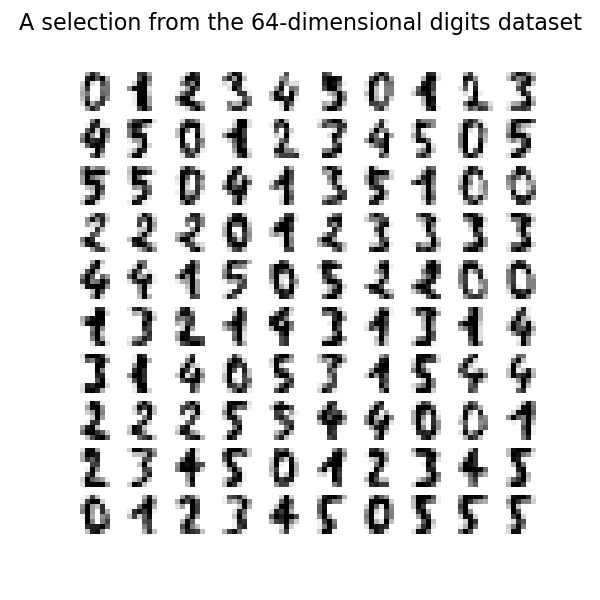
Джерело зображення: scikit-learn · Manifold learning on handwritten digits · дані: UCI Machine Learning Repository
Замість пікселів — спільні «частини»
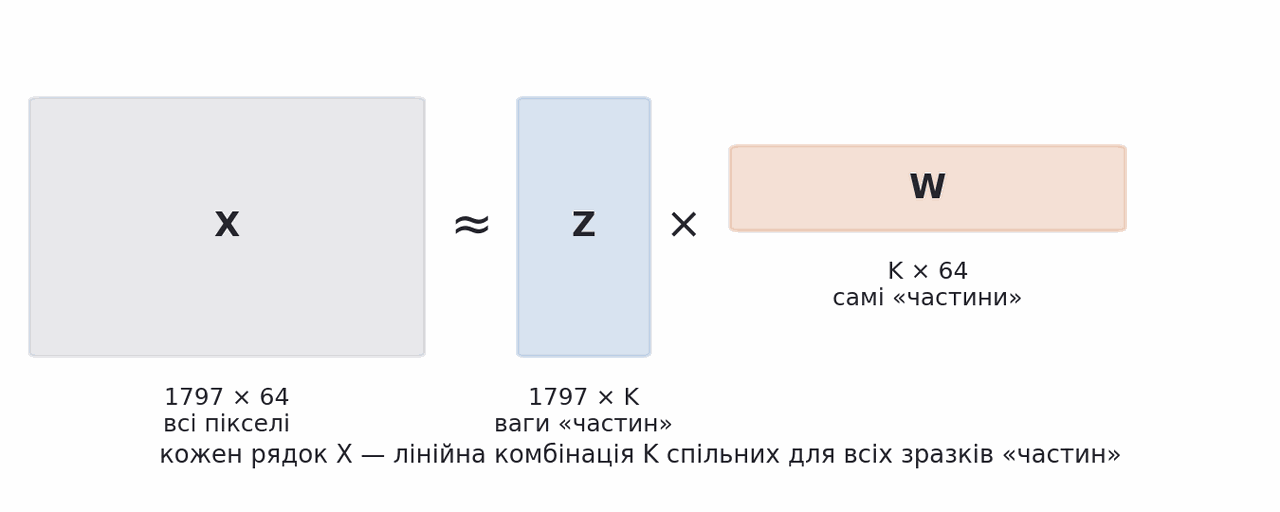
Ідея моделі латентних факторів (latent-factor model) така: знайти невелику кількість «частин», спільних для всіх зображень, і описувати кожну цифру тим, скільки якої частини в ній узято.
Рядок
Це один об'єкт із чотирма прочитаннями: скалярний добуток для кожної клітинки, добуток матриці на вектор для кожного рядка, розклад матриці на дві та зміна базису, у якому
Від k-means до PCA: ваги замість одного центроїда
Найпростіший матричний розклад ми вже бачили. У k-means кожен об'єкт замінюється найближчим центроїдом; мовою факторів це означає, що
| k-means | PCA | |
|---|---|---|
| подання | одна одиниця, решта нулі | будь-які дійсні числа |
| апроксимація об'єкта | найближчий центроїд | лінійна комбінація |
| цільова функція | сума квадратів відхилень | та сама сума квадратів |
| розв'язок | локальні мінімуми, задача NP-складна | глобальний мінімум через SVD |
Різниця одна, але вирішальна: k-means дозволяє взяти рівно одну частину цілком, PCA — довільну суміш кількох, зокрема з дробовими й від'ємними вагами. Тому за тієї самої кількості чисел на об'єкт PCA описує дані точніше.
Геометрія: PCA міряє відстань по перпендикуляру
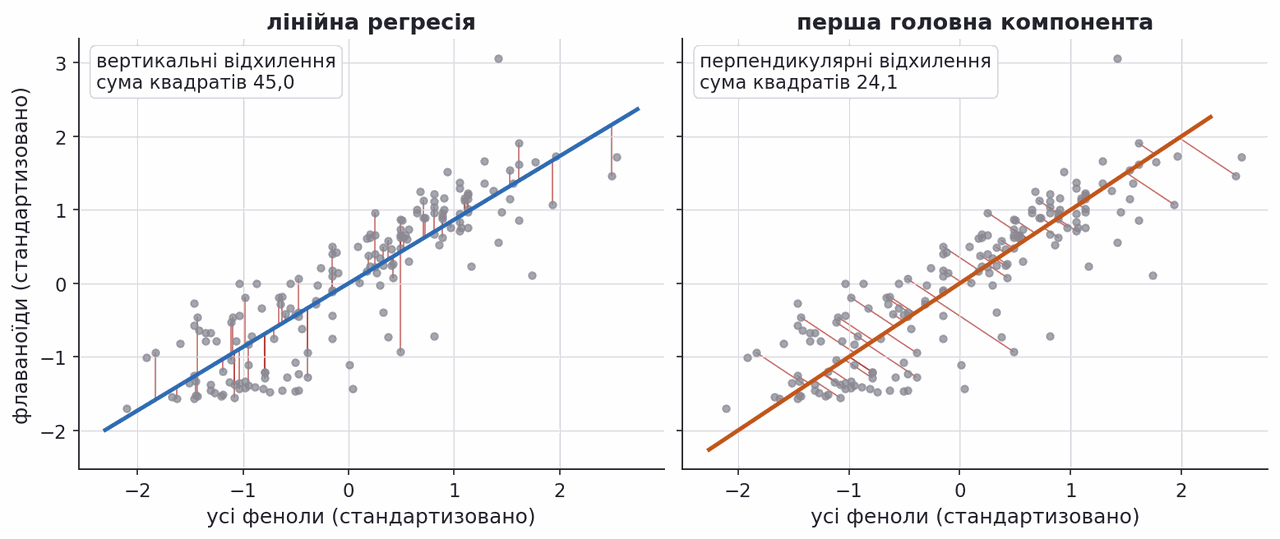
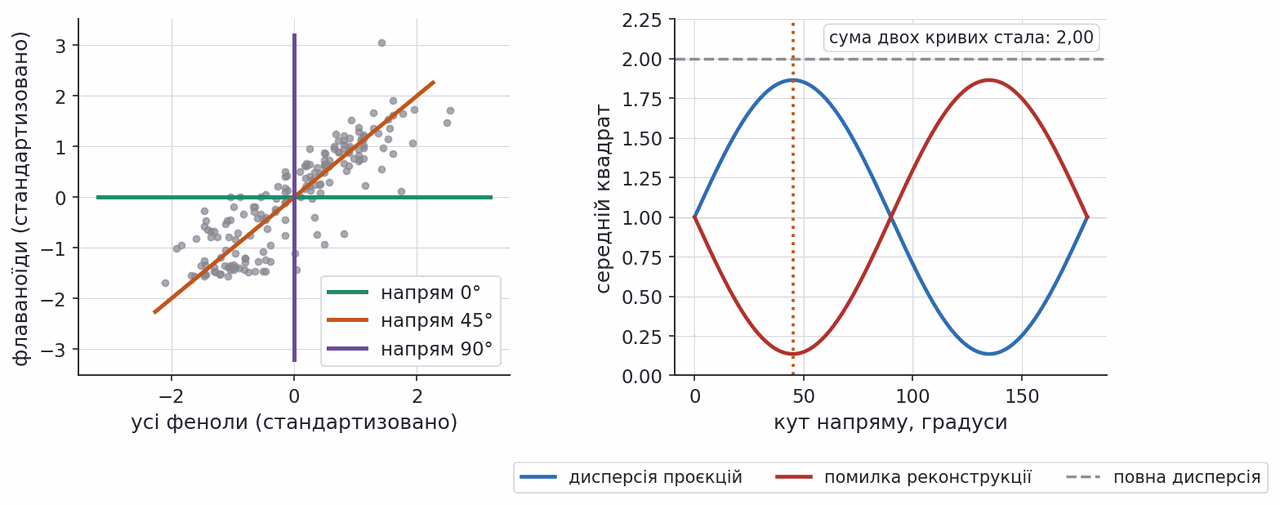
Візьмімо дві стандартизовані ознаки Wine — сумарний вміст фенолів і вміст флаваноїдів. Їхня кореляція 0,86, хмара точок витягнута вздовж діагоналі.
Ліворуч звична лінійна регресія: вона мінімізує вертикальні відхилення, бо вважає одну ознаку відповіддю, а другу — входом. Праворуч перша головна компонента: тут обидві ознаки рівноправні, а мінімізується перпендикулярна відстань до прямої.
Числа на панелях міряють різні величини, тому 45,0 і 24,1 порівнювати між собою не можна. Чесне порівняння інше: якщо для тієї самої прямої регресії порахувати перпендикулярні відхилення, вийде 25,7 проти 24,1 у головної компоненти. Пряма регресії проходить близько, але оптимальна вона для іншої задачі.
Цільова функція розкладу і чому дані центрують
Формально ми шукаємо дві матриці, добуток яких найближчий до даних у сенсі суми квадратів:
| Позначення | Значення |
|---|---|
| кількість зразків і кількість вихідних ознак | |
| кількість компонент, яку ми обираємо | |
| норма Фробеніуса, корінь із суми квадратів усіх елементів |
Перед розкладом кожну ознаку центрують:
Максимум дисперсії і мінімум помилки — та сама задача
Головну компоненту описують двома способами, які на перший погляд різні. Погляд синтезу: шукаємо пряму, до якої точки найближчі. Погляд аналізу: шукаємо напрям, уздовж якого проєкції найбільше розкидані.
"Synthesis view: PCA finds hyper-plane minimizing distance to data
. Analysis view: PCA finds hyper-plane maximizing variance in space." — UBC CPSC 340, лекція 27
Рисунок показує, чому ці два описи еквівалентні. Праворуч дві криві: дисперсія проєкцій і середня помилка реконструкції як функції кута напряму. За теоремою Піфагора їхня сума стала і дорівнює повній дисперсії даних, тут 2,00. Отже, максимум однієї кривої припадає рівно на мінімум другої — на кут 45°, бісектрису хмари.
Джерело формулювання: UBC CPSC 340
Головні компоненти — власні вектори коваріаційної матриці
Погляд аналізу перетворює задачу на класичну задачу лінійної алгебри. Для центрованих даних вибіркова коваріаційна матриця та перший напрям задаються так:
Розв'язок відомий:
Перевіримо на двох ознаках Wine із попереднього розділу. Після стандартизації коваріаційна матриця дорівнює кореляційній: на діагоналі одиниці, поза нею 0,86. Її власні значення —
Джерело: Bishop, Pattern Recognition and Machine Learning, §12.1
Код: головні компоненти в чотири рядки через SVD
Власні вектори коваріаційної матриці на практиці не рахують: сингулярний розклад
Вивід код запущено, вивід не редагувався
text
частка дисперсії перших 10: 0.738
W ортонормована: True
те саме, що PCA з точністю до знака: True
На що дивитися: десять компонент із шістдесяти чотирьох утримують 73,8 % дисперсії, а два True підтверджують, що ручний SVD дає ті самі ортонормовані компоненти, що й PCA.
Порівняння «з точністю до знака» тут не хитрість, а наслідок наступного розділу.
Розклад не єдиний: чотири джерела свободи
Матриці
| Свобода | Домовленість, яка її знімає |
|---|---|
| масштаб: | нормування |
| довільне обертання всередині підпростору | ортогональність |
| перестановка компонент | послідовний пошук: спершу |
| знак: | перший ненульовий елемент |
Практичний висновок: помилка реконструкції та сума пояснених дисперсій визначені однозначно, а от знак координат — ні. Тому дві реалізації PCA можуть дати дзеркально відображену картинку, і це не помилка.
Одна тонкість: сам підпростір однозначний лише тоді, коли між
Wine: тринадцять ознак у двох числах
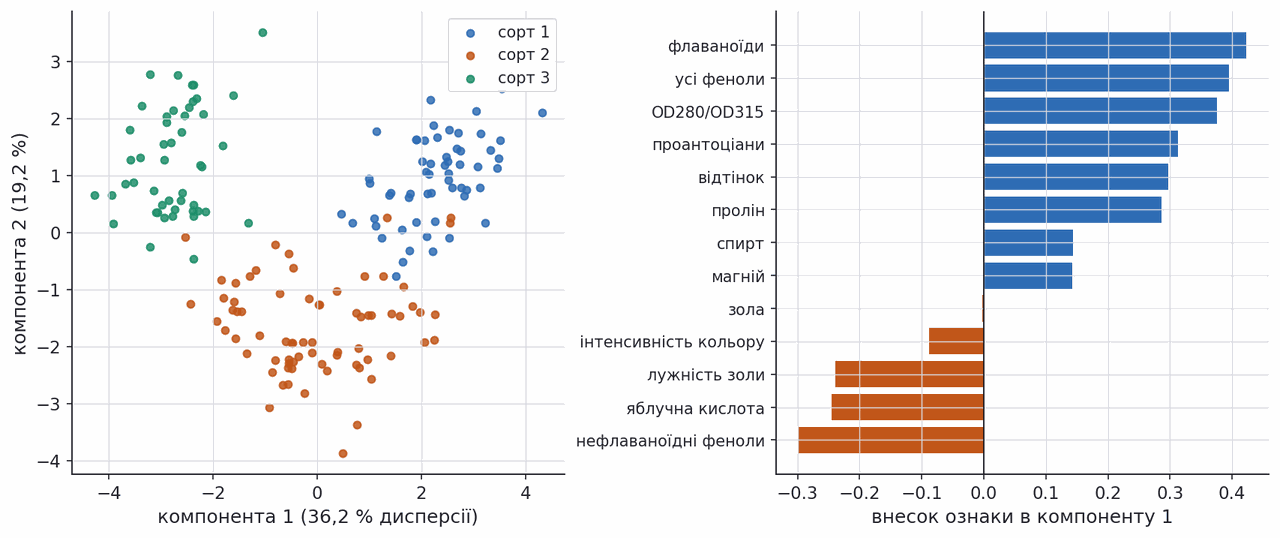
Набір Wine — 178 зразків вина трьох сортів, тринадцять хімічних вимірювань: вміст спирту, фенолів, флаваноїдів, магнію, інтенсивність кольору, кількість проліну та інші. Мітка сорту в PCA не використовується.
Ліворуч кожен зразок показано двома першими компонентами замість тринадцяти ознак. Вони утримують 36,2 % і 19,2 % дисперсії, разом 55,4 %, і цього досить, щоб три сорти розійшлися майже без перекриття.
Праворуч видно, з чого зроблена перша компонента. Найбільші додатні внески дають флаваноїди (+0,42), сумарні феноли (+0,40) і показник OD280/OD315 (+0,38), найбільші від'ємні — нефлаваноїдні феноли (−0,30), яблучна кислота (−0,25) і лужність золи (−0,24). Тобто перша компонента — це вісь «фенольна насиченість», якої жодна окрема ознака не вимірює.
Джерело даних: UCI Machine Learning Repository
Без стандартизації PCA слухає найбільшу ознаку
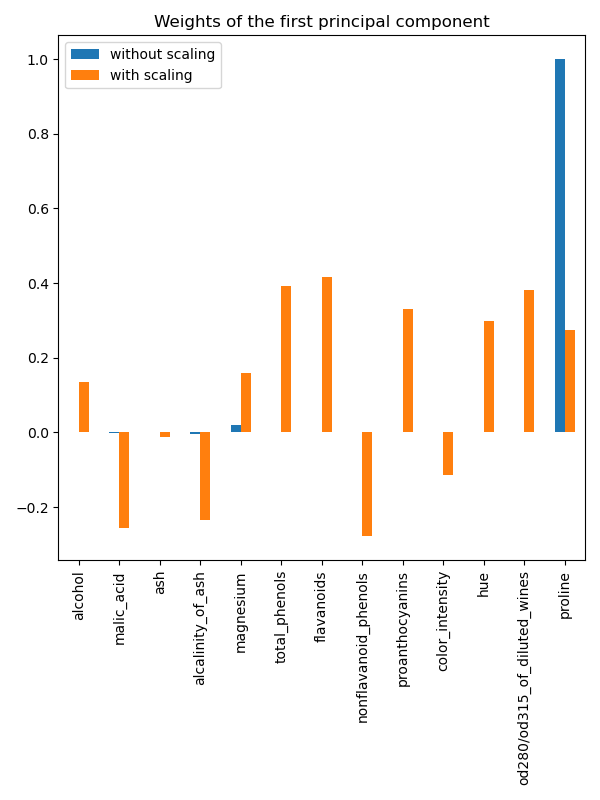
PCA максимізує дисперсію, а дисперсія залежить від одиниць виміру. У Wine вміст проліну — сотні одиниць, а відтінок — близько одиниці; квадрат першого числа більший у мільйони разів.
Вивід код запущено, вивід не редагувався
text
сирі: перша компонента пояснює 0.998
  proline                      +1.000
  magnesium                    +0.018
  alcalinity_of_ash            -0.005
стандартизовані: перша компонента пояснює 0.362
  flavanoids                   +0.423
  total_phenols                +0.395
  od280/od315_of_diluted_wines +0.376
На що дивитися: на сирих даних перша компонента — це майже чистий пролін із вагою 1,000, бо в нього найбільший масштаб; після стандартизації її формують кілька хімічних ознак разом.
На сирих даних перша компонента «пояснює» 99,8 % дисперсії, а вага проліну в ній дорівнює 1,000 проти 0,018 у наступної ознаки: компонента складається з самого проліну. Після стандартизації вона пояснює лише 36,2 %, зате складається з флаваноїдів (0,423), фенолів (0,395) і оптичної густини (0,376) — тобто описує хімію вина, а не вибір одиниць.
Пастка саме в числі 99,8 %: воно виглядає як чудовий результат, а означає, що PCA не знайшов нічого, крім найбільшої за масштабом колонки.
Правило просте: якщо ознаки в різних одиницях, перед PCA потрібен StandardScaler. Виняток — коли всі ознаки однорідні за природою й шкалою, як яскравість пікселів у наших цифрах.
Вибір числа компонент за поясненою дисперсією
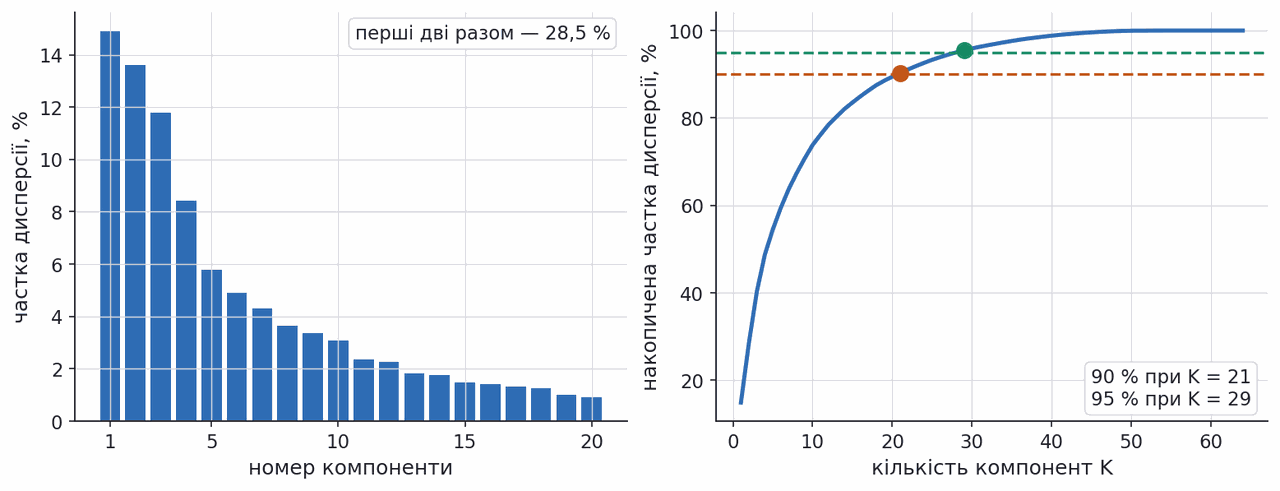
Частка дисперсії, яку утримують перші
Ліворуч — внесок кожної з перших двадцяти компонент для наших цифр: перша дає близько 15 %, перші дві разом 28,5 %, далі внески швидко спадають. Праворуч — накопичена крива: 90 % дисперсії набирається на 21 компоненті, 95 % — на 29 із 64.
Звична домовленість — брати найменше
IncrementalPCA працює, коли дані не влазять у пам'ять
Досі PCA бачив усю матрицю одразу. У проєкті так буває не завжди: MNIST у подвійній точності — це 440 мегабайтів, а справжні набори бувають на порядки більші. IncrementalPCA навчається частинами й тримає в пам'яті лише поточний блок.
Вивід код запущено, вивід не редагувався
text
частинами : 0.8244
повністю  : 0.8254
блок у пам'яті: 3.1 МБ проти 220 МБ
На що дивитися: навчання частинами втрачає лише 0,001 поясненої дисперсії, зате одночасно тримає в пам'яті 3,1 МБ замість 220.
П'ятдесят компонент пояснюють 0,8244 дисперсії при навчанні частинами проти 0,8254 при повному — різниця в третьому знаку. У пам'яті натомість 3,1 мегабайта замість 220.
Але за це платять часом: повний PCA впорався за 0,1 секунди, покроковий — за 9,7. Це не оптимізація, а обмін: ви віддаєте швидкість за можливість працювати з даними, які в пам'ять не поміщаються. Якщо вони поміщаються, звичайний PCA кращий у всьому.
Реконструкція цифр із K чисел
Пояснена дисперсія — абстрактне число. Подивімося, як воно виглядає: беремо вісім цифр, стискаємо кожну до
Двох компонент (29 % дисперсії) вистачає лише на розмиту пляму: нуль ще вгадується, решта — ні. Вісім компонент (67 %) уже дають упізнавані цифри, хоча тонкі деталі втрачено. Шістнадцять (85 %) майже не відрізняються від оригіналу на око, тридцять дві (97 %) — тим паче.
Отже, «зайвих» вимірів у зображенні справді багато: чверть початкового обсягу зберігає всю зорову інформацію. Це і є стиснення з втратами, кероване одним параметром
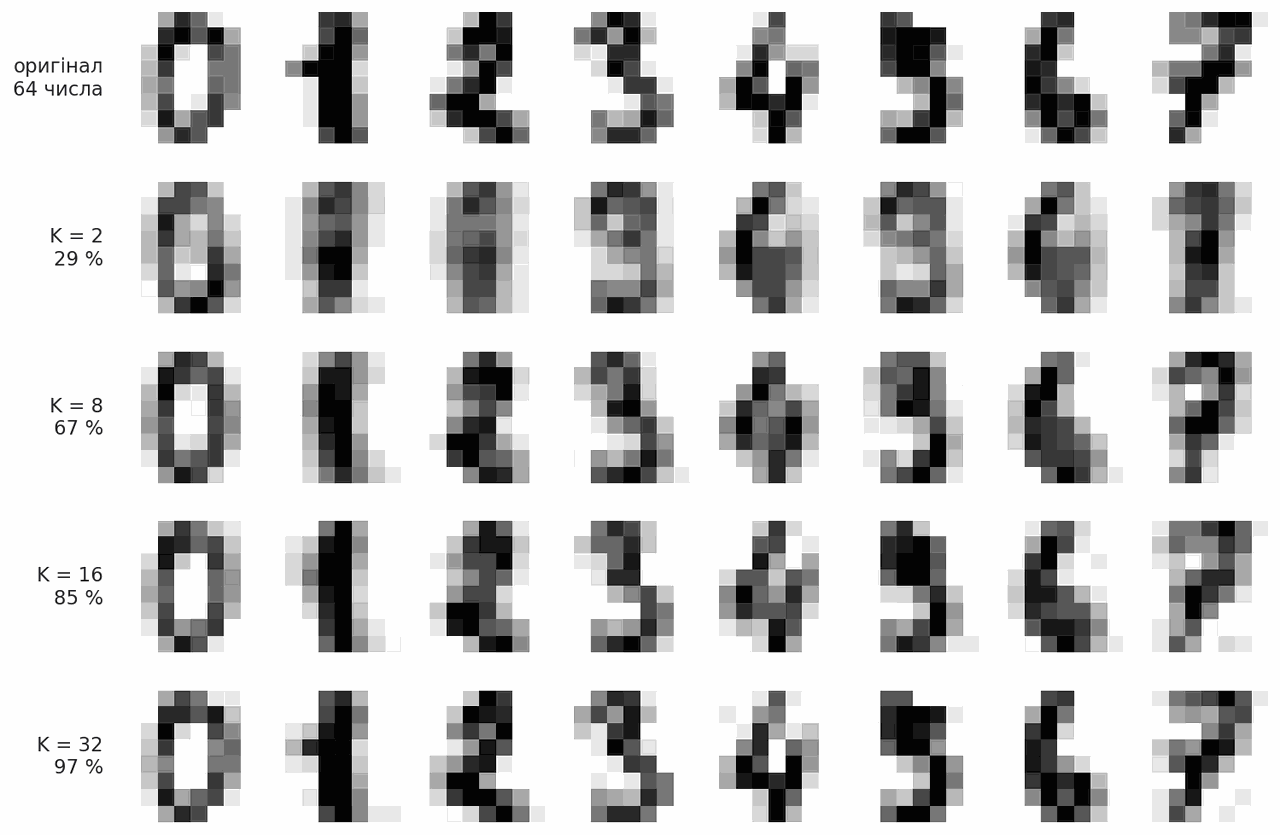
Скільки чисел треба, щоб цифра лишилася цифрою
Ті самі вісім цифр, що на рисунку. Верхній ряд — оригінал у 64 пікселі, нижній — відновлення з K чисел за формулою zₙW + μ. Обчислюється просто тут: посуньте K і дивіться, коли цифра стає впізнаваною.
оригінал
64 числа
64 числа
відновлено
8 чисел
8 чисел
67 %поясненої дисперсії
8,0×стиснення обсягу
8 / 64чисел на зображення
Двох компонент (29 %) вистачає лише на розмиту пляму: нуль ще вгадується, решта — ні. Вісім (67 %) уже дають упізнавані цифри, шістнадцять (85 %) майже не відрізняються на око, тридцять дві (97 %) — тим паче. Отже, «зайвих» вимірів у зображенні справді багато: чверть початкового обсягу зберігає всю зорову інформацію. Це і є стиснення з втратами, кероване одним параметром K. Зверніть увагу, що при малих K на місці нуля може з'явитися сірий фон — відновлення не зобов'язане лишатися в діапазоні яскравості.
Код: PCA на цифрах через scikit-learn
У scikit-learn потрібне число компонент можна не задавати, а зажадати частку дисперсії — бібліотека сама візьме найменше
Вивід код запущено, вивід не редагувався
text
K: 21
пояснена дисперсія: 0.903
середня похибка на піксель: 0.9 з 16
стиснення: 3.0 разу
На що дивитися: 21 компонента з 64 зберігає 90,3 % дисперсії, і відновлений піксель помиляється в середньому на 0,9 за шкалою 0–16.
Центрування PCA робить сам, а inverse_transform додає збережене середнє назад.
Джерело: scikit-learn · PCA
Число компонент можна обирати за якістю класифікації
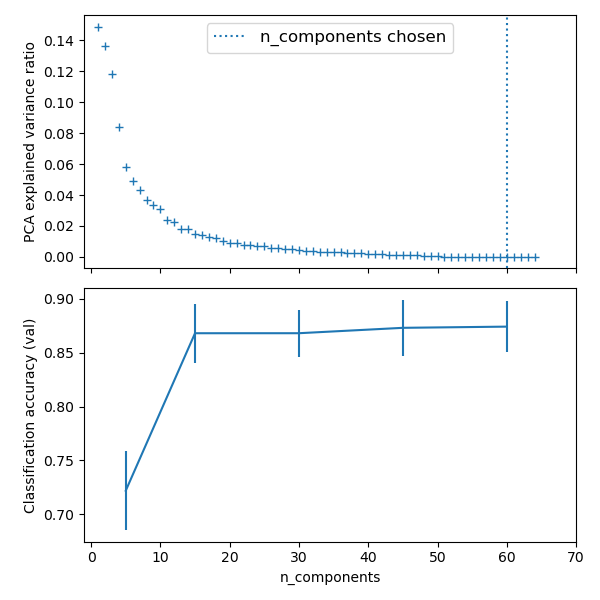
Пояснена дисперсія — критерій самого PCA. Коли ж стиснення є лише кроком перед моделлю з учителем, розумніше обирати
На рисунку PCA і логістичну регресію зібрано в один конвеєр, а GridSearchCV перебирає число компонент разом із силою регуляризації. Точність перехресної перевірки різко зростає до п'ятнадцяти компонент і далі виходить на полицю; формально найкращою виявляється конфігурація з шістдесятьма компонентами й оцінкою 0,874.
Висновок обережний: два критерії не зобов'язані збігатися. Для 90 % дисперсії вистачало 21 компоненти, а класифікатору майже байдуже, брати 15 чи 60 — різниця в точності менша за відсотковий пункт і навряд чи варта вчетверо довшого вектора.
Джерело: scikit-learn · Pipelining: chaining a PCA and a logistic regression
Breast Cancer: PCA нічого не знає про діагноз
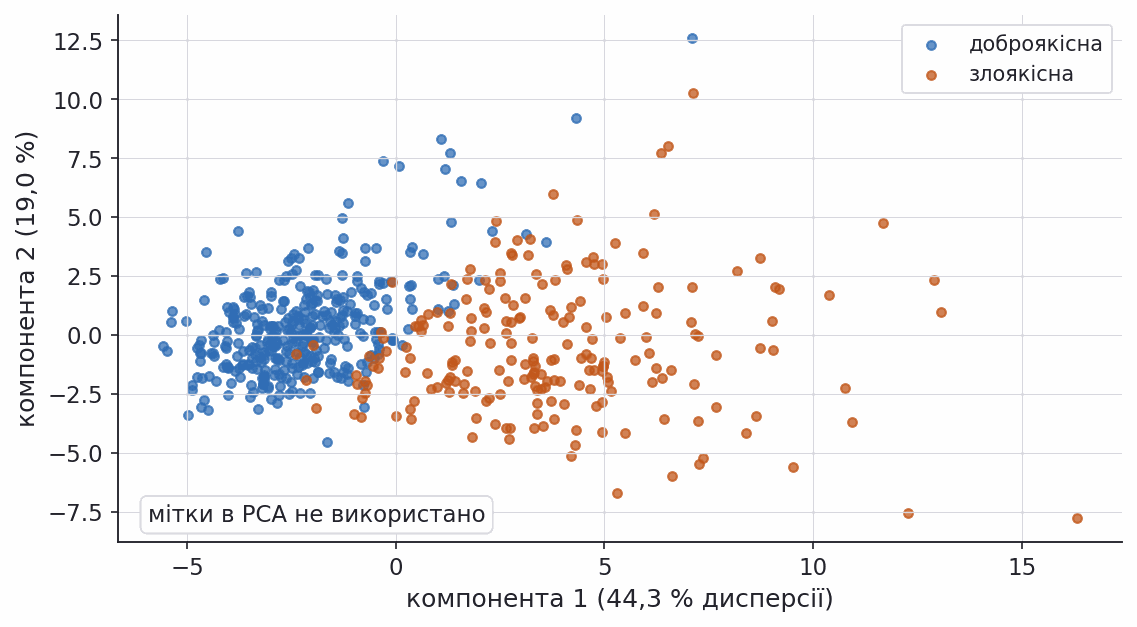
Набір Breast Cancer Wisconsin із лекції 05 має тридцять ознак, обчислених із зображення біопсії, і вони сильно корельовані: радіус, периметр і площа ядра описують по суті один і той самий розмір.
PCA бачить лише матрицю чисел — мітки «доброякісна» чи «злоякісна» в розклад не подавали. Проте на площині двох перших компонент, які утримують 44,3 % і 19,0 % дисперсії, класи розходяться майже повністю. Кольори тут додано вже після побудови, щоб перевірити результат.
Це і корисно, і небезпечно. Корисно: коли структура даних узгоджена з міткою, PCA працює як безкоштовний відбір ознак — 90 % дисперсії тут утримують 7 компонент із 30. Небезпечно: ніхто цього не гарантує, і напрям найбільшої дисперсії цілком може виявитися неінформативним для задачі.
Власні обличчя: компоненти, які видно очима
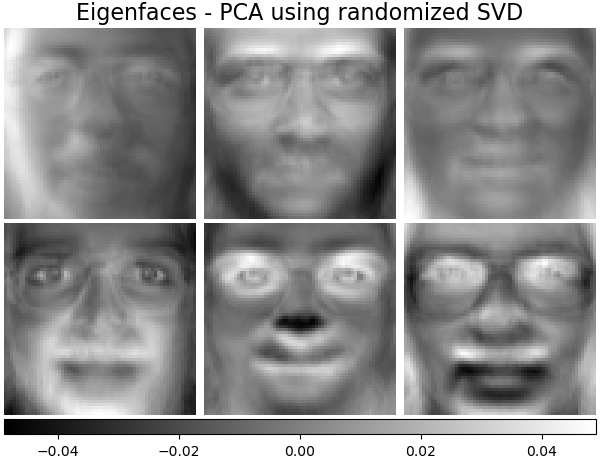
Коли рядки
Перші з них відповідають найгрубішим змінам: загальна освітленість, тінь зліва чи справа, форма овалу. Далі йдуть окуляри, вуса, посмішка. Будь-яке обличчя з набору наближається сумою кількох десятків таких шаблонів із власними вагами — і саме ці ваги стають ознаками для розпізнавання.
Зверніть увагу на природу шаблонів: вони глобальні. Кожне власне обличчя зачіпає весь кадр одразу, бо ортогональність вимагає розкидати вагу по всіх пікселях. «Частин» у побутовому сенсі — окремо ніс, окремо око — PCA не дає.
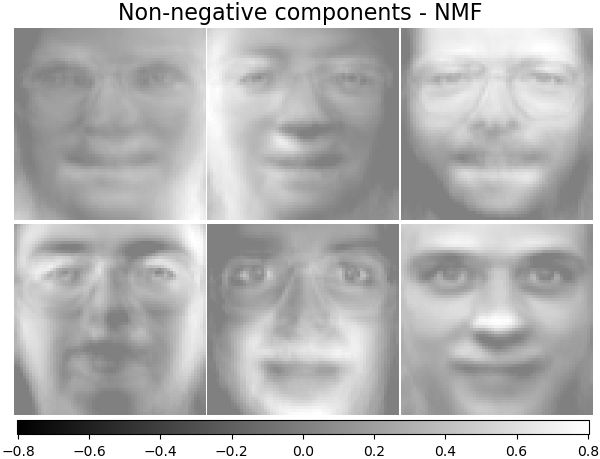
NMF: розклад на невід'ємні частини
Ортогональність — не єдине можливе обмеження. Невід'ємний матричний розклад (non-negative matrix factorization, NMF) вимагає, щоб усі елементи
Це має сенс скрізь, де від'ємна величина безглузда: яскравість пікселя, кількість слів у документі, час перегляду. Оскільки компоненти можна лише додавати, розклад змушений складати обличчя з фрагментів, а не з глобальних тіней, — і компоненти стають ближчими до «частин», які можна назвати словами.
Ціна: дані для NMF не центрують, глобального розв'язку через SVD немає, а розрідженістю компонент керувати напряму не вдається. Того самого ефекту домагаються й інакше — штрафом
Обмеження методу головних компонент
PCA дешевий, детермінований і майже завжди перший крок — але його межі варто знати заздалегідь.
Він лінійний. Кожна компонента — лише зважена сума вихідних ознак. Структуру, накручену на криву поверхню, площиною не розпрямиш.
Велика дисперсія не означає корисність. Ознака з малим розкидом може бути єдиною, що розділяє класи, і PCA відкине її першою — міток він не бачить.
Він чутливий до викидів. Ціль квадратична, тому одне екстремальне спостереження здатне розвернути першу компоненту на себе.
Компоненти важко тлумачити. Кожна змішує всі
Масштаб вирішує все. Без стандартизації результат залежить від того, у яких одиницях виміряна кожна ознака.
Ядровий PCA розгортає нелінійну структуру
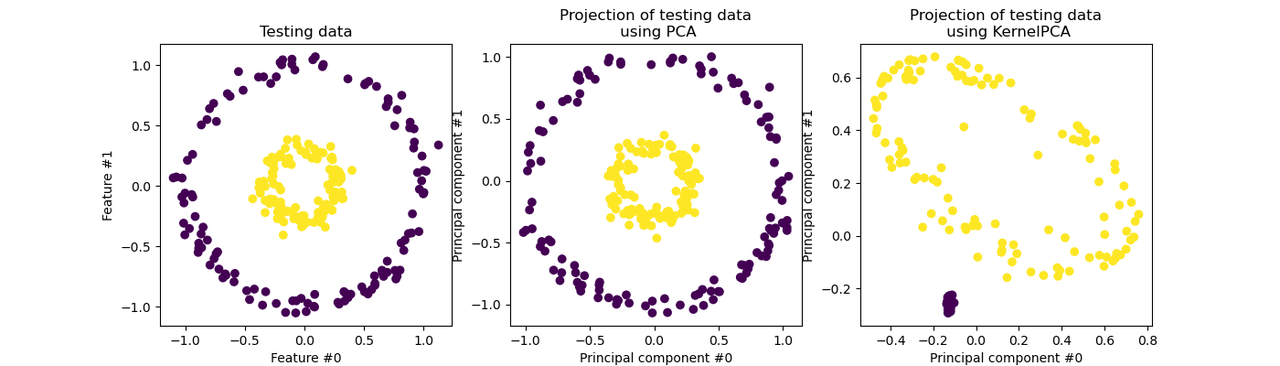
Перше з цих обмежень знімається прийомом із лекції 07. Замість того щоб шукати компоненти у вихідному просторі, застосуємо ядровий трюк: обчислимо PCA у просторі, куди дані переведено нелінійним відображенням, ніколи не будуючи це відображення явно.
На рисунку два концентричні кільця. Звичайний PCA (середня панель) лише повертає картинку: жодна пряма кільця не розділить, тому проєкція залишається круглою. Ядровий PCA (kernel PCA) з гаусовим ядром (права панель) розтягує кільця так, що внутрішнє й зовнішнє розходяться вздовж першої компоненти — після цього їх розділяє звичайна пряма.
Плата за це відома з лекції 07: матриця ядра має розмір
Джерело: scikit-learn · Kernel PCA
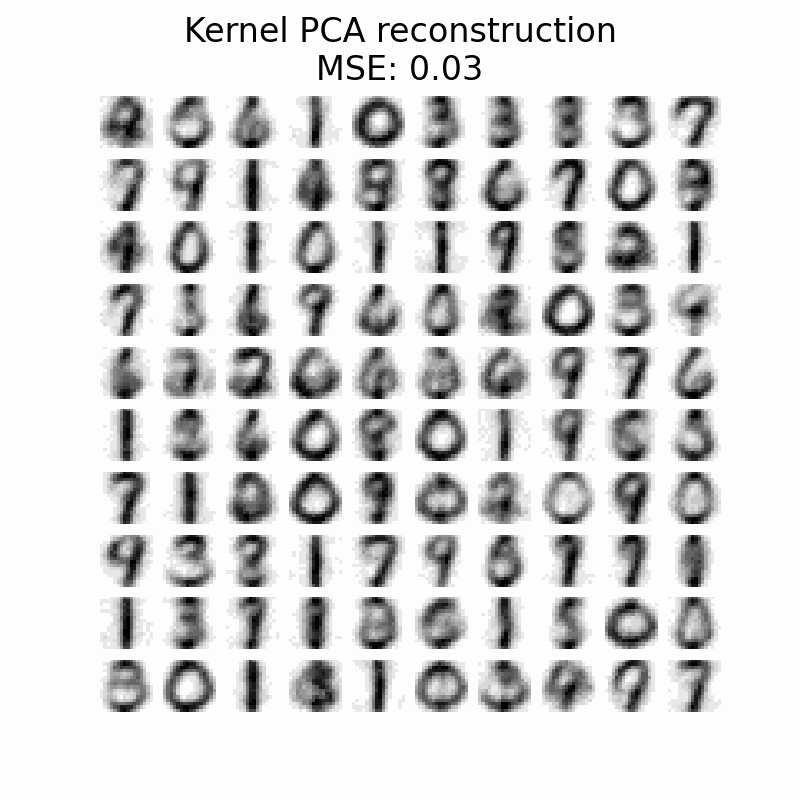
Шумозаглушення зображень ядровим PCA
Реконструкція з
До зображень цифр додали гаусів шум і відновили їх двома способами. Середньоквадратична похибка зашумлених зображень — 0,06, після звичайного PCA — 0,01, після ядрового — 0,03. Формально виграв лінійний PCA.
Але на око кращий результат дає ядровий: він прибирає крап на тлі й лишає рівні штрихи, тоді як лінійний зберігає сіру зернистість. Це корисний урок про метрики: одне число не завжди відповідає тому, що ми насправді хочемо отримати.
Матриця оцінок майже порожня
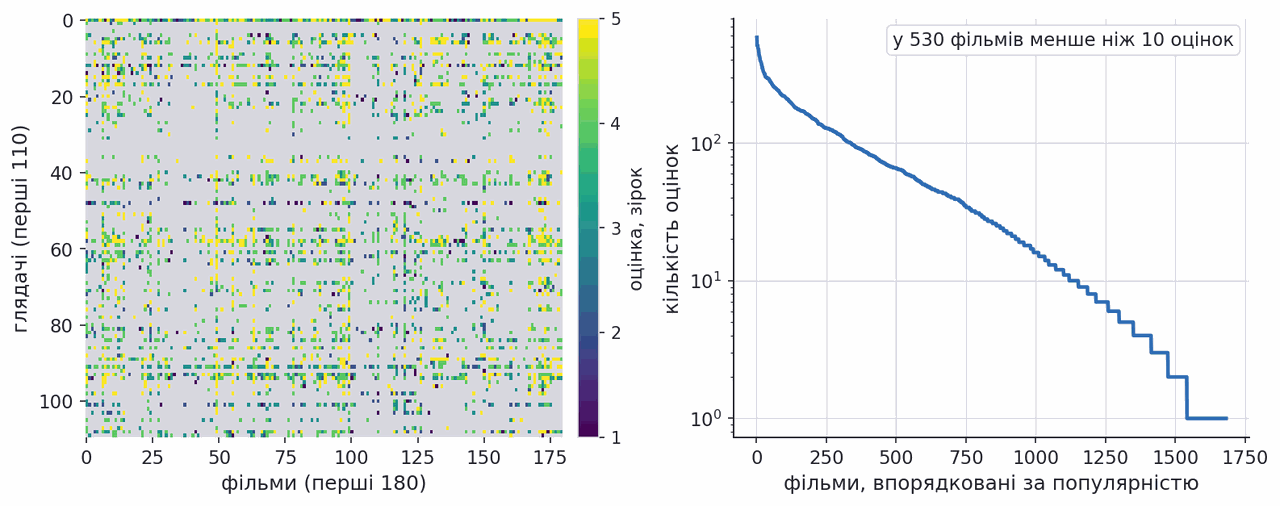
Змінімо задачу. MovieLens 100K — 100 000 оцінок від 943 глядачів на 1682 фільми, шкала від однієї до п'яти зірок. Розкладемо їх у матрицю «глядачі × фільми».
Ліворуч — її фрагмент. Сіре — це не нулі, а відсутні значення: заповнено лише 6,3 % клітинок, решту 93,7 % ніхто не оцінював. Саме ці порожні клітинки нам і треба заповнити — прогноз оцінки й буде рекомендацією.
Праворуч — друга особливість таких даних: популярність має довгий хвіст. Кілька сотень фільмів зібрали тисячі оцінок, а в 530 із 1682 їх менше ніж десять. Для цих фільмів статистики майже немає, і будь-яка модель поводитиметься на них невпевнено.
Джерело даних: GroupLens · MovieLens 100K
Розклад, який навчається лише на спостережених оцінках
Модель залишається тією самою,
| Позначення | Значення |
|---|---|
| множина пар (глядач, фільм) із наявною оцінкою | |
| смаки | |
| властивості | |
| кількість латентних факторів, |
Прогноз оцінки — скалярний добуток: збіг напрямів дає високу оцінку, протилежні напрями — низьку. Пропуски більше не заважають: те, чого ми не бачили, у сумі не бере участі, а прогноз для нього дає сама модель. Ціль опукла окремо по
Джерело: EPFL CS-433, лекція 11b
Латентні фактори мають зрозумілий сенс
Ніхто не пояснював моделі, що таке жанр, — вона має лише таблицю оцінок. Проте фактори, які вона знаходить, часто виявляються осмисленими.
На схемі відтворено класичний приклад: перший фактор розтягує фільми між орієнтацією на жіночу і чоловічу аудиторію, другий — між серйозним і суто розважальним кіно. «Сенс і чуйність» опиняється ліворуч угорі, «Смертельна зброя» — праворуч, «Тупий і ще тупіший» — унизу праворуч.
Глядачі живуть на тій самій площині. Прогноз для пари — скалярний добуток двох векторів, тому глядач Gus, розташований унизу праворуч, отримає високу оцінку саме для комедій із того самого кута, а не для драм із протилежного.
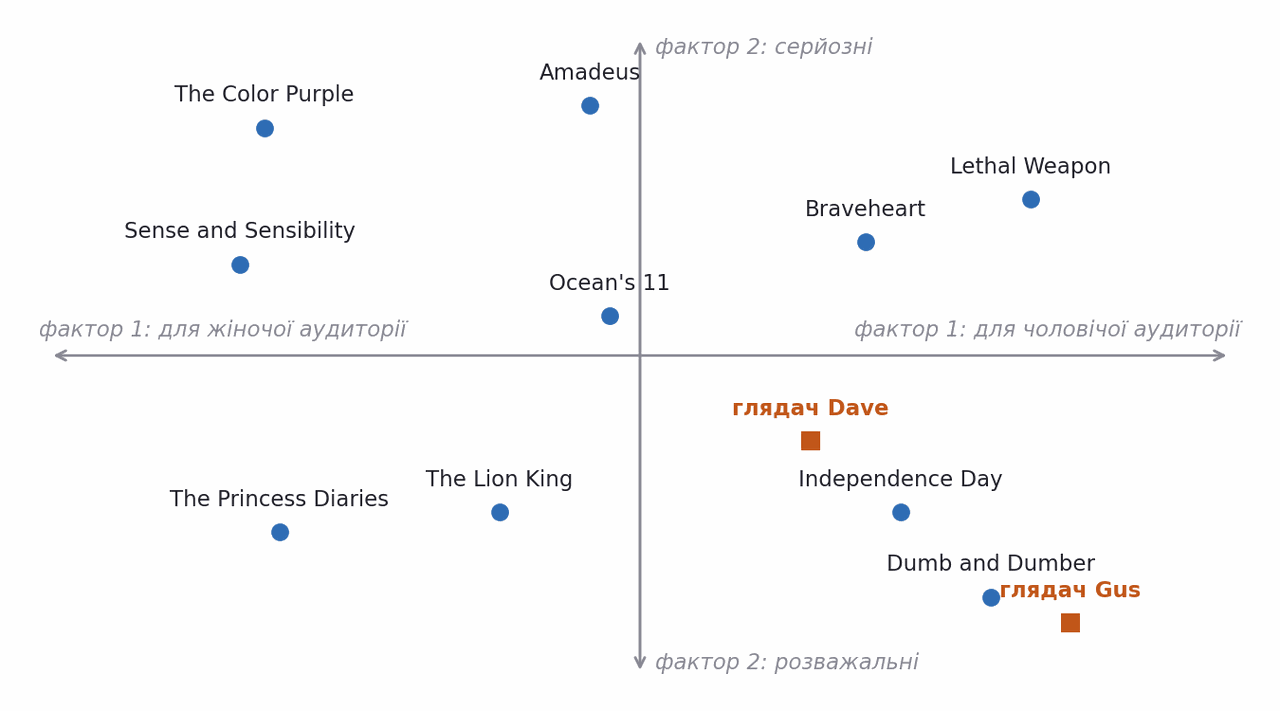
Джерело ідеї рисунка: Koren, Bell, Volinsky, «Matrix Factorization Techniques for Recommender Systems», IEEE Computer, 2009, рис. 2
Регуляризація і зсуви: дві обов'язкові добавки
Голий розклад із пропусками швидко перенавчається: латентні вектори рідкісних фільмів можна роздути як завгодно, бо їх майже ніщо не стримує. Ліки — штраф на довжину векторів:
Регуляризувати треба обидві матриці. Штраф лише на
Друга добавка — зсуви (biases). Частина оцінки пояснюється не смаками, а простими речами: цей глядач узагалі ставить високі бали, цей фільм подобається всім. Їх виносять окремо:
Латентній частині залишається лише те, що зсуви не пояснили.
SGD і ALS: два способи мінімізувати ту саму функцію
Цільова функція не опукла по
| Стохастичний градієнтний спуск | Почергові найменші квадрати (ALS) | |
|---|---|---|
| один крок | одна випадкова оцінка | усі |
| вартість кроку | розв'язання систем із матрицями | |
| робота з пропусками | тривіальна: чого не бачили, того й немає в сумі | потребує окремого виведення |
| збіжність | повільніша, потрібен крок навчання | швидка, кроку навчання не потребує |
SGD виграє на розріджених даних, де оцінок мало, а порожніх клітинок мільйони. ALS виграє тоді, коли пропусків небагато й обчислення можна розпаралелити: кожен рядок
Код: матричний розклад через стохастичний градієнт
Двадцять рядків numpy — і працююча рекомендаційна система. Похідні тут прості: помилка, помножена на вектор партнера.
Вивід код запущено, вивід не редагувався
text
епоха  1   RMSE на тесті 1.0002
епоха  2   RMSE на тесті 0.9791
епоха  3   RMSE на тесті 0.9703
епоха  4   RMSE на тесті 0.9657
епоха  5   RMSE на тесті 0.9625
епоха  6   RMSE на тесті 0.9606
епоха  7   RMSE на тесті 0.9590
епоха  8   RMSE на тесті 0.9565
епоха  9   RMSE на тесті 0.9551
епоха 10   RMSE на тесті 0.9528
епоха 11   RMSE на тесті 0.9504
епоха 12   RMSE на тесті 0.9476
епоха 13   RMSE на тесті 0.9451
епоха 14   RMSE на тесті 0.9434
епоха 15   RMSE на тесті 0.9405
епоха 16   RMSE на тесті 0.9386
епоха 17   RMSE на тесті 0.9378
епоха 18   RMSE на тесті 0.9368
епоха 19   RMSE на тесті 0.9358
епоха 20   RMSE на тесті 0.9355
епоха 21   RMSE на тесті 0.9352
епоха 22   RMSE на тесті 0.9350
епоха 23   RMSE на тесті 0.9349
На що дивитися: RMSE на тестових оцінках спадає від 1,0002 після першої епохи до 0,9349 після двадцять третьої, і наприкінці крива майже вирівнюється.
Архів MovieLens 100K треба розпакувати заздалегідь і вказати шлях до нього в змінній DATA.
Результат на MovieLens: криві навчання і роль K
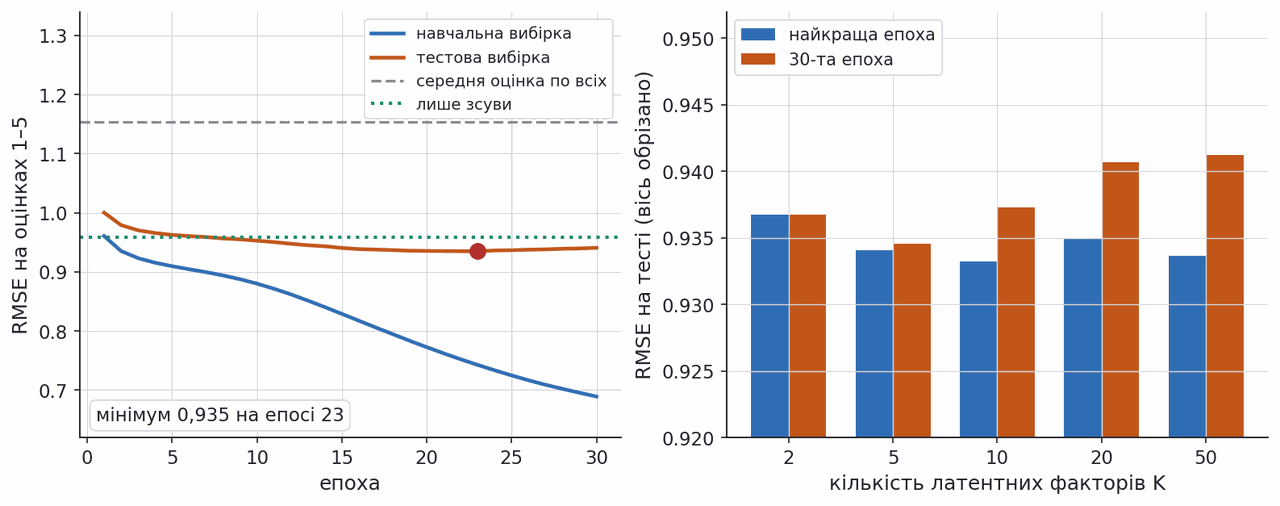
Порівнювати треба з базовими моделями. Прогноз «усім середню оцінку 3,53» дає RMSE 1,154. Прогноз «середня плюс зсув глядача плюс зсув фільму», без жодних латентних факторів, — уже 0,959. Повний розклад із двадцятьма факторами доходить до 0,935 на 23-й епосі.
Ліворуч видно, що далі починається перенавчання: помилка на навчальній вибірці продовжує падати до 0,69, а на тестовій повзе вгору. Рятує рання зупинка.
Праворуч — вплив числа факторів; зверніть увагу, що вісь обрізано і всі відмінності лежать у третьому знаку. З ранньою зупинкою
Приз Netflix зробив матричний розклад стандартом
2006 року Netflix виклав понад 100 млн оцінок від приблизно 500 тис. користувачів на понад 17 тис. фільмів і пообіцяв 1 млн доларів за зниження помилки прогнозу на 10 %. У змаганні взяли участь близько 48 тис. команд зі 182 країн.
Команда BellKor покращила базову модель на 8,43 % 2007 року, а разом із Big Chaos — на 9,46 % 2008-го. Переможець 2009 року об'єднав понад 100 різних прогнозних моделей в один ансамбль.
Найцікавіше в цій історії — не переможець. Простий регуляризований матричний розклад із зсувами, той самий, який ми щойно написали, сам собою давав близько 7 % покращення, і саме його згодом узяли на озброєння багато компаній. Систему-переможницю Netflix так і не впровадив: виграш не виправдовував складності.
Джерело: Koren, Bell, Volinsky, IEEE Computer, серпень 2009
Колаборативна фільтрація і проблема холодного старту
Матричний розклад — це один із двох підходів до рекомендацій, і корисно бачити межу між ними.
| На основі вмісту | Колаборативна фільтрація | |
|---|---|---|
| тип задачі | з учителем: ознаки пари → оцінка | без учителя: заповнення матриці |
| що потрібно на вході | описи глядачів і фільмів | лише наявні оцінки |
| новий глядач або фільм | працює одразу | холодний старт: даних немає |
| індивідуальні смаки | не вивчає | вивчає, і в цьому її сила |
Звідси холодний старт (cold start): для щойно доданого фільму немає жодної оцінки, тому й вектора
І ще одне: точність — не єдиний критерій. Різноманітність видачі, свіжість, можливість пояснити рекомендацію словами важать для користувача не менше за третій знак RMSE.
Многовиди: дані лежать на скрученій поверхні
Повернімося до візуалізації. Класичний приклад, на якому лінійні методи здаються, — «швейцарський рулет»: точки живуть у трьох вимірах, але насправді лежать на двовимірному аркуші, скрученому в спіраль.
Тут евклідова відстань обманює. Дві точки з сусідніх витків спіралі близькі «навпростець», хоча вздовж самого аркуша між ними половина рулету. PCA міряє відстань саме навпростець, тому будь-яка його проєкція склеїть різні витки в одну пляму.
Многовид (manifold) — це низьковимірний простір, у якому евклідові відстані мають сенс лише локально. Фотографії однієї сцени з різних ракурсів, рукописні цифри, поверхня Землі — усе це многовиди, вкладені в простір значно більшої розмірності.
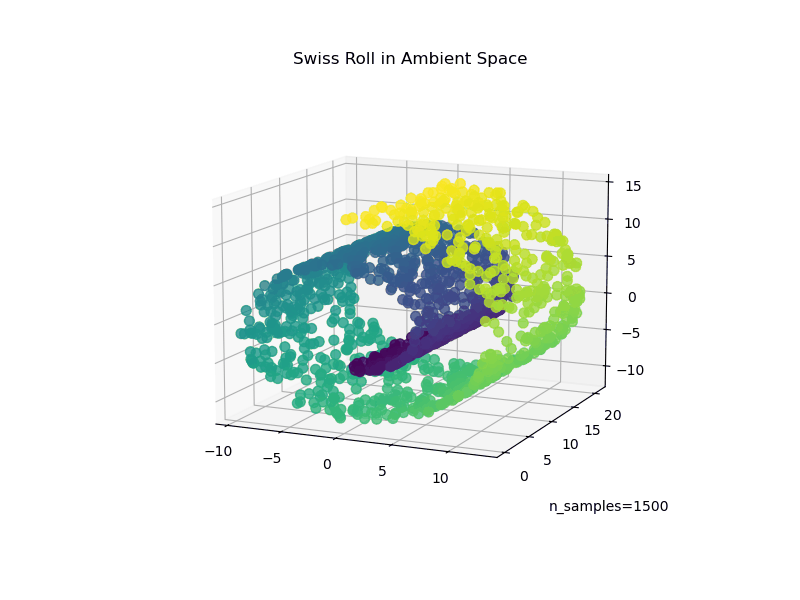
Розгортання рулета: збереження сусідства замість дисперсії
Якщо відстані «навпростець» брехливі, треба міряти інакше. Сімейство методів навчання многовидів (manifold learning) відмовляється від матриці
Різняться вони тим, що саме зберігають і як шукають розв'язок. Багатовимірне шкалювання (MDS) зберігає всі попарні відстані й рухає точки градієнтним спуском; ISOMAP спершу будує граф найближчих сусідів і міряє відстані вздовж нього, а не навпростець; локально лінійне вкладення (LLE) відновлює лише локальні залежності між сусідами і зводить задачу до власних векторів.
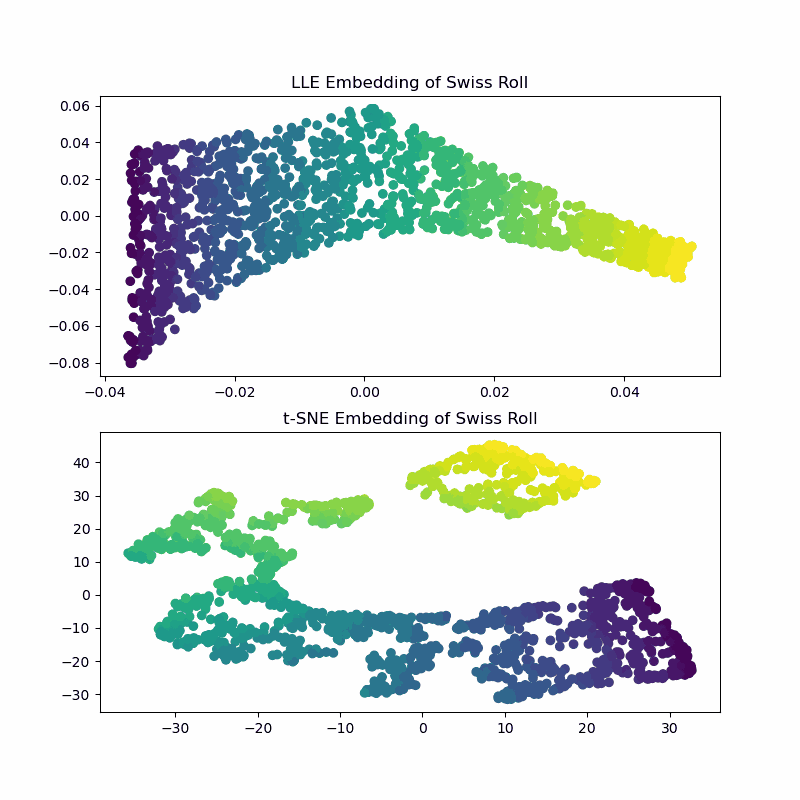
На рисунку рулет розгорнуто двома методами. LLE вгорі справді розпрямляє аркуш і зберігає плавний перехід кольору. t-SNE внизу теж розгортає стрічку, але рве її на окремі шматки — саме тому, що піклується про сусідів, а не про цілу форму.
PCA і t-SNE на тих самих цифрах
t-SNE (t-distributed stochastic neighbor embedding) працює з імовірностями сусідства. У вихідному просторі ймовірність
Результат на наших цифрах промовистий. PCA вкладає в дві компоненти 28,5 % дисперсії — угадуються нулі й одиниці, решта злилася. t-SNE відокремлює всі десять цифр, хоча міток так само не бачив.
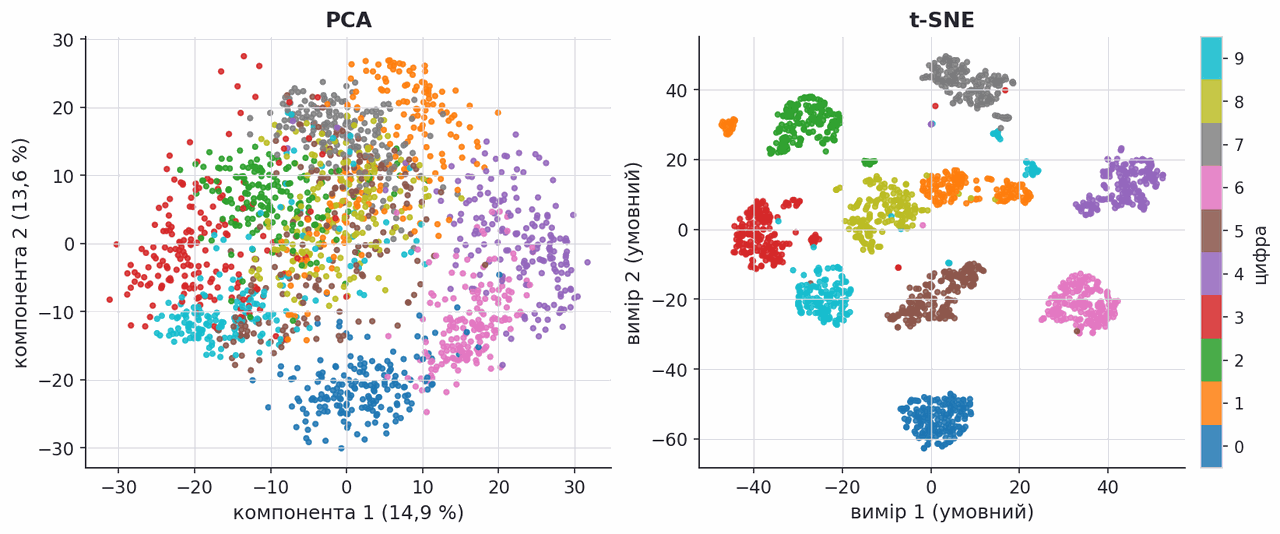
Джерело: van der Maaten, Hinton, «Visualizing Data using t-SNE», JMLR 9, 2008
t-SNE не можна читати як карту відстаней
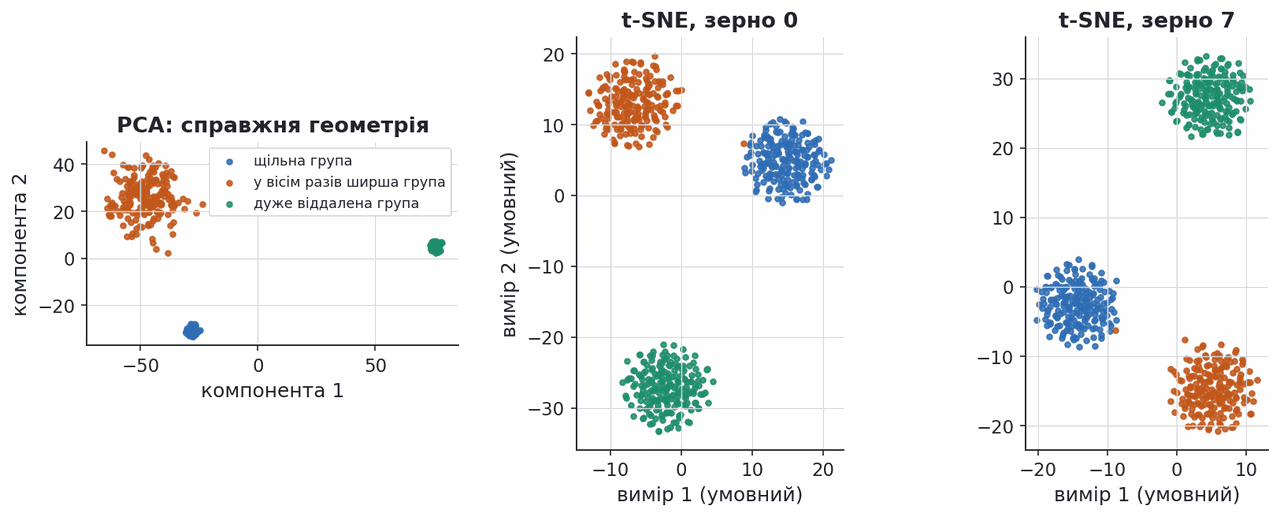
Цей розділ — найважливіше застереження лекції. Побудуємо три групи в 50 вимірах, про які ми знаємо все: одна щільна, друга у вісім разів ширша, третя дуже далеко від перших двох.
PCA ліворуч показує справжню геометрію: широка група справді широка, далека справді далеко. Дві карти t-SNE праворуч відрізняються лише випадковим зерном — і на обох усі три групи стали однакового розміру, розійшлися на однакову відстань, а взаємне розташування перемішалося.
Отже, на карті t-SNE не можна читати три речі: розмір скупчень, відстані між ними та їхнє взаємне розташування. Достовірним є лише сам факт, що точки всередині скупчення були сусідами. Змініть перплексію чи зерно — картинка зміниться. На чистому гаусовому шумі t-SNE здатен намалювати переконливі «кластери», яких немає.
Довіру до карти можна виміряти числом
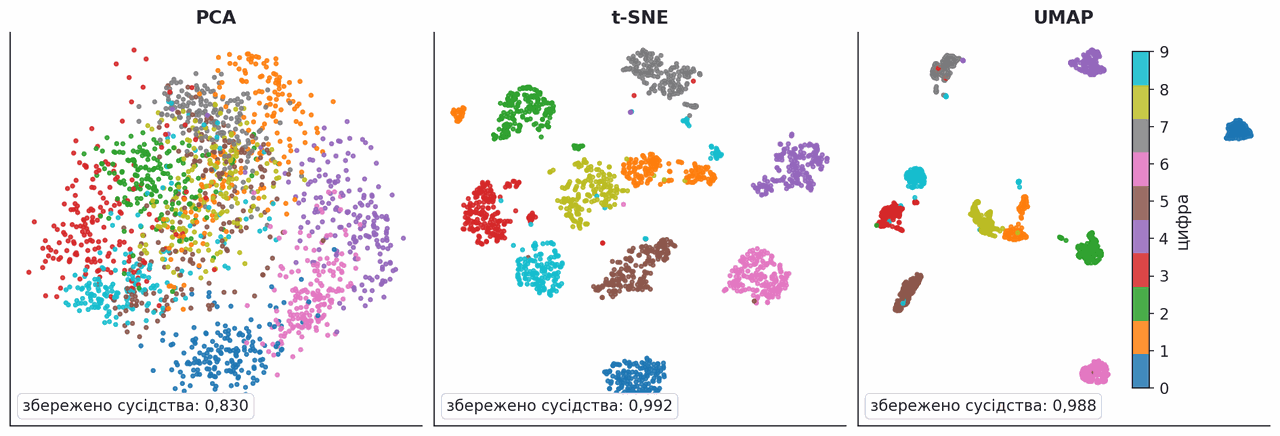
Застереження попереднього розділу лишає студента без інструмента: як перевірити свою карту? Міра є, і вона в scikit-learn. Trustworthiness дивиться, скільки найближчих сусідів кожної точки у вихідному просторі лишилися сусідами на карті; одиниця означає, що сусідство збережено повністю.
Вивід код запущено, вивід не редагувався
text
PCA    0.8296
t-SNE  0.9917
UMAP   0.9880
На що дивитися: чим ближче довіра до 1, тим менше на карті «чужих» сусідів, яких не було поруч у 64-вимірному просторі: t-SNE і UMAP майже бездоганні (0,99), PCA — лише 0,83.
На цифрах PCA зберігає 0,830, t-SNE — 0,992, UMAP — 0,988. Тепер видно, чого саме коштує лінійність: PCA втрачає майже кожного п'ятого сусіда, бо мусить описати всі шістдесят чотири виміри двома напрямами. Це число варто рахувати щоразу, коли карту показують комусь, хто робитиме з неї висновки.
Порада «спершу PCA до 50» на наших даних не працює
Документація scikit-learn радить перед t-SNE знижувати розмірність лінійним методом до кількох десятків. Порада відома, тож перевірмо її.
На десяти тисячах цифр MNIST, тобто 784 ознаки: t-SNE напряму — 19,1 секунди і trustworthiness 0,9829; через PCA до п'ятдесяти компонент — 19,1 секунди і 0,9840. Ні виграшу в часі, ні помітного виграшу в якості. Ми повторили дослід із шістьма тисячами точок, штучно розширивши простір до трьох тисяч ознак: 13,3 секунди напряму проти 13,0 через PCA.
Причина зрозуміла, якщо згадати, з чого складається час. Реалізація Барнса — Гата витрачає його переважно на оптимізацію розкладки, вартість якої залежить від кількості точок, а не від кількості ознак. Знизивши розмірність, ми прискорюємо лише пошук сусідів, а він тут і так дешевий.
Висновок не «порада хибна», а «порада має умови». Вона стосується випадків, коли дані не влазять у пам'ять або коли ознак справді десятки тисяч. На наших масштабах вона не дає нічого — і це варто було перевірити, а не переказувати.
UMAP: та сама ідея, інша математика
Сучасна альтернатива t-SNE — UMAP (uniform manifold approximation and projection). Ідея спільна: зберегти граф сусідства, а не відстані; відмінності — у тому, як його будують і оптимізують.
UMAP описує дані зваженим графом найближчих сусідів і мінімізує перехресну ентропію між високо- та низьковимірним графами замість розбіжності Кульбака — Лейблера.
На тих самих цифрах UMAP дає trustworthiness 0,988 проти 0,992 у t-SNE — сусідство зберігає не гірше. Права панель рисунка вище показує різницю, яку числом не спіймати: острівці UMAP щільніші й розсунуті далі. Це не «краще», а інша цільова функція.
Ціна тут — час: 7,2 секунди проти 3,4 у t-SNE. Перевага UMAP у швидкості з'являється на вибірках від десятків тисяч точок.
Застереження попереднього розділу чинні повністю: UMAP так само чутливий до кількості сусідів і мінімальної відстані й так само не дає права міряти відстані на карті лінійкою.
Джерело: McInnes, Healy, Melville, «UMAP: Uniform Manifold Approximation and Projection», arXiv:1802.03426, 2018
PCA, MDS і t-SNE: що обирати під задачу
Три сімейства методів розв'язують три різні задачі, і плутати їх дорого.
| PCA | MDS та ISOMAP | t-SNE і UMAP | |
|---|---|---|---|
| що зберігає | дисперсію, глобально й лінійно | попарні або геодезичні відстані | локальні сусідства |
| перенесення нових точок | так, множенням на | ні | ні у t-SNE, окремою процедурою в UMAP |
| розв'язок | глобальний, через SVD | неопуклий, градієнтний спуск | неопуклий, залежить від старту |
| для чого годиться | стиснення, ознаки, шумозаглушення | візуалізація зі збереженням масштабу | лише візуалізація |
Робочий порядок такий: PCA — завжди першим, він дешевий і дає відповідь на питання «скільки тут насправді вимірів». t-SNE або UMAP — далі, коли треба показати структуру людині, причому часто після попереднього стиснення тим самим PCA до кількох десятків компонент.
Підсумок лекції
Одна модель, три застосування. Розклад
PCA — це два еквівалентні описи. Мінімум перпендикулярної помилки реконструкції і максимум дисперсії проєкцій — одна задача; її розв'язок дають топ-
Число компонент обирають за поясненою дисперсією або за якістю кінцевої моделі; на наших цифрах 90 % дисперсії утримує 21 компонента з 64.
Пропуски не заважають. Сума лише по спостережених клітинках плюс регуляризація і зсуви дали RMSE 0,935 проти 1,154 у тривіального прогнозу.
Карти t-SNE читають обережно: сусідство достовірне, розміри й відстані — ні.
Місток далі. Наступна лекція показує, як нейронна мережа будує ознаки сама; а автокодувальник із лекцій 13–14 — це той самий розклад, у якому лінійну проєкцію замінено мережею, тобто нелінійне узагальнення PCA.
Джерела й додаткові матеріали
Курси
- EPFL CS-433, лекція 11b: матричні розклади
- UBC CPSC 340, лекції 25–28: PCA, SVD, t-SNE
Підручники
- Bishop. Pattern Recognition and Machine Learning
- Hastie та ін. The Elements of Statistical Learning, розділ 14
Статті
- Koren, Bell, Volinsky. Matrix Factorization Techniques, IEEE Computer, 2009
- van der Maaten, Hinton. Visualizing Data using t-SNE, JMLR, 2008
- McInnes та ін. UMAP, arXiv:1802.03426, 2018
Документація