Тема
Лекція 04 · Імовірнісний погляд: максимальна правдоподібність
Дві попередні лекції мінімізували суму квадратів помилок, ніде не пояснюючи, звідки взялася саме вона. Сьогодні ми зайдемо з іншого боку: опишемо, як випадковість породжує дані, — і функція втрат з'явиться сама, разом із регуляризатором.
Зміст лекції
Лекція проходить один шлях двічі: спершу від імовірнісної моделі до вже знайомої нам квадратичної втрати, потім тим самим шляхом до втрат, яких ми ще не бачили.
- Модель породження даних. Прогноз як розподіл, а не як число; нормальний шум навколо прямої.
- Правдоподібність і її логарифм. Імовірність спостережених даних як функція параметрів моделі.
- Гаусів шум дає метод найменших квадратів. Виведення MSE з принципу максимальної правдоподібності.
- Розподіл шуму визначає функцію втрат. Лаплас дає модуль похибки, Бернуллі — перехресну ентропію.
- Властивості й межі оцінки максимальної правдоподібності. Що вона гарантує і де підводить.
- Апріорний розподіл і регуляризація. MAP-оцінка, гаусів пріор як ridge, лапласів як lasso.
Наскрізна теза всіх шести блоків одна: вибір функції втрат — це вибір моделі шуму. Вона зв'язує лекцію 02, де ми взяли MSE як даність, лекцію 03, де регуляризація виглядала інженерним прийомом, і лекцію 05, де знадобиться перехресна ентропія.
Чого ви навчитеся
Після цієї лекції ви зможете:
- записати ймовірнісну модель породження даних для лінійної регресії й пояснити роль кожного її припущення;
- відрізнити правдоподібність від імовірності та пояснити, чому максимізують саме логарифм;
- вивести квадратичну втрату з припущення про гаусів шум і показати, що вона дає ту саму оцінку, що й нормальні рівняння;
- за заданим розподілом шуму або міток отримати відповідну функцію втрат;
- пояснити, що таке важкі хвости шуму і яку функцію втрат брати, коли вони є;
- пояснити ентропію, перехресну ентропію й розходження Кульбака — Лейблера і чому MLE мінімізує розходження між даними й моделлю;
- оцінити стандартне відхилення шуму й перетворити точковий прогноз на інтервал;
- назвати, що гарантує оцінка максимальної правдоподібності й у яких умовах вона перенавчається;
- пояснити, чому ridge відповідає гаусову апріорному розподілу ваг, а lasso — лапласову, і як ширина пріора пов'язана з коефіцієнтом регуляризації.
Дві дороги до методу найменших квадратів
У лекції 02 ми діяли просто: оголосили, що втратами буде середній квадрат помилки, і мінімізували її. Питання «чому квадрат, а не модуль і не четвертий степінь» тоді залишилося без відповіді, а в лекції 03 до нього додалося друге — чому штраф за великі ваги взагалі має право стояти поруч із втратою.
Сьогодні ми пройдемо цей шлях у зворотному напрямку. Спершу опишемо припущення про те, як виникають наші дані. Потім запитаємо: за яких значень параметрів такі дані найімовірніші? Виявиться, що для одного конкретного припущення про шум відповідь збігається з методом найменших квадратів рівно, до останнього знака.
Цінність другої дороги не в тому, що вона дає ту саму відповідь. Цінність у тому, що варто змінити припущення — і вона дає іншу функцію втрат, причому обґрунтовану, а не вигадану.
| Геометричний шлях | Імовірнісний шлях | |
|---|---|---|
| Із чого починають | «Помилки треба зробити малими» | «Дані породжені моделлю з шумом» |
| Що постулюють | квадрат помилки як міра | розподіл шуму навколо прогнозу |
| Звідки береться сума квадратів | обрано як зручну гладку міру | випливає з гаусового шуму |
| Що дає на виході | ті самі ваги | ті самі ваги плюс міра невпевненості |
| Чого не пояснює | чому саме квадрат, а не модуль | нічого не постулює задарма: розподіл треба обрати |
Обидві дороги приводять до одного розв'язку, але друга йде далі: змінивши припущення про шум, ми автоматично отримуємо іншу функцію втрат — і саме цим займається решта лекції.
Похибки моделі з лекції 02 складаються в дзвін
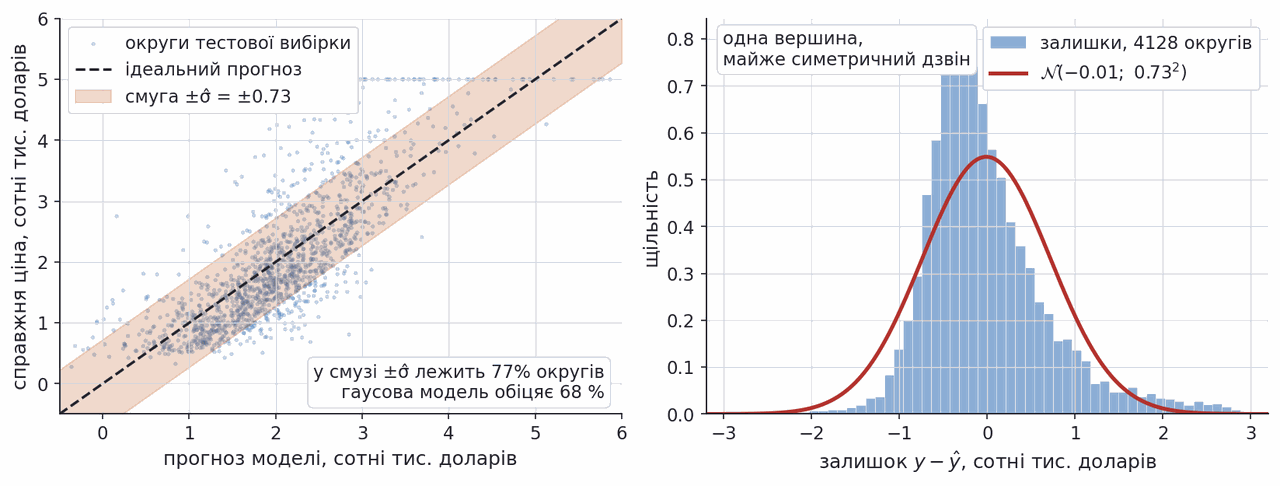
Почнімо з того, що вже маємо. Модель лекції 02 — лінійна регресія на восьми ознаках набору California Housing — передбачає медіанну ціну житла в окрузі. На 4128 відкладених округах вона промахується в середньому на 53,5 тисячі доларів.
Ліворуч видно, що прогнози тримаються навколо лінії ідеального збігу, а смуга завширшки ±0,73 накриває більшу частину хмари. Праворуч ті самі помилки зібрані в гістограму: одна вершина біля нуля, приблизна симетрія, спад в обидва боки. Це не хаос — це форма, яку можна описати розподілом. Саме на цьому спостереженні побудована вся лекція.
Джерело даних: scikit-learn · California Housing
Нормальний розподіл: центр і розкид
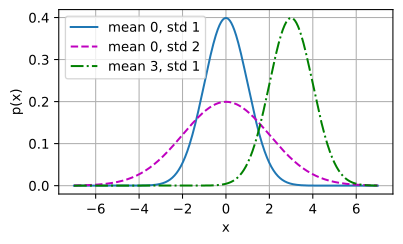
Форму дзвона задає нормальний, або гаусів, розподіл (Gaussian distribution). У нього рівно два параметри: середнє
На рисунку три криві. Суцільна синя і штрихпунктирна зелена мають однакову ширину, але різні центри — 0 і 3. Це чистий зсув. Синя і пунктирна рожева стоять в одному центрі, проте рожева вдвічі ширша і рівно вдвічі нижча: площа під будь-якою щільністю дорівнює одиниці, тож розтягнутий розподіл обов'язково стає нижчим.
Друге потрібне нам поняття — незалежність: величини
Джерело: Dive into Deep Learning · Linear Regression
Імовірнісна модель породження даних
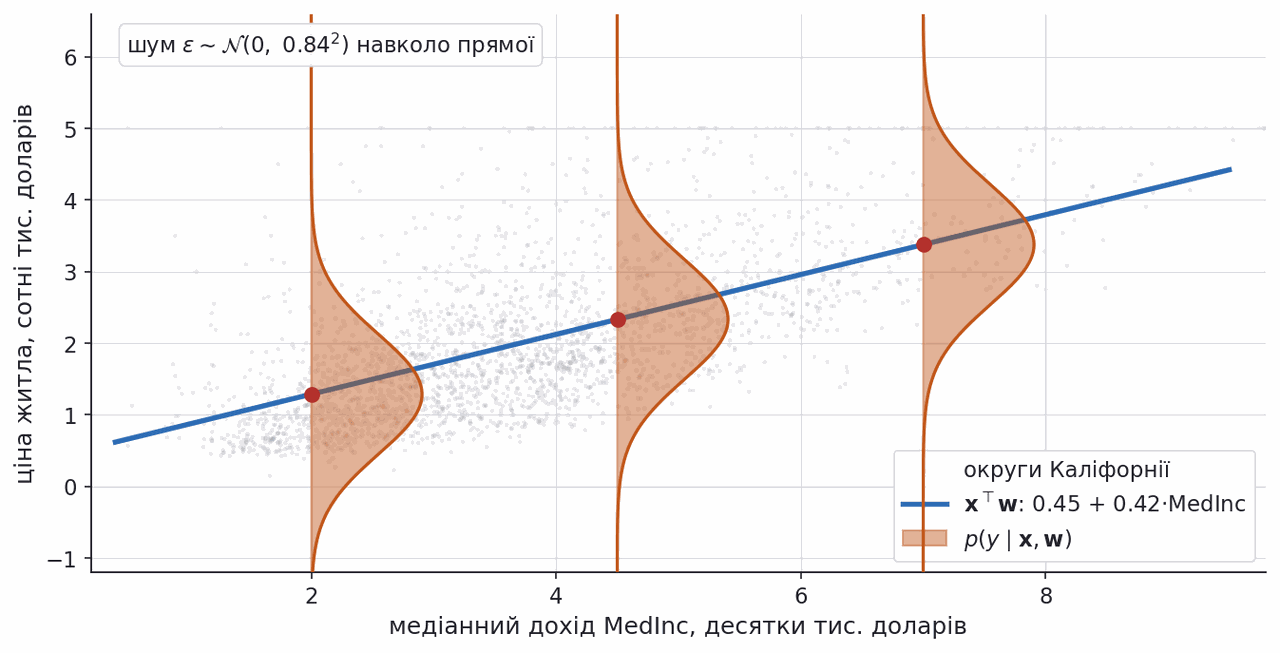
Тепер запишемо припущення явно. Ми вважаємо, що ціна кожного округу утворилася так: лінійна модель дала своє число, а зверху додалося випадкове відхилення — усе, чого модель не бачить.
| Позначення | Значення |
|---|---|
| ознаки | |
| шум: похибка вимірювання плюс усі чинники поза моделлю | |
| дисперсія шуму, однакова для всіх спостережень | |
| «незалежно» | шум різних округів не пов'язаний між собою і не залежить від |
Наслідок читається просто: модель передбачає не число, а цілий розподіл
Правдоподібність — це ймовірність даних як функція параметрів
Модель у нас є, невідомі ваги — теж. Потрібне правило, за яким серед усіх можливих
"Define a likelihood function, probability of data given parameters:
. Choose parameters to maximize the likelihood." — UBC CPSC 340, лекція 24
Правдоподібність (likelihood) — це та сама щільність
Оцінка максимальної правдоподібності (maximum likelihood estimate, MLE) — це те
Важливо, що правдоподібність не є розподілом за
Джерело: UBC CPSC 340 Machine Learning
Мінімальний приклад: підкидання монети
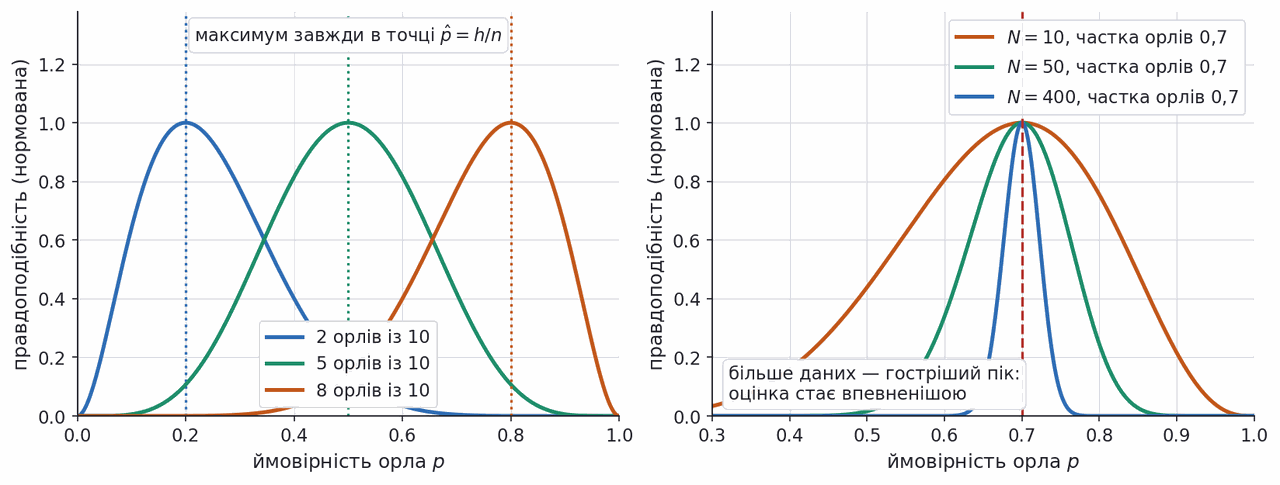
Найкоротший приклад, на якому видно все. Монета падає орлом з невідомою ймовірністю
Ліворуч на рисунку — ця функція для десяти підкидань і трьох різних результатів. Максимум щоразу стоїть точно в точці
Праворуч частка орлів фіксована на 0,7, а змінюється кількість підкидань. Точка максимуму не рухається, але пік стає дедалі вужчим: більше даних — менше сумнівів щодо оцінки. Ця картинка знадобиться нам двічі — коли говоритимемо про властивості MLE і коли додаватимемо апріорний розподіл.
Де стоїть максимум правдоподібності
Та сама функція, що на рисунку: монета впала орлом h разів із N. Крива рахується просто тут, а вертикальна риска — це не підпис, а обчислена точка максимуму.
0,700оцінка p̂ = h / N
0,325ширина піка на половині висоти
10спостережень у вибірці
Посуньте h — максимум поїде рівно у h/N, як і обіцяє формула h/p − (N−h)/(1−p) = 0. Тепер зафіксуйте частку орлів (наприклад, 7 із 10, потім 35 із 50, потім 140 із 200): точка максимуму стоїть на місці, а пік стає дедалі вужчим — більше даних не змінює оцінку, але зменшує сумнів щодо неї. Увімкніть логарифм: добуток перетворюється на суму, максимум лишається там само, зате крива стає зручною для похідної й не переповнює арифметику при великому N.
Кнопка «додати пріор» знадобиться після розділу про MAP. Візьміть найкоротший можливий дослід — три орли з трьох. Правдоподібність максимальна в точці 1,000: за цією оцінкою монета ніколи не впаде решкою, хоч ми бачили лише три підкидання. Увімкніть пріор Beta(2, 2) — апріорне переконання «монета радше чесна» — і MAP дає 0,800: оцінка відходить від абсурду, не втрачаючи зв'язку з даними. Тягніть силу пріора: при s = 1 пріор рівномірний і MAP збігається з MLE, при s = 20 оцінка сповзає до 0,537, тобто дані майже нічого не важать. Тепер поверніть N до 200 при тій самій частці орлів — і побачите головне: із зростанням вибірки апостеріорна крива притискається до правдоподібності, і пріор перестає щось вирішувати.
Логарифм перетворює добуток на суму
Правдоподібність — це завжди добуток по спостереженнях. Працювати з ним напряму не можна з двох причин, і обидві видно на рисунку.
Перша — обчислювальна. Кожен множник менший за одиницю, тому добуток тане експоненційно. Уже приблизно після тисячі ста спостережень із ймовірністю 0,5 добуток виходить за межі float64 і стає в пам'яті машини точним нулем. Сума логарифмів такої проблеми не має: вона просто лінійно спадає.
Друга — аналітична. Похідна добутку вимагає правила Лейбніца, похідна суми береться почленно.
Заміна законна, бо логарифм монотонно зростає: якщо
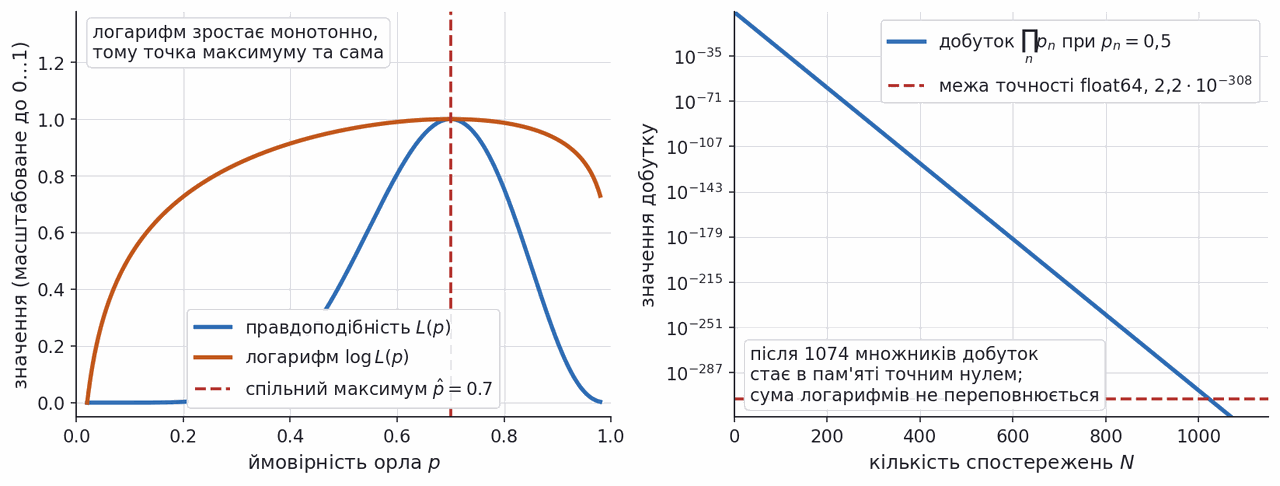
Далі в лекції ми користуємось від'ємною логарифмічною правдоподібністю (negative log-likelihood, NLL) і всюди мінімізуємо: так формули стають функціями втрат без жодного перекладу.
Правдоподібність лінійної моделі
Повертаємось до California Housing. Оскільки шум різних округів незалежний, імовірність усього набору даних дорівнює добутку ймовірностей окремих спостережень:
Тут
Символ добутку тут не косметика, а прямий наслідок припущення про незалежність шуму. Якби помилки сусідніх округів були пов'язані — а в географічних даних так буває, — це рівняння було б неправильним.
Логарифм гаусової правдоподібності є сумою квадратів
Візьмімо логарифм добутку. Логарифм експоненти знімає експоненту, добуток перетворюється на суму, а всі множники, що не залежать від
Тепер поставмо поруч втрату з лекції 02:
Сума квадратів у них та сама. Відрізняються лише знак і додатний множник (
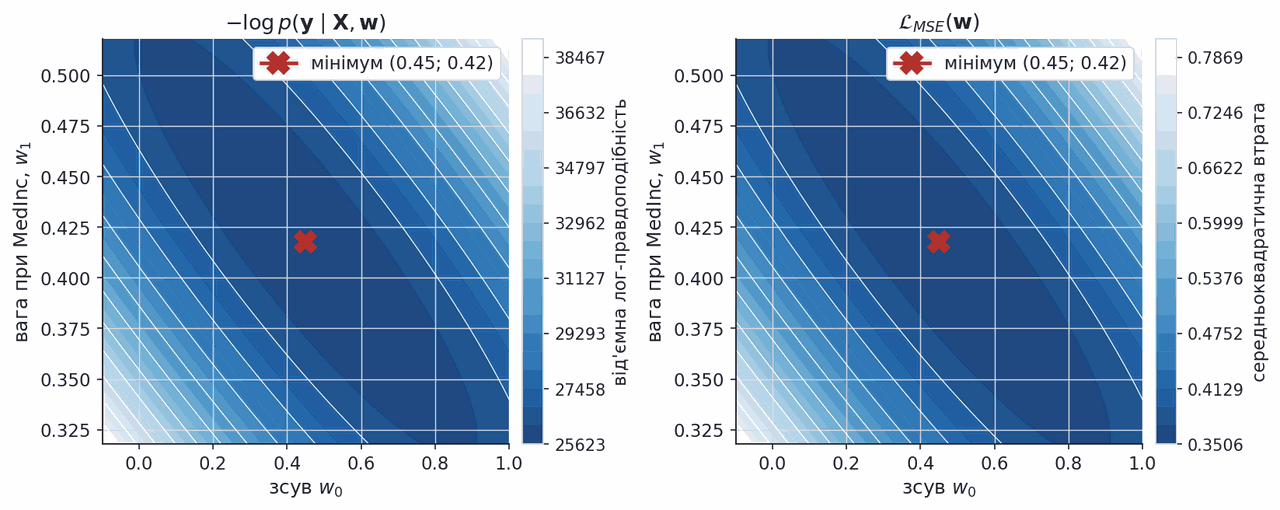
Максимум правдоподібності й мінімум MSE — одна точка
Звідси головна рівність лекції:
Рівність умовна. Вона тримається на трьох припущеннях розділу 6: шум гаусів, дисперсія однакова для всіх округів, помилки незалежні. МНК можна застосувати до будь-яких даних, але без гаусового шуму він уже не є оцінкою максимальної правдоподібності: ваги лишаються розумними, але вже не найточніші серед усіх оцінок, а інтервали на основі σ — нечесні. Тому припущення перевіряють на залишках — розділ 17 зробить це на наших даних.
На рисунку обидві поверхні побудовані над однією площиною ваг для моделі «ціна ← медіанний дохід». Рівні контурів вибрано так, щоб їм відповідали ті самі значення суми квадратів. Картинки збігаються повністю — різні лише числа на шкалах збоку: ліворуч десятки тисяч натів, праворуч частки одиниці. Хрестик стоїть в одному й тому самому місці.
"MLE can also be interpreted as finding the model under which the observed data is most likely to have been generated from." — EPFL CS-433, лекція 03c
Джерело: EPFL CS-433 Machine Learning
Код: оцінка максимальної правдоподібності на California Housing
Перевіримо рівність чисельно. Максимізуємо логарифм правдоподібності по дев'яти вагах і ще по
Вивід код запущено, вивід не редагувався
text
макс. розбіжність ваг: 4.52e-06
σ̂ з MLE: 0.7241  √(SSE/N): 0.7241
На що дивитися: ваги MLE відрізняються від розв'язку нормальних рівнянь лише на 4,5·10⁻⁶, а σ̂ = 0,7241 збігається з коренем із середнього квадрата залишків.
Оцінку шуму
Лежандр, Гаусс і два обґрунтування найменших квадратів
Історично ці дві дороги й були двома різними відкриттями.
Адрієн-Марі Лежандр опублікував метод найменших квадратів 1805 року в праці про орбіти комет — як алгебраїчний прийом: серед усіх кривих оберімо ту, для якої сума квадратів відхилень найменша. Моделі похибок у цьому обґрунтуванні не було.
Карл Фрідріх Гаусс 1809 року дав методу інше обґрунтування, саме те, яке ми щойно відтворили: якщо похибки спостережень підпорядковані нормальному розподілу, найімовірнішими значеннями параметрів є ті, що дає метод найменших квадратів. Гаусс заявляв, що користувався методом із 1795 року, і це спричинило найвідомішу суперечку про пріоритет в історії статистики.
Отже, обчислювальний рецепт і його ймовірнісне пояснення належать різним авторам. Об'єднувати ці два внески в один — поширена помилка.
Джерело: Stigler S. M. Gauss and the Invention of Least Squares. Annals of Statistics 9(3), 1981, 465–474
Рецепт: від розподілу до функції втрат
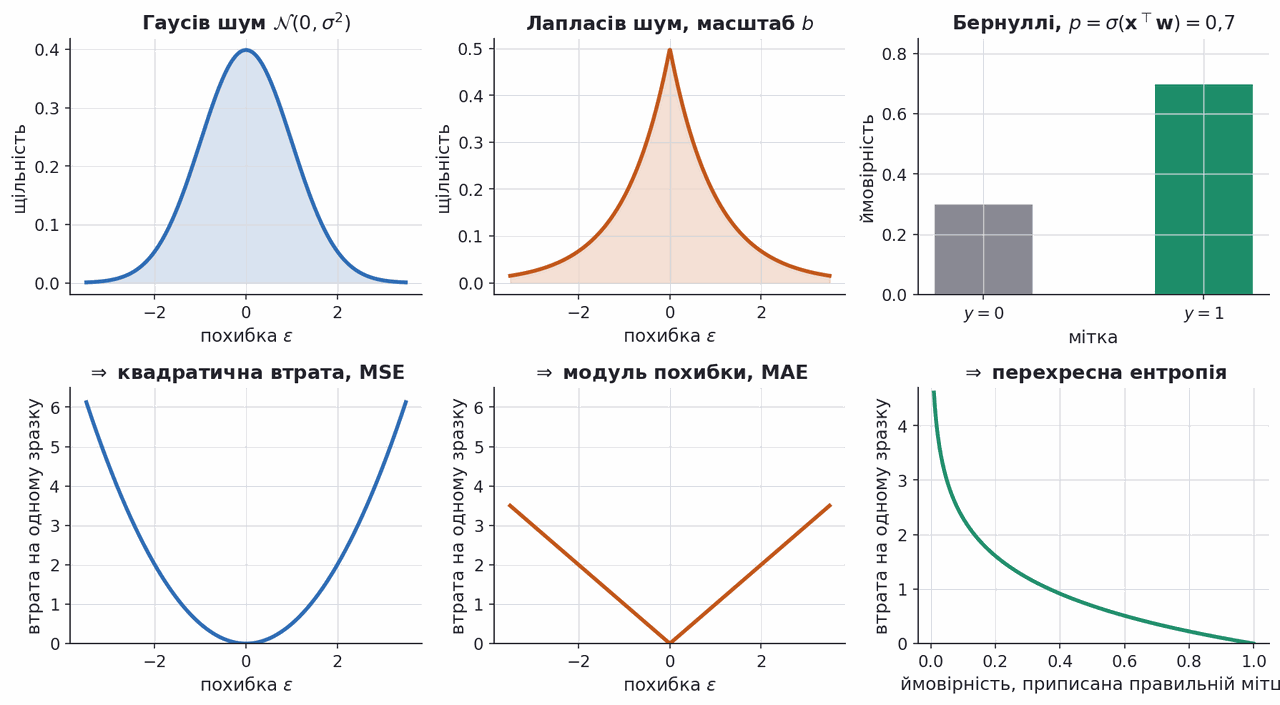
Виведення, яке ми зробили для гаусового шуму, ніде не спиралося на його конкретний вигляд. Отже, воно є загальним рецептом із трьох кроків:
Крок 1. Обираємо розподіл, який описує шум у цілі або спосіб породження міток. Крок 2. Беремо мінус логарифм його щільності. Крок 3. Сумуємо по спостереженнях — і отримуємо функцію втрат, яку можна мінімізувати звичайним градієнтним спуском.
На рисунку рецепт застосовано до трьох розподілів. Верхній ряд — самі розподіли, нижній — те, у що перетворює їх мінус логарифм: квадратична парабола, гострий злам модуля і крива, що прямує в нескінченність, коли модель приписує правильній мітці нульову ймовірність.
Розподіл Лапласа дає середню абсолютну похибку
Замінімо гаусів шум на розподіл Лапласа (Laplace distribution) з масштабом
Крок за кроком: мінус логарифм щільності дорівнює
Різниця між двома моделями — у хвостах. Для залишку
Гаусова і лапласова моделі на залишках California Housing
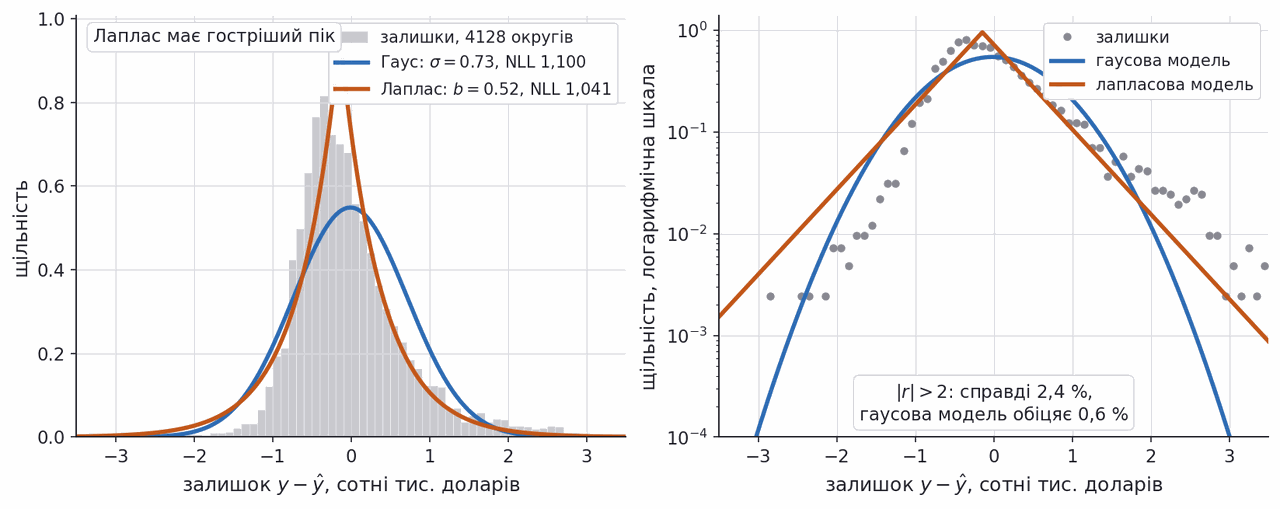
Перевіримо обидві моделі на реальних помилках нашої регресії. Обидві підігнано за максимумом правдоподібності: для гаусової це середнє й стандартне відхилення залишків, для лапласової — медіана й середнє абсолютне відхилення від неї.
Ліворуч видно, що справжній розподіл має гостріший пік, ніж допускає гаусова крива. Праворуч та сама картина в логарифмічній шкалі, де добре читаються хвости.
Тут
| Відхилення | Спостережено | Гаусова модель | Лапласова модель |
|---|---|---|---|
| 5,11 % | 3,92 % | 5,61 % | |
| 2,42 % | 0,60 % | 2,15 % | |
| 1,07 % | 0,06 % | 0,82 % |
Великих помилок учетверо більше, ніж обіцяє гаусова модель. Середня NLL це підтверджує: 1,041 у лапласової проти 1,100 у гаусової — менше означає краще. Наші дані описуються моделлю, яка веде до MAE, а не до MSE.
Квадратична втрата оцінює середнє, модуль — медіану
Різниця між двома втратами має точне статистичне формулювання. Мінімізуючи квадратичну втрату, модель наближає умовне середнє
На симетричному розподілі це та сама точка, і різниці немає. На асиметричному вони розходяться. Рисунок побудовано на цілі з важким правим хвостом: чорний пунктир — справжнє середнє, помаранчева пряма — медіана. Кілька дуже великих значень тягнуть середнє вгору, тоді як медіана залишається там, де лежить основна маса даних.
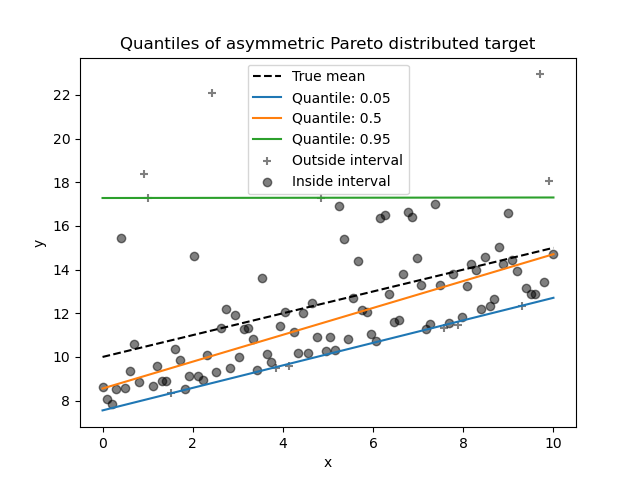
Практичний висновок прямий. Якщо потрібне очікуване значення — наприклад, сумарна виручка за тисячею угод, — беріть MSE. Якщо потрібен типовий випадок, стійкий до кількох аномалій, — MAE. Це вибір моделі шуму, а не смаку.
Джерело: scikit-learn · Quantile regression
Важкі хвости ламають гаусову модель
Наскільки дорого коштує неправильне припущення про шум, видно на прикладі з документації scikit-learn. Сині хрестики — навчальні дані: 400 точок уздовж синусоїди, і в кожної третьої ціль навмисно замінено на 10 — це ряд угорі. Кожна лінія — кубічний поліном, підігнаний своїм методом, а число в легенді — середньоквадратична похибка на чистих тестових точках, яких псування не торкнулося.
Бірюзова лінія — звичайний МНК, тобто MLE за гаусового шуму: зіпсовані точки вигинають її так, що похибка сягає 11,055. Чорний пунктир — регресор Хубера, 0,011: у тисячу разів менше. Зелений RANSAC (0,002) і жовтий метод Тейла — Сена (0,234) теж стійкі, але це вже не моделі шуму, а процедури: перша шукає найбільшу узгоджену підмножину точок, друга бере медіану нахилів.
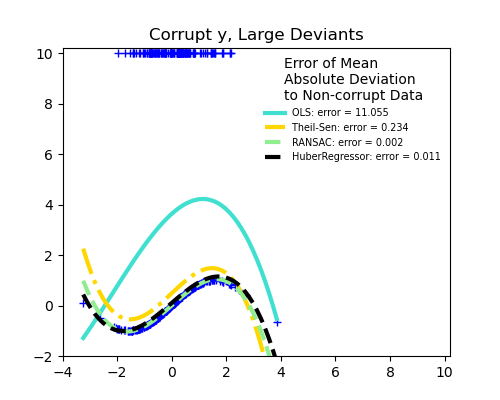
Причина провалу МНК суто ймовірнісна: гаусова модель вважає велике відхилення настільки неймовірним, що готова зрушити всю криву, аби його пояснити.
Джерело: scikit-learn · Robust linear estimator fitting
Важкий хвіст — це повільне спадання щільності
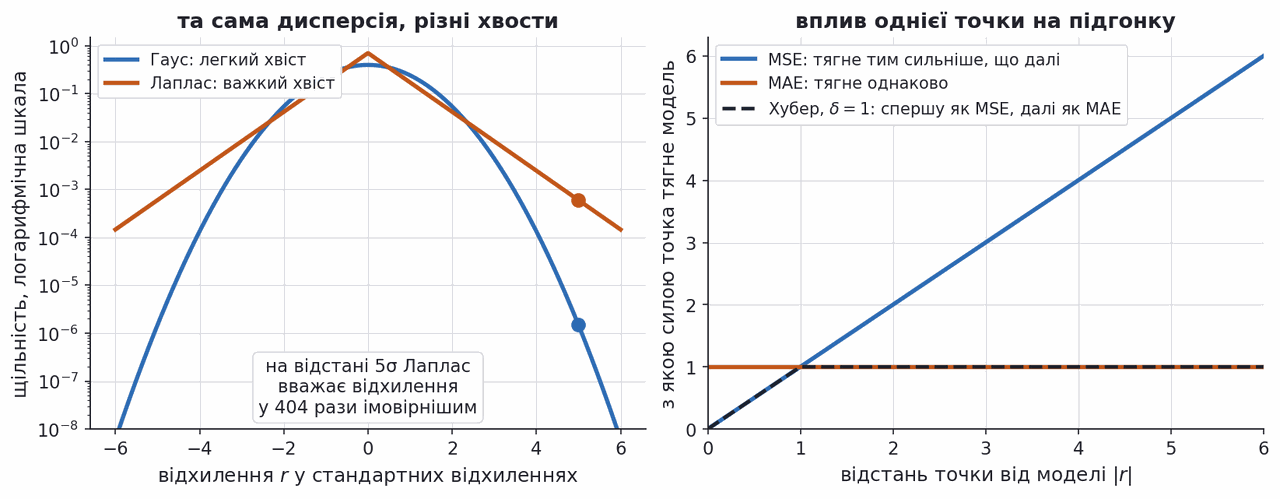
Хвіст розподілу — те, наскільки швидко спадає щільність далеко від центру. Ліворуч дві щільності з однаковою дисперсією в логарифмічній шкалі: гаусова падає параболою, лапласова — прямою, і на відстані п'яти стандартних відхилень Лаплас вважає відхилення в 404 рази ймовірнішим. Модель із важкими хвостами — та, для якої великий промах рідкісний, але не неможливий.
Праворуч — наслідок для підгонки: з якою силою одна точка тягне модель, тобто похідна функції втрат. У MSE ця сила росте з відстанню, і один далекий викид переважує сотні звичайних точок. У MAE вона стала: далека точка тягне не сильніше за близьку.
Що брати, коли залишки мають важкі хвости:
- MAE, тобто медіанну регресію, — шум Лапласа з розділу 16;
- втрату Хубера з лекції 02 — Гаус у центрі, Лаплас на хвостах: малі помилки штрафуються квадратом, великі — модулем.
У scikit-learn це QuantileRegressor(quantile=0.5) і HuberRegressor.
Розподіл Бернуллі дає перехресну ентропію
Той самий рецепт працює й тоді, коли ціль не число, а мітка класу. Мітка приймає два значення, тож природна модель — розподіл Бернуллі (Bernoulli distribution) з параметром
Запис компактний, але читається просто: при
Це не нова ідея, а третє застосування того самого рецепта. Повне виведення разом із градієнтом і геометрією межі рішення — у лекції 05.
Ентропія, перехресна ентропія і відстань між розподілами
Перехресна ентропія щойно з'явилася як мінус логарифм правдоподібності. Варто назвати всі три пов'язані величини одразу — далі в курсі вони трапляться ще чотири рази, і щоразу це буде та сама величина під іншим приводом.
| Позначення | Що вимірює | Коли дорівнює нулю |
|---|---|---|
| скільки невизначеності в самому розподілі | коли | |
| ціна кодування | ніколи: знизу обмежена | |
| наскільки | рівно тоді, коли |
Зв'язок між ними — одне тотожне рівняння:
Звідси головний висновок лекції в новому формулюванні: оцінка максимальної правдоподібності — це мінімізація
Розходження несиметричне:
Ці три величини повернуться в лекції 06 як домішка вузла дерева, у лекції 09 як цільова функція t-SNE, у лекції 13 як контрастивна втрата і в лекції 14 як доданок у нижній оцінці ELBO.
Код: перехресна ентропія на даних про пухлини
Порахуємо цю величину на реальній задачі класифікації — наборі Breast Cancer Wisconsin, 569 пухлин і 30 числових ознак, передбачаємо злоякісність.
Вивід код запущено, вивід не редагувався
text
NLL руками: 0.1069 sklearn log_loss: 0.1069 модель «усім 0,5»: 0.6931На що дивитися: NLL 0,1069 однакова в ручному розрахунку й у бібліотеці і вшестеро менша за 0,6931 — втрату моделі, яка всім ставить імовірність 0,5.
Джерело даних: Breast Cancer Wisconsin, UCI
Три розподіли — три функції втрат
Зведімо все докупи. Ліва колонка — припущення про те, як породжуються дані; права — функція втрат, яку це припущення породжує.
| Модель шуму або міток | Функція втрат після | Поведінка | Де в курсі |
|---|---|---|---|
| Гаусів шум | середній квадрат похибки, MSE | легкі хвости, чутлива до викидів | лекції 02–03 |
| Лапласів шум, масштаб | середній модуль похибки, MAE | важкі хвости, стійка до викидів | лекція 02 |
| Бернуллі з сигмоїдою | перехресна ентропія | бінарна класифікація | лекція 05 |
Рецепт не вичерпується трьома рядками. Якщо ціль — лічильник подій, природною моделлю є розподіл Пуассона, і NLL дає втрату, якої немає в жодному стандартному списку. Якщо мітка порядкова (оцінка від однієї до п'яти зірок), будується своя модель і своя втрата. Саме тому імовірнісний погляд цінний: він дає не набір готових формул, а спосіб виводити нові.
Гарантії оцінки максимальної правдоподібності
MLE популярна не лише через зручність. У неї є три властивості, які варто знати.
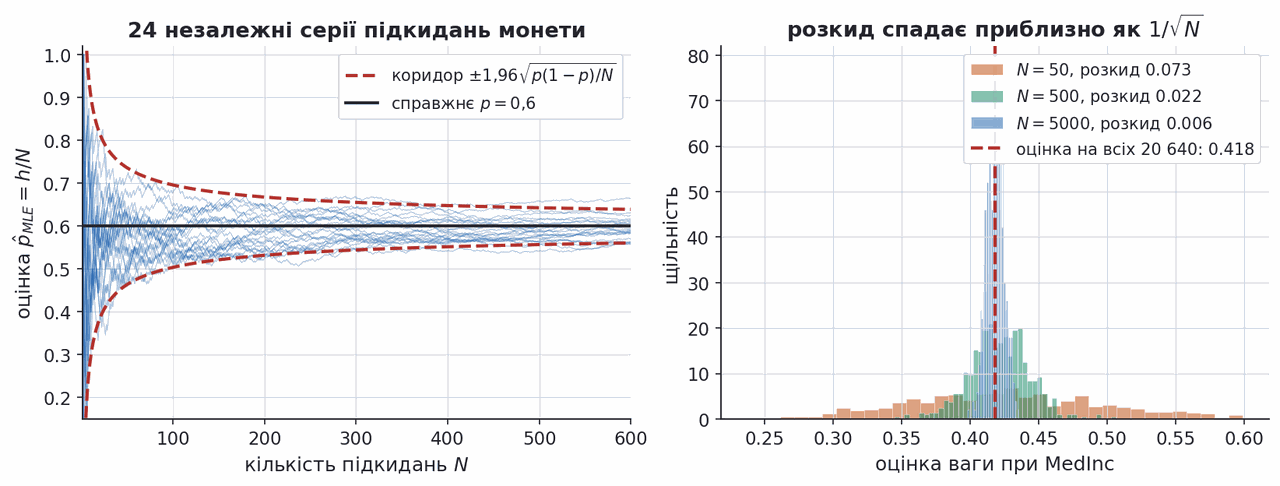
Консистентність. За зростання обсягу даних оцінка збігається за ймовірністю до справжнього значення параметра — за умови, що модель обрано правильно. Ліворуч на рисунку 24 незалежні серії підкидань монети з
Швидкість близько
Асимптотична нормальність і ефективність. Для великих
Незміщеність: оцінка в середньому влучає в правду
Слово «незміщений» з попереднього розділу варто розібрати окремо. Оцінку рахують на випадковій вибірці, тож вона сама випадкова: інша вибірка — інше число. Оцінку називають незміщеною (unbiased), якщо її середнє по всіх можливих вибірках дорівнює справжньому значенню. Різниця між цим середнім і правдою — зміщення (bias), те саме слово, що в розкладі помилки з лекції 03.
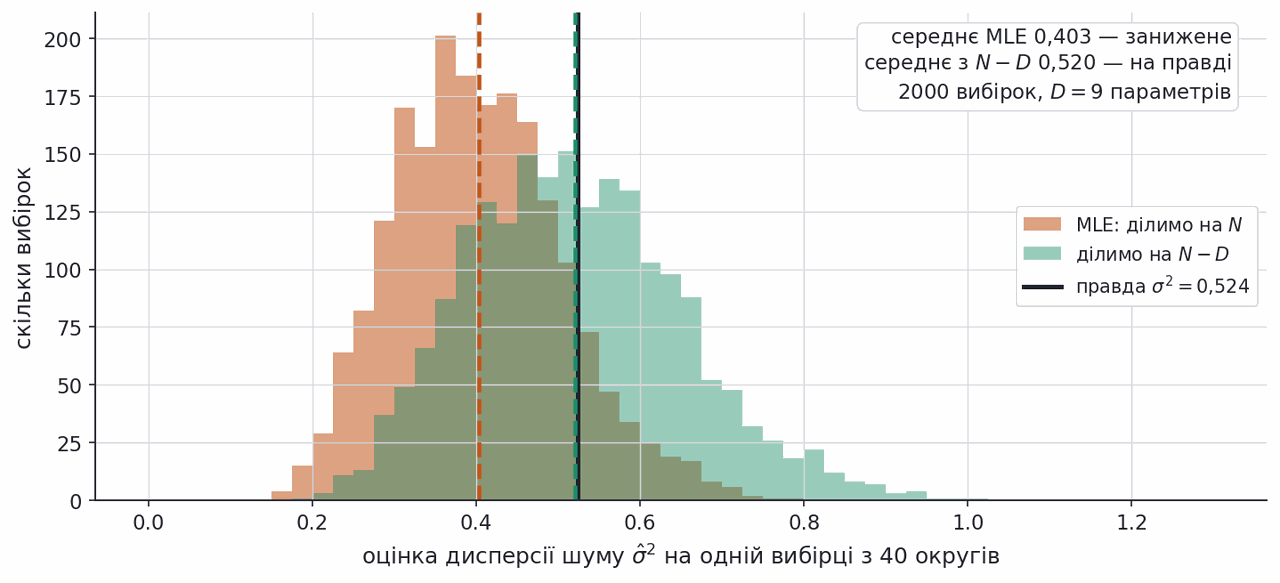
MLE незміщеності не гарантує. Приклад — дисперсія шуму: MLE ділить суму квадратів залишків на
Рисунок перевіряє це там, де правду знаємо: дані породжено самою моделлю з
Код: дві оцінки σ на California Housing
На справжніх даних правди ми не знаємо, але можемо порівняти обидві оцінки на всіх 20 640 округах і на сорока.
Вивід код запущено, вивід не редагувався
text
N = 20640:  MLE 0.7241  незміщена 0.7243
N = 40:     MLE 0.5665  незміщена 0.6435
множник sqrt((N-D)/N) при N = 40: 0.88
На що дивитися: на 20 640 округах оцінки майже збігаються (0,7241 і 0,7243), а на 40 точках MLE помітно менша — 0,5665 проти 0,6435, рівно в 0,88 раза.
На всіх округах різниця невидима: 0,7241 проти 0,7243. На сорока MLE дає 0,5665, поправлена оцінка — 0,6435, і множник між ними рівно
Але обидві нижчі за 0,724 на повних даних. Поправка
Оцінка максимальної правдоподібності вірить даним беззастережно
Усі гарантії з попереднього розділу асимптотичні, тобто справджуються за великого
Найкоротший приклад — та сама монета. Три підкидання, три орли: правдоподібність максимальна при
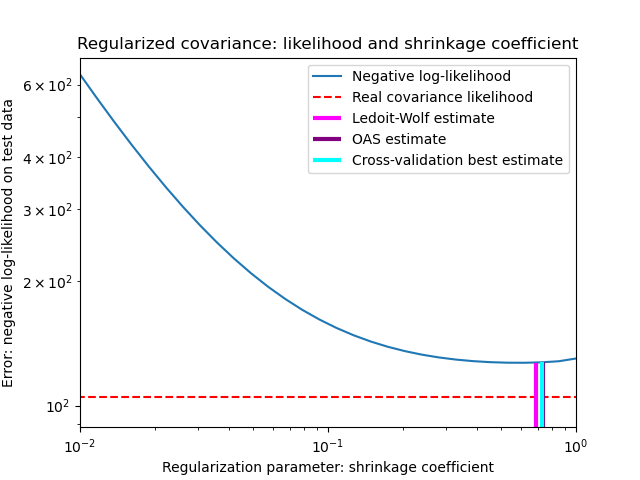
На рисунку та сама хвороба на серйознішій задачі — оцінюванні коваріаційної матриці. Горизонтальна вісь показує силу стягування оцінки до простої, вертикальна — від'ємну лог-правдоподібність на нових даних. Ліворуч, де стягування майже немає, працює практично чиста оцінка максимальної правдоподібності — і вона найгірша з усіх. Мінімум досягається аж біля 0,7. Червоний пунктир унизу показує, наскільки добре описала б дані справжня коваріація.
Правило Баєса переставляє умову
Ліки від надмірної довіри до даних дає теорія ймовірностей. Досі ми максимізували
Перехід між цими двома величинами дає правило Баєса:
Три нові назви.
Апріорний розподіл — це не здогадка з нічого. Для California Housing ми знаємо, що ознаки стандартизовані, а ціни лежать у межах кількох одиниць, тож вага величиною сто була б абсурдною ще до жодного спостереження.
MAP: правдоподібність, помножена на пріор
Оцінка максимуму апостеріорної ймовірності (maximum a posteriori, MAP) — це вершина апостеріорного розподілу:
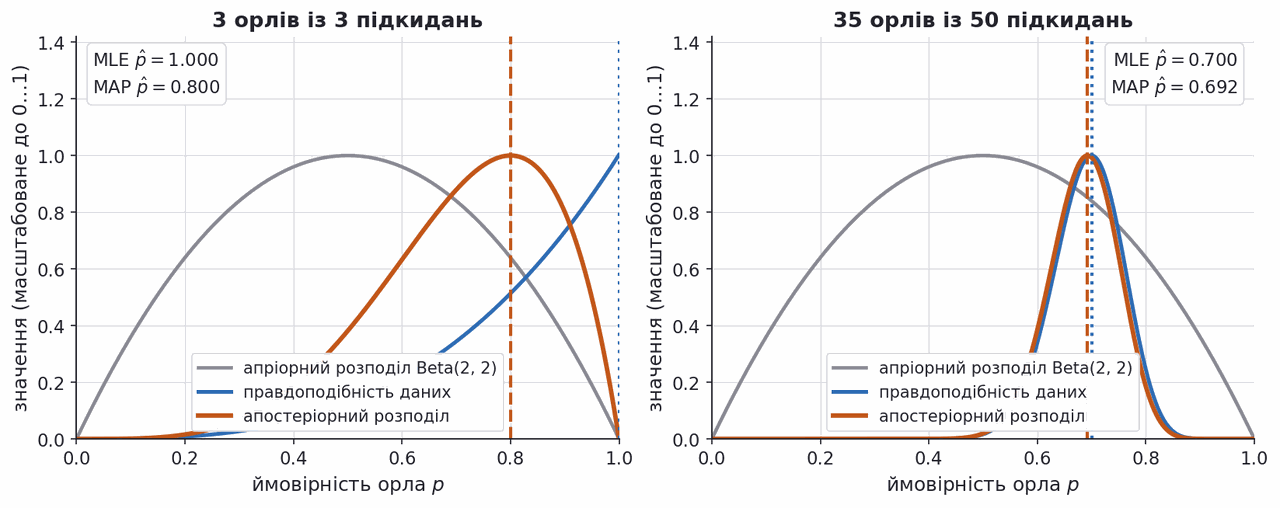
Повернімось до монети. Апріорне переконання «монета радше чесна, але я не наполягаю» описує розподіл Beta(2, 2) — сірий горб із центром у 0,5.
Ліворуч: три орли з трьох підкидань. Правдоподібність зростає монотонно й дає
Праворуч: 35 орлів із 50 підкидань. Правдоподібність уже гострий пік, і пріор майже нічого не змінює: 0,700 проти 0,692. Це загальне правило — чим більше даних, тим менший вплив апріорних припущень.
Мінус логарифм пріора — це регуляризатор
Перепишімо MAP у тій самій формі, у якій ми записуємо втрати: беремо мінус логарифм і мінімізуємо.
Ця рівність і є другим головним результатом лекції. Регуляризатор із лекції 03, який виглядав інженерним прийомом, виявляється мінус логарифмом апріорного розподілу ваг. Обираючи штраф, ви обираєте, у що вірите щодо ваг до початку навчання.
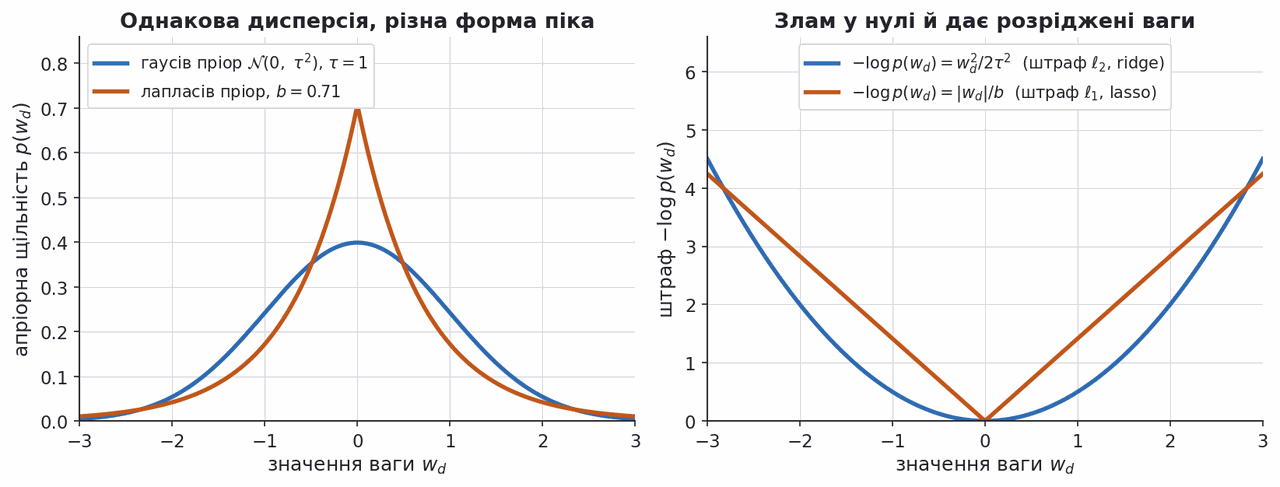
Рисунок показує обидва пріори, які нас цікавлять, з однаковою дисперсією. Гаусів має круглу вершину, лапласів — гострий злам у нулі. Праворуч їхні мінус логарифми: парабола
Гаусів пріор дає ridge
Візьмімо гаусів пріор на кожній вазі:
Праворуч стоїть саме те, що мінімізує Ridge(alpha=…) у scikit-learn. Коефіцієнт регуляризації має точний зміст: це відношення дисперсії шуму до дисперсії пріора. Вузький пріор (мале
На рисунку — шляхи коефіцієнтів ridge. Зверніть увагу на напрямок осі: зліва направо регуляризація слабшає, тому ваги розходяться від нуля саме праворуч.
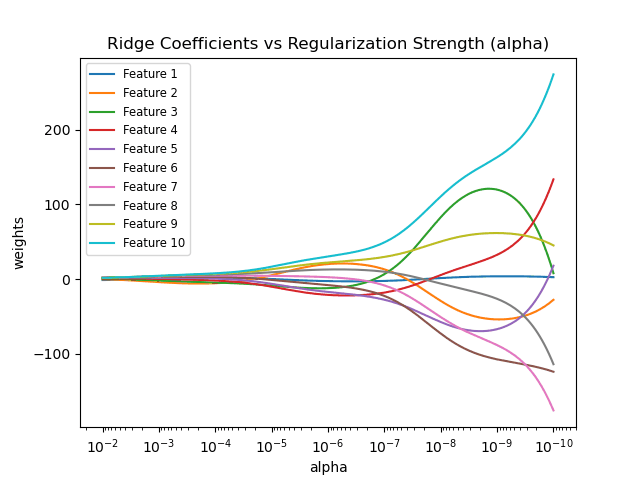
Джерело: scikit-learn · Ridge coefficients as a function of regularization
Код: MAP і ridge дають однакові ваги
Перевіримо рівність
Вивід код запущено, вивід не редагувався
text
alpha = σ²/τ² = 5.826
макс. розбіжність: 1.78e-15
На що дивитися: ваги MAP і Ridge з alpha = σ²/τ² = 5,826 збігаються до 10⁻¹⁵, тобто до похибки заокруглення.
Зсув моделі навмисно не штрафують: апріорне переконання «ціни близькі до нуля» жодного сенсу не має, на відміну від переконання «жодна ознака не має величезної ваги».
Лапласів пріор дає розріджені ваги
Замінімо гаусів пріор на лапласів: мінус логарифм дає
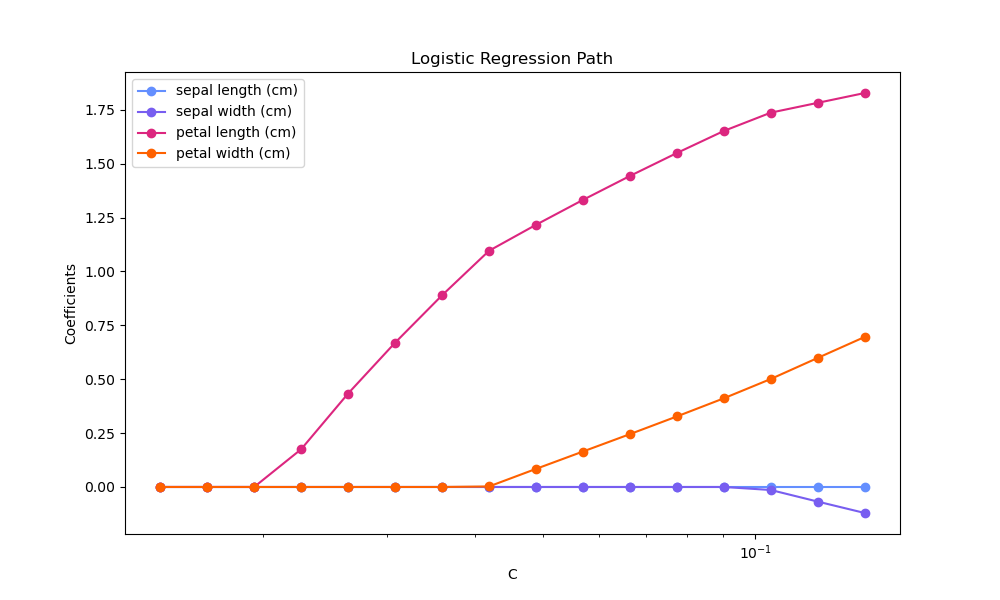
Джерело: scikit-learn · Regularization path of L1-Logistic Regression
Апріорний розподіл рятує оцінку на малій вибірці
На всіх 20 640 округах пріор майже не впливає на результат: даних настільки багато, що правдоподібність перемагає будь-яке апріорне переконання. Різниця з'являється там, де даних мало.
Візьмімо випадкові 40 округів і навчимо на них ту саму модель. Метод найменших квадратів дає ваги довжиною
Ліворуч видно, як гаусів пріор стягує ваги до нуля в міру звуження. Праворуч — помилка на нових даних: мінімум досягається при
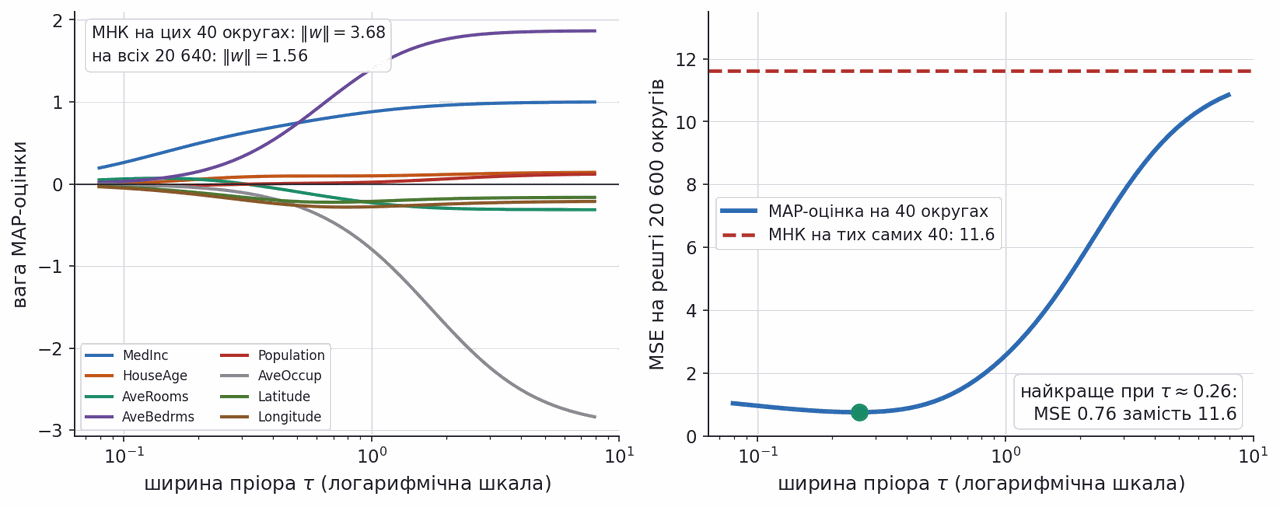
Занадто вузький пріор теж шкідливий: при
Байєсова регресія: прогноз як розподіл
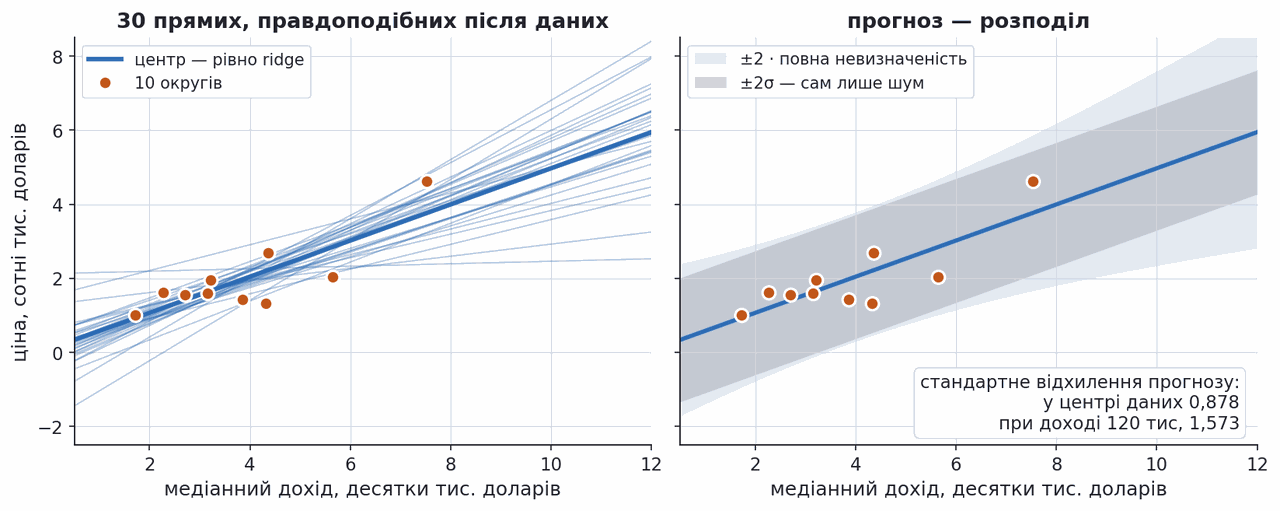
MAP бере з апостеріорного розподілу лише вершину — одну пряму. Але після даних правдоподібна не одна пряма, а ціла множина: одні більше, інші менше. Байєсова регресія зберігає цей розподіл і прогнозує, усереднюючи всі правдоподібні прямі.
Ліворуч — 10 випадкових округів і 30 прямих, витягнутих з апостеріорного розподілу; до даних ми вважали нахил
Для гаусового шуму й гаусового пріора прогноз теж гаусів, і його дисперсія має дві частини:
Перша однакова всюди й не зменшується з даними. Друга мала там, де даних багато, і росте за їхніми межами. Праворуч: у центрі даних стандартне відхилення прогнозу 0,878 — майже сам шум, а при доході 120 тисяч — 1,573.
У scikit-learn це BayesianRidge. Обережно з позначеннями: там
MLE і MAP поруч
| MLE | MAP | |
|---|---|---|
| Максимізує | ||
| Питання | за яких ваг дані найімовірніші | які ваги найімовірніші за таких даних |
| У мові втрат | чиста функція втрат | втрата плюс регуляризатор |
| Що потрібно задати | модель шуму | модель шуму й апріорний розподіл |
| Слабке місце | перенавчається на малих вибірках | результат залежить від вибору пріора |
Обидві оцінки повертають одне число на кожну вагу, тобто відкидають інформацію про невизначеність. Повний байєсів підхід її зберігає, але потребує обчислення інтегралів, які для більшості моделей беруться лише наближено.
За зростання обсягу даних MAP наближається до MLE: пріор — це фіксована кількість «уявних спостережень», і на тлі мільйона реальних вона зникає.
Походження кожної формули лекції
Усе, що ми вивели, — два принципи і кілька припущень. MLE максимізує
| Метод | Принцип | Припущення | Що мінімізуємо | Де в курсі |
|---|---|---|---|---|
| МНК, MSE | MLE | гаусів шум | Л02, Л04 | |
| MAE, медіанна регресія | MLE | шум Лапласа | Л02, Л04 | |
| Хубер | MLE | Гаус у центрі, Лаплас на хвостах | Л02, Л04 | |
| Квантильна регресія | MLE | асиметричний шум Лапласа | Л02 | |
| Логістична регресія | MLE | мітка з розподілу Бернуллі | перехресна ентропія | Л04, Л05 |
| Ridge | MAP | гаусів шум і гаусів пріор | Л03, Л04 | |
| Lasso | MAP | гаусів шум і пріор Лапласа | Л03, Л04 | |
| Байєсова регресія | увесь апостеріорний розподіл | гаусів шум і гаусів пріор | нічого: прогноз — розподіл | Л04 |
Тут
Обмеження ймовірнісного підходу
Модель шуму — це припущення, а не факт. Ми бачили це на власних даних: залишки California Housing описуються лапласовою моделлю краще, ніж гаусовою, а курс усе одно навчає модель за MSE. Припущення варто перевіряти, дивлячись на розподіл залишків.
Незалежність спостережень порушується частіше, ніж здається. Сусідні округи Каліфорнії корелюють між собою, вимірювання одного пацієнта в різні дні — теж. Добуток ймовірностей у такому разі неправильний, і оцінка невизначеності виходить надто оптимістичною.
Максимум не описує розподіл. Якщо апостеріорний розподіл має дві вершини або сильно асиметричний, його вершина погано представляє те, у що ми віримо.
Пріор доводиться обирати. Гаусів і лапласів пріори популярні не тому, що вони найкраще описують реальність, а тому, що дають зручні штрафи. Це чесно визнаний компроміс.
Обчислювальна складність. Для складних моделей ані максимум правдоподібності, ані апостеріорний розподіл не беруться аналітично — потрібні чисельні методи.
Підсумок лекції
Модель породження даних замінює постульовану втрату. Достатньо описати, як виникає ціль, — і функція втрат виводиться, а не вигадується.
Гаусів шум дає метод найменших квадратів. Ми перевірили це і аналітично, і чисельно: MLE збігається з розв'язком нормальних рівнянь до похибки оптимізатора, а
Вибір функції втрат — це вибір моделі шуму. Гаус дає MSE, Лаплас — MAE, Бернуллі — перехресну ентропію. Три рядки однієї таблиці замість трьох непов'язаних рецептів.
Регуляризація — це апріорний розподіл. Ridge є MAP-оцінкою з гаусовим пріором при
Мала вибірка вимагає пріора, велика його не помічає. На 40 округах пріор зменшив помилку в п'ятнадцять разів, на 20 640 не змінив майже нічого.
У наступній лекції той самий принцип збудує логістичну регресію: розподіл Бернуллі, перехресна ентропія, градієнт «прогноз мінус мітка».
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекція 03c: гаусова модель, властивості MLE
- UBC CPSC 340 — лекції 23–24: NLL, MAP, пріор
- Stanford CS229 — розділ 3
Підручники
- Bishop C. Pattern Recognition and Machine Learning — розділ 3
- Murphy K. Probabilistic Machine Learning — розділи 4–11
Історія
- Stigler S. M. Gauss and the Invention of Least Squares, 1981
Документація