Тема
Лекція 03 · Узагальнення, перенавчання та регуляризація
У лекції 02 ми навчилися підганяти модель під наявні дані. Тепер з'ясуємо головне: чи працюватиме вона на даних, яких ніколи не бачила, — і що робити, коли модель запам'ятовує навчальну вибірку замість того, щоб вивчати закономірність.
Зміст лекції
Лекція розгортається чотирма кроками: спершу побачимо явище, потім навчимося його вимірювати, далі пояснимо його причину і насамкінець отримаємо ліки.
- Недонавчання і перенавчання. Що відбувається, коли клас моделей заслабкий або занадто багатий, і чому нульова помилка на навчальних даних нічого не гарантує.
- Чесне вимірювання якості. Справжня та емпірична помилка, поділ на навчальну, валідаційну й тестову вибірки, крос-валідація.
- Розклад помилки на зміщення й дисперсію. Звідки береться U-подібна крива складності та які три доданки утворюють помилку.
- Регуляризація ridge і lasso. Штраф за складність, геометрія L2 і L1, розрідженість як автоматичний відбір ознак, вибір гіперпараметра λ.
Кожен крок відповідає на питання, яке ставить попередній: явище треба виміряти, вимірювання треба пояснити, а пояснення підказує ліки.
Чого ви навчитеся
Після цієї лекції ви зможете:
- відрізнити недонавчання від перенавчання за поведінкою помилки на навчальній і на новій вибірках;
- пояснити, чому тренувальна помилка систематично занижує справжню помилку моделі;
- розділити дані на навчальну, валідаційну й тестову частини та сказати, за що відповідає кожна;
- провести крос-валідацію за M блоками й оцінити не лише помилку, а й її розкид;
- записати розклад помилки на шум, квадрат зміщення та дисперсію і пояснити зміст кожного доданка;
- застосувати закриту форму ridge-регресії та пояснити, чому вона рятує погано обумовлену задачу;
- пояснити геометрично, чому L1-штраф занулює частину ваг, а L2 лише стискає їх;
- підібрати λ крос-валідацією й уникнути витоку даних під час підбору.
Модель, що вивчила навчальні дані напам'ять
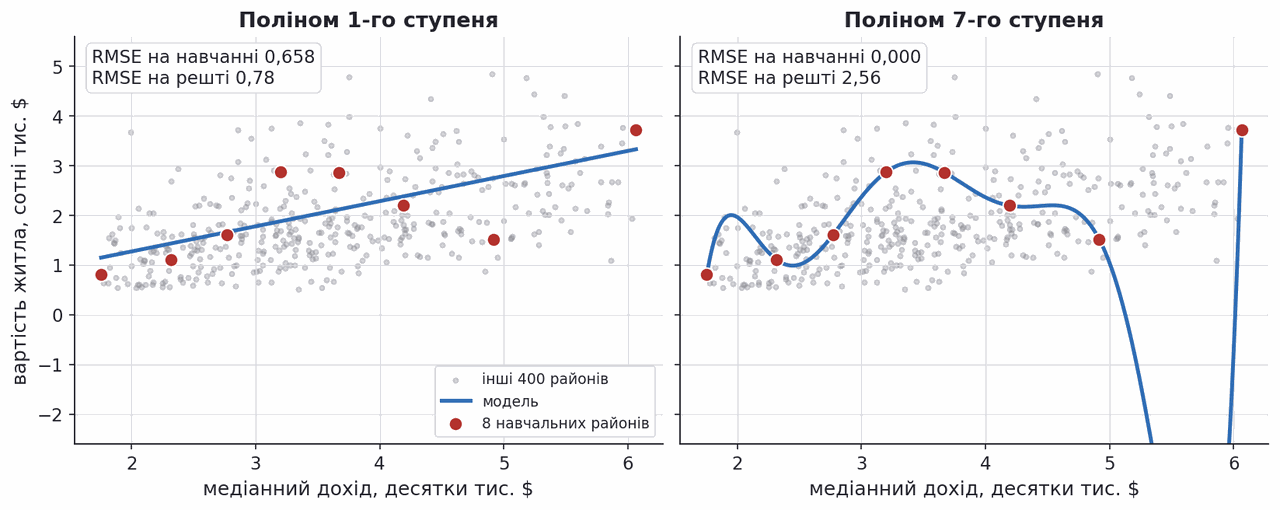
Візьмімо вісім районів Каліфорнії і спробуймо передбачити медіанну вартість житла за медіанним доходом мешканців. Пряма лишає помітні відхилення: RMSE на цих восьми районах дорівнює 0,658. Поліном сьомого степеня проходить рівно через усі вісім точок, і його помилка на навчальних даних дорівнює нулю.
Тепер покажемо обом моделям ще 400 районів із того самого діапазону доходів — картина перевертається. У прямої RMSE 0,78, у полінома 2,56. Між навчальними точками поліном вигинається як завгодно, а в правій частині взагалі передбачає від'ємну вартість житла.
Нульова помилка на навчальних даних — не досягнення, а попередження.
Дані лекції: ціни на житло в Каліфорнії
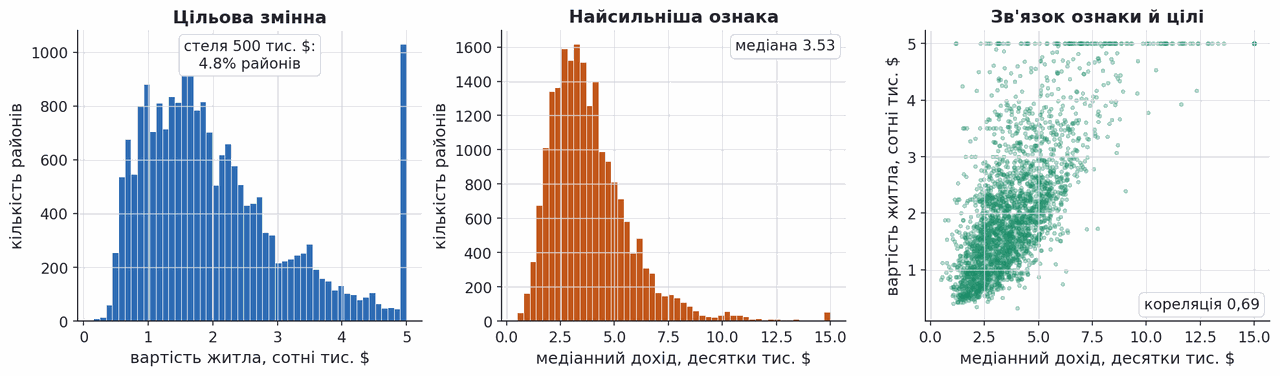
Набір даних цієї лекції — той самий, що в лекції 02: California Housing, 20 640 груп кварталів за даними перепису США 1990 року; тут ми називаємо їх районами, у лекції 02 — округами, це одна й та сама одиниця спостереження. Для кожного району відомі вісім числових ознак: медіанний дохід мешканців, середній вік забудови, середня кількість кімнат і спалень на житло, населення, середня кількість мешканців на житло, широта й довгота. Передбачаємо медіанну вартість житла в районі, виміряну в сотнях тисяч доларів.
Дві особливості даних видно одразу. Вартість обрізана згори на позначці 500 тис. $ — таких районів 4,8 %, і це штучна стеля збору даних, а не властивість ринку. Медіанний дохід має довгий правий хвіст. Найсильніший одиничний предиктор — саме дохід: кореляція з ціною 0,69.
Джерело даних: scikit-learn · California Housing
Розширення ознак поліномом
Лінійна модель обмежена прямою лише доти, доки ми годуємо її сирими ознаками. Замінімо кожне спостереження
| Позначення | Значення |
|---|---|
| вихідна ознака | |
| максимальний степінь — гіперпараметр складності моделі | |
| ваги, які підбирає метод найменших квадратів |
Модель лишається лінійною за вагами, тому працює той самий розв'язок, що й у лекції 02: розширення ознак — це препроцесинг. У джерелах степінь позначають то
Вивід код запущено, вивід не редагувався
text
[[ 1.     1.5    2.25   3.375]
 [ 1.     2.     4.     8.   ]
 [ 1.     3.2   10.24  32.768]]
На що дивитися: кожен рядок — одна точка x, розкладена на степені 1, x, x², x³: з однієї ознаки вийшло чотири стовпці.
Недонавчання і перенавчання
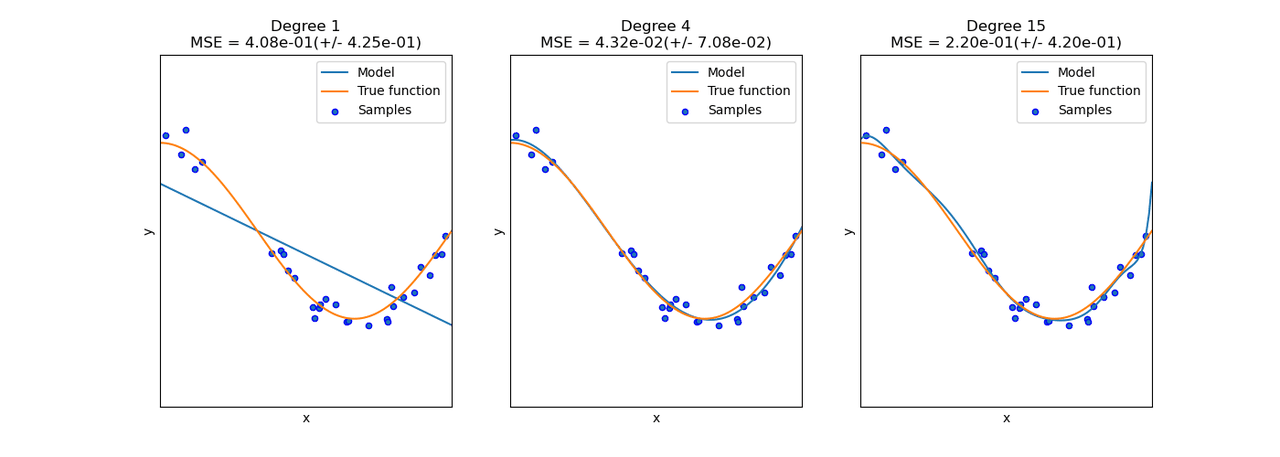
Той самий набір точок і три різні класи моделей. Пряма не здатна вигнутися за даними — це недонавчання (underfitting). Поліном четвертого степеня майже збігається зі справжньою функцією. Поліном п'ятнадцятого степеня проходить впритул до кожної точки, повторюючи шум вимірювань, — це перенавчання (overfitting).
"Models can be too limited … we cannot find a function that is a good fit for the data in our model. We then say that we underfit. … We have such a rich model family that we do not just fit the underlying function but we in fact fit the noise in the data as well." — EPFL CS-433, лекція 03b
Складність у тому, що справжньої функції на практиці ми не бачимо: у нас є лише дані, і заздалегідь невідомо, де в них сигнал, а де шум.
Клас моделей і справжня функція
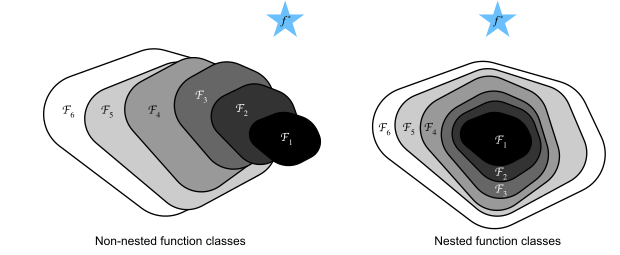
Обираючи степінь полінома, ми насправді обираємо цілий клас моделей (model class) — множину функцій, серед яких алгоритм шукатиме найкращу. Справжня залежність
На схемі кожна область — окремий клас моделей, зірка — справжня функція. Ліворуч класи не вкладені один в одний: збільшуючи складність, ми можемо навіть віддалитися від
Звідси обережний висновок: багатший клас моделей сам собою не наближає нас до правильної відповіді. Він лише дає більше свободи — і тим більший ризик, що ця свобода піде на підганяння під шум.
Помилка на навчальних і на нових даних
Повернімося до прикладу, де справжня залежність відома:
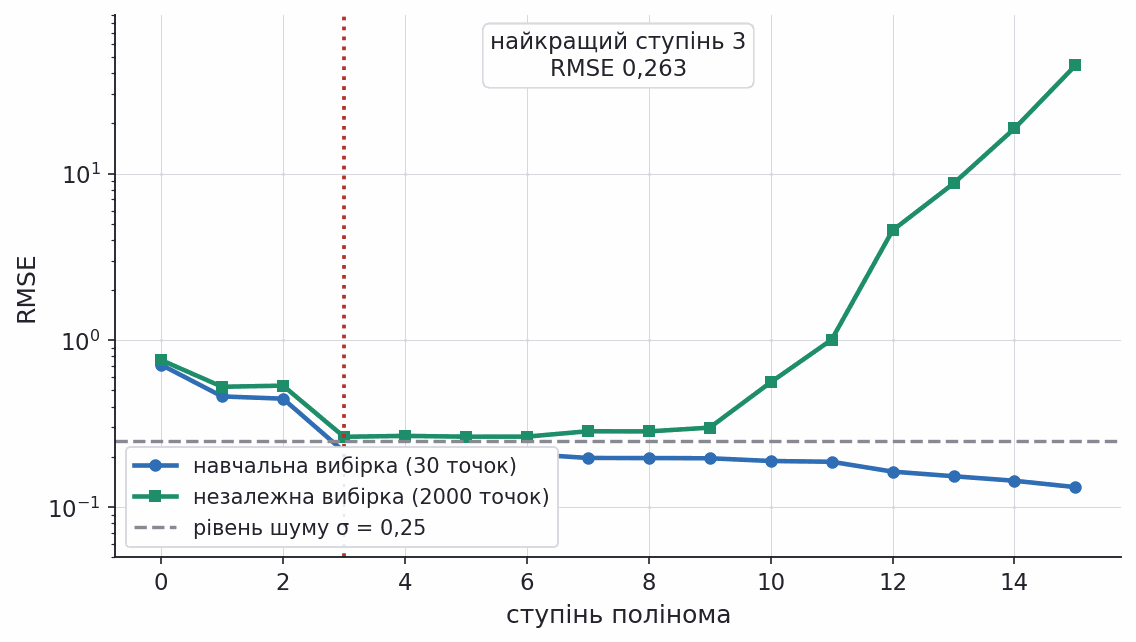
Помилка на навчальних даних спадає монотонно: що більше ступенів свободи, то точніше модель проходить крізь точки. Помилка на нових даних поводиться інакше — спадає до степеня 3, де досягає 0,263, тримається на плато до степеня 9, а далі стрімко зростає: на степені 15 вона вже 44,5.
Рівень шуму 0,25 — це підлога, нижче якої не опуститься жодна модель. Найкращий поліном підходить до неї впритул.
Більше даних приборкує складну модель
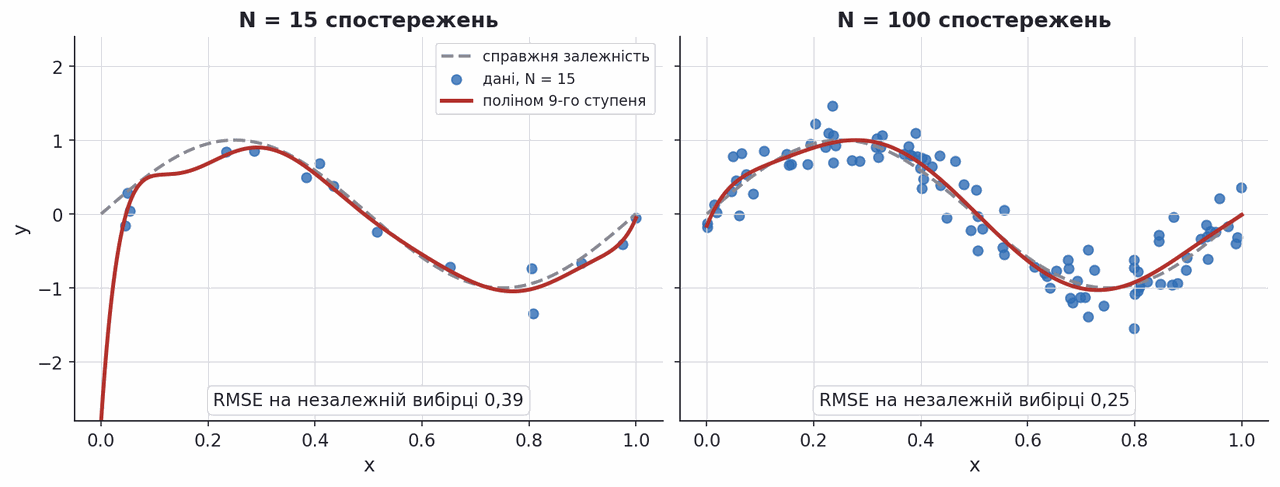
Степінь полінома — не єдиний важіль. Залишмо степінь 9 незмінним і збільшмо вибірку.
На 15 точках модель дев'ятого степеня має майже стільки ж параметрів, скільки спостережень, і вигинається, щоб пройти поруч із кожним: RMSE на незалежній вибірці 0,39. На 100 точках та сама модель уже не може догодити всім одразу, змушена шукати компроміс — і виходить на форму справжнього синуса: RMSE 0,25, тобто рівно рівень шуму.
Правило звідси просте: перенавчання — не властивість моделі, а співвідношення між її гнучкістю та кількістю даних.
Справжня та емпірична помилка
Дані
| Позначення | Значення |
|---|---|
| розподіл, з якого беруться дані; невідомий | |
| втрата на одному спостереженні, наприклад | |
| емпірична помилка: незміщена оцінка справжньої, якщо | |
| тренувальна помилка: та сама формула, але |
Різницю
Три ролі даних: навчання, валідація, тест
Оцінити справжню помилку можна лише на даних, яких модель не бачила, тому вибірку ділять на три частини з різними обов'язками.
Навчальна підбирає ваги
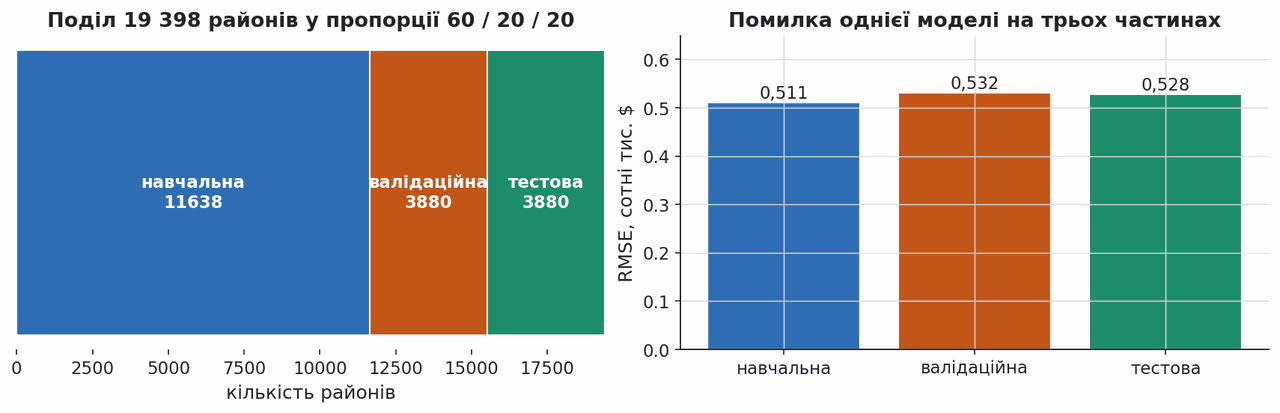
На рисунку 19 398 районів Каліфорнії — це ті, що лишилися з 20 640 після відсіву районів зі стелею 5,0 та явних викидів за кількістю кімнат, мешканців і населенням — поділено у пропорції 60/20/20, і на кожній частині виміряно помилку однієї й тієї самої моделі: 0,511 на навчальній, 0,532 на валідаційній, 0,528 на тестовій. Різниця між першим і другим числом — це розрив узагальнення в явному вигляді.
Компроміс очевидний: що більше даних віддано на оцінювання, то менше лишається на навчання.
Джерело поділу на три частини: Hastie, Tibshirani, Friedman · The Elements of Statistical Learning, §7.2
Розмір тестової вибірки визначає точність оцінки
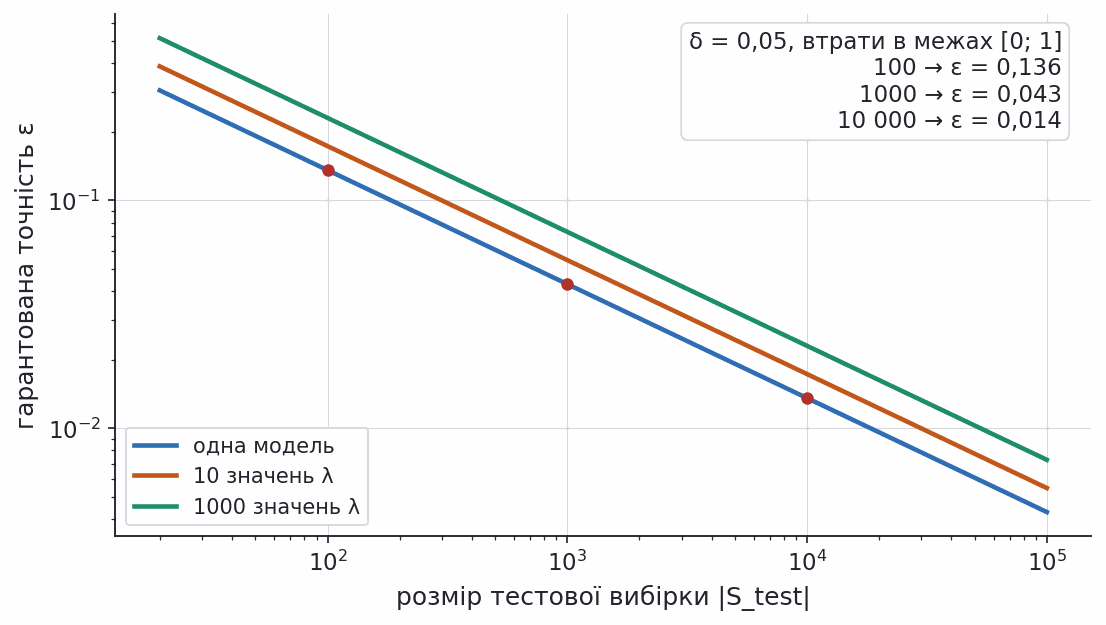
Число, отримане на тесті, теж випадкове: воно залежить від того, які саме спостереження туди потрапили. Якщо втрати обмежені відрізком
Точність спадає як
Крос-валідація за M блоками
Один поділ витрачає дані марно й залежить від того, які точки потрапили у валідацію. Крос-валідація (cross-validation) знімає обидві вади: дані ділять на M блоків і M разів навчають на M−1 із них, перевіряючи на решті.
"Cross-validation returns an estimate of the generalization-error and its variance." — EPFL CS-433, лекція 04a
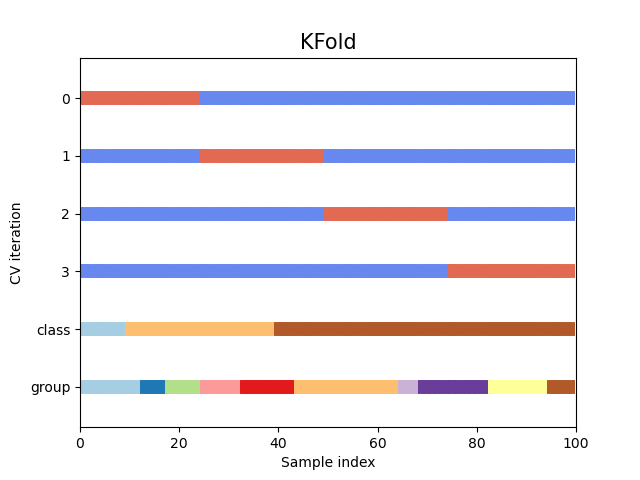
Джерело: scikit-learn · Visualizing cross-validation behavior
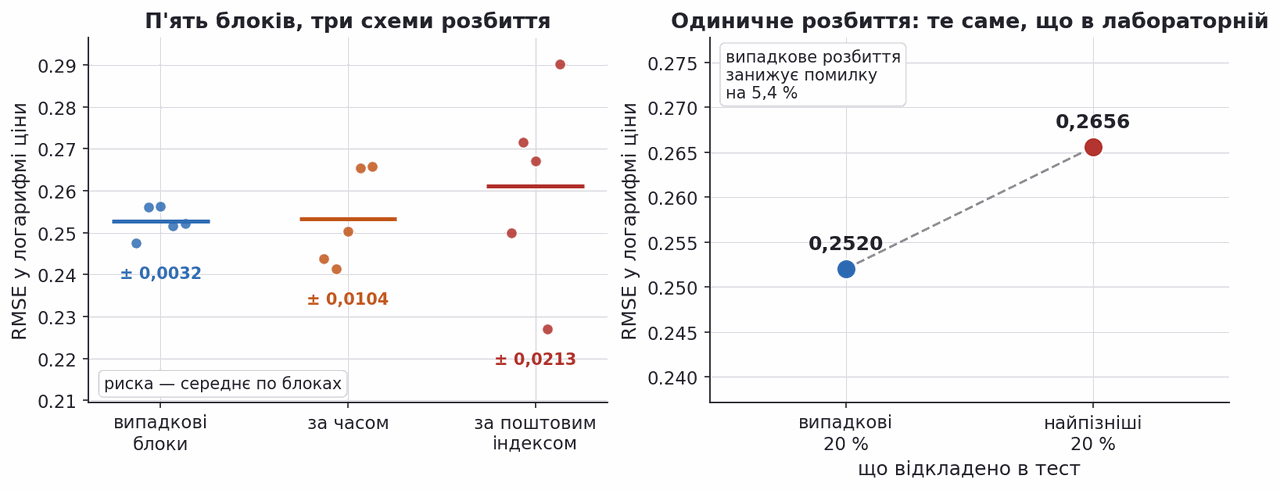
Найважливіші тут останні слова: «and its variance». Випадкові блоки припускають незалежність спостережень, а вона є не завжди. Порівняймо на King County із лабораторної три схеми: випадкові блоки, поділ за часом угоди й групування за поштовим кодом.
Вивід код запущено, вивід не редагувався
text
випадкові блоки    RMSE 0.2527 ± 0.0032
за часом угоди     RMSE 0.2533 ± 0.0104
за поштовим кодом  RMSE 0.2612 ± 0.0213
На що дивитися: середні RMSE майже однакові, а розкид між блоками зростає всемеро — від ±0,0032 при випадкових блоках до ±0,0213 при розбитті за поштовим кодом.
Середні майже збігаються — це й найнебезпечніше. Дивитися треба на розкид: ±0,0032, ±0,0104 і ±0,0213 — усемеро більше на тих самих даних. Випадкове перемішування не так завищує якість, як приховує, наскільки погано ми її знаємо.
Права панель — одиничне розбиття: найпізніші 20 % дають RMSE 0,2656 проти 0,2520 у випадкових.
Вибір степеня полінома крос-валідацією
Перевіримо це: 500 районів Каліфорнії, вісім ознак, розширених поліномом, п'ять блоків.
Вивід код запущено, вивід не редагувався
text
степінь 1:  RMSE = 0.617 ± 0.090
степінь 2:  RMSE = 0.608 ± 0.056
степінь 3:  RMSE = 1.477 ± 0.542
степінь 4:  RMSE = 63.776 ± 52.422
На що дивитися: найменша помилка — на степені 2; на третьому RMSE зростає більш ніж удвічі, на четвертому стає безглуздою, а розкид по блоках сягає ±52.
Крос-валідація обирає степінь 2: уже на третьому нерегуляризована модель розсипається, на четвертому помилка стає безглуздою, а розкид по блоках — ±52.
У проєкті степінь підбирають разом із силою регуляризації, і повний перебір такої сітки задорогий. Дешевші способи: половинний пошук (successive halving) відсіює слабких кандидатів на малій частині даних, випадковий пробує N комбінацій навмання.
Вивід код запущено, вивід не редагувався
text
повний      степінь 3  RMSE на тесті 0.5730
половинний  степінь 1  RMSE на тесті 0.5997
випадковий  степінь 3  RMSE на тесті 0.5730
На що дивитися: випадковий пошук знайшов той самий оптимум, що й повний (степінь 3, RMSE 0,5730), а половинний зупинився на степені 1 і програв — 0,5997.
Результат повчальніший за очікуваний. Випадковий пошук перебрав 20 комбінацій із 60 і знайшов той самий оптимум, що й повний, — за третину обчислень. Половинний, найдешевший (47 підгонок проти 300), обрав степінь 1 замість 3 і програв: 0,5997 проти 0,5730.
Причина в механіці: він починає з 60 кандидатів на 18 рядках із 500 і щораунду лишає третину. На вісімнадцяти спостереженнях поліном третього степеня не має шансу себе показати — і вилітає першим раундом. Дешевий пошук виправданий лише там, де про кандидата можна судити за частиною даних.
Валідаційна оцінка зміщена, якщо нею ж обирали модель
Коли та сама вибірка і обирає гіперпараметр, і повідомляє результат, оцінка виходить оптимістичною: серед десятків кандидатів завжди знайдеться той, кому пощастило саме на цих точках.
Правильна схема — вкладена крос-валідація (nested cross-validation); наступний розділ розбирає її крок за кроком.
На рисунку — тридцять повторів того самого експерименту на наборі Iris. Невкладена схема систематично дає вищу оцінку якості, ніж вкладена, і різниця між ними є чистим оптимізмом від подвійного використання даних.
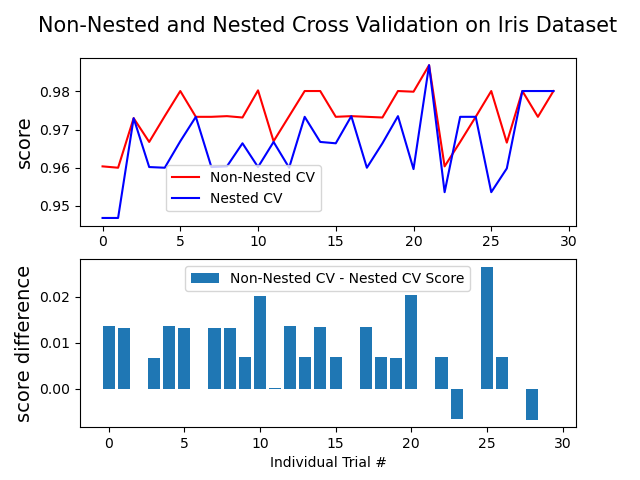
Джерело: scikit-learn · Nested versus non-nested cross-validation
Вкладена крос-валідація крок за кроком
Ідея одна: вибір гіперпараметра — теж частина навчання, тому він має відбуватися всередині процедури, а не зовні. Звідси два цикли.
- Зовнішній ділить дані на
блоків. Блок відкладається й не бере участі ні в чому. - Внутрішній працює лише на решті
блоків: ділить їх ще раз і перебирає кандидатів, обираючи найкращого. - Переможець навчається на всіх
блоках і один раз міряється на відкладеному блоці . - Так по черзі для кожного
; підсумкова оцінка — середнє по зовнішніх блоках.
Блок
Вивід код запущено, вивід не редагувався
text
невкладена: 0.9736
вкладена:   0.9663
оптимізм:   0.0074
На що дивитися: невкладена оцінка вища за вкладену на 0,0074 — це оптимізм від того, що ті самі дані й обирали гіперпараметр, і звітували про якість.
Різниця 0,0074 і є оптимізмом від подвійного використання даних: невкладена оцінка виявилася вищою у 21 випадку з 30.
Криві навчання показують, чого бракує моделі
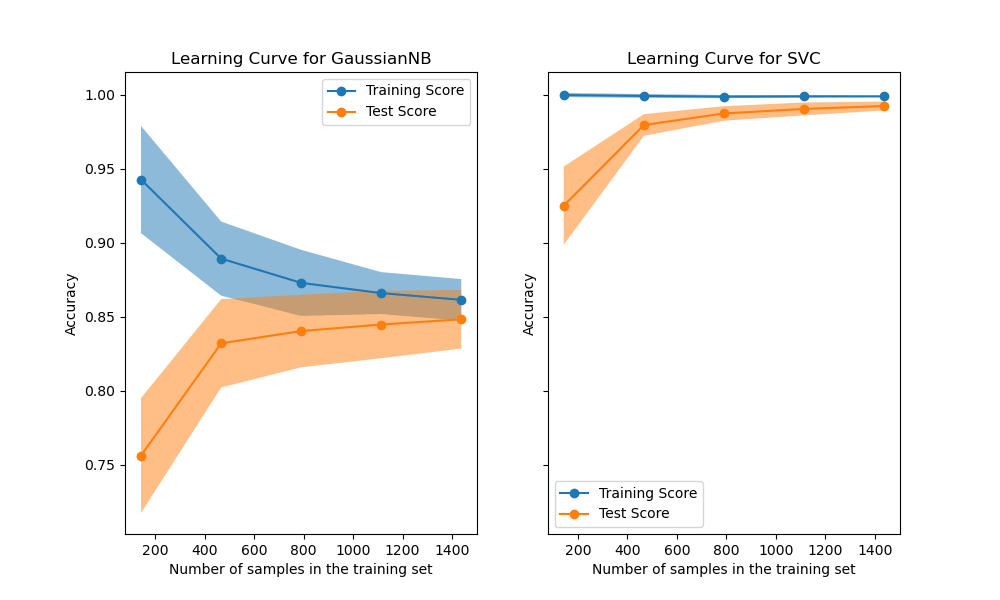
Криву «помилка проти складності» будувати дорого: потрібно перебрати всі значення гіперпараметра. Дешевша діагностика — крива навчання (learning curve): та сама модель, але дедалі більша навчальна вибірка.
Читають її за проміжком між кривими. Зійшлися на посередньому рівні — моделі бракує гнучкості, і нові дані не допоможуть; лишився широкий проміжок — модель перенавчається, і дані ще здатні його скоротити. Ліворуч на рисунку криві зійшлися на 0,86: клас моделей вичерпано. Праворуч інша модель на тих самих даних виходить на 0,99.
Та сама модель на різних вибірках
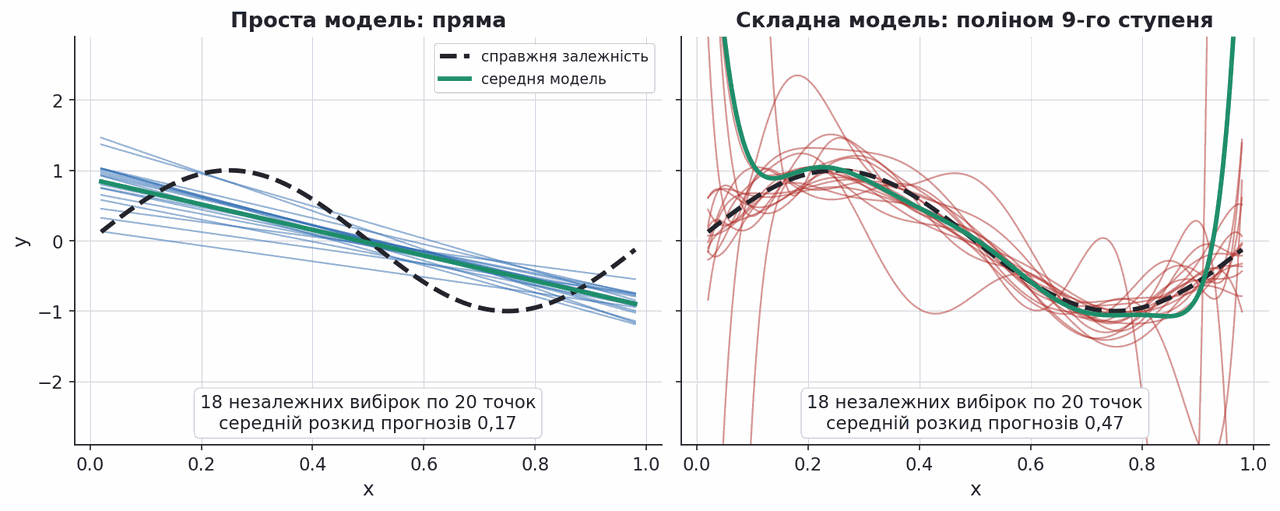
Досі ми навчалися один раз. Але навчальна вибірка сама випадкова: інші двадцять точок — інша модель. Повторімо навчання вісімнадцять разів, щоразу на новій вибірці з того самого джерела.
Пряма зсувається мало: усі вісімнадцять прямих утворюють вузький пучок, середній розкид прогнозів 0,17. Проте жодна з них не описує синус — усі систематично промахуються в одні й ті самі боки. Це зміщення (bias).
Поліном дев'ятого степеня поводиться навпаки: середня з вісімнадцяти кривих майже збігається зі справжньою функцією, зате окремі криві розлітаються, розкид 0,47. Це дисперсія (variance).
Прості моделі стабільні, але систематично помиляються. Складні в середньому праві, зате непередбачувані на конкретній вибірці.
Розклад помилки на три доданки
Нехай
| Доданок | Що вимірює | Чим зменшується |
|---|---|---|
| шум | випадковість самих вимірювань | нічим: це нижня межа |
| зміщення² | систематичний промах середньої моделі | багатшим класом моделей |
| дисперсія | чутливість моделі до конкретної вибірки | простішим класом, більшою вибіркою, регуляризацією |
Усі три доданки невід'ємні, тож кожен окремо є нижньою межею справжньої помилки. Розклад виведено для квадратичних втрат і фіксованої точки
Три доданки в числах
Порахуймо розклад чисельно. Справжня функція
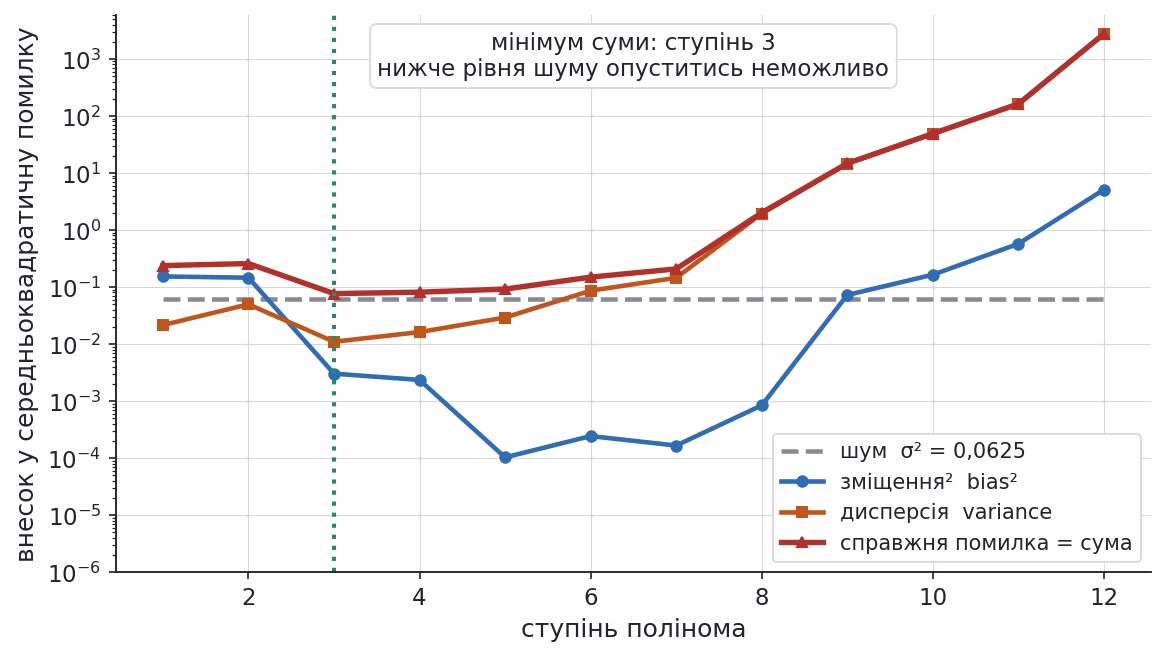
Зміщення² спадає від 0,153 на першому степені до 0,0001 на п'ятому — клас моделей стає достатньо багатим, щоб описати синус. Дисперсія робить протилежне: 0,021 на першому степені, 0,086 на шостому, 2742 на дванадцятому.
Сума мінімальна на третьому степені й дорівнює 0,076. Горизонтальна лінія шуму
Три доданки на одному повзунку
Ті самі числа, що на рисунку: справжня функція sin(2πx), шум 0,25, 400 незалежних вибірок по 25 точок. Ліворуч — шість підгонок із різних вибірок і їхнє середнє; праворуч — розклад помилки в логарифмічному масштабі.
справжнясередня модельокремі підгонки
Точок у навчальній вибірці:
0,0030зміщення²
0,0109дисперсія
0,0625шум σ² — підлога
0,0765сума — мінімум
3найкращий ступінь при 25 точках
При 25 точках на першому ступені всі шість підгонок майже збігаються — дисперсія мала, 0,021, — але жодна не схожа на синус: зміщення² дорівнює 0,153. На п'ятому зміщення падає до 0,0001, бо клас моделей уже достатньо багатий. Далі починається розплата: дисперсія 0,086 на шостому ступені й 2742 на дванадцятому, де підгонки розлітаються за межі графіка. Мінімум суми — на третьому ступені, 0,076. Сірий стовпчик шуму не рухається взагалі: це підлога, нижче якої не опуститься жодна модель, бо шум не залежить від даних.
Тепер перемкніть розмір вибірки. Зміщення² від нього майже не залежить — це властивість класу моделей, а не даних, — зате дисперсія падає з кожною доданою точкою: на дев'ятому ступені це 155 243 при 15 точках, 14,6 при 25, 0,017 при 50 і 0,005 при 100. Разом із нею відсувається межа складності, яку дані здатні прогодувати: найкращий ступінь 15 → 3 · 25 → 3 · 50 → 5 · 100 → 5. Питання «яка модель складна занадто» не має відповіді у відриві від того, скільки в нас спостережень.
На п'ятнадцяти точках варто зупинитися окремо. Рисунок вище в цій-таки лекції показує поліном дев'ятого ступеня на 15 точках із помилкою 0,39 — крива хоч і вигинається, але виглядає пристойно. Тут же дисперсія на тому самому ступені дорівнює шестизначному числу. Суперечності немає: на рисунку одна конкретна вибірка, якій пощастило, а тут — середнє за чотирмастами. Час від часу точки лягають так, що поліном іде у стелю, і саме ці рідкісні випадки дають майже весь внесок у дисперсію. У цьому й полягає сенс доданка: він міряє не те, як модель поводиться на ваших даних, а те, наскільки по-різному вона повелася б на інших даних із того самого джерела. Одна вдала вибірка про це не говорить нічого.
Чотири варіанти влучності моделі
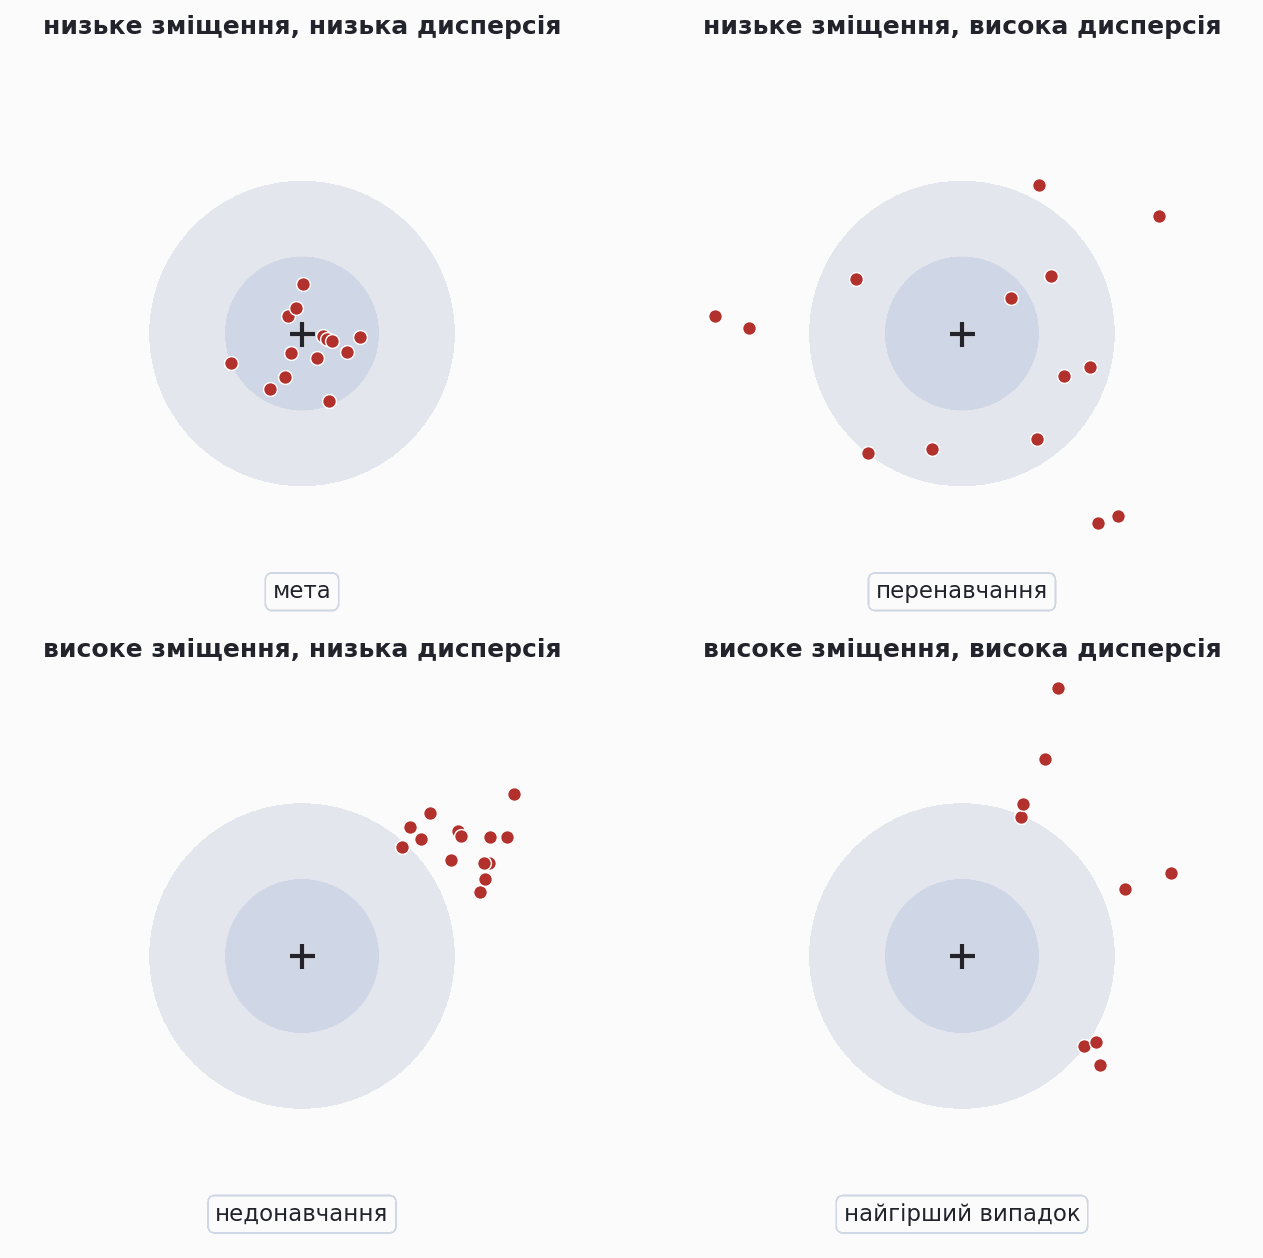
Класична метафора: модель — стрілець, справжня відповідь — центр мішені, кожен постріл — прогноз моделі, навченої на своїй випадковій вибірці.
Низьке зміщення й низька дисперсія — купно в центрі, це мета. Низьке зміщення й висока дисперсія — розкидано навколо центру: у середньому правильно, але окремий постріл ненадійний, типове перенавчання. Високе зміщення й низька дисперсія — купно, проте не туди: недонавчання. Високе зміщення й висока дисперсія — і не туди, і врозтіч.
Важлива деталь: у реальній задачі ми бачимо лише один постріл. Ані зміщення, ані дисперсію напряму виміряти не можна — саме тому їх оцінюють опосередковано, через криві навчання і крос-валідацію.
Регуляризація як штраф за складність
Досі складністю ми керували грубо — вибором степеня. Гнучкіший підхід: залишити багатий клас моделей, але додати до функції втрат плату за складність.
"Through regularization, we can penalize complex models and favor simpler ones. The second term Ω is a regularizer, measuring the complexity of the model given by w." — EPFL CS-433, лекція 03d
Тепер модель має вибір: або зменшувати помилку на даних, або тримати ваги малими. Множник перед
Регуляризація ніколи не зменшує помилку на навчальних даних — мінімум береться по звуженому вибору. А от розрив узагальнення вона зменшує лише зазвичай, а не завжди: за невдалого
Ridge-регресія: штраф за квадрат норми ваг
Найпоширеніший регуляризатор — квадрат евклідової норми. У парі із середньоквадратичною втратою це ridge-регресія:
Задача лишається квадратичною, тому розв'язок є в закритій формі:
При Ridge(alpha=…) у scikit-learn мінімізує alpha — це наше alpha.
Погано обумовлена задача робить МНК нестійким
Ridge не лише стримує складність — він лікує конкретну числову хворобу. Якщо ознаки майже колінеарні або їх більше, ніж спостережень, матриця
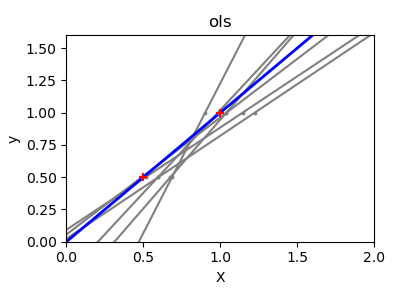
На рисунку одну й ту саму задачу розв'язано методом найменших квадратів кілька разів, щоразу з мікроскопічно зсунутими точками. Прямі розлітаються віялом: дані змінилися на частки відсотка, а модель — цілком.
Той самий ефект у числах. Дві майже однакові ознаки, $x_2 = x_1 + $ шум амплітуди 0,01, справжня залежність
Джерело: scikit-learn · Ordinary Least Squares and Ridge Regression
Шлях коефіцієнтів ridge
Що більший λ, то сильніше стискаються ваги. Рисунок показує це на класичному прикладі: матриця Гільберта — навмисно погано обумовлена система з десятьма ознаками.
Вісь λ спрямована справа наліво: праворуч регуляризації майже немає, ліворуч вона відчутна. У правій частині ваги розбігаються в сотні, бо модель компенсує одну велику вагу іншою, протилежною за знаком. У лівій усі десять траєкторій сходяться до нуля.
Головне спостереження таке: жодна траєкторія не досягає нуля на скінченному λ. L2-штраф стискає ваги, але не вимикає ознаки.
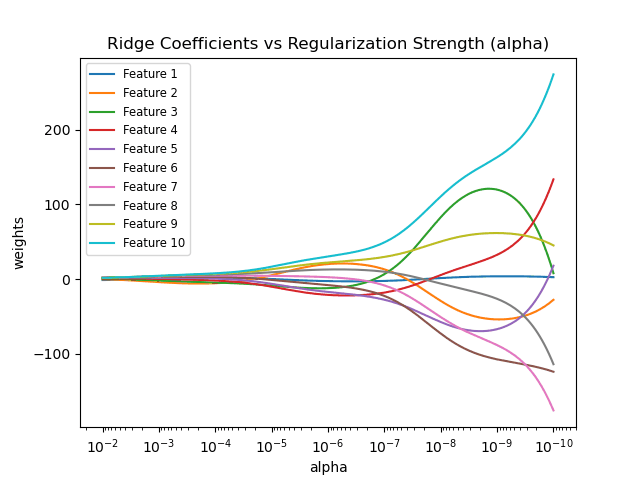
Джерело: scikit-learn · Plot Ridge coefficients as a function of the regularization
Ridge у коді: закрита форма й бібліотека
Двадцять рядків, щоб побачити: усередині ridge немає нічого, крім формули з попереднього розділу.
Вивід код запущено, вивід не редагувався
text
numpy   [ 0.6246  0.1119 -0.1033  0.1066  0.029  -0.208  -0.5347 -0.5324]
sklearn [ 0.6246  0.1119 -0.1033  0.1066  0.029  -0.208  -0.5347 -0.5324]
максимальна розбіжність: 8.0e-15
На що дивитися: ваги numpy і scikit-learn збігаються до 8·10⁻¹⁵, тобто до машинної точності.
np.linalg.solve розв'язує систему, а не обертає матрицю: обернення дорожче й чисельно гірше. Розбіжність із бібліотечною реалізацією лежить на рівні машинної точності.
Числовий приклад: як λ стискає одну вагу
Візьмімо одну стандартизовану ознаку — медіанний дохід — і ті самі 500 районів. Для однієї ваги обидві задачі мають розв'язок у явному вигляді. Тут для наочності взято суму квадратів без множника
На цих даних
| λ | 0 | 50 | 200 | 500 | 1000 | 2000 |
|---|---|---|---|---|---|---|
| ridge | 0,609 | 0,554 | 0,435 | 0,305 | 0,203 | 0,122 |
| lasso | 0,609 | 0,509 | 0,209 | 0 | 0 | 0 |
Ridge ділить вагу на дедалі більше число: вона зменшується, але нулем не стає ніколи. Lasso віднімає від чисельника сталу λ і, щойно λ перевищує 304,5, дає точний нуль. У цьому вся різниця між стисканням і вимиканням ознаки.
Lasso: штраф за суму модулів
Замінімо квадрат норми на суму модулів — отримаємо lasso:
Закритої форми тут немає: модуль не диференційовний у нулі, тому розв'язок шукають координатним спуском або проксимальними методами. Натомість з'являється властивість, якої ridge не має, — розрідженість (sparsity).
"This forces some of the elements of w to be strictly 0 and therefore enforces sparsity in the model (some features will not be used since their coefficients are zero)." — EPFL CS-433, лекція 03d
Розріджений розв'язок є автоматичним відбором ознак: модель сама повідомляє, які ознаки їй не потрібні.
Алгоритми розв'язання: Hastie, Tibshirani, Friedman · The Elements of Statistical Learning, §3.4.4
Геометрія L1 і L2
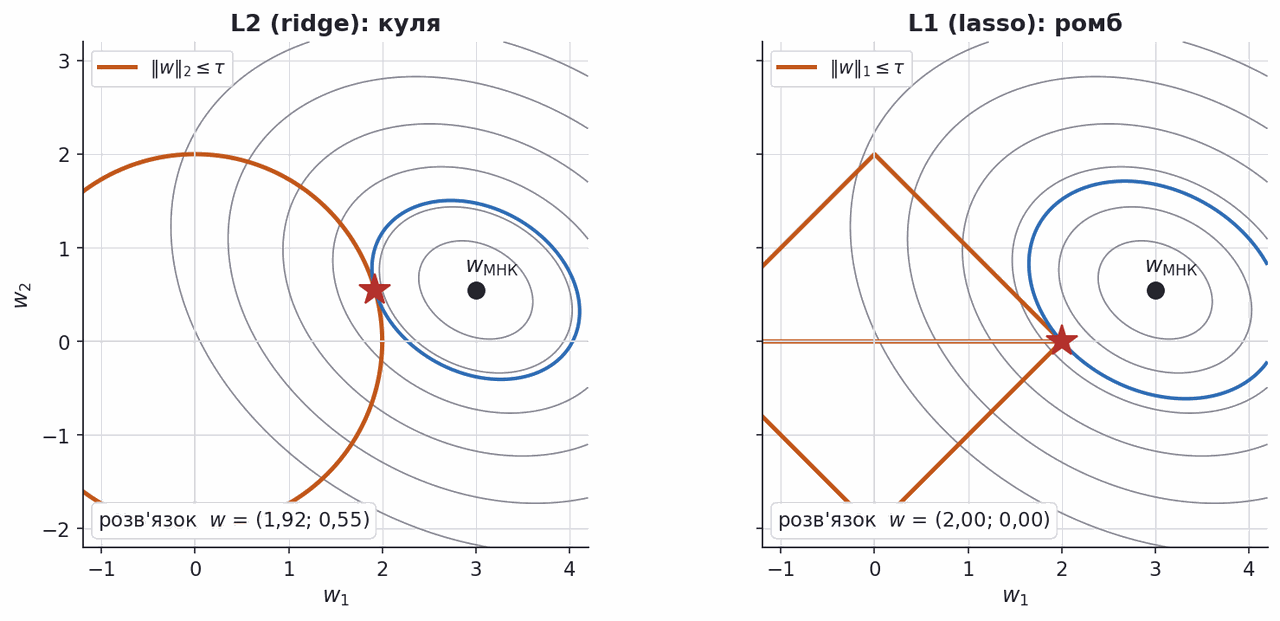
Обидві задачі можна записати з обмеженням замість штрафа: мінімізувати ту саму квадратичну втрату за умови
Лінії рівня квадратичної втрати — еліпси навколо розв'язку МНК. Розв'язок обмеженої задачі лежить там, де найменший еліпс торкається межі області.
Куля гладка, тому дотик відбувається в довільній точці й обидві координати ненульові: тут
У просторі багатьох ознак кутів у ромба експоненційно багато, і кожен відповідає своєму набору занулених координат.
Шлях коефіцієнтів lasso
Той самий графік, що й для ridge, але для L1-штрафа. Відмінність видно одразу: траєкторії не наближаються до нуля асимптотично, а досягають його і залишаються там.
Читати шлях зручно справа наліво. При великому λ усі ваги нульові; з послабленням регуляризації ознаки вмикаються по черзі, і першими — найкорисніші. Це готовий порядок важливості ознак, отриманий без окремої процедури відбору.
Штрихові лінії — розв'язок алгоритмом LARS, який будує той самий шлях точно, а не за сіткою значень λ.
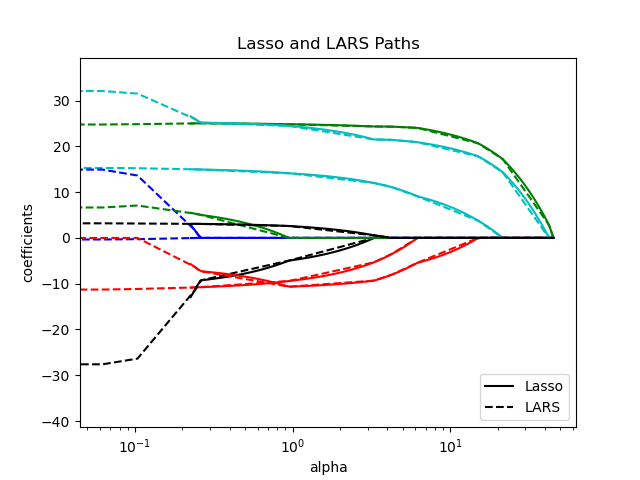
Джерело: scikit-learn · Lasso, Lasso-LARS, and Elastic Net paths
Ridge і lasso на ознаках California Housing
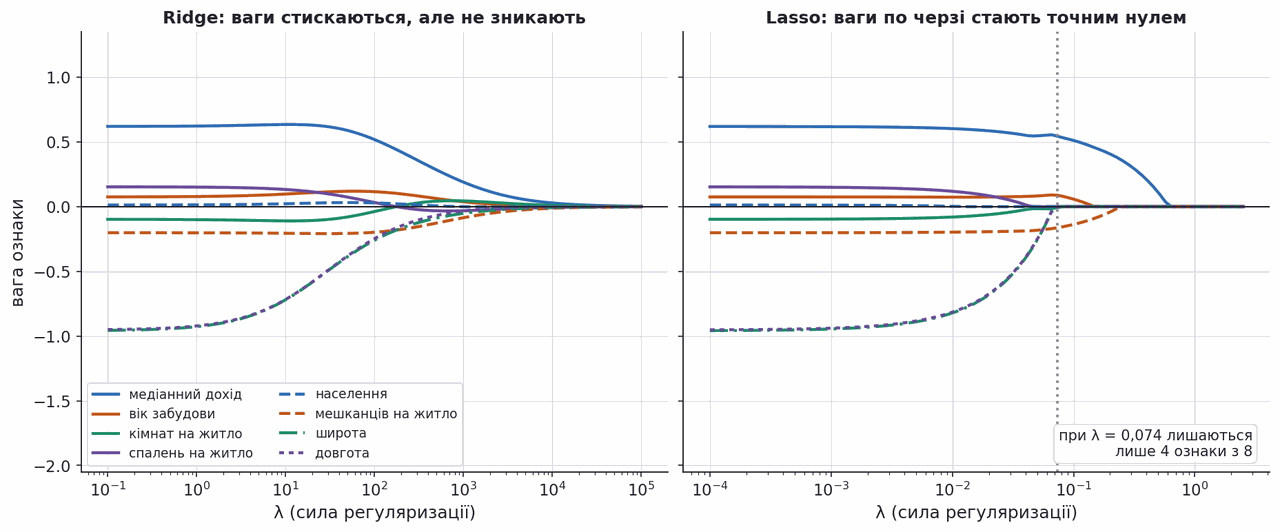
Порівняймо обидва штрафи на тих самих даних: 500 районів, вісім вихідних ознак, усі стандартизовані.
Ліворуч ridge: усі вісім траєкторій плавно сходяться до нуля, але жодна його не досягає навіть при λ = 100 000. Праворуч lasso: ознаки вимикаються по черзі. Першим зникає населення району, далі спальні на житло, потім широта й довгота. При λ = 0,074 в моделі лишаються чотири ознаки з восьми — медіанний дохід, вік забудови, кімнати на житло і мешканці на житло.
Діапазони λ на панелях різні, бо в scikit-learn Ridge штрафує без ділення на Lasso — з ним; порівнювати варто форму траєкторій, а не самі числа.
Зверніть увагу на широту й довготу: їхні ваги майже однакові за модулем і йдуть поруч на обох панелях. Це слід географії, який модель не може розділити на два окремі впливи.
Що робить λ з вагами
Ті самі дані, що на рисунку: 500 районів California Housing, вісім стандартизованих ознак. Посуньте λ — і побачите різницю між двома штрафами на тих самих вагах.
8 / 8ознак лишилося в моделі
0,594RMSE на навчальних
0,600RMSE на 5000 відкладених
Ridge стискає всі вісім ваг плавно, але жодна не стає нулем навіть при λ = 100 000 — ознак завжди лишається вісім. Lasso вимикає їх по черзі: спочатку населення району, далі спальні на житло, потім широта й довгота. При λ ≈ 0,074 в моделі лишаються рівно чотири ознаки. Зверніть увагу на широту й довготу: їхні ваги майже однакові за модулем і зникають поруч — це слід географії, який модель не може розділити на два окремі впливи. Діапазони λ на двох штрафах різні, бо Ridge у scikit-learn штрафує без ділення на N, а Lasso — з ним.
L2 проти L1: практичне порівняння
Обидва штрафи стримують складність, але поводяться по-різному, і вибір між ними змістовний, а не технічний.
| Властивість | L2 (ridge) | L1 (lasso) |
|---|---|---|
| Розрідженість розв'язку | немає, ваги лише стискаються | є, частина ваг точно нульова |
| Єдиність розв'язку | завжди єдиний | може бути не єдиний |
| Закрита форма | є | немає, потрібен ітеративний розв'язувач |
| Дубльовані ознаки | ділить вагу між ними порівну | схильний лишити одну, решту занулити |
| Стійкість до нерелевантних ознак | помірна | висока |
Останній рядок таблиці варто читати обережно: при точному дублюванні ознак розв'язок lasso не єдиний, і сумарну вагу можна розподілити між дублікатами по-різному. Гарантії, що вціліє рівно одна ознака, немає — саме тому в парі корельованих ознак lasso обирає «навмання».
Практичне правило: якщо ознак небагато й усі осмислені — ridge; якщо ознак сотні й більшість, найімовірніше, зайві — lasso або їхня суміш, elastic net, яка додає обидва штрафи одночасно.
Джерело порівняння: UBC CPSC 340, лекція 17
Тренувальна і валідаційна якість залежно від λ
Крива за λ дзеркальна до кривої за степенем полінома: складність спадає зліва направо, на вертикальній осі — коефіцієнт детермінації
При малому λ модель не регуляризована: на навчальних даних
Саме 0,83 завищене — за механізмом розділу 15: його здобуто на тій вибірці, якою обирали λ. Підсумок міряють на третій, не використаній досі частині.
Затінена смуга — розкид по блоках: поблизу оптимуму він широкий, тож «точне» найкраще λ великою мірою випадкове. З двох близьких значень беріть більше: простіша модель.
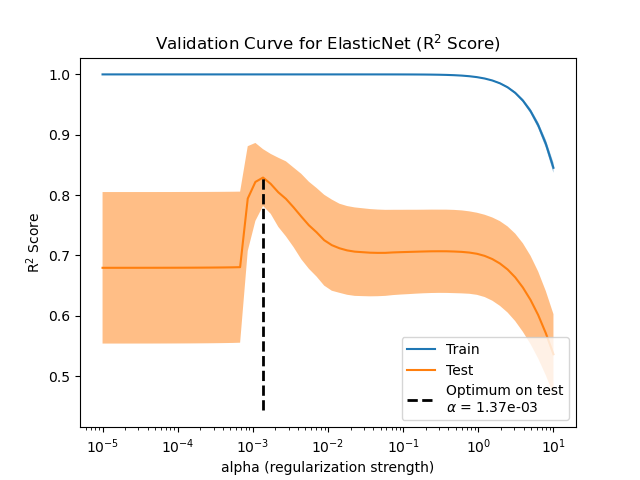
Джерело: scikit-learn · Effect of model regularization on training and test error
Регуляризація рятує модель на California Housing
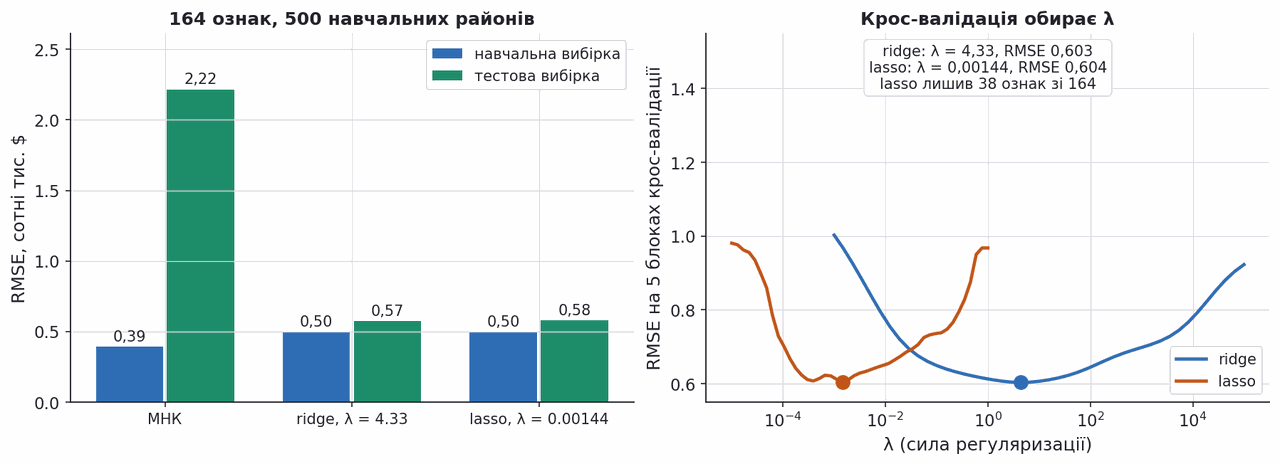
Повернімося до задачі, у якій крос-валідація забракувала третій степінь. На 500 навчальних районах поліном третього степеня дає 164 ознаки — параметрів утричі менше, ніж спостережень, і цього вже досить, щоб МНК розсипався.
Вивід код запущено, вивід не редагувався
text
МНК   λ = 0         CV 1.477  train 0.393  test 2.216  ненульових ваг 164
ridge λ = 4.3288    CV 0.603  train 0.499  test 0.574  ненульових ваг 164
lasso λ = 0.0014424 CV 0.604  train 0.497  test 0.578  ненульових ваг 38
На що дивитися: МНК має найменшу помилку на навчанні (0,393) і найбільшу на тесті (2,216); ridge і lasso тримають тест близько 0,57, а lasso лишає лише 38 ненульових ваг зі 164.
МНК гірший за прогноз «завжди середня ціна», у якого RMSE 0,982. Ridge погіршив навчальну помилку на чверть і зменшив тестову вчетверо; lasso досяг того самого, лишивши 38 ознак зі 164.
Один практичний нюанс: на найменших значеннях ConvergenceWarning. На вибір
Стандартизація перед регуляризацією
Штраф
Наочно на наших даних. Без стандартизації ridge при λ = 10 дає вагу 0,356 для доходу і 0,399 для кількості спалень — виходить, що спальні важливіші за дохід. Після стандартизації ті самі ваги дорівнюють 0,635 і 0,133, а вага населення зростає з 0,0000 до 0,023.
Середнє й стандартне відхилення обчислюють лише на навчальній частині і тим самим перетворенням застосовують до валідаційної й тестової. Усередині крос-валідації це має відбуватися в кожному блоці окремо — саме тому препроцесинг загортають у Pipeline.
Витік даних робить оцінку безглуздою
Витік даних (data leakage) — це будь-яке потрапляння інформації з перевірочної частини в процес навчання. Найпоширеніша форма — препроцесинг або відбір ознак, виконані до поділу на блоки.
Вивід код запущено, вивід не редагувався
text
витік: 0.744
чесно: 1.277
На що дивитися: з витоком RMSE 0,744 — нібито закономірність у чистому шумі; чесний відбір усередині конвеєра дає 1,277, гірше за тривіальний прогноз, як і має бути.
Відбір ознак на всьому масиві дає RMSE 0,744 — краще за стандартне відхилення цілі 1,061, тобто модель нібито знайшла закономірність у чистому шумі. Відбір усередині конвеєра дає 1,277, трохи гірше за тривіальний прогноз, як і має бути.
Джерело: Hastie, Tibshirani, Friedman · The Elements of Statistical Learning, §7.10.2
Ridge як апріорне знання про ваги
Регуляризацію можна прочитати ймовірнісно. Якщо припустити, що шум гаусів, а ваги апріорі розподілені як
Іншими словами, L2-штраф — це закодоване переконання «великі ваги малоймовірні». L1-штраф так само відповідає апріорному розподілу Лапласа, у якого гостріший пік у нулі.
"Regularization … can be understood as a compressed form of data; in this sense, using regularization is equivalent to adding data which helps reduce overfitting." — EPFL CS-433, лекція 03d
Звідки взагалі беруться функції втрат і чому квадратична відповідає саме гаусовому шуму — тема наступної лекції про максимальну правдоподібність.
Байєсів погляд на обидва штрафи: The Elements of Statistical Learning, §3.4.3
Обмеження регуляризації
Регуляризація не створює інформації. Вона лише перерозподіляє: додає зміщення, щоб зменшити дисперсію. Якщо дисперсія й так мала, виграшу не буде. На повних 16 512 навчальних районах California Housing із вісьмома ознаками крос-валідація обирає λ = 19,3, що стискає ваги менш ніж на відсоток, і на тесті ridge не виграє нічого: 0,7275 проти 0,7273 у звичайного МНК.
Значення λ не універсальне. Підібране на одному наборі даних, воно не переноситься на інший: залежить і від масштабу ознак, і від кількості спостережень, і від конвенції реалізації.
Розрідженість lasso нестабільна. Серед сильно корельованих ознак lasso обирає одну майже випадково, і на іншій вибірці вибір може бути іншим. Тому перелік ненульових ознак не можна читати як висновок про причинність.
Штраф не рятує від хибної постановки. Якщо ознаки не містять потрібної інформації або в даних є витік, жодне λ цього не виправить.
Підсумок лекції
Нульова помилка на навчальних даних нічого не означає. Модель, яка проходить через кожну точку, підганяється під шум; єдина чесна оцінка — на даних, яких вона не бачила.
Складність треба вимірювати, а не вгадувати. Поділ на навчальну, валідаційну й тестову частини та крос-валідація дають оцінку помилки узагальнення разом із її розкидом.
Помилка розкладається на три доданки. Шум задає нижню межу, зміщення спадає зі складністю, дисперсія зростає, а мінімум суми лежить посередині.
Регуляризація керує складністю неперервно. Ridge стискає ваги і лікує погану обумовленість, lasso занулює частину з них і відбирає ознаки. Гіперпараметр λ підбирають крос-валідацією, ознаки перед цим стандартизують, а весь препроцесинг тримають усередині конвеєра.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекції 03b, 03d, 04a, 04b
- UBC CPSC 340 — лекції 16–17 про L2 і L1
- Stanford CS229 — розділи 8 і 9
Підручники
- Hastie, Tibshirani, Friedman. The Elements of Statistical Learning — §3.4, §7.2, §7.10
- Bishop. Pattern Recognition and Machine Learning — §1.1 і §3.2
Документація