Тема
Лекція 13 · Сучасне навчання подань
Досі ознаки для моделі готувала людина. Сьогодні розберемо, як модель будує їх сама з нерозмічених даних — і чому саме це вміння стоїть за словниковими векторами, BERT, SimCLR і CLIP.
Зміст лекції
Лекція йде від простого питання «як перетворити слово чи картинку на числа» до сучасних моделей, які вчаться на даних без жодної мітки.
- Подання як окрема задача. Чому ознаки вигідніше вивчати, ніж конструювати, і чим це відрізняється від усього попереднього курсу.
- Вектори слів. Матриця співвживань, матричний розклад, GloVe, word2vec і геометрія простору значень.
- Контекстні подання. Одне слово має кілька значень; ELMo, GPT і BERT як три відповіді на цю проблему.
- Самонавчання. Допоміжна задача, яка перетворює нерозмічені дані на навчальний сигнал.
- Контрастивне навчання. SimCLR: притягнути два види одного об'єкта, відштовхнути чужі.
- Мультимодальність і базові моделі. CLIP і те, чому одну модель тепер навчають раз, а використовують усюди.
Кожен наступний блок знімає обмеження попереднього: матричний розклад дає один вектор на слово, контекстні моделі це виправляють; текстові моделі працюють лише з текстом, контрастивне навчання переносить ту саму ідею на зображення.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чим подання (representation) відрізняється від сирої ознаки і чому якість подання визначає якість усієї моделі;
- побудувати матрицю співвживань за корпусом тексту й дістати з неї вектори слів матричним розкладом;
- розрізнити CBOW і skip-gram та пояснити роль негативного семплування;
- прочитати геометрію простору слів: косинусну подібність, аналогії та їхні межі;
- пояснити, навіщо потрібні контекстні подання і чим маскована мовна модель відрізняється від передбачення наступного токена;
- сформулювати допоміжну задачу (pretext task) для нерозмічених даних і пояснити, чому спільні подання схильні до колапсу;
- записати контрастивну втрату SimCLR і назвати роль температури, проєктора та аугментацій;
- виміряти якість подання лінійним зондуванням і показати, скільки міток воно економить.
Задача: ознаки, які модель будує сама
Дванадцять попередніх лекцій мали спільну мовчазну передумову: матриця ознак
Навчання подань (representation learning) прибирає людину з цього кроку. Замість того щоб конструювати ознаки вручну, ми вчимо відображення
"Constructing good feature representations (= representation learning) benefits all ML applications." — EPFL CS-433, лекція «Text Representation Learning»
Ключова обставина: подання можна вчити без міток. Розмічених даних завжди мало, нерозмічених — практично необмежено, і саме цю асиметрію використовує вся сучасна практика.
Джерело: EPFL CS-433 Machine Learning
Дані лекції: рукописні цифри 8×8
Щоб не говорити про подання абстрактно, весь практичний бік лекції побудовано на одному наборі даних.
Optical Recognition of Handwritten Digits. 1797 зображень розміром 8×8 пікселів, кожен піксель — ціле число від 0 до 16. Класів десять, за цифрами від 0 до 9. Ділимо на 1257 зображень для навчання і 540 для перевірки.
Праворуч видно, чим для алгоритму є картинка: вектором із 64 чисел без жодного уявлення про те, що сусідні пікселі пов'язані. Далі ми навчимо модель дістати з цих 64 чисел компактне подання — і зробимо це, жодного разу не показавши їй мітку класу.
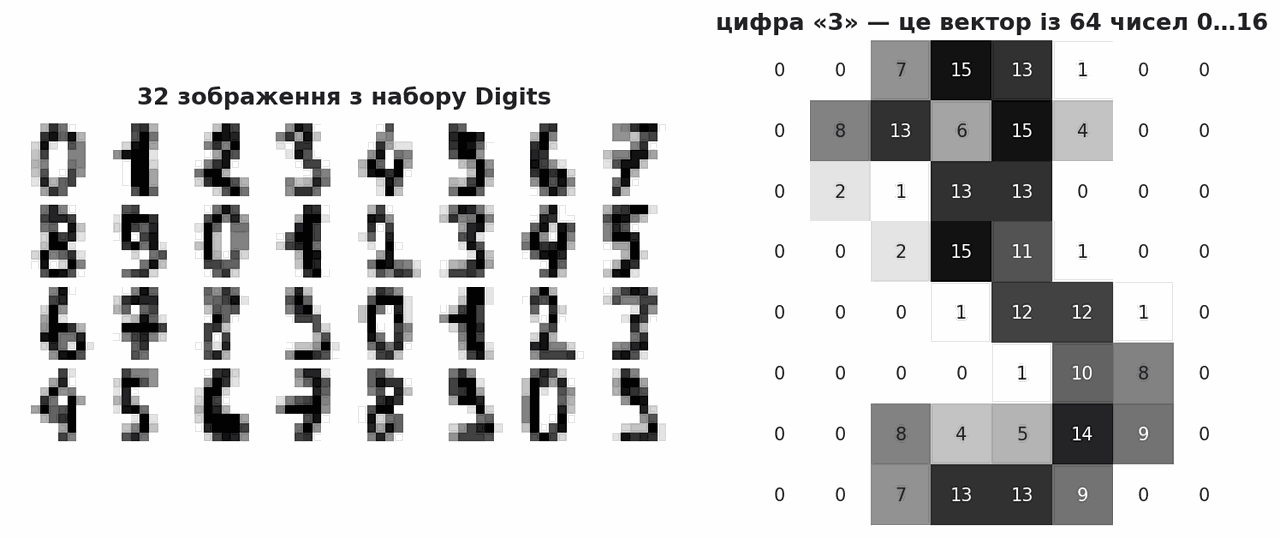
Джерело даних: UCI · Optical Recognition of Handwritten Digits
Мітки коштують дорого, дані — ні
Причина, чому навчання подань взагалі виникло, суто економічна. Розмітити мільйон зображень або сто тисяч медичних знімків — це праця людей-експертів; зібрати мільярд нерозмічених текстів чи фотографій коштує майже нічого.
На рисунку — класифікація текстів із набору 20 newsgroups. Модель, навчена на всіх мітках, дає micro-F1 0,90. Та сама модель на 20 % міток падає до 0,77. Але якщо до тих самих 20 % міток додати решту документів без міток і застосувати самонавчання, результат піднімається до 0,83 — половина втраченого повертається безкоштовно.
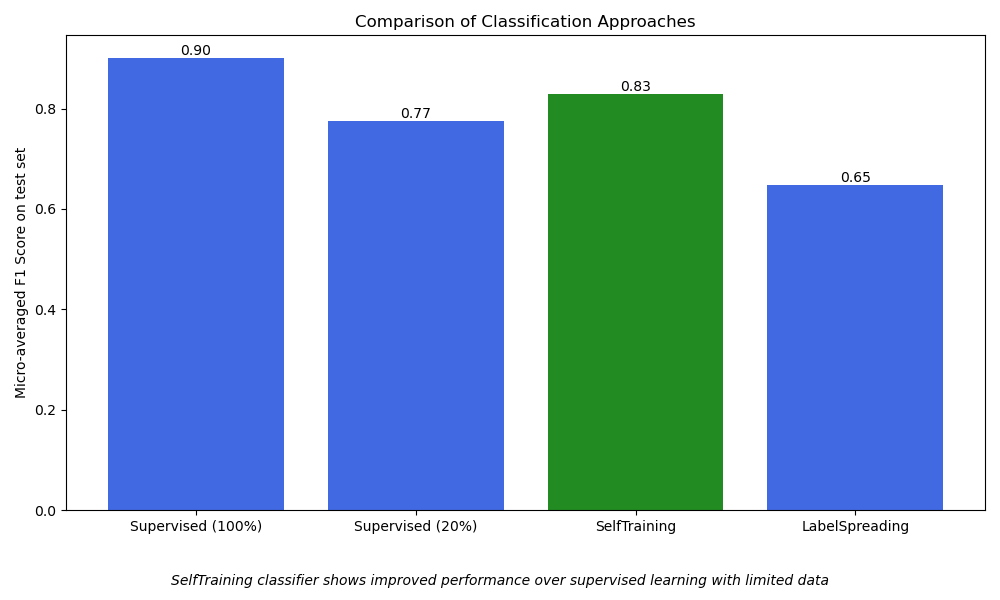
Саме цей розрив і закриває решта лекції, тільки значно потужнішими засобами.
Джерело: scikit-learn · Semi-supervised classification on a text dataset
Слово як номер у словнику
Почнімо з тексту, бо там задача подання видно найгостріше. Найпростіший спосіб перетворити слово на числа — пронумерувати словник і подати слово вектором із однією одиницею.
Такий вектор називають унітарним кодуванням (one-hot encoding). Для словника з
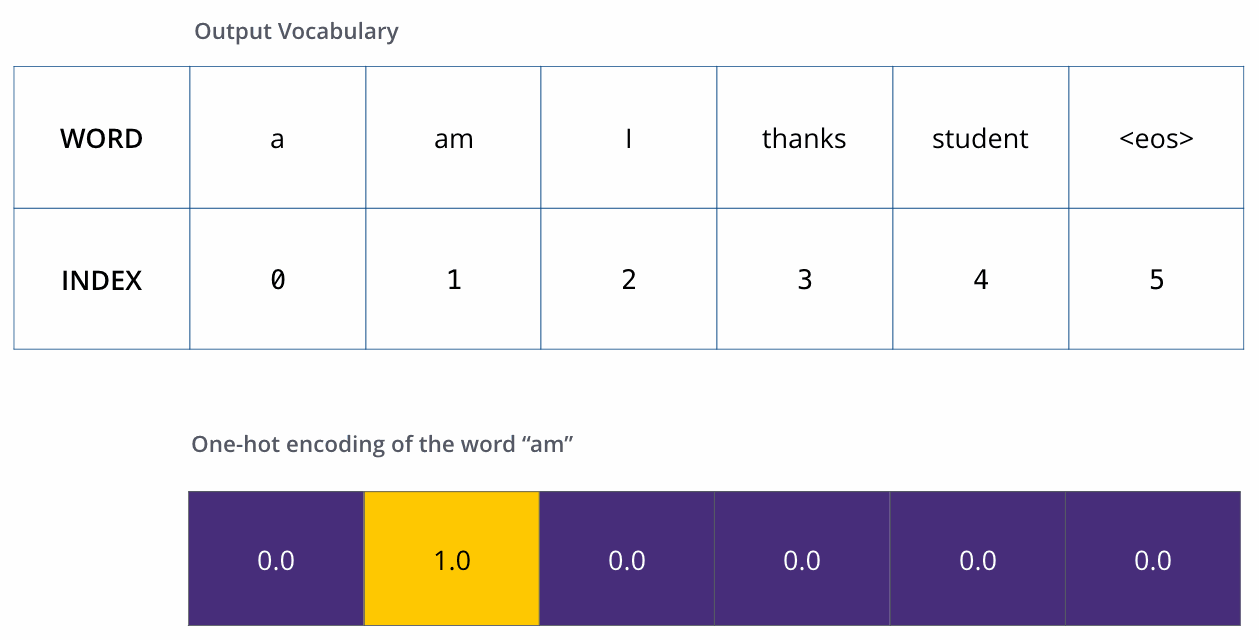
Проблема видна одразу. По-перше, розмір: реальний словник має сотні тисяч слів, тож вектор виходить велетенський і майже повністю нульовий. По-друге і головне — геометрія порожня: скалярний добуток будь-яких двох різних слів дорівнює нулю, тому «кіт» так само далекий від «кота» і від «інтегралу». Словник знає, як слово пишеться, але нічого не знає про те, що воно означає.
Джерело: The Illustrated Transformer
Щільний вектор замість розрідженого
Альтернатива — вкладення (embedding): відображення слова в щільний вектор невеликої розмірності
Тепер кожна координата не «одне слово», а якась узагальнена характеристика значення, і слова з подібним змістом отримують подібні вектори. Простір перестає бути порожнім: у ньому з'являються відстані, напрямки й околиці.
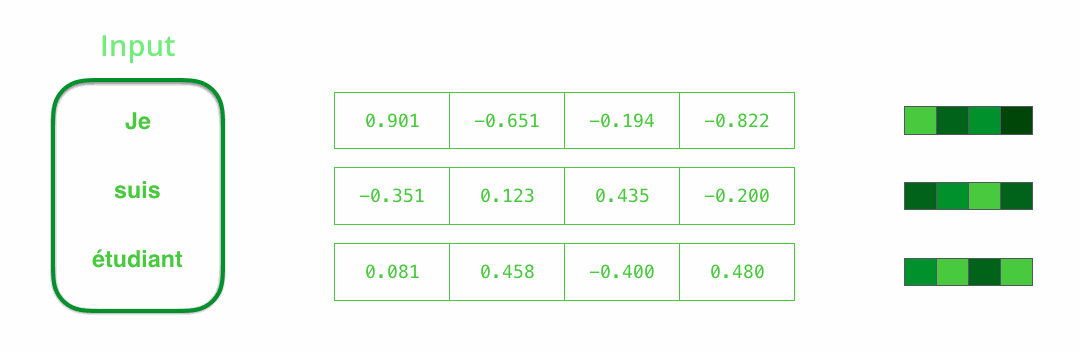
Лишається головне питання лекції: звідки взяти ці числа. Ніхто не задає їх вручну — їх треба вивчити з даних, і навчальним сигналом стане сам текст.
Джерело: Visualizing Neural Machine Translation
Матриця співвживань: сигнал із нерозміченого тексту
Джерело сигналу сформулював ще Дж. Ферт: слово характеризується компанією, у якій воно з'являється. Формалізуємо це лічильником
Контекст треба означити явно: документ, абзац, речення або вікно з кількох слів. Ми беремо вікно завширшки п'ять слів.
Ліворуч — фрагмент реальної матриці, побудованої за 6000 повідомлень корпусу 20 newsgroups для словника з 400 найчастіших слів. Блокова структура видно неозброєним оком: god, jesus, church, bible тримаються разом, windows, software, computer, file — окремо. Жодних міток для цього не знадобилося, лише текст.
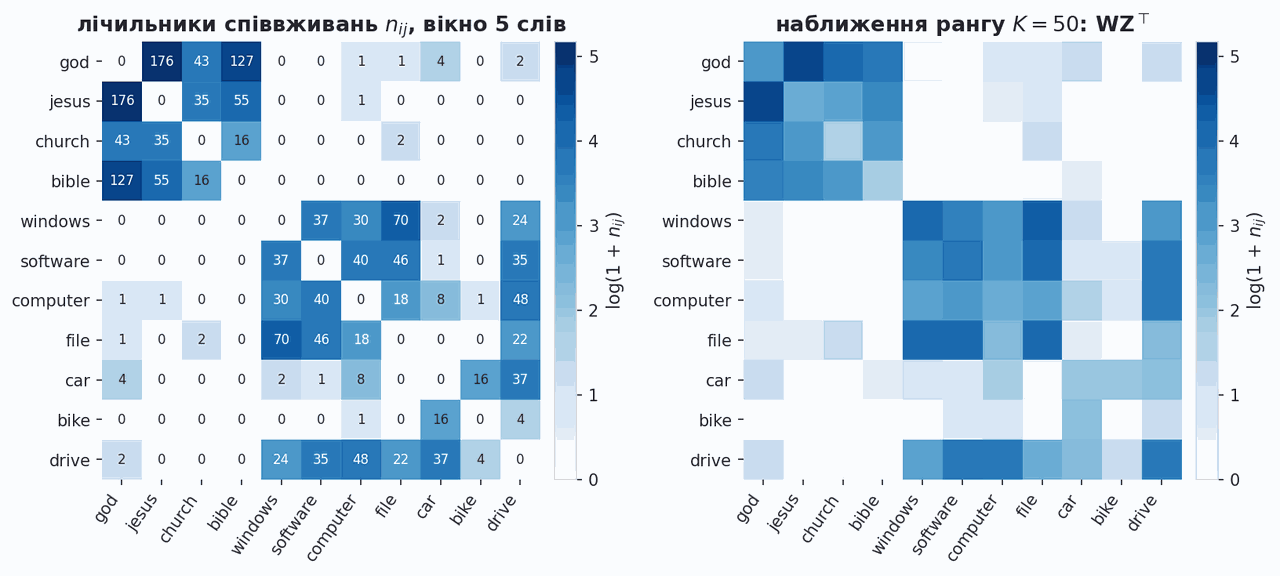
Праворуч — те, що дає наближення рангу 50, до якого ми зараз перейдемо.
Подання слів як матричний розклад
Матриця
| Позначення | Значення |
|---|---|
| логарифм лічильника; логарифм гасить розрив між дуже частими й рідкісними парами | |
| подання слів, рядок | |
| подання контекстних слів | |
| розмірність подання, зазвичай 50–500 | |
| множина пар із ненульовим лічильником | |
| вага важливості пари |
Це буквально та сама задача, що й розклад матриці «користувач × фільм». Різниця лише в тому, що замість оцінок глядачів у клітинках стоять лічильники сумісних появ слів.
GloVe: як зважити пари слів
Якби всі пари важили однаково, найчастіші сполучення на кшталт «of the» задавили б собою решту. Модель GloVe (Global Vectors) розв'язує це ваговою функцією, що зростає до певної межі й далі не росте:
Рідкісні пари отримують малу вагу, бо їхні лічильники ненадійні; наддомінантні пари обрізаються одиницею і не можуть перекричати всіх інших. Значення
Числовий приклад. Нехай
Джерело: Pennington, Socher, Manning. GloVe (EMNLP 2014)
Код: від корпусу до векторів слів
Уся конструкція вміщується в двадцять рядків: зібрати лічильники, взяти логарифм, зробити усічений сингулярний розклад.
Вивід код запущено, вивід не редагувався
text
матриця (400, 400) · ненульових 88.6%
подання (400, 50) · пояснена дисперсія 0.749
На що дивитися: матриця 400 × 400 заповнена на 88,6 %, а 50 чисел на слово зберігають 74,9 % її дисперсії.
CBOW: передбачити слово за оточенням
Матричний розклад — не єдиний шлях до тих самих векторів. Модель word2vec приходить до них через задачу передбачення, і історично саме вона зробила вектори слів масовим інструментом.
Перший варіант — CBOW (continuous bag of words). Беремо вікно тексту, ховаємо центральне слово і вимагаємо від моделі відновити його за сусідами. На рисунку: за словами the, man, his, son треба назвати loves.
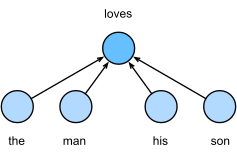
Вектори сусідів усереднюються в один вектор контексту, і вже за ним модель обирає центральне слово. Мітки для такого навчання не потрібні — їх постачає сам текст, просто прибиранням одного слова.
Джерело: Dive into Deep Learning · Word2vec
Skip-gram: передбачити оточення за словом
Другий варіант — skip-gram — розвертає задачу. Тепер вхід один, центральне слово, а передбачити треба кожне слово з вікна навколо нього.
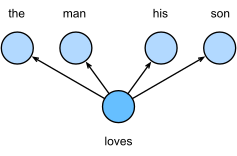
На перший погляд це складніше, але саме skip-gram виявився кращим на рідкісних словах: кожна поява рідкісного слова породжує стільки навчальних пар, скільки слів у вікні, тоді як у CBOW вона розчиняється в усередненні. Розмір вікна в оригінальній роботі — п'ять слів у кожен бік.
Обидві моделі, попри різні формулювання, дають вектори з тими самими властивостями, що й матричний розклад. Це не збіг: обидві оптимізують по суті ту саму інформацію про спільні появи слів.
Джерело: Mikolov et al. Efficient Estimation of Word Representations (2013)
Негативне семплування замість softmax по словнику
У прямій постановці skip-gram знаменник softmax пробігає весь словник — сотні тисяч доданків на кожен крок. Це надто дорого.
Виправлення просте й важливе для решти лекції: замінити багатокласову задачу бінарною. Модель має лише відрізнити справжню пару «слово — сусід» від підробленої, у якій другим елементом стоїть випадкове слово з корпусу.
Це знову логістична регресія з лекції 05, тільки ознаками є скалярний добуток двох векторів, які й навчаються. Прийом називають негативним семплуванням (negative sampling); на кожну справжню пару беруть кілька випадкових підроблених.
Запам'ятайте цю схему — «притягнути справжню пару, відштовхнути випадкову». Через двадцять хвилин вона повернеться під назвою контрастивного навчання, тільки замість слів у ній будуть зображення.
Джерело: Mikolov et al. Distributed Representations of Words and Phrases (NIPS 2013)
Геометрія простору слів: близькість означає схожість
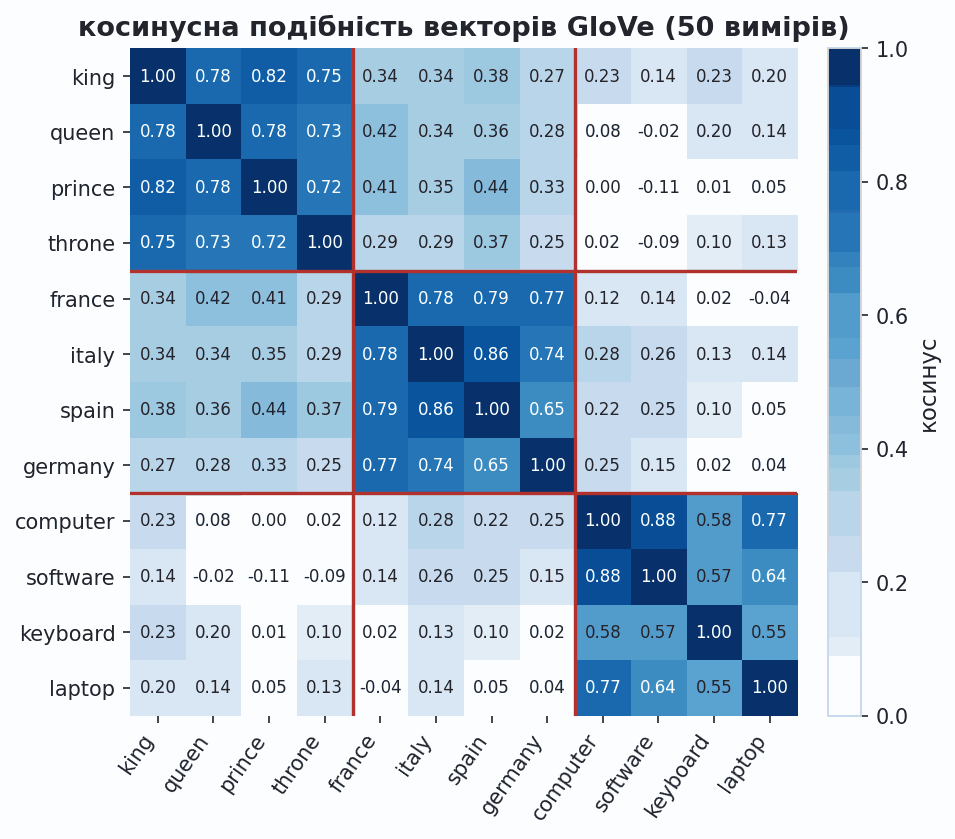
Подивімося, що насправді виходить. Візьмемо готові вектори GloVe, навчені на Вікіпедії та корпусі Gigaword: 400 000 слів по 50 чисел на кожне.
Матриця показує косинусну подібність дванадцяти слів із трьох різних тем. Усередині кожної теми значення високі (italy і spain — 0,86, computer і software — 0,88), між темами падають майже до нуля або нижче (software і prince — мінус 0,11). Червоні лінії розділяють теми; блокова структура виникла сама, ніхто не повідомляв моделі, які слова до якої теми належать.
Джерело векторів: GloVe · Stanford NLP
Семантичний пошук: коли запит не збігається словами
Близькість векторів — не самоціль: її головне застосування це пошук. Класичний пошук шукає збіг рядків, тож запит іншими словами він не знаходить; пошук за вкладеннями порівнює зміст. Перевірмо на 600 документах 20 Newsgroups: запит перетворюємо на вектор тією самою моделлю, що й документи, і беремо п'ять найближчих за косинусом.
Вивід код запущено, вивід не редагувався
text
документів 600, вектор — 768 чисел, довжина 1.000На що дивитися: кожен документ став вектором із 768 чисел одиничної довжини, тож скалярний добуток двох таких векторів — це вже косинусна подібність.
Вивід код запущено, вивід не редагувався
text
запит                                          слова вкладення
nasa shuttle launch orbit                        1.0       1.0
spacecraft departing our planet                  1.0       1.0
a machine that leaves the earth and circles it   0.4       0.8
goaltender stopped every shot                    0.6       1.0
picture made by a computer from shapes           0.6       1.0
середнє: ключові слова 0.72, вкладення 0.96
На що дивитися: у стовпцях — частка документів потрібної теми серед п'яти знайдених; коли запит не повторює слів із документів, пошук за словами помиляється, а вкладення тримаються: у середньому 0,72 проти 0,96.
Результат залежить від того, як сформульовано запит. «nasa shuttle launch orbit» — словами самих документів — обидва методи дають влучність@5 рівно 1,0. «goaltender stopped every shot» замість слова «hockey»: ключові слова 0,6, вкладення 1,0. «a machine that leaves the earth and circles it», зовсім без термінів: 0,4 проти 0,8.
Середнє по п'яти запитах: 0,72 за словами проти 0,96 за вкладеннями. Що далі формулювання від лексики документів, то більший розрив. Саме на цьому стоять сучасні пошукові системи й схема RAG, де знайдені за змістом фрагменти підставляють у запит до мовної моделі.
Напрямки в просторі слів кодують відношення
Подібність — лише половина історії. Виявилося, що різниця двох векторів теж має сенс: вона кодує відношення між словами.
Ліворуч шість пар «чоловіче — жіноче» у проєкції на дві головні компоненти. Стрілки майже паралельні: різниця
Звідси — знаменита арифметика: обчислимо queen з косинусом 0,852.
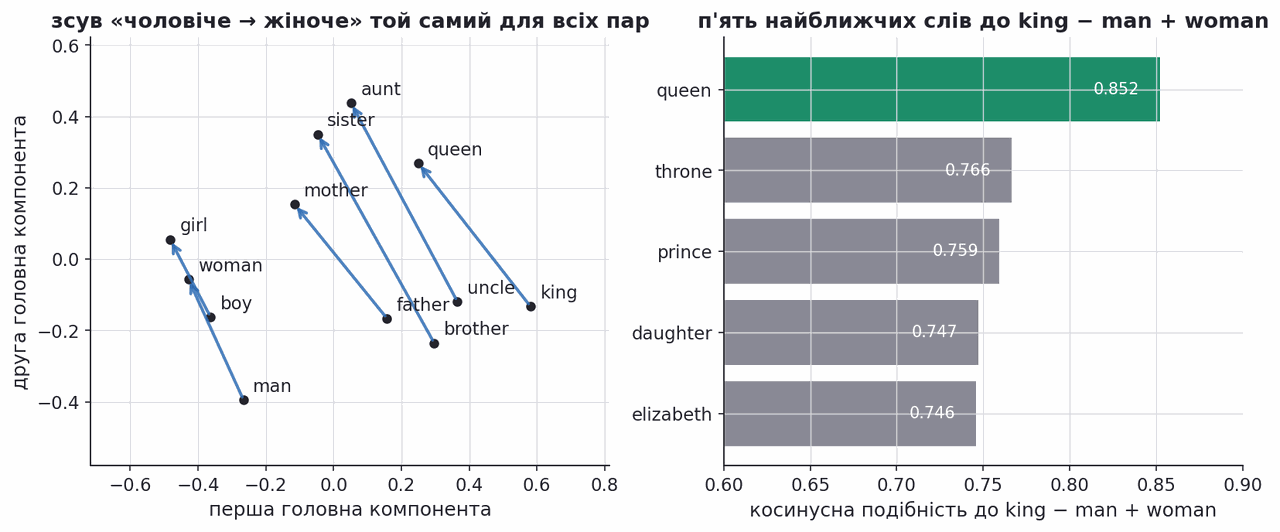
Приклад походить із робіт Mikolov та співавторів; у слайдах EPFL наведено споріднений тест на аналогіях фраз, де найкраща модель дала 72 % правильних відповідей на 3218 прикладах.
Арифметика у просторі слів
Справжні вектори GloVe (50 вимірів), ті самі, що вантажить код лекції. Обчислення просте:
v = вектор(b) − вектор(a) + вектор(c), далі шукаємо найближче слово за косинусом. Словник тут скорочено до 80 слів, щоб усе рахувалося миттєво. :=:queen
queen0,852prince0,759daughter0,747princess0,742son0,7080,852схожість найкращої відповіді
0,531пряма схожість «man» і «king»
50вимірів на слово
Класичний приклад працює: man : king = woman : queen зі схожістю 0,852 — те саме число друкує код лекції. Так само знаходяться столиці й ступені порівняння: напрямок «країна → столиця» у цьому просторі один і той самий для Франції та Італії. Але візьміть останню кнопку — cat : dog = car : ? — і відповідь буде беззмістовною, хоча схожість лишиться високою. Це і є межа методу: модель завжди повертає найближче слово, а чи існує сама аналогія, вона не перевіряє.
Код: аналогії й межі методу
Вивід код запущено, вивід не редагувався
text
man : king = woman : ?
    queen 0.852 · throne 0.766 · prince 0.759
paris : france = rome : ?
    italy 0.861 · spain 0.793 · portugal 0.760
walking : walked = swimming : ?
    athletics 0.725 · olympic 0.680 · championships 0.672
На що дивитися: дві перші аналогії розв'язано правильно (queen, italy), а третя провальна: замість дієслова модель видає спортивні слова, бо swimming у корпусі живе серед спорту.
Третій рядок — чесна межа методу. Граматичну аналогію «йти : йшов = плавати : плавав» п'ятдесятивимірні вектори не тримають: замість дієслова модель видає назви видів спорту, бо в корпусі swimming живе серед спортивних термінів, а не серед дієслів.
Одне слово має кілька значень
У всього побудованого досі є спільна вада: слову відповідає рівно один вектор незалежно від того, де воно стоїть.
Візьмімо українське «коса». У реченні «дівчина заплела косу» це зачіска, у «косою косять траву» — інструмент, у «пароплав обійшов косу» — мілина. Один вектор мусить бути середнім арифметичним трьох різних значень, і жодне з них не подане добре. Англійське bank (берег і банк) або mouse (миша і мишка) — така сама історія.
Потрібні контекстні подання (contextual representations): вектор слова має обчислюватися заново для кожного речення, з урахуванням сусідів. Технічно це означає, що подання видає не таблиця пошуку, а мережа, яка читає все речення — тобто трансформер із лекції 12.
| Речення | Що означає «bank» | Вектор GloVe |
|---|---|---|
| He sat on the river bank. | берег річки | той самий |
| She works at a bank. | фінансова установа | той самий |
| The plane will bank left. | крен літака | той самий |
Один вектор мусить обслуговувати всі три значення, тому опиняється десь між ними — і не описує жодного. Саме цю ваду знімають контекстні подання, до яких переходимо далі.
Три покоління: ELMo, GPT і BERT
Рисунок зіставляє три підходи, які з'явилися один за одним протягом двох років.
ELMo дає контекстні подання, але архітектуру під кожну цільову задачу доводиться будувати окремо. GPT прибирає цю проблему: та сама модель донавчається під нову задачу мінімальними змінами, проте увага в ній однонапрямна — токен бачить лише те, що було до нього. BERT поєднує обидві переваги: мінімальні зміни під задачу плюс двонапрямна увага, коли кожен токен бачить усе речення.
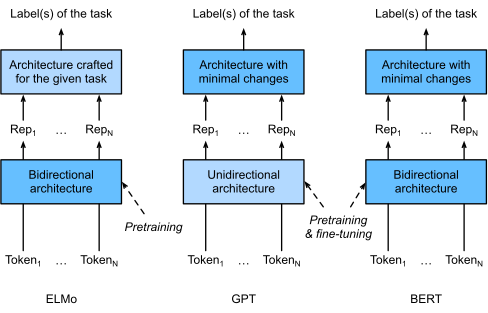
Ця картинка задає й загальну схему роботи, яка тримається донині: спершу попереднє навчання (pretraining) на величезному нерозміченому корпусі, потім донавчання (fine-tuning) на маленькій розміченій вибірці цільової задачі.
Джерело: Dive into Deep Learning · BERT
Вхід BERT: сума трьох вкладень
BERT приймає одну або дві послідовності одразу. Службовий токен [CLS] стоїть на початку і збирає подання всього входу; [SEP] розділяє речення.
Вектор кожної позиції складається з трьох доданків: вкладення самого токена, вкладення сегмента (перше речення чи друге) і позиційного вкладення.
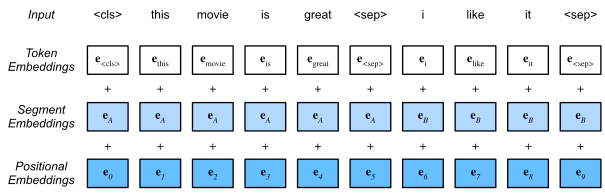
Далі це працює так: для класифікації речення беруть вихід у позиції [CLS], для розмітки іменованих сутностей — виходи окремих токенів, для пошуку відповіді в тексті — межі фрагмента. Одна попередньо навчена модель, різні маленькі голови зверху.
Джерело: Devlin et al. BERT (2018)
Маскована мовна модель як навчальний сигнал
Лишається питання, на чому саме BERT навчається, якщо міток немає. Відповідь — маскована мовна модель (masked language modelling).
Приблизно 15 % токенів у реченні замінюють на [MASK], а модель має відновити, що там було. Приклад зі слайдів EPFL CS-433: She [MASK] her coffee → She drank her coffee.
"Forces the model to learn a comprehensive representation of the language that is very useful for many downstream tasks. Can train on huge corpora of text (books, Wikipedia, etc) without any labelling." — EPFL CS-433, лекція «Self-supervised Learning»
Щоб угадати пропущене слово, модель мусить розібратися і в граматиці, і в сполучуваності, і в тому, що взагалі роблять із кавою. Функція втрат — звичайна перехресна ентропія з лекції 05, тільки класів стільки, скільки токенів у словнику.
Джерело: EPFL CS-433 Machine Learning
Замаскувати слово чи передбачити наступне
BERT і GPT розв'язують ту саму задачу самонавчання двома різними способами, і різниця між ними визначає, для чого кожна модель придатна.
| BERT: маскування | GPT: наступний токен | |
|---|---|---|
| Архітектура | трансформер-енкодер | трансформер-декодер |
| Напрямок уваги | двонапрямна, кожен токен бачить усі | причинна, лише попередні токени |
| Навчальна задача | відновити ~15 % замаскованих токенів | передбачити наступний токен |
| Сильна сторона | подання для класифікації, розмітки, пошуку | генерація тексту довільної довжини |
Причинність — не технічна деталь, а суть відмінності. BERT бачить майбутнє, тому дає кращі подання, але не вміє продовжувати текст: щоб згенерувати наступне слово, його не можна бачити. GPT платить половиною контексту за здатність писати.
Самонавчання: означення й загальна схема
Узагальнимо побачене. Обидві задачі — і маскування, і передбачення наступного токена — влаштовані однаково: сигнал навчання витягується з самого входу.
"Self-supervised learning: use the input itself to generate supervisory signals. The base task is an artificial pretext task that requires learning useful features and structure in the input data." — EPFL CS-433, лекція «Self-supervised Learning»
Формально: беремо нерозмічену точку
де
Для зображень допоміжні задачі бувають різні: передбачити кут повороту картинки, розфарбувати чорно-білу, вгадати взаємне розміщення двох фрагментів, відновити приховану частину.
Допоміжна задача на цифрах: відновити приховане
Перевіримо це на наших даних. Візьмемо 1257 зображень без міток, у кожному випадково приховаємо 35 % пікселів і навчимо автокодувальник відновлювати оригінал.
Мережа стискає 64 пікселі до 16 чисел і розгортає назад. Функція втрат — середньоквадратична похибка між відновленим і вихідним зображенням; за 200 епох вона падає з 0,1713 до 0,0221.
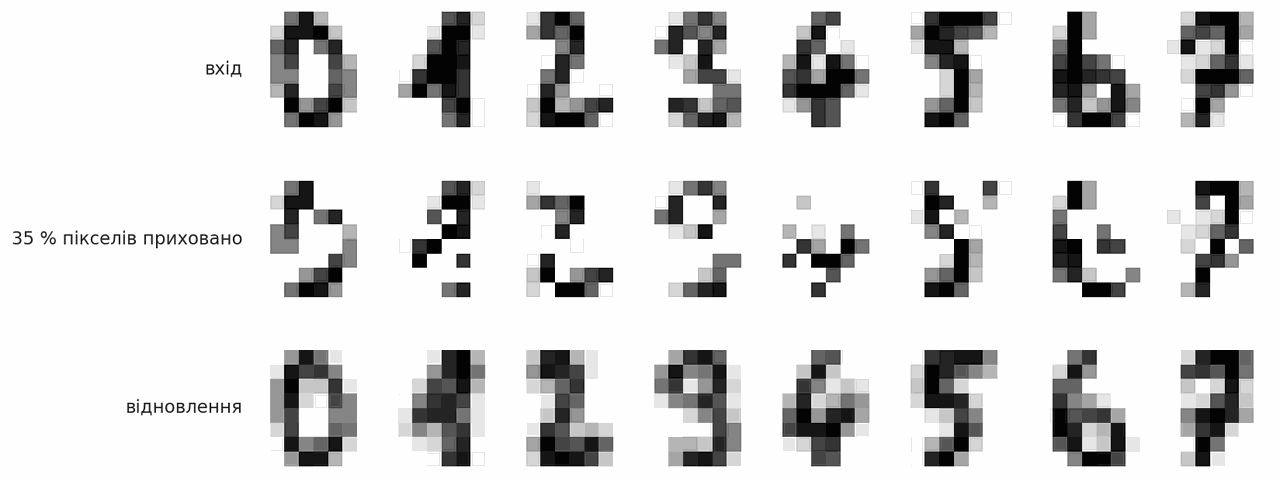
Середній рядок — те, що бачить мережа; нижній — те, що вона повертає. Щоб дописати відсутню третину, мережа мусила вивчити, як узагалі виглядають цифри. Саме ці 16 чисел ми потім і використаємо як подання.
Спільні подання і пастка колапсу
Є й інший спосіб позбутися міток, без відновлення входу. Ідея спільних подань (joint embedding): зробити два випадкові «види» тієї самої точки й вимагати, щоб енкодер видав для них близькі вектори.
Звучить розумно, але має очевидну поломку.
"Problem: constant f is a trivial encoder that is invariant!" — EPFL CS-433, лекція «Self-supervised Learning»
Енкодер, який на будь-який вхід відповідає нулем, задовольняє вимогу ідеально й не містить жодної інформації. Це називають колапсом подань. Отже, самої вимоги близькості замало — потрібна протидійна сила, яка утримує різні об'єкти на відстані.
Джерело: EPFL CS-433 Machine Learning
Контрастивне навчання: притягнути своє, відштовхнути чуже
Протидійна сила знаходиться там само, де ми її вже бачили в word2vec: додати негативні приклади.
Тут
На рисунку — реальні аугментації з нашого набору. Вихідна трійка, два її випадкові види (поворот до 15°, зсув на піксель, зміна яскравості, витирання квадрата 2×2, гаусів шум) і вид зовсім іншої цифри.
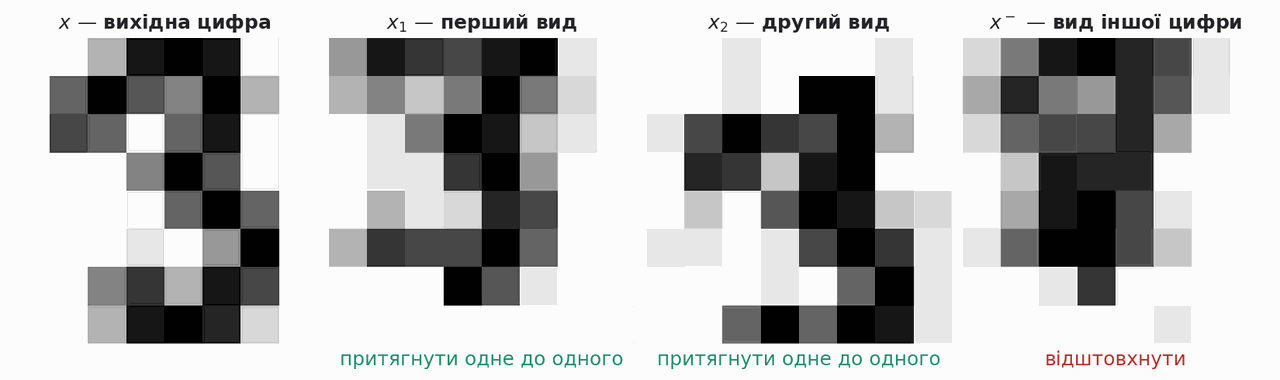
Аугментації тут — не косметика, а формулювання задачі: вони кажуть моделі, які зміни вважати неістотними.
Втрата SimCLR
SimCLR — контрастивна схема з кількома вдалими інженерними рішеннями. Її функція втрат:
| Позначення | Значення |
|---|---|
| другий вид тієї самої точки — єдиний позитив | |
| види решти точок батча як негативи та їхня кількість | |
| косинусна подібність, поділена на температуру | |
| енкодер |
Придивіться до дробу: це softmax, у якому «правильний клас» — це власний позитив серед усіх негативів. Тобто перед нами перехресна ентропія з лекції 05, а контрастивне навчання — задача класифікації, у якій мітки виготовляє сам генератор видів.
Температура
Джерело: Chen et al. SimCLR (ICML 2020)
Код: SimCLR на PyTorch
Вивід код запущено, вивід не редагувався
text
у пікселях два види однієї цифри різняться на 0.238,
дві різні цифри — на 0.264
На що дивитися: у пікселях два види однієї цифри (0,238) майже так само далекі, як дві різні цифри (0,264), — схожості, яку пікселі не бачать, енкодеру доведеться навчитися.
Вивід код запущено, вивід не редагувався
text
до навчання NT-Xent 6.236; навмання — ln(2·256 − 1) = 6.236На що дивитися: до навчання втрата дорівнює ln 511 = 6,236 — рівно стільки дає вгадування позитивної пари навмання серед 511 кандидатів.
Вивід код запущено, вивід не редагувався
text
епоха   0   NT-Xent 6.216
епоха 100   NT-Xent 4.834
епоха 200   NT-Xent 4.749
епоха 299   NT-Xent 4.700
На що дивитися: NT-Xent падає з 6,216 до 4,700 за 300 епох: модель дедалі впевненіше знаходить другий вид тієї самої цифри серед 511 кандидатів.
Навчання займає близько тридцяти секунд на процесорі.
Що вивчив енкодер
Подивімося на результат очима. Обидві панелі — проєкція t-SNE тестових зображень, які модель не бачила; ліворуч проєктуються сирі 64 пікселі, праворуч — 32 числа з навченого енкодера.
Кластери є в обох випадках: цифри 8×8 — легкі дані, і навіть сирі пікселі вже майже розділяються. Але подання групує їх щільніше: силует за справжніми класами зростає з 0,16 до 0,29, тобто відстань усередині класу зменшилася відносно відстані між класами майже вдвічі.
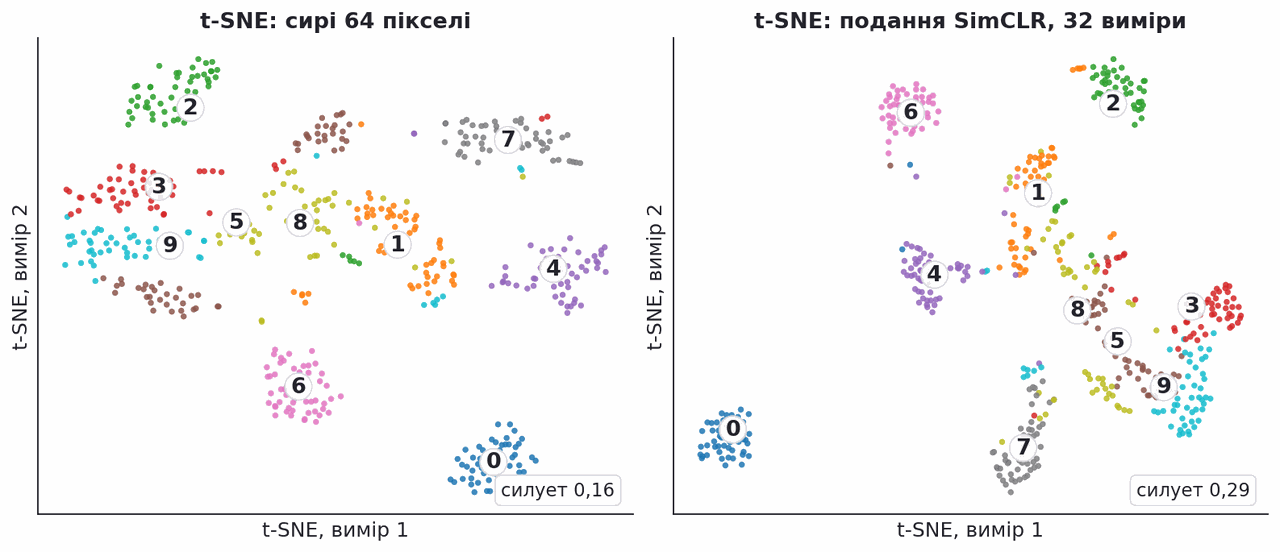
Нагадаємо, що жодної мітки під час навчання енкодера не використано. Структуру класів модель відновила лише з того, що поворот і зсув не змінюють цифру.
Код: лінійне зондування замороженого енкодера
Картинка переконує, але не вимірює. Стандартний спосіб оцінити подання — лінійне зондування (linear probing): заморозити енкодер, поставити зверху звичайну логістичну регресію і навчити її на кількох мітках.
Вивід код запущено, вивід не редагувався
text
міток на клас  1:  сирі пікселі 0.564   SimCLR 0.716
міток на клас  5:  сирі пікселі 0.841   SimCLR 0.853
міток на клас 50:  сирі пікселі 0.956   SimCLR 0.941
На що дивитися: з однією міткою на клас подання SimCLR дає 0,716 проти 0,564 на сирих пікселях, а з 50 мітками перевага зникає — 0,941 проти 0,956.
Кожне число — середнє з десяти випадкових виборів розмічених прикладів.
Чужий енкодер допомагає не завжди
Природна думка після лекції 11: навіщо навчати власний енкодер, якщо є resnet18 з ImageNet? Поставмо його третьою колонкою — заморозимо й проженемо ті самі цифри, домалювавши їх до трьох каналів і 64 пікселів.
| Міток на клас | Сирі пікселі | Власний SimCLR | Заморожений resnet18 |
|---|---|---|---|
| 1 | 0,564 | 0,716 | 0,404 |
| 5 | 0,841 | 0,853 | 0,767 |
| 50 | 0,956 | 0,941 | 0,945 |
Результат протилежний очікуванню: мережа з одинадцяти мільйонів параметрів, навчена на мільйоні фотографій, програє навіть сирим пікселям — 0,404 проти 0,564 на одній мітці.
Причина в тому, що переносити нема чого. ImageNet — це кольорові фотографії з текстурами й тлом; наші цифри — вісім на вісім градацій сірого. Ознаки resnet18 тут просто не спрацьовують, а власний SimCLR, який не бачив жодної мітки, але вчився саме на цих даних, виграє там, де міток мало.
Порівняйте з лекцією 11: там та сама resnet18 на супутникових знімках дала 0,910 проти 0,752 у навчання з нуля. Різниця не в моделі, а у відстані між доменами. Правило: перенесення працює, коли джерело й ціль поділяють низькорівневу структуру, і не працює, коли ні — а перевіряється це лінійним зондуванням за десять хвилин.
Подання економить мітки, а не замінює їх
Розгорнімо ці три рядки в криву. Горизонтальна вісь — скільки розмічених прикладів на клас дозволено використати, вертикальна — частка правильних відповідей на всіх 540 тестових зображеннях.
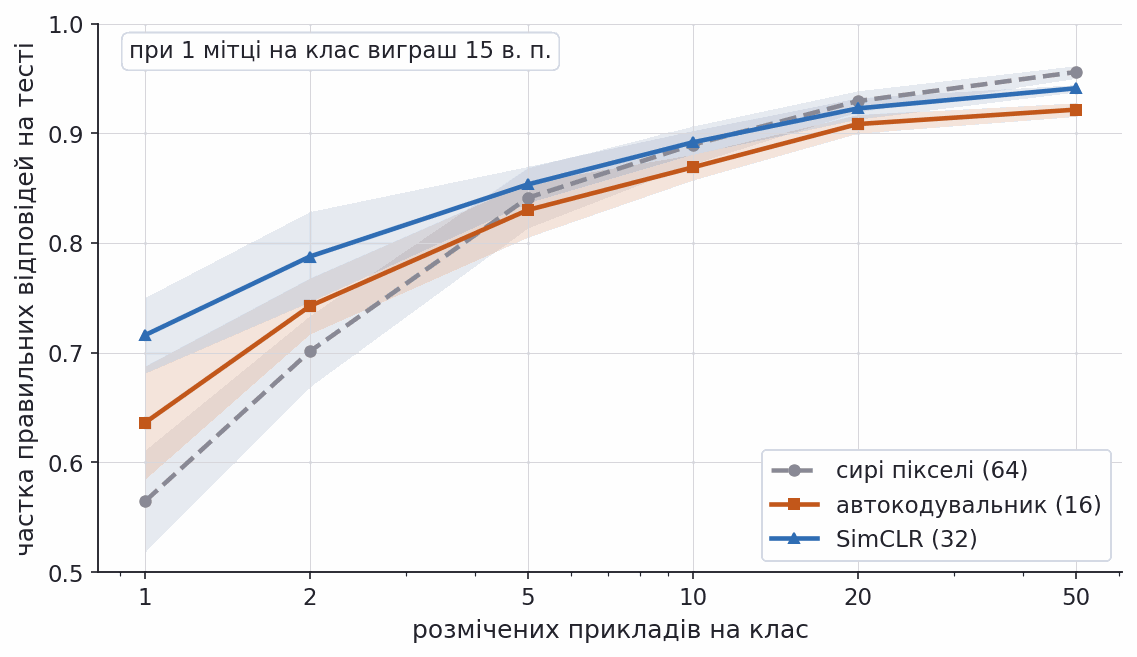
Читати треба так. При одній мітці на клас контрастивне подання дає 71,6 % проти 56,4 % на сирих пікселях — виграш у 15 відсоткових пунктів. При п'яти мітках розрив звужується до 1,2 пункту, а після двадцяти сирі пікселі виходять уперед і при п'ятдесяти мітках виграють 95,6 % проти 94,1 %.
Це не невдача, а точне окреслення користі. Самонавчання коштовне саме там, де міток мало; коли їх достатньо, пряме навчання на сирих даних наздоганяє й переганяє. Автокодувальник, що просто відновлював приховані пікселі, слабший за контрастивний за всіх режимів — вибір допоміжної задачі впливає на результат не менше за архітектуру.
CLIP: текст і зображення в спільному просторі
Досі текст і зображення жили в різних просторах. CLIP з'єднує їх, і механізм — уже знайомий контрастивний.
Навчальні дані — пари «зображення та його підпис», зібрані з інтернету. Два енкодери, один для картинок, другий для тексту, проєктують обидві модальності в один простір розмірності
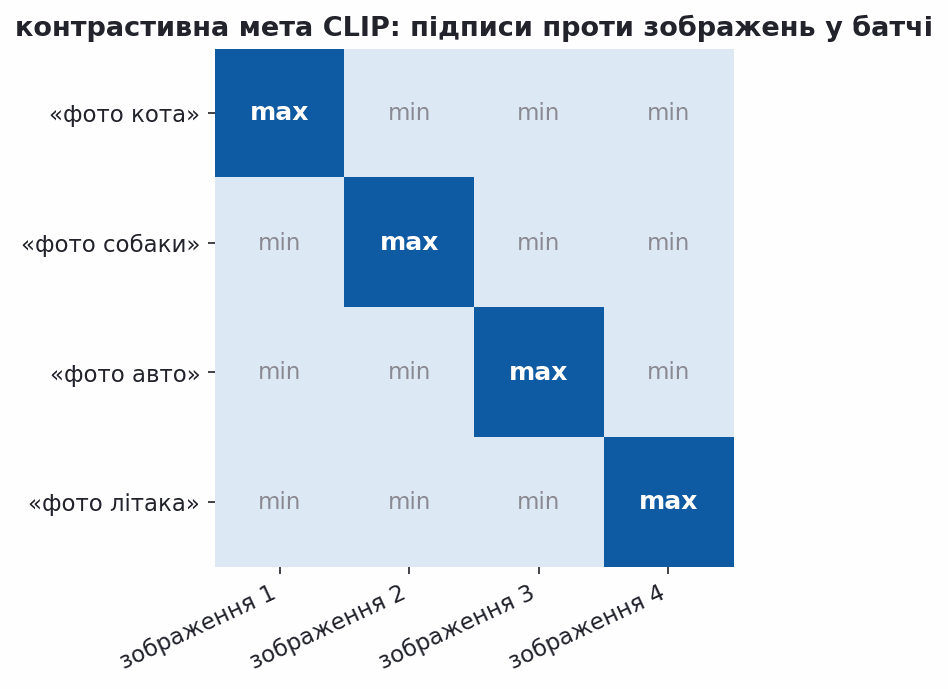
"Use captioned images to learn a joint multimodal embedding space. Objective: maximize cosine similarity of caption and image embeddings while minimizing unrelated pairs." — EPFL CS-433, лекція «Self-supervised Learning»
Джерело: Radford et al. CLIP (ICML 2021)
Класифікація без жодного навчального прикладу
Спільний простір дає несподівану здатність. Щоб класифікувати зображення на нові класи, CLIP не треба донавчати взагалі.
Порядок дій: беремо назви класів, вставляємо кожну в шаблон "A photo of [class]", проганяємо ці речення через текстовий енкодер і отримуємо по вектору на клас. Зображення проганяємо через свій енкодер і оголошуємо переможцем клас із найбільшою косинусною подібністю.
Це називають класифікацією без прикладів (zero-shot classification) — на відміну від навчання за кількома прикладами (few-shot), де хоч кілька розмічених зразків потрібно. Набір класів задається текстом, тому змінити його можна за секунду, без жодного дотику до ваг.
Практичний наслідок: набір класів перестав бути частиною архітектури. Модель, навчена один раз на різнорідних парах з інтернету, обслуговує задачі, яких її автори не передбачали.
Базові моделі: одна модель на багато задач
Остання зміна — організаційна: раніше під кожну задачу навчали свою модель, тепер одну велику навчають раз на нерозміченому корпусі, а під задачу лише адаптують. Такі моделі називають базовими (foundation models) — термін зі звіту Стенфордського CRFM 2021 року; суть не в розмірі, а в тому, що модель є спільною основою, тож і її хиби успадковують усі застосування одразу.
| Модель | Параметрів | Дані | Що з'явилося |
|---|---|---|---|
| GPT-1, 2018 | 117 млн | BooksCorpus, 7000 книг | попереднє навчання працює, але під кожну задачу потрібне своє донавчання |
| GPT-2, 2019 | 1,5 млрд | WebText, 40 ГБ | розв'язує задачі без донавчання, лише за формулюванням |
| GPT-3, 2020 | 175 млрд | 600 ГБ тексту | навчання з прикладів у самому запиті, без зміни ваг |
Джерело: Bommasani et al. On the Opportunities and Risks of Foundation Models (2021)
Обмеження навчання подань
Метод потужний, але має чіткі межі, і про них варто знати заздалегідь.
Подання успадковує все, що є в даних. Вектори слів відтворюють упередження корпусу разом із його знаннями; жоден етап навчання їх не фільтрує. У лекції 14 ми побачимо, чим це обертається на практиці.
Допоміжна задача визначає результат. Наш експеримент це показав прямо: контрастивне навчання дало на цифрах 71,6 % при одній мітці на клас, відновлення прихованих пікселів — 63,6 %, і жодна зміна архітектури цього розриву не закриє.
Аугментації — це припущення про світ. Кажучи «поворот не змінює цифру», ми вбудовуємо в модель конкретне переконання. Для рукописних цифр воно правильне, для медичних знімків із важливою орієнтацією — уже ні.
Виграш зникає, коли міток достатньо. Самонавчання окупається на малих вибірках; за повної розмітки пряме навчання зазвичай не гірше.
Оцінювання непряме. Якість подання видно лише через цільову задачу, тому порівнювати моделі треба лінійним зондуванням, а не втратою на допоміжній задачі.
Підсумок лекції
Подання — окремий об'єкт навчання. Замість того щоб конструювати ознаки руками, ми вчимо відображення в простір, де геометрія відповідає змісту.
Текст дає навчальний сигнал сам. Матриця співвживань, розкладена на дві вузькі матриці, дає вектори слів; word2vec приходить до того самого через задачу передбачення.
Геометрія простору слів осмислена, але не всесильна. Близькість означає схожість, різниця векторів кодує відношення; граматичні аналогії п'ятдесятивимірні вектори вже не тримають.
Один вектор на слово — замало. Контекстні моделі перераховують подання для кожного речення: BERT двонапрямно, GPT причинно.
Самонавчання узагальнює цю ідею на будь-які дані. Допоміжна задача створює пару «вхід — ціль» із нерозміченої точки, а контрастивна втрата рятує від колапсу, додаючи негативи.
Користь вимірюється економією міток. Контрастивне подання дало +15 відсоткових пунктів при одній мітці на клас і поступилося сирим пікселям при п'ятдесяти.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — Text Representation Learning, Self-supervised Learning
- Dive into Deep Learning — word2vec і BERT
Статті
- word2vec, 2013 · негативне семплування, 2013
- GloVe, 2014 · BERT, 2018
- SimCLR, 2020 · CLIP, 2021
- Foundation Models, 2021
Підручники й інструменти
- Introduction to Information Retrieval — розділ 6
- Deep Learning — розділ 15 · PyTorch