Тема
Лекція 11 · Згорткові мережі та навчання глибоких моделей
Минулого разу ми будували повнозв'язні мережі й навчали їх зворотним поширенням. Сьогодні побачимо, що для зображень така мережа влаштована неправильно, і замінимо її на згорткову — з тими самими градієнтами, але в сотні разів меншою кількістю ваг.
Зміст лекції
Лекція йде від однієї конкретної поломки повнозв'язної мережі до архітектур, які виграли ImageNet.
- Чому повнозв'язна мережа не годиться для зображень. Кількість ваг і втрата просторової структури.
- Операція згортки. Фільтр, карта ознак, доповнення, крок, багатоканальність.
- Будова згорткової мережі. Пулінг, конвеєр «видобуток ознак → класифікація», LeNet.
- Згорткова мережа на MNIST у PyTorch. Код, криві навчання, вивчені ядра й карти ознак.
- Глибина. Чому глибокі стеки навчаються гірше і як це виправляють залишкові зв'язки та нормалізація.
- Прийоми узагальнення. Dropout, аугментація даних і те, скільки кожен із них насправді дає.
Перші три блоки будують модель, четвертий її запускає, а два останні відповідають на питання, що заважає зробити модель глибшою і точнішою.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чому кількість ваг повнозв'язного шару робить його непридатним для зображень;
- записати формулу двовимірної згортки і порахувати карту ознак вручну для малого прикладу;
- обчислити розмір виходу згорткового шару за розміром ядра, доповненням і кроком;
- порахувати кількість навчуваних параметрів згорткового шару з кількома каналами;
- пояснити, що дають локальна зв'язність, спільні ваги та еквіваріантність до зсуву;
- зібрати й навчити згорткову мережу на MNIST у PyTorch;
- прочитати візуалізацію вивчених ядер і карт ознак;
- пояснити, як залишкові зв'язки та пакетна нормалізація роблять глибокі мережі навчуваними;
- обрати аугментацію даних під конкретну задачу й розпізнати, коли вона шкодить.
Дані лекції: рукописні цифри MNIST
Уся практична частина лекції побудована на одному наборі даних.
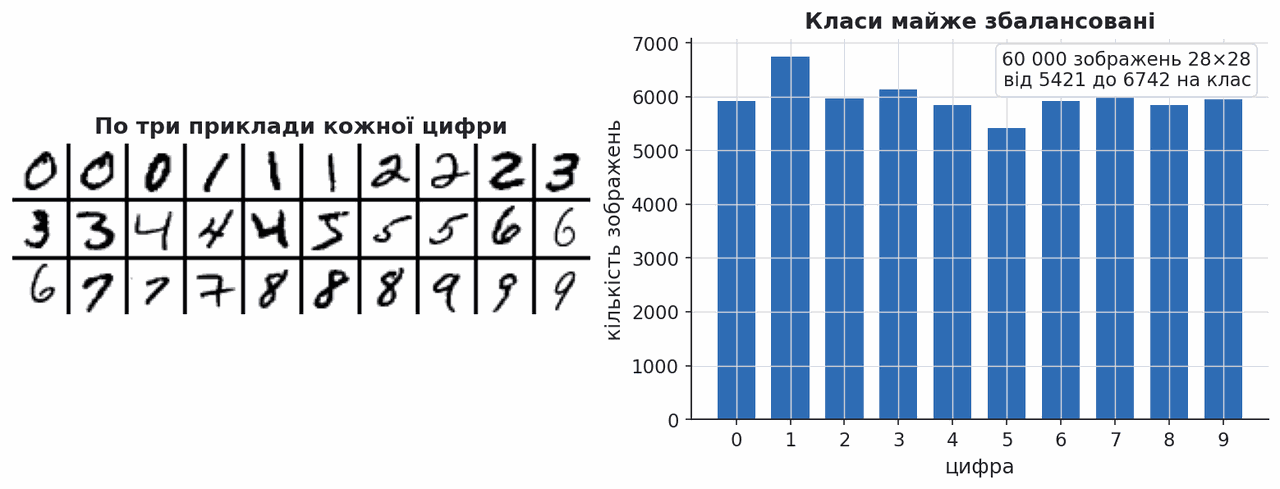
MNIST — 70 000 зображень рукописних цифр у відтінках сірого, розміром 28 × 28 пікселів: 60 000 для навчання і 10 000 для тестування. Ознаки — 784 значення яскравості від 0 до 255. Передбачаємо цифру від 0 до 9. Класи майже збалансовані: від 5421 до 6742 зображень на клас.
Це найвідоміший набір для навчання розпізнаванню зображень, і водночас той самий, на якому в 1998 році працювала LeNet — перша практична згорткова мережа.
Джерело даних: MNIST на OpenML
Повнозв'язний шар не масштабується на зображення
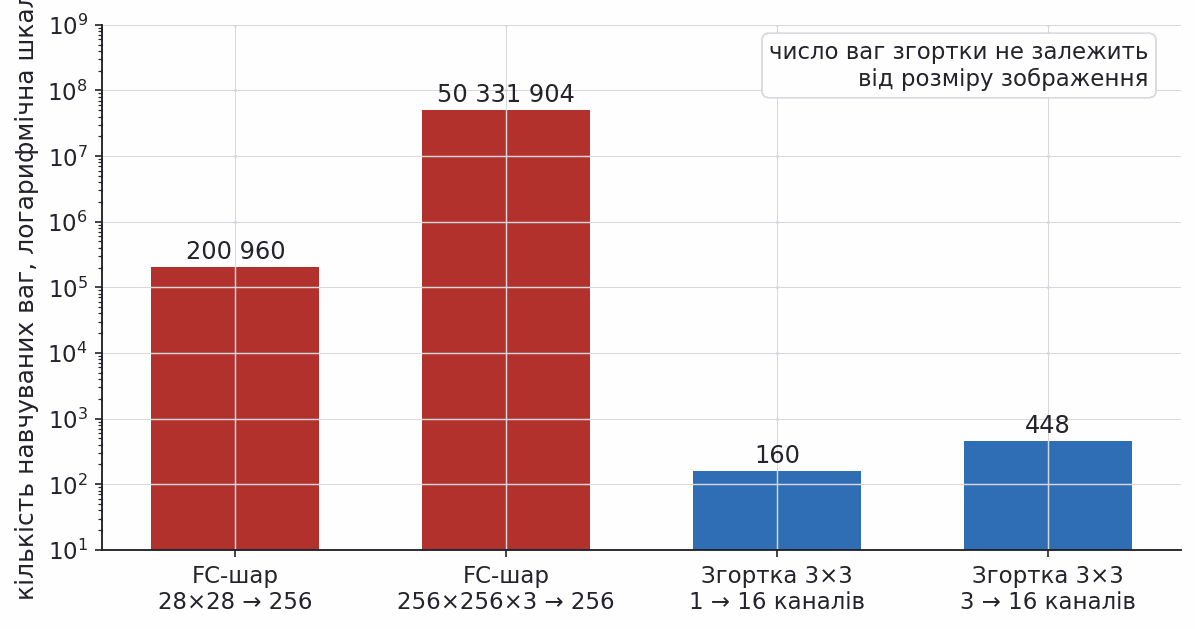
Повнозв'язний шар з'єднує кожен вхід із кожним виходом, тому кількість ваг дорівнює добутку розмірностей. Для MNIST це ще терпимо: 784 × 256 = 200 960 ваг. Для кольорової фотографії 256 × 256 × 3 той самий шар потребує вже понад 50 мільйонів ваг — і це лише перший шар мережі.
Згортковий шар влаштований інакше. Він зберігає невелике ядро (kernel) і застосовує його в кожній позиції зображення. Ядро 3 × 3 на 16 вихідних каналів для кольорового входу — це
"Fully connected neural networks interpret an image as a flattened vector, disregarding the original spatial dependencies." — EPFL CS-433, лекція 08b
Джерело: EPFL CS-433 Machine Learning
Розгортання зображення у вектор руйнує сусідство
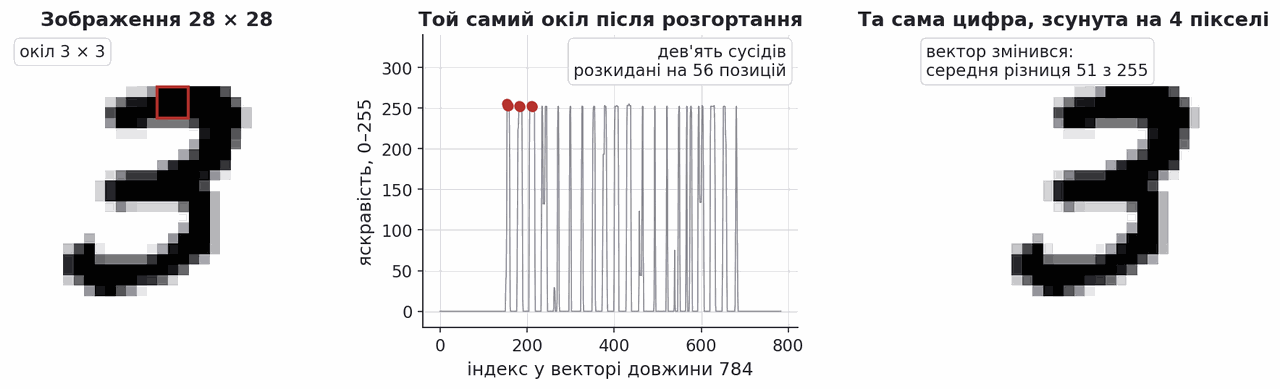
Кількість ваг — не єдина біда. Щоб подати зображення в повнозв'язний шар, його розгортають у вектор довжини 784, читаючи рядок за рядком. Після цього два пікселі, що лежали один над одним, опиняються за 28 позицій один від одного, і мережа не має жодної підказки, що вони сусіди — їй доведеться вивести це з даних.
Друга поломка ще прикріша. Зсунемо цифру на чотири пікселі праворуч: людина бачить ту саму трійку, а вектор ознак змінюється в середньому на 50 одиниць яскравості з 255. Для повнозв'язного шару це фактично інший об'єкт.
Що встигає вивчити повнозв'язний шар на MNIST
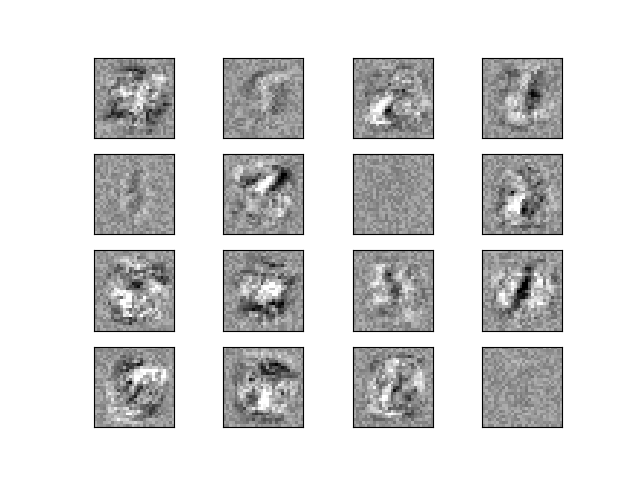
Погляньмо, у що це виливається на практиці. На рисунку — ваги першого шару повнозв'язної мережі, навченої на MNIST: кожен квадрат 28 × 28 показує ваги одного прихованого нейрона, розкладені назад у форму зображення.
Помітно два типи ваг. Частина нейронів вивчила розмиті глобальні шаблони цілої цифри — вони спрацюють лише тоді, коли цифра стоїть точно на своєму місці. Решта лишилася майже випадковим шумом: мережа просто не встигла їх використати. Жодного локального детектора — краю, вигину, штриха — тут немає, бо в архітектурі нічого не спонукає його утворити.
Джерело: scikit-learn · Visualization of MLP weights on MNIST
Згортка в одному вимірі: ковзне вікно
Почнімо з найпростішого випадку — сигналу на прямій. Згортка (convolution) бере невеликий набір ваг, ставить його в позицію
На рисунку той самий фільтр
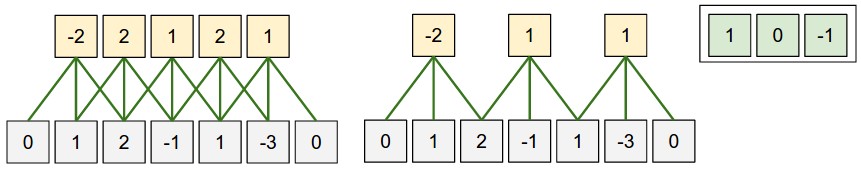
"These 'weighted averages of neighbours' are called 'convolutions'." — UBC CPSC 340, лекція 32
Джерело: Stanford CS231n · Convolutional Networks
Двовимірна згортка крок за кроком
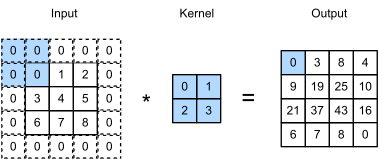
У двох вимірах усе те саме, тільки вікно квадратне. Ядро 2 × 2 накладається на лівий верхній кут входу, обчислюється сума добутків, результат записується в лівий верхній кут карти ознак. Потім вікно зсувається праворуч, потім на рядок нижче.
Перше число на рисунку:
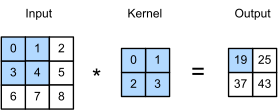
Формула згортки і що в ній позначено
Запишемо те саме формулою. Елемент карти ознак у позиції
| Позначення | Значення |
|---|---|
| вхідна карта: саме зображення або вихід попереднього шару | |
| карта ознак (feature map) — результат згортки | |
| фільтр, або ядро: навчувані ваги, аналог матриці | |
| розмір фільтра; типово 3 або 5 | |
| крок (stride): на скільки пікселів зсувається вікно | |
| просторові індекси в карті ознак, нумерація з нуля |
Індекси
Числовий приклад: детектор вертикального краю
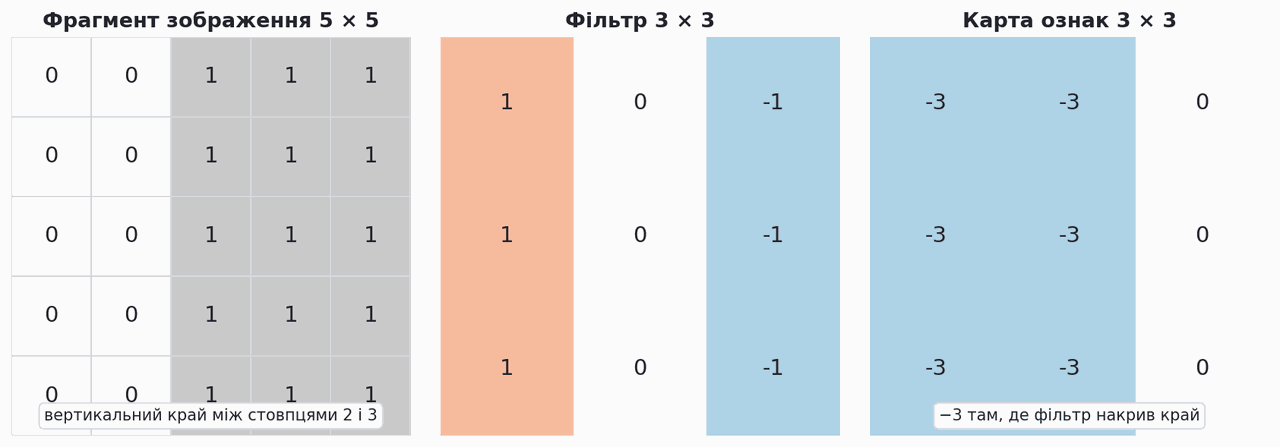
Візьмімо фрагмент зображення 5 × 5, у якому ліва частина темна, а права світла, і фільтр із додатними вагами зліва та від'ємними справа.
Там, де фільтр накриває межу між темним і світлим, додатна й від'ємна частини не компенсують одна одну, і на виході з'являється
Це і є те, що робить згортка: перетворює зображення на карту того, наскільки сильно кожна ділянка схожа на шаблон, записаний у фільтрі.
Код: та сама згортка в PyTorch
Формула з попереднього розділу — це рівно один виклик conv2d. Розміри тензора: (зразки, канали, висота, ширина), тому фрагмент і фільтр треба доповнити двома одиничними вимірами.
Вивід код запущено, вивід не редагувався
text
tensor([[-3., -3.,  0.],
        [-3., -3.,  0.],
        [-3., -3.,  0.]])
На що дивитися: карта 3 × 3 збігається з ручним розрахунком: −3 там, де вікно накриває вертикальний край, і 0 на рівномірній ділянці.
Технічна деталь: у глибокому навчанні «згорткою» називають операцію без віддзеркалення фільтра — математично це крос-кореляція. Оскільки ваги фільтра однаково навчаються, різниці для моделі немає.
Джерело: PyTorch · torch.nn.functional.conv2d
Локальна зв'язність і спільні ваги
Дві властивості згортки варто назвати окремо, бо саме вони дають економію ваг.
Локальна зв'язність (local connectivity): кожен вихідний нейрон дивиться лише на невелике вікно входу, а не на все зображення. На рисунку п'ять нейронів одного стовпця виходу дивляться на ту саму невелику ділянку вхідного об'єму, кожен своїм фільтром.
Спільні ваги (weight sharing): той самий фільтр застосовується в кожній позиції. Наслідок — еквіваріантність до зсуву (translation equivariance): зсунутий вхід дає так само зсунутий вихід. Детектор краю, вивчений у лівому куті зображення, працює і в правому.
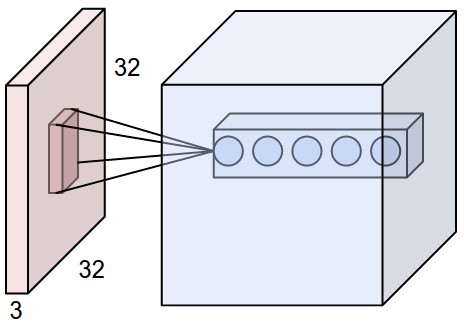
"Because same filters used across the image, they can detect a pattern anywhere." — UBC CPSC 340, лекція 33
Джерело: Stanford CS231n · Convolutional Networks
Класичні фільтри, якими ознаки будували до навчання
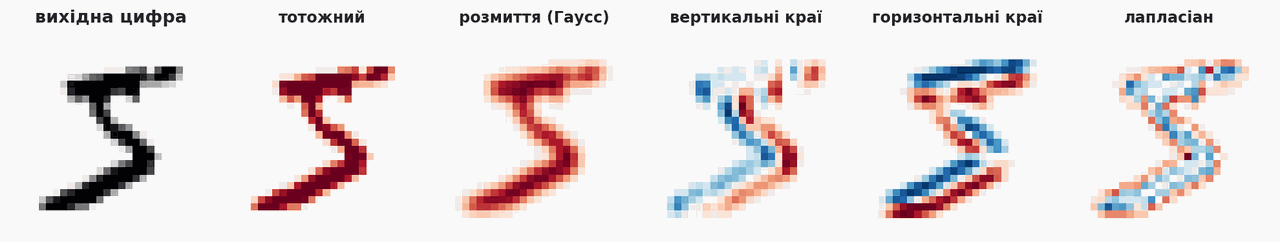
До появи згорткових мереж фільтри не вчили, а придумували. Комп'ютерний зір користувався готовим набором: гауссове розмиття для придушення шуму, різниці сусідніх пікселів для країв, лапласіан для «сплесків», фільтри Габора для орієнтованих смуг.
На рисунку п'ять таких фільтрів застосовано до однієї цифри MNIST. Кожен дає власну карту ознак, і кожна підкреслює свою властивість зображення. Ознаками для класифікатора служили саме ці карти.
Згорткова мережа робить рівно те саме, з однією відмінністю: ваги фільтрів вона підбирає сама під конкретну задачу, замість того щоб брати їх із підручника.
Фільтр, який ви задаєте самі
Ліворуч — справжня цифра MNIST, 28 × 28 пікселів. Праворуч — карта ознак: ядро проходить по кожній позиції й рахує суму добутків. Синє означає додатний відгук, червоне — від'ємний, білі ділянки фільтр не помітив.
ядро 3 × 3
реагує на перепад яскравості зліва направо
Доповнення нулями
28 × 28розмір карти ознак
9 + 1ваг у ядрі, разом зі зсувом
784позицій, де працюють ті самі 9 ваг
—розбіжність «зсунули вхід» проти «зсунули карту»
Перевірте формулу розміру виходу самі: при доповненні й кроці 1 карта лишається 28 × 28, при кроці 2 стає 14 × 14, а без доповнення втрачає по пікселю з кожного боку. Порівняйте «вертикальні краї» з «горизонтальними»: це те саме ядро, повернуте на 90°, і воно бачить зовсім інші частини цифри. «Тотожність» повертає вхід без змін — корисна перевірка, що механіка чесна. А головне: скільки б не було позицій, ваг завжди дев'ять — саме на цьому тримається вся економія згорткового шару.
Останній повзунок зсуває цифру вправо, і на ньому видно еквіваріантність — властивість, заради якої згортку й вигадали. Зсуньте на три пікселі: карта ознак зсунеться рівно на три, форма відгуку не зміниться взагалі. Остання плашка показує це числом: вона порівнює карту зсунутого зображення з картою незсунутого, зсунутою на ті самі пікселі, і при доповненні з кроком 1 різниця дорівнює нулю до останнього знака. Саме тому один вивчений детектор краю працює в усіх 784 позиціях, а повнозв'язному шару довелося б вивчати кожну позицію окремо.
Доповнення нулями зберігає розмір карти
Вікно, що цілком міститься всередині входу, не дістає до самих країв: вхід 5 × 5 і ядро 3 × 3 дають карту 3 × 3. Після десятка таких шарів від зображення нічого не залишиться, а пікселі біля рамки братимуть участь у меншій кількості обчислень, ніж центральні.
Ліки — доповнення нулями (zero padding): по краях додають рамку з нулів. Вхід 3 × 3 із рамкою в один піксель стає 5 × 5, і після ядра 2 × 2 карта виходить 4 × 4.
Два стандартні режими: same — доповнити так, щоб розмір зберігся, і valid — не доповнювати зовсім, згортаючи лише там, де фільтр вміщується повністю.
Крок згортки прорідує карту ознак
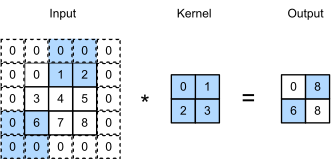
Другий гіперпараметр — крок (stride). При кроці 1 вікно посувається на один піксель, при кроці 2 — через один, і карта ознак виходить приблизно вдвічі меншою по кожній осі.
На рисунку вхід 3 × 3 із доповненням, ядро 2 × 2, крок 3 по вертикалі та 2 по горизонталі — карта стискається до 2 × 2. Крок більший за одиницю виконує ту саму роль, що й пулінг: зменшує просторовий розмір і здешевлює наступні шари.
Розмір виходу рахується однією формулою
Три гіперпараметри — розмір ядра, доповнення і крок — разом визначають розмір карти ознак:
де
Перевірмо на трьох випадках, які знадобляться далі:
- наскрізний приклад,
, , , : ; - шар нашої мережі,
, , , : — розмір збережено; - той самий шар із кроком 2:
— розмір удвічі менший.
Це та арифметика, через яку доводиться проходити щоразу, коли збираєш мережу: розмір входу останнього повнозв'язного шару має збігтися з тим, що видали згорткові.
Багатоканальна згортка і скільки в ній ваг
Реальне зображення має кілька каналів: три кольорові в фотографії, десятки карт ознак усередині мережі. Фільтр має рівно стільки ж каналів, скільки вхід. Згортки по каналах обчислюються окремо, потім додаються, і до суми додається зсув — виходить один канал результату. Приклад зі слайдів EPFL: внески трьох каналів
Щоб отримати кілька карт ознак, беруть кілька фільтрів. Звідси й підрахунок ваг:
| Величина | Формула | Приклад: |
|---|---|---|
| Ваги одного фільтра | ||
| Зсув одного фільтра | ||
| Увесь шар |
У цій формулі немає ні висоти, ні ширини зображення. Саме тому згорткова мережа однаково добре працює на 28 × 28 і на 4000 × 3000.
Пулінг зменшує карту ознак
Між згортковими шарами ставлять пулінг (pooling) — субдискретизацію, яка зменшує просторовий розмір карти. Найпоширеніший варіант, max pooling, розбиває карту на вікна 2 × 2 і залишає в кожному максимум; є ще усереднювальний варіант.
Пулінг не має навчуваних параметрів — налаштовують лише розмір вікна, тип і крок. Його роль подвійна: наступні шари стають учетверо дешевшими, а точне положення ознаки перестає мати значення — важливо, що вона в цій ділянці є.
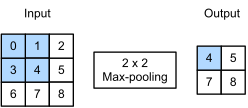
"Pooling is a downsampling operation that reduces the spatial dimensions of the convolved feature. Pooling layers do not have learnable parameters." — EPFL CS-433, лекція 08b
Джерело: Dive into Deep Learning · Pooling
Пулінг на реальній цифрі
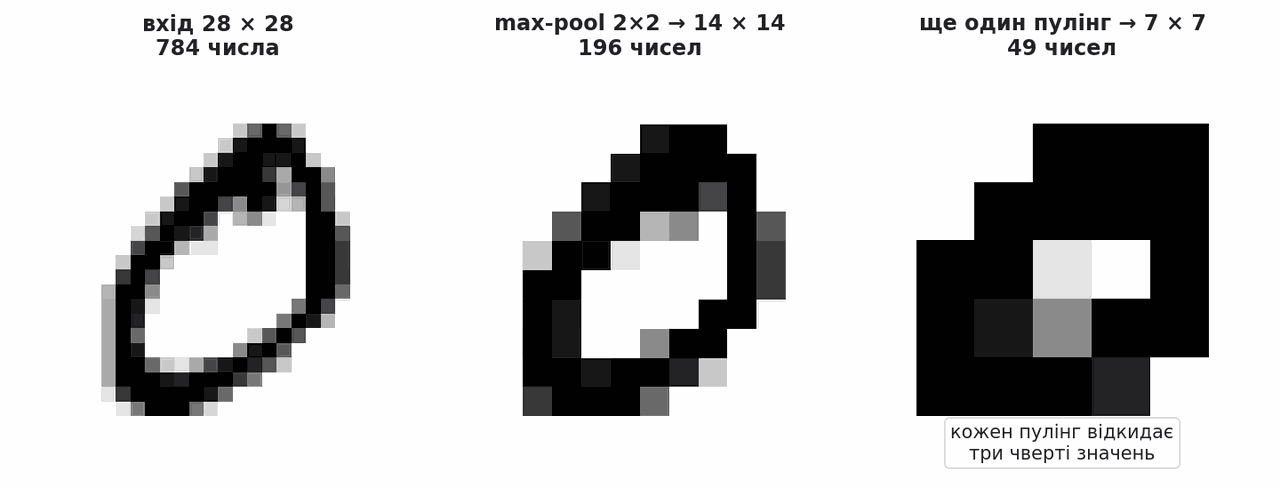
Подивимось, що пулінг робить із зображенням MNIST. Перший прохід стискає 28 × 28 до 14 × 14, другий — до 7 × 7. Із 784 чисел лишається 49, тобто кожен крок відкидає три чверті значень.
Цифра при цьому лишається впізнаваною. Це і є причина, чому пулінг працює: для рішення «це нуль» деталі окремих пікселів не потрібні, потрібна груба форма. Водночас видно й ціну: після двох пулінгів тонкі штрихи зливаються, тому в сучасних архітектурах пулінг ставлять ощадливіше або замінюють згорткою з кроком 2.
Повний конвеєр згорткової мережі
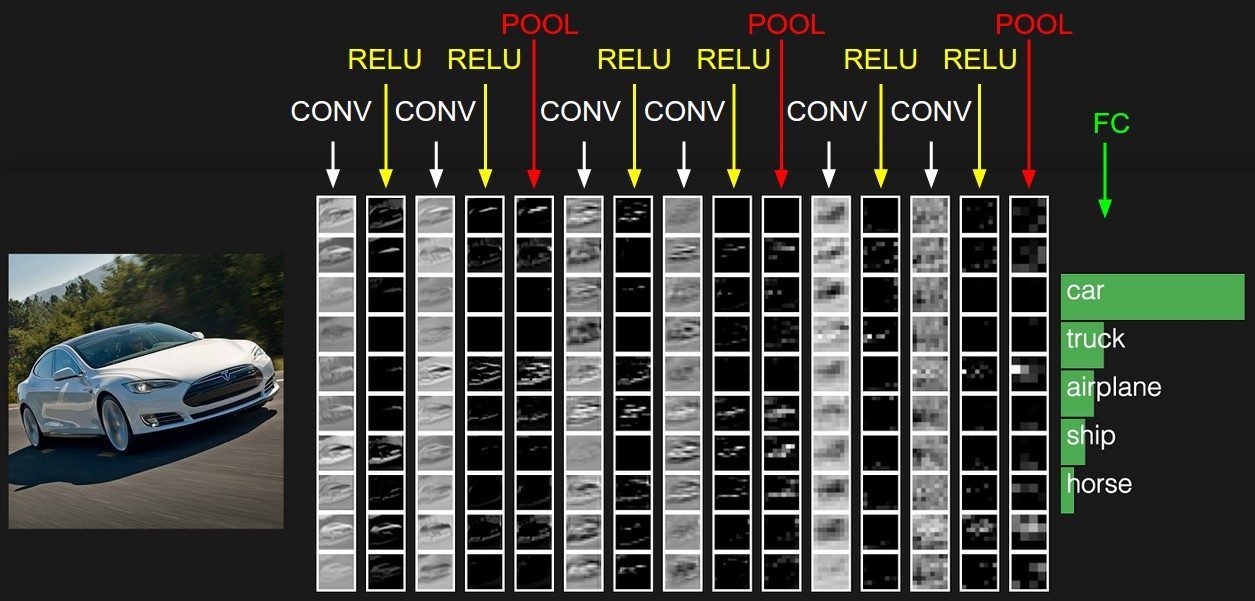
Тепер зберімо все докупи. Згорткова мережа складається з двох частин.
Видобуток ознак: кілька разів поспіль повторюється блок «згортка → нелінійність ReLU → пулінг». Просторовий розмір зменшується, кількість каналів зростає. Рецептивне поле — ділянка входу, що впливає на один нейрон, — росте з глибиною: перші шари бачать краї, глибші складають із них частини об'єктів.
Класифікація: карти ознак останнього блоку розгортаються у вектор і подаються в повнозв'язні шари, які й видають оцінки класів. Той самий класифікатор, що в лекції 10, — але тепер він отримує на вхід не сирі пікселі, а ознаки, побудовані згортками.
LeNet: перша практична згорткова мережа
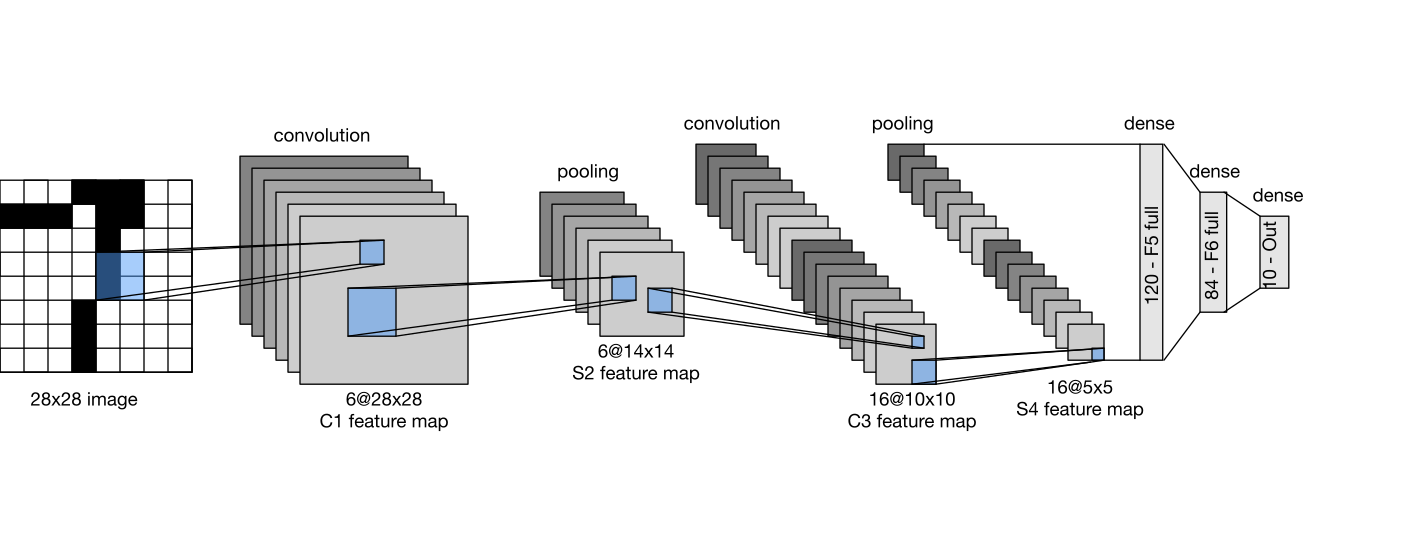
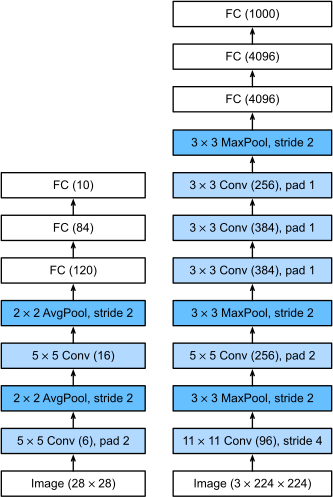
Схема, яку ми щойно описали, з'явилася в LeNet (LeCun та ін., 1998) — мережі для розпізнавання рукописних цифр, що працювала в поштових і банківських системах.
Вхід 28 × 28 проходить через згортку в 6 каналів, усереднювальний пулінг, згортку в 16 каналів, ще один пулінг — і три повнозв'язні шари на 120, 84 і 10 виходів. За цією схемою легко порахувати ваги: 156 + 2416 + 48 120 + 10 164 + 850, разом приблизно 62 тисячі.
Порівняйте з архітектурою, яку ми зберемо в наступних розділах: та сама послідовність, ті самі два згорткові блоки. За чверть століття змінилися масштаби, нелінійності й способи оптимізації, але каркас лишився.
Джерело: Dive into Deep Learning · LeNet
Код: згорткова мережа на MNIST у PyTorch
Завантаження даних і сама модель. Коментарі показують, як змінюється форма тензора.
Вивід код запущено, вивід не редагувався
text
навчальних 60000, тестових 10000, параметрів мережі 11274На що дивитися: уся мережа має лише 11 274 параметри на 60 000 навчальних зображень, і дві третини з них припадають на останній повнозв'язний шар.
Ваги розподілені так: перша згортка — 208, друга — 3216, повнозв'язний шар — 7850; обидва згорткові шари разом обходяться трьома з половиною тисячами.
Джерело: PyTorch · torchvision.datasets.MNIST
Код: цикл навчання
Далі — звичайний цикл із лекції 10: перемішані мінібатчі, перехресна ентропія, Adam. Нічого специфічного для згорток тут немає, бо зворотне поширення крізь згортковий шар працює так само, як крізь повнозв'язний.
Вивід код запущено, вивід не редагувався
text
епоха 1: втрата 0.2937
епоха 2: втрата 0.0734
епоха 3: втрата 0.0546
епоха 4: втрата 0.0437
епоха 5: втрата 0.0371
На що дивитися: втрата падає з 0,2937 після першої епохи до 0,0371 після п'ятої: основне мережа вивчає вже за першу епоху.
Зерно генератора зафіксовано вище, тому ці числа відтворюються точно; без нього перша епоха гуляє в межах кількох сотих.
Єдина тонкість зі спільними вагами: градієнт ваги фільтра — це сума градієнтів по всіх позиціях, де ця вага працювала. PyTorch робить це сам; правило походить із ланцюгового, коли одна змінна входить у вираз кілька разів.
Згорткова мережа проти повнозв'язної на MNIST
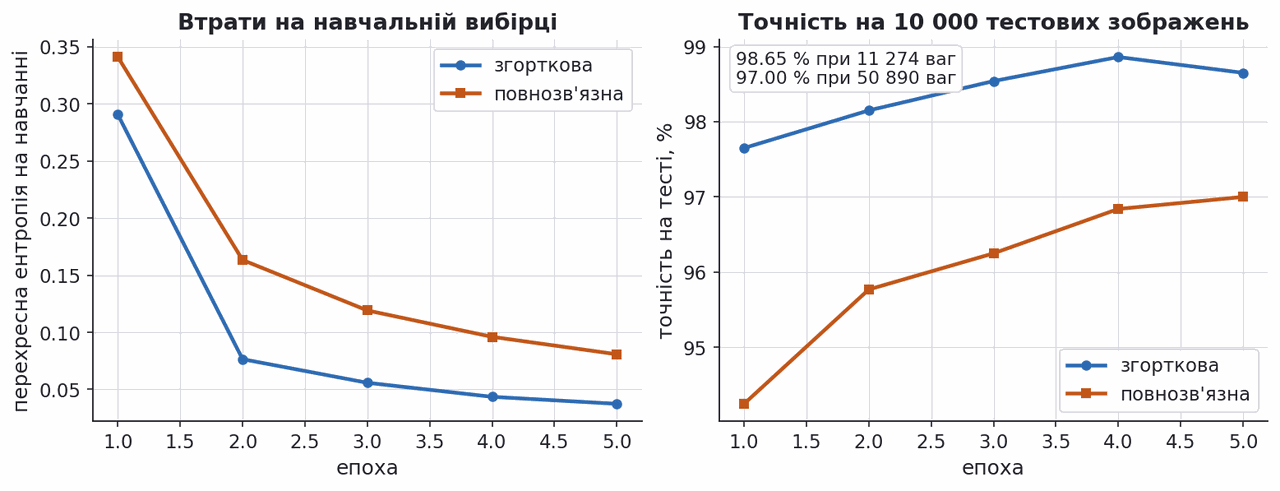
Порівняймо чесно: обидві мережі навчено п'ять епох на тих самих 60 000 зображень одним оптимізатором.
Згорткова мережа з 11 274 вагами дає 98,65 % правильних відповідей на тесті. Повнозв'язна з 50 890 вагами — 97,00 %. Учетверо менше параметрів і при цьому на 1,65 відсоткового пункту вища точність; на 10 000 тестових зображень це 165 виправлених помилок.
Причина не в тому, що згортка «потужніша». Навпаки: вона слабша, бо може менше. Але те, що вона може, точно відповідає структурі задачі — і мережі не доводиться витрачати дані на вивчення того, що сусідні пікселі пов'язані.
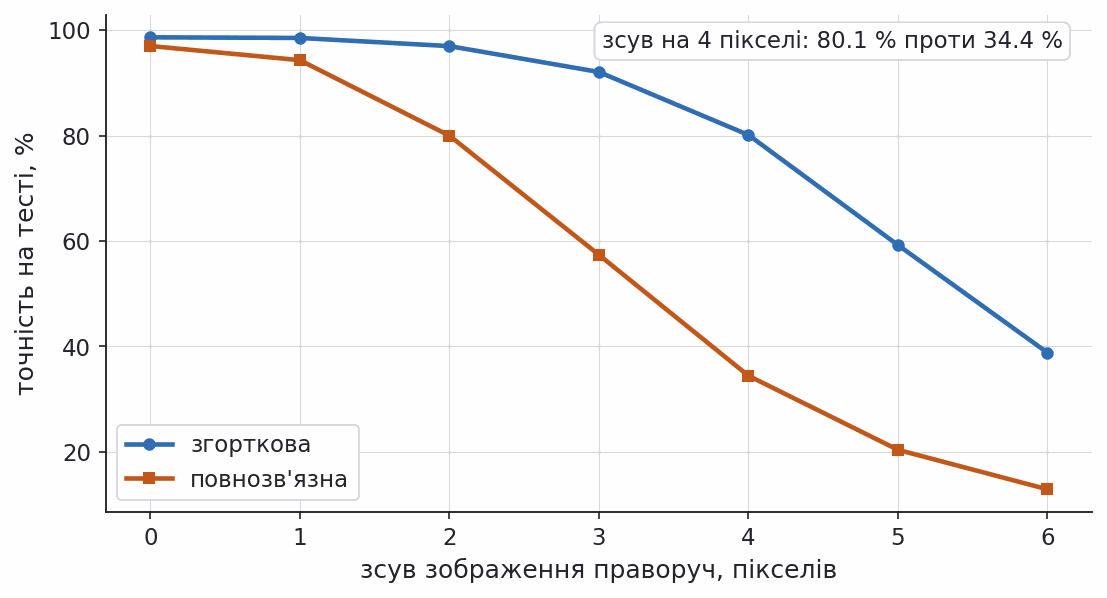
Стійкість до зсуву — це те, що дають спільні ваги
Точність на чистому тесті приховує головну відмінність. Зсунемо тестові зображення праворуч і подивимось, як обидві мережі це витримають.
При зсуві на два пікселі згорткова тримає 96,98 %, а повнозв'язна падає до 79,98 %. При зсуві на чотири — 80,12 % проти 34,42 %. Обидві мережі навчалися на нормалізованих, центрованих цифрах і жодного зсуву не бачили; різниця цілком походить з архітектури.
Варто розрізняти два поняття. Згортка еквіваріантна до зсуву: зсунеться вхід — зсунеться карта ознак. Пулінг і повнозв'язний шар наприкінці додають часткову інваріантність: невеликий зсув на відповіді вже не позначається.
Еквіваріантність — не метафора, її можна перевірити рівністю.
Вивід код запущено, вивід не редагувався
text
розбіжність: 3.0e-08На що дивитися: розбіжність 3·10⁻⁸ — це похибка округлення float32: зсунути вхід і зсунути вихід згортки — одне й те саме.
Розбіжність —
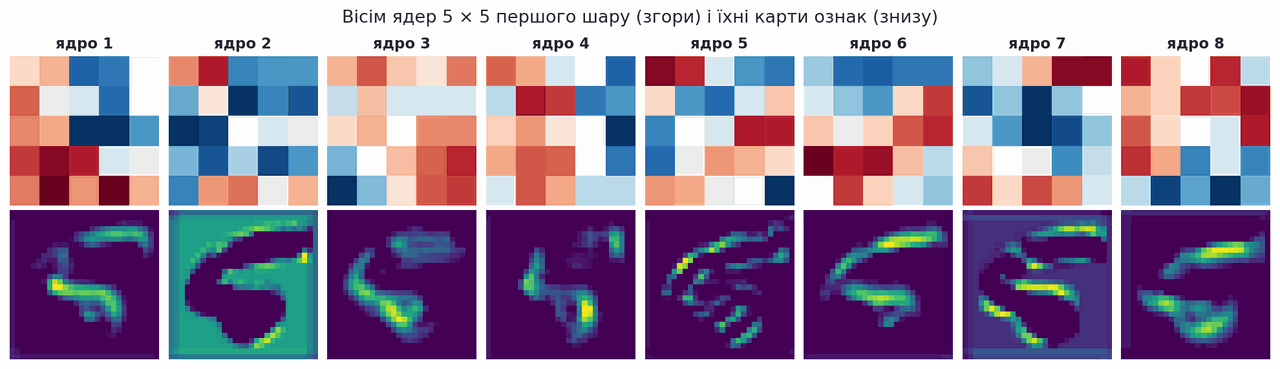
Ядра, які мережа вивчила сама
Заглянемо всередину навченої мережі. Угорі — вісім ядер 5 × 5 першого шару: синє означає від'ємну вагу, червоне — додатну. Унизу — карта ознак, яку кожне ядро дає на одній цифрі.
Ядра не схожі на охайні фільтри з підручника, але кожне має свою спеціалізацію: одні відгукуються на верхні межі штриха, інші на нижні, ще одні гасять фон і залишають контур. Порівняйте з попереднім розділом про ваги повнозв'язної мережі: там були розмиті шаблони цілої цифри, тут — локальні детектори, які працюють у будь-якому місці зображення.
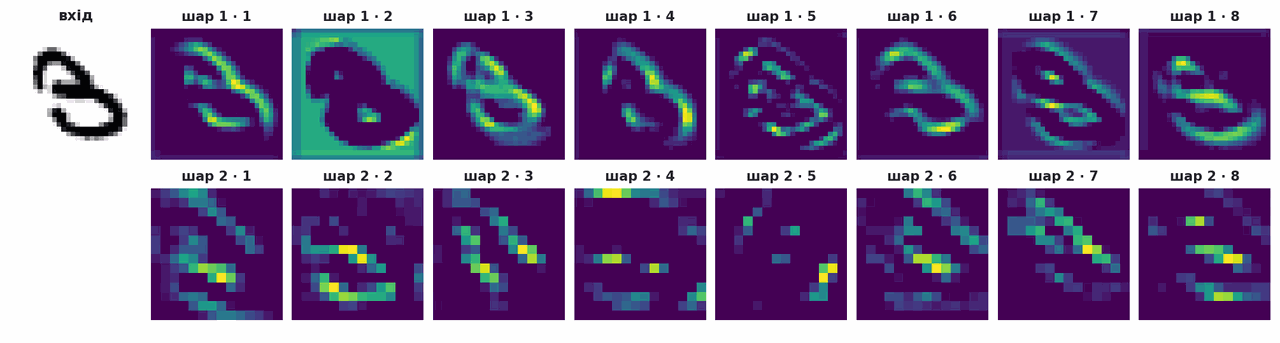
Карти ознак стають дедалі абстрактнішими
Тепер простежимо одну цифру крізь обидва згорткові блоки. Верхній ряд — вісім карт ознак після першого згорткового шару, розміром 28 × 28: у них ще впізнається сама трійка, підсвічена по-різному.
Нижній ряд — вісім із шістнадцяти карт після другого шару, розміром 14 × 14. Тут цифра вже не читається: залишилися окремі яскраві плями там, де знайдено потрібну комбінацію ознак першого шару. Ще один пулінг стискає їх до 7 × 7, і саме ці 16 × 7 × 7 = 784 числа отримує повнозв'язний класифікатор.
Це і є ієрархія подань: перший шар знаходить краї, другий складає з країв частини, глибші шари в більших мережах — цілі об'єкти. Рецептивне поле нейрона росте з глибиною, тому кожен наступний шар «бачить» ширшу ділянку входу.
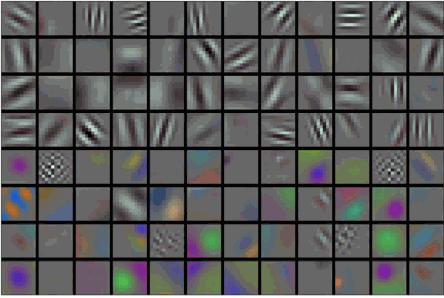
На кольорових фотографіях перший шар вивчає те саме
Наші ядра виглядають шумно, бо MNIST — маленький і чорно-білий набір. На великих кольорових даних картина стає хрестоматійною.
На рисунку — 96 ядер першого шару AlexNet, навченої на ImageNet. Верхня половина: детектори орієнтованих країв і смуг різної частоти — фактично ті самі фільтри Габора, які раніше програмували вручну. Нижня половина: кольорові плями й переходи.
Мережа не отримувала жодної підказки про те, що краї важливі. Вона дійшла до цього сама, з мільйона фотографій, і дійшла приблизно до того самого, що людство вигадувало для комп'ютерного зору тридцять років.
Джерело: Dive into Deep Learning · AlexNet
Ніхто не навчає згорткову мережу з нуля
Досі кожну мережу цієї лекції ми навчали від випадкових ваг. У прикладній роботі так не роблять майже ніколи: беруть мережу, уже навчену на ImageNet, і донавчають під свою задачу. Причина не в економії часу, а в тому, що перші шари вивчають краї, кути й текстури — те саме для будь-яких зображень, як ми бачили двома розділами вище.
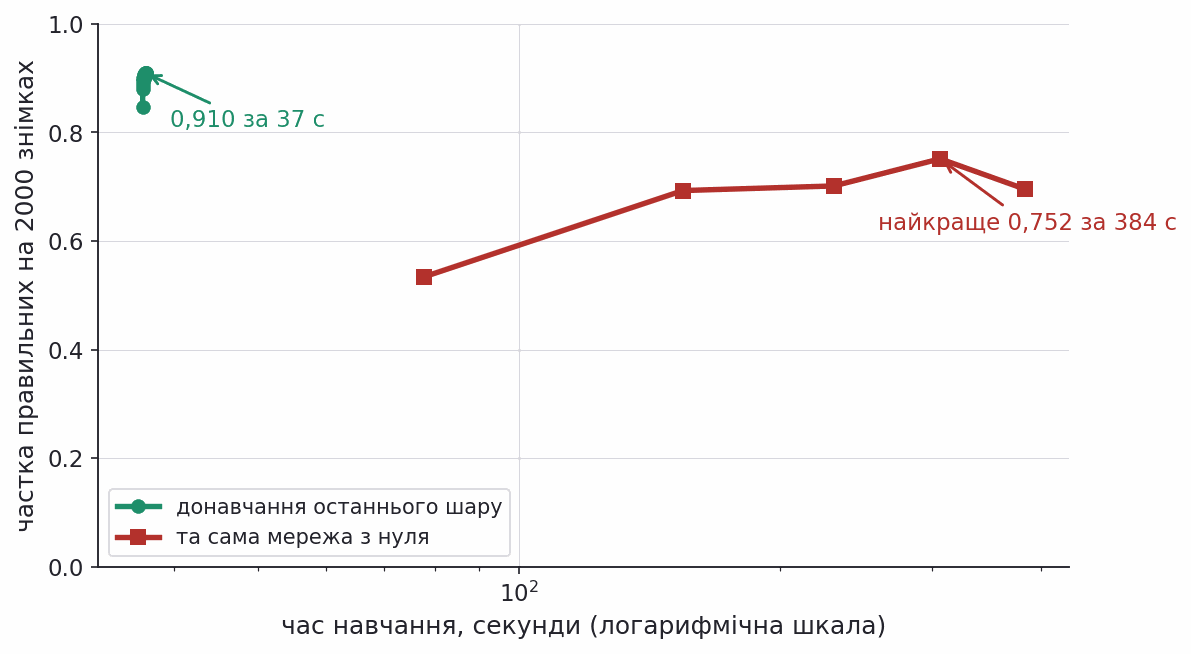
Візьмімо EuroSAT — 27 000 супутникових знімків 64×64 у десяти класах землекористування; це набір лабораторної роботи 4. Порівняймо два шляхи на 6000 навчальних і 2000 тестових знімках.
Вивід код запущено, вивід не редагувався
text
донавчання: 0.91На що дивитися: лінійний шар поверх готових ознак ImageNet правильно розпізнає 91 % супутникових знімків, хоча з усієї мережі навчалися лише 5130 ваг.
Донавчання дає 0,910 точності. Обчислення ознак усіх восьми тисяч знімків зайняло 36,8 секунди, навчання лінійної голови — 0,4 секунди: разом менш ніж хвилина на звичайному процесорі, причому оновлюються лише 5130 параметрів із 11 мільйонів.
Та сама архітектура з нуля: удесятеро довше й гірше
Тепер чесне порівняння: та сама resnet18, але з випадковими вагами й повним навчанням усіх одинадцяти мільйонів параметрів на тих самих 6000 знімках.
П'ять епох забирають 384 секунди — удесятеро більше за все донавчання — і дають по епохах 0,534, 0,693, 0,702, 0,752, 0,696. Останнє число не помилка: навчання з нуля на шести тисячах зображень нестійке, і точність між епохами стрибає вниз.
Порівняння виходить не «трохи краще», а якісне: 0,910 за 37 секунд проти найкращих 0,752 за 384 секунди. Причина проста — 6000 знімків замало, щоб з нуля вивчити детектори країв, які ImageNet уже вивчив на мільйоні фотографій.
Звідси правило, з якого починають будь-яку задачу комп'ютерного зору: спершу візьміть попередньо навчену мережу й донавчіть останній шар. Навчання з нуля має сенс, коли зображення принципово не схожі на фотографії — знімки з мікроскопа, спектрограми, дані сенсорів — або коли їх мільйони.
AlexNet, 2012: рік, коли все змінилося
AlexNet виграла конкурс ImageNet 2012 з похибкою top-5 15,4 % проти 26,2 % у найближчого конкурента — розрив, якого в цьому конкурсі не бувало. Саме цей результат зробив глибоке навчання мейнстримом.
Архітектурно AlexNet — це та сама LeNet, тільки більша: п'ять згорткових шарів замість двох, три повнозв'язні, вхід 224 × 224 × 3 замість 28 × 28. Що справді було новим — це набір інженерних рішень: ReLU замість насичених нелінійностей, навчання на двох GPU протягом п'яти-шести днів, аугментація зсувами й віддзеркаленнями, dropout у повнозв'язних шарах.
Числа top-5 наведено за курсом UBC CPSC 340, лекція 33; в оригінальній статті фігурує 15,3 % для ансамблю моделей.
Джерело: Dive into Deep Learning · AlexNet
ReLU навчається у рази швидше за насичені нелінійності
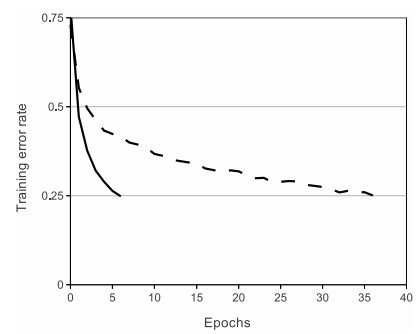
Один із графіків статті про AlexNet вартий окремого розділу, бо пояснює, чому ReLU витіснила сигмоїду й гіперболічний тангенс скрізь.
Суцільна лінія — та сама мережа з ReLU, штрихова — з
Причина в похідній. У насичених функцій вона майже нульова на обох кінцях, і в глибокій мережі добуток таких похідних дає зникаючий градієнт (vanishing gradient): перші шари майже не отримують сигналу. У ReLU похідна на додатному боці дорівнює одиниці й нічого не гасить.
Джерело: Stanford CS231n · Neural Networks
Глибші мережі навчаються гірше, ніж мали б
Здавалося б, глибина безкоштовна: якщо додати шари, гірше не стане — зайві шари в найгіршому разі вивчать тотожне перетворення й пропустять сигнал далі. Формально це так: клас функцій, доступний глибшій мережі, містить у собі клас функцій мілкішої.
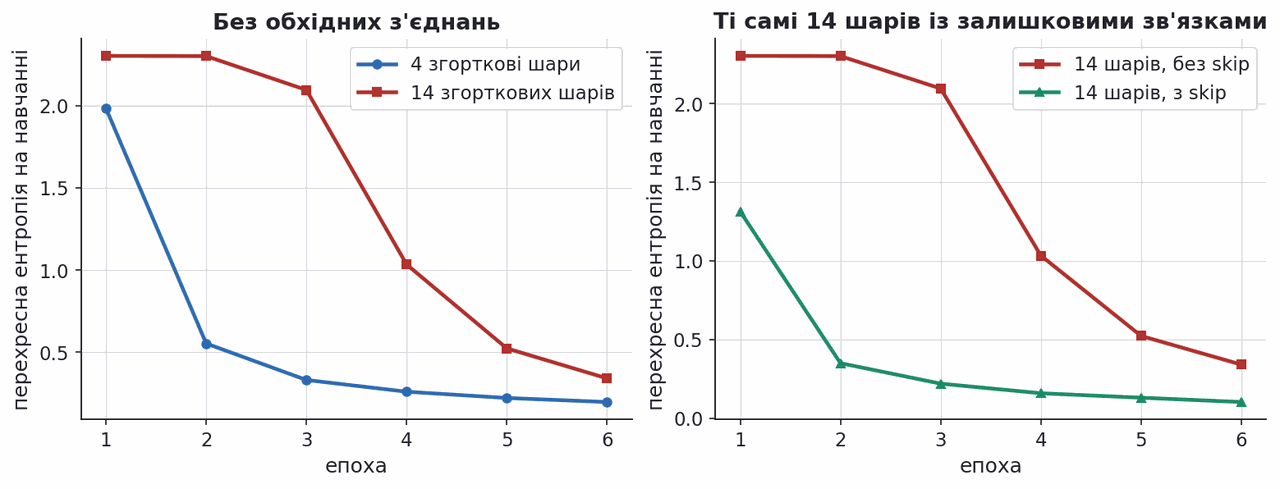
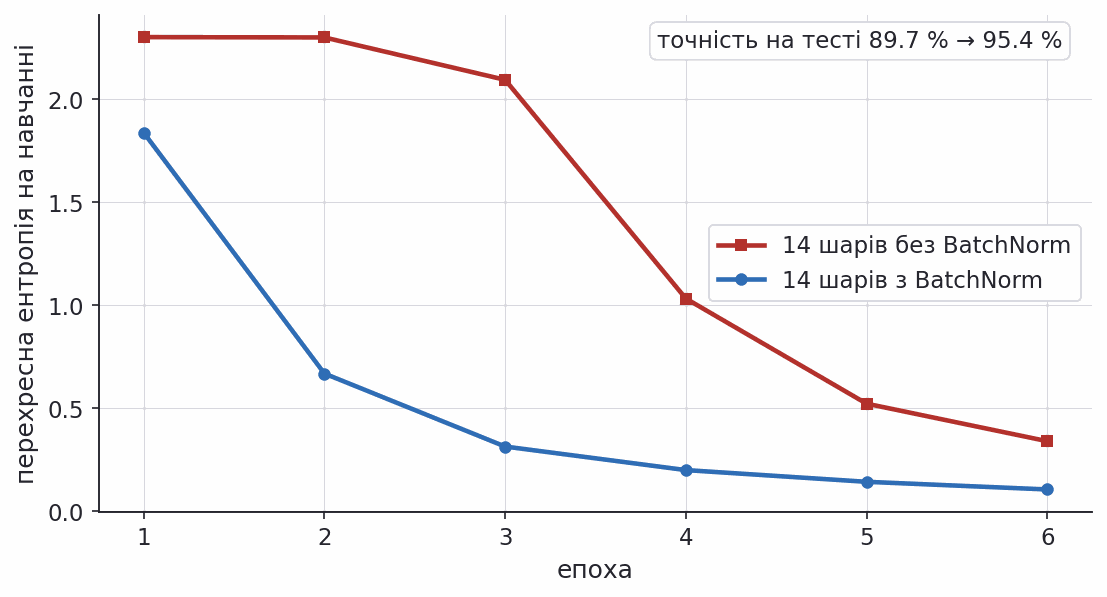
На практиці цього не відбувається. Ліворуч на рисунку — наш власний дослід: два стеки згорткових шарів, у чотири шари й у чотирнадцять, навчено на однакових 6000 зображеннях MNIST за однакових умов. Глибший стек не просто не виграв — він програв: втрата на навчанні 0,34 проти 0,196, точність на тесті 89,7 % проти 94,0 %. Перші дві епохи він узагалі не рухався з місця.
Праворуч — те саме після однієї зміни, про яку далі. Втрата падає до 0,103, точність зростає до 96,59 %.
Залишковий блок: додати вхід до виходу
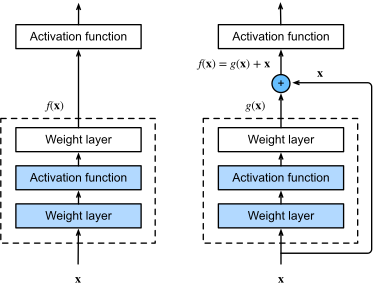
Зміна на диво проста. Замість того щоб просити блок шарів обчислити потрібне перетворення
Тут
Тепер тотожне перетворення дається задарма: щоб блок нічого не змінював, достатньо занулити ваги залишкової гілки, а не підбирати їх так, щоб вони склалися в одиничну матрицю. І градієнт має прямий шлях до нижніх шарів — той самий
Код: залишковий блок у PyTorch
Весь блок — десять рядків. Якщо розміри входу й виходу не збігаються, на обхідний шлях додають згортку 1 × 1 із відповідним кроком.
Вивід код запущено, вивід не редагувався
text
форма виходу: (4, 8, 14, 14) · параметрів блока: 1200На що дивитися: вихід має ту саму форму, що й вхід, — саме тому до нього можна додати X; блок коштує лише 1200 параметрів.
Із таких блоків складено ResNet — мережу зі 152 шарами, яка 2015 року виграла всі п'ять змагань ImageNet. Обхідні з'єднання зробили навчання мереж глибших за сто шарів практичною справою — саму ідею пропускати сигнал повз шари раніше пробували Highway Networks — і сьогодні вони є практично в кожній сучасній архітектурі, зокрема в трансформерах наступної лекції.
Джерело: He K. et al., Deep Residual Learning for Image Recognition, CVPR 2016
Пакетна нормалізація вирівнює масштаби всередині мережі
Другий спосіб зробити глибокий стек навчуваним — нормалізувати активації прямо посеред мережі. Пакетна нормалізація (batch normalization) для кожної ознаки віднімає середнє по мінібатчу й ділить на стандартне відхилення, після чого повертає моделі свободу двома навчуваними параметрами:
Тут
Той самий стек із чотирнадцяти шарів із доданою нормалізацією зрушує з місця з першої ж епохи: втрата падає до 0,106 замість 0,34, точність на тесті зростає з 89,7 % до 95,4 %.
Формулу наведено за Ioffe S., Szegedy C., Batch Normalization, ICML 2015
BatchNorm ламається не у формулі, а в режимі eval
Формула вище має неочевидний наслідок: під час навчання шар нормує батч його власними статистиками. Отже, прогноз для одного зображення залежить від того, які інші зображення потрапили з ним в один батч. Перевірмо.
Вивід код запущено, вивід не редагувався
text
train: клас 8 проти 9 · розбіжність 3.807
eval : клас 9 проти 9 · розбіжність 0.0
На що дивитися: у режимі train одне й те саме зображення отримує різні класи залежно від сусідів у батчі, а в режимі eval розбіжність рівно нуль.
У режимі навчання те саме зображення дістає клас 8 в одній компанії й клас 9 в іншій, а виходи розходяться на 3,807. У режимі eval розбіжність дорівнює рівно нулю: шар перемикається на ковзні середні, накопичені під час навчання, і сусіди по батчу більше ні на що не впливають.
Звідси правило, яке коштує людям робочих днів: model.eval() перед будь-яким оцінюванням і перед видачею прогнозів — не косметика, а умова відтворюваності. Ця ж вада пояснює, чому в трансформерах з лекції 12 узяли LayerNorm: вона нормує кожен приклад окремо, тож не залежить ані від розміру батчу, ані від режиму.
Dropout: навчати одразу багато мереж
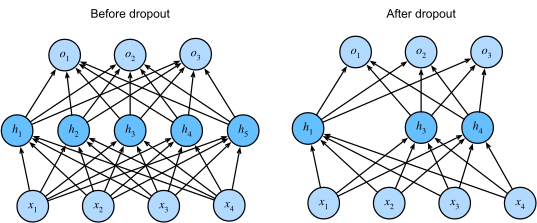
Перейдімо від навчуваності до узагальнення. Dropout на кожному кроці навчання залишає кожен вузол шару з імовірністю
Ефект подвійний. Нейрон не може покластися на конкретного сусіда, бо той будь-якої миті може зникнути, тож ознаки виходять менш взаємозалежними. А оскільки підмережа щоразу нова, навчання нагадує вирощування ансамблю з експоненційно багатьох мереж зі спільними вагами.
Під час тестування нічого не вимикають, але виходи домножують на
Джерело: Dive into Deep Learning · Dropout · Srivastava N. et al., JMLR 2014
Аугментація даних: перетворення, що зберігають мітку
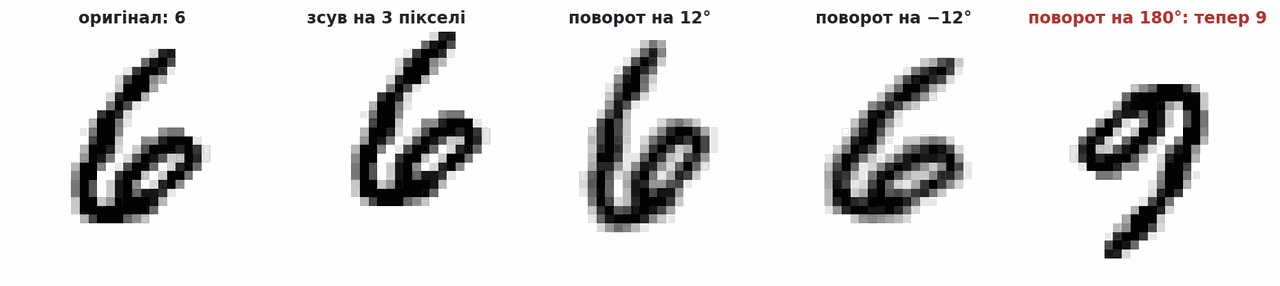
Найпрямолінійніший спосіб боротьби з перенавчанням — узяти більше даних. Якщо взяти їх нізвідки, дані породжують із наявних: до кожного зображення застосовують перетворення
Для рукописних цифр підходять невеликі зсуви й повороти: зсунута шістка залишається шісткою. Але останній кадр на рисунку показує межу методу. Поворот на 180° перетворює шістку на дев'ятку, і мітка «6» стає хибною — модель вчитимуть на брехні.
Правило просте: перетворення обирають під конкретний набір даних. Віддзеркалення по горизонталі нешкідливе для фотографій котів і руйнівне для тексту й цифр.
Виміряний внесок dropout і аугментації
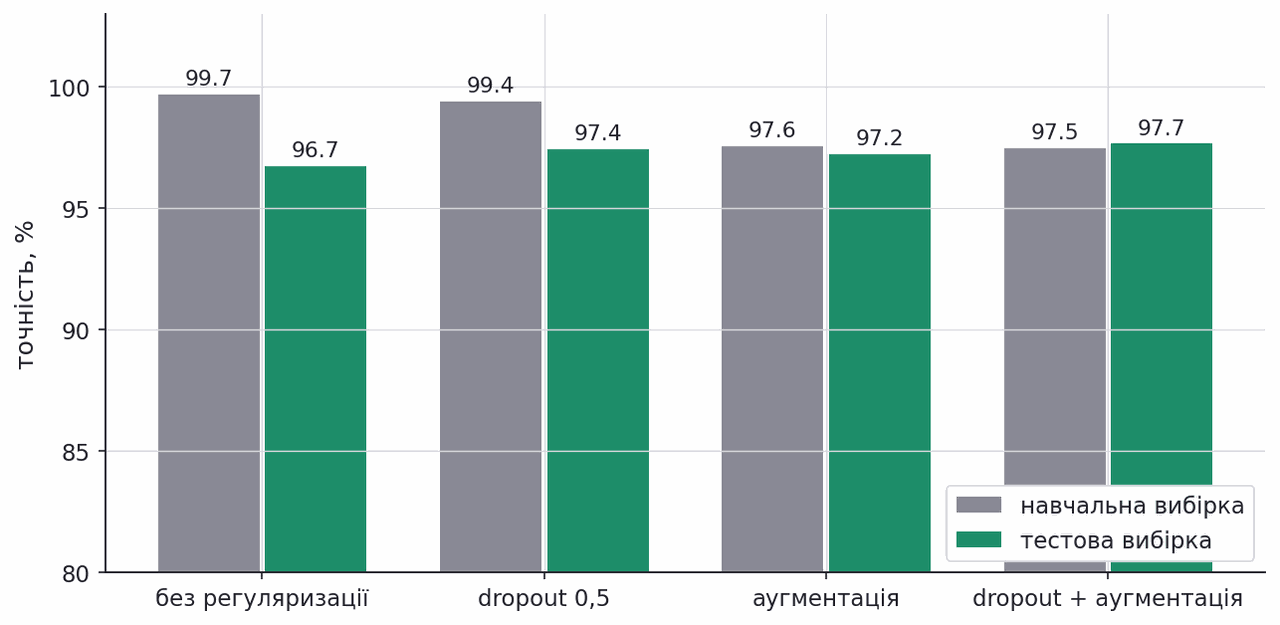
Виміряймо. Щоб перенавчання було видно, навчальну вибірку зменшено до 3000 зображень; тест той самий, 10 000. Усі чотири мережі однакові й навчалися 25 епох.
Без регуляризації мережа доходить до 99,7 % на навчанні й 96,74 % на тесті — розрив майже три відсоткові пункти, класичне перенавчання. Dropout 0,5 піднімає тест до 97,42 %. Аугментація зсувами й поворотами тримає навчання на 97,57 %, а тест — на 97,24 %: розрив майже зникає, бо мережа щоразу бачить нову версію зображення. Разом обидва прийоми дають 97,66 % — і це єдина конфігурація, де тест вищий за навчання.
Аугментацію показано через transforms.RandomAffine(degrees=12, translate=(0.1, 0.1)) — стандартний інструмент torchvision.
Внесок кожного прийому на великих даних
Наш дослід — на трьох тисячах зображень. Zhang та ін. поставили те саме питання на CIFAR-10, і їхня таблиця дає порядок величин, з яким варто звіряти очікування.
| Модель | Аугментація | Weight decay | Точність на навчанні | Точність на тесті |
|---|---|---|---|---|
| Inception | так | так | 100,0 | 89,05 |
| Inception | ні | так | 100,0 | 86,03 |
| Inception | ні | ні | 100,0 | 85,75 |
| Inception без BatchNorm | ні | так | 100,0 | 83,00 |
| MLP 3 × 512 | ні | так | 100,0 | 53,35 |
| MLP 3 × 512 | ні | ні | 100,0 | 52,39 |
Порівнюючи рядки по одному, дістаємо внесок кожного прийому. Аугментація: 89,05 проти 86,03, тобто три пункти. Пакетна нормалізація: 86,03 проти 83,00 — знову три пункти. Weight decay: 86,03 проти 85,75, тобто три десятих пункта.
І окремо два спостереження. Архітектура важить більше за всі прийоми разом: згорткова Inception і повнозв'язна MLP 3 × 512 мають 1,65 і 1,74 мільйона параметрів, а за однакових умов відрізняються на 33 пункти. А точність на навчанні всюди дорівнює 100 %, тобто за навчальною вибіркою перенавчання не видно взагалі.
Джерело: Zhang C. et al., Understanding Deep Learning Requires Rethinking Generalization, ICLR 2017
Обмеження згорткових мереж
Згортка — сильне припущення про структуру даних, і там, де воно не виконується, метод програє.
Припущення про локальність. Згортка зв'язує лише сусідні елементи. Якщо важлива залежність між далекими частинами входу, її доводиться збирати через багато шарів. Саме тут згорткові мережі поступаються механізму уваги, до якого перейдемо в наступній лекції.
Порядок пікселів має значення. Переставте пікселі зображення випадково, але однаково для всіх зразків: людина нічого не впізнає, повнозв'язна мережа навчиться майже як раніше, згорткова — зламається. Її перевага цілком тримається на тому, що сусідство в даних справжнє.
Інваріантність лише часткова. До невеликих зсувів мережа стійка, до великих зсувів, поворотів і зміни масштабу — ні, у чому ми переконалися на власному досліді. Це вирішують аугментацією, а не архітектурою.
Потрібно багато даних. Мільйони параметрів сучасних архітектур не навчаються на тисячі прикладів. Стандартний вихід — узяти мережу, навчену на великому наборі, і донавчити її під свою задачу.
Підсумок лекції
Повнозв'язна мережа неправильно влаштована для зображень. Вона потребує мільйонів ваг, розгортає зображення у вектор і руйнує сусідство пікселів.
Згортка виправляє обидві біди одним прийомом. Маленький фільтр, який ковзає по зображенню: локальна зв'язність дає економію ваг, спільні ваги — еквіваріантність до зсуву. Кількість параметрів шару не залежить від розміру зображення.
Мережа складається з двох частин: стек «згортка → ReLU → пулінг» будує ознаки, повнозв'язні шари наприкінці класифікують. Перший шар вивчає детектори країв, глибші — дедалі абстрактніші комбінації.
Наш дослід на MNIST: 11 274 ваги проти 50 890 і 98,65 % проти 97,00 % на тесті; при зсуві на чотири пікселі різниця зростає до 80,12 % проти 34,42 %.
Глибина потребує окремих інструментів. Стек із чотирнадцяти шарів навчається гірше за стек із чотирьох; залишкові зв'язки й пакетна нормалізація повертають йому працездатність.
Узагальнення купують аугментацією й dropout, причому аугментація дає більше — за умови, що перетворення справді зберігає мітку.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекція 08b
- UBC CPSC 340 — лекції 31–33
- Stanford CS231n
Підручник
- Goodfellow та ін. Deep Learning, розділ 9
Статті
- Krizhevsky та ін. AlexNet, NIPS 2012 — сторінка статті
- He та ін. ResNet, CVPR 2016
- Srivastava та ін. Dropout, JMLR 2014
- Ioffe, Szegedy. Batch Normalization, ICML 2015
- Zhang та ін. Rethinking Generalization, ICLR 2017
Інструменти