Тема
Лекція 07 · Опорно-векторні машини та ядрові методи
У лекції 05 ми навчилися проводити межу між класами й оцінювати ймовірність. Сьогодні поставимо жорсткіше питання: серед усіх допустимих меж знайти найнадійнішу — і навчимося робити межу нелінійною, не додаючи жодної нової ознаки вручну.
Зміст лекції
Лекція йде від геометрії однієї прямої до методу, який працює в нескінченновимірному просторі ознак.
- Максимальний відступ. Гіперплощина, ширина коридору між класами, опорні вектори.
- М'який відступ. Слекові змінні, hinge-втрата, параметр C і компроміс «ширина проти помилок».
- Двоїста задача. Змінні
, розрідженість розв'язку і головне відкриття: дані входять у задачу лише через попарні скалярні добутки. - Ядровий трюк. Простір ознак, ядро як міра схожості, умова Мерсера, каталог ядер.
- Налаштування ядрової SVM. RBF-ядро, спільний підбір C і gamma, наскрізний приклад на медичних даних.
- Ядрова регресія. Теорема про представлення, kernel ridge regression і SVR.
Кожен блок відкриває наступний: двоїста задача потрібна не сама по собі, а тому, що саме з неї виростає ядровий трюк.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чому серед усіх роздільних прямих SVM обирає ту, що максимізує відстань до найближчих точок;
- зв'язати ширину коридору з нормою вектора ваг і записати задачу hard-SVM;
- пояснити роль слекових змінних і показати, що soft-SVM — це мінімізація hinge-втрати з ridge-регуляризацією;
- передбачити, як зміняться відступ, кількість опорних векторів і якість моделі при зміні C;
- пояснити, чому двоїста задача залежить від даних лише через матрицю попарних скалярних добутків;
- обчислити значення ядра двома способами — напряму й через явне відображення ознак — і переконатися, що вони збігаються;
- обрати ядро під форму даних та підібрати C і gamma перехресною перевіркою;
- назвати ситуації, у яких ядрова SVM непридатна, і пояснити чому.
Два сурогати однієї втрати: місток із лекції 05
У лекції 05 ми вже бачили ключову картину: справжня мета класифікації — мінімізувати нуль-одиничну втрату, тобто частку помилок, але вона розривна й неопукла. Тому мінімізують опуклу верхню оцінку — сурогатну втрату (surrogate loss), і вибір цієї оцінки визначає метод.
Перехресна ентропія веде до логістичної регресії: модель віддає ймовірність і карається за кожну недостатньо впевнену відповідь, навіть правильну. Hinge-втрата веде до методу опорних векторів: щойно точка класифікована правильно й із запасом, штраф стає рівно нулем, і модель перестає нею цікавитися.
Саме з цієї байдужості до «легких» точок виростає весь сьогоднішній метод: у розв'язку залишаються тільки ті спостереження, що лежать біля межі.
| Перехресна ентропія | Hinge-втрата | |
|---|---|---|
| Формула | ||
| Штраф за впевнено правильну точку | малий, але ніколи не нуль | рівно нуль |
| Що дає модель | ймовірність класу | тільки бік межі |
| Які точки впливають на розв'язок | усі | лише ті, що ближче за відступ |
| Метод, який із неї виростає | логістична регресія | опорно-векторна машина |
Графік обох функцій поруч із нуль-одиничною втратою — у розділі «Функції втрат, придатні для класифікації» лекції 05.
Дані лекції: розміри пелюсток трьох сортів ірисів
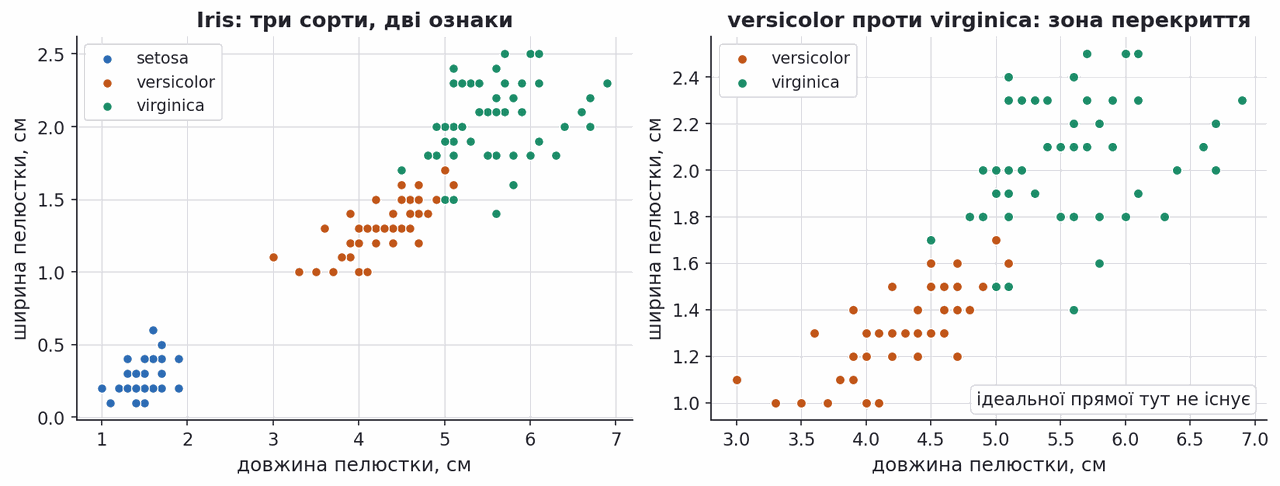
Геометрію відступу найкраще видно на двох ознаках, тому основний приклад лекції — класичний набір Iris: 150 квіток, по 50 кожного з трьох сортів, для кожної виміряно довжину й ширину чашолистка та пелюстки в сантиметрах. Беремо дві ознаки — довжину й ширину пелюстки — і передбачаємо сорт.
Ліворуч видно, що сорт setosa відділяється від решти з великим запасом, а versicolor і virginica частково перекриваються. Це дві різні задачі: для першої існує ідеальна пряма, для другої — ні. Спершу розв'яжемо легку, потім навчимося жити з важкою.
Джерело даних: UCI Machine Learning Repository · Iris
Роздільних прямих багато, надійна серед них одна
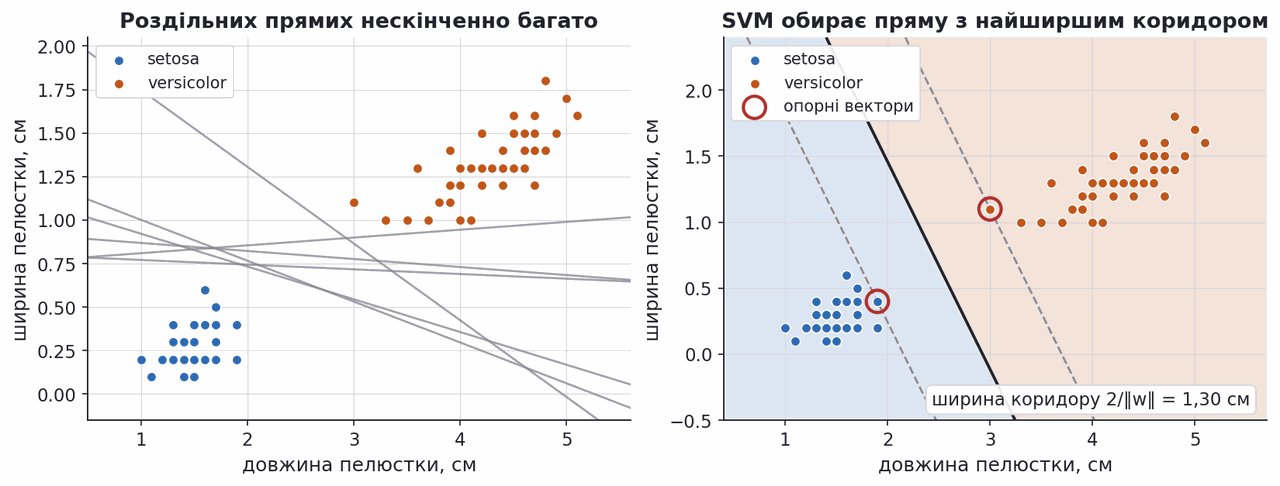
Візьмімо легку задачу: setosa проти versicolor. Між класами лежить порожня смуга, і будь-яка пряма, що проходить крізь неї, розділяє тренувальні дані без жодної помилки. Ліворуч намальовано шість таких прямих — усі мають однакову нульову похибку на навчанні.
Проте вони не рівноцінні. Пряма, що майже торкається квітки, розсипається від найменшого шуму у вимірюванні: трохи інша пелюстка — і точка опиняється не з того боку. Пряма, що йде серединою смуги, витримує таке зміщення.
Метод опорних векторів (support vector machine, SVM) формалізує цю інтуїцію: серед усіх роздільних гіперплощин обираємо ту, навколо якої залишається найширший вільний коридор. На цих даних його ширина — 1,30 см, а тримається він лише на двох квітках.
Опорно-векторні мережі: стаття 1995 року
Метод у сучасному вигляді описали Корінна Кортес і Володимир Вапнік. Їхня стаття вводить одразу дві речі, які ми розберемо сьогодні: нелінійне відображення у високовимірний простір ознак і розширення методу на дані, які не розділяються без помилок.
"The support-vector network is a new learning machine for two-group classification problems. The machine conceptually implements the following idea: input vectors are non-linearly mapped to a very high-dimension feature space. In this feature space a linear decision surface is constructed." — Cortes C., Vapnik V., 1995
Українською: класифікатор нелінійно переносить входи у простір дуже високої розмірності й будує там лінійну розділяльну поверхню. Уся складність ховається у відображенні, сам класифікатор залишається лінійним — і саме тому задача лишається опуклою.
Джерело: Cortes C., Vapnik V. Support-vector networks. Machine Learning, 20, 273–297 (1995)
Гіперплощина і відстань до неї
Мітки в SVM зручно кодувати як
Розділяльна поверхня — гіперплощина (hyperplane): у двох вимірах пряма, у трьох площина, у
| Позначення | Значення |
|---|---|
| нормаль до гіперплощини, задає її нахил | |
| зсув: наскільки площина відсунута від початку координат | |
| мітка | |
| довжина вектора ваг, нормує відстань |
Формула відстані — це теорема Піфагора: беремо проєкцію точки на напрям
Відступ — це відстань до найближчої точки
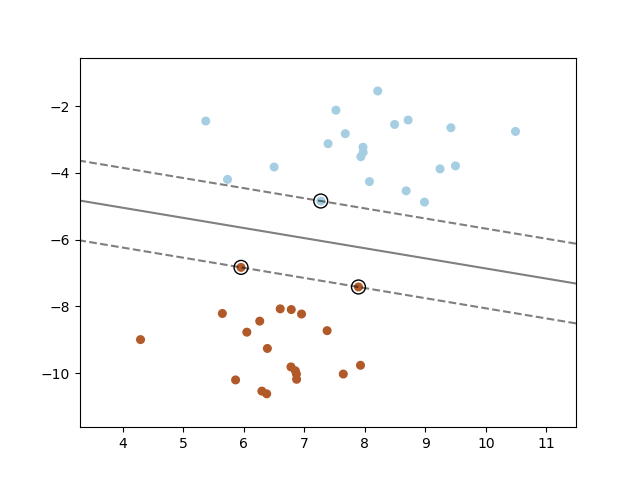
Відступ (margin) гіперплощини — найменша відстань від неї до тренувальної точки. Не середня і не типова, а саме найменша: одна квітка, що підійшла впритул, визначає весь відступ, хай би як далеко лежала решта.
На рисунку суцільна лінія — межа рішення, дві штрихові — межі коридору, а обведені точки лежать точно на них. Пересунути суцільну лінію хоч трохи вгору або вниз означає звузити коридор.
Правило hard-SVM обирає таку гіперплощину, для якої це мінімальне значення найбільше з можливих. Звідси й назва — класифікатор із максимальним відступом.
Джерело: scikit-learn · SVM: Maximum margin separating hyperplane
Максимізація відступу — це мінімізація норми ваг
Максимізувати мінімум відстаней незручно. Але задача має приховану симетрію: якщо помножити
За такої нормалізації відступ дорівнює
Числовий приклад із попереднього рисунка: для setosa проти versicolor оптимальний
Розв'язок тримається лише на опорних векторах
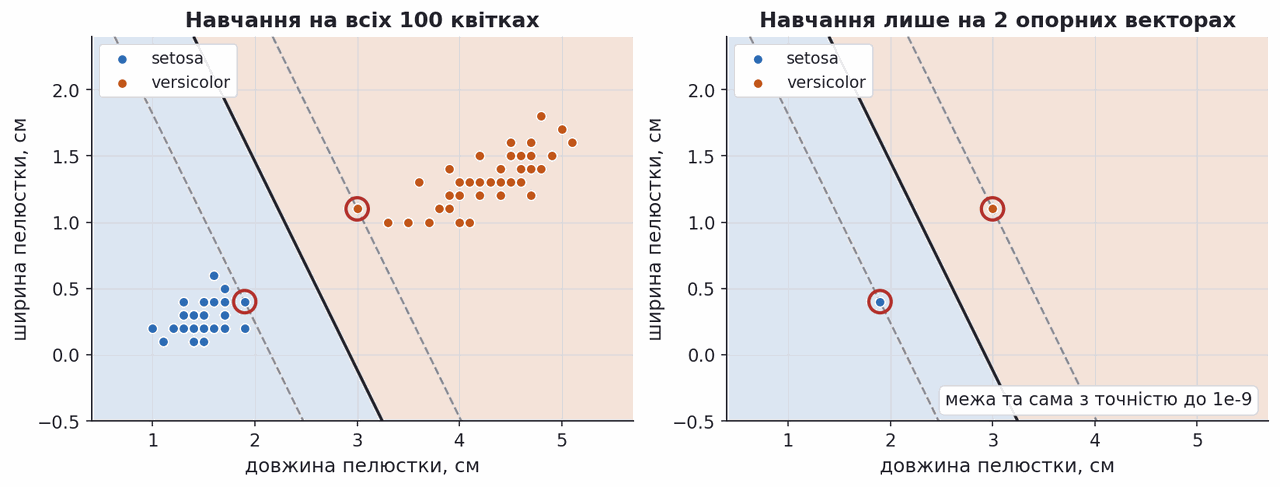
Опорні вектори (support vectors) — це точки, що лежать на межах коридору або порушують їх. Решта спостережень у розв'язок не входять зовсім, і це легко перевірити експериментом.
Ліворуч SVM навчено на всіх 100 квітках, праворуч — лише на двох опорних векторах, які знайшла перша модель. Межа збіглася: максимальна різниця коефіцієнтів становить
Практичний наслідок подвійний. З одного боку, модель компактна: щоб робити прогнози, достатньо зберігати опорні вектори. З іншого — вона вразлива: помилка у вимірюванні однієї прикордонної точки зсуває всю межу, тоді як груба помилка в далекій точці не робить нічого.
Реальні класи перекриваються: м'який відступ
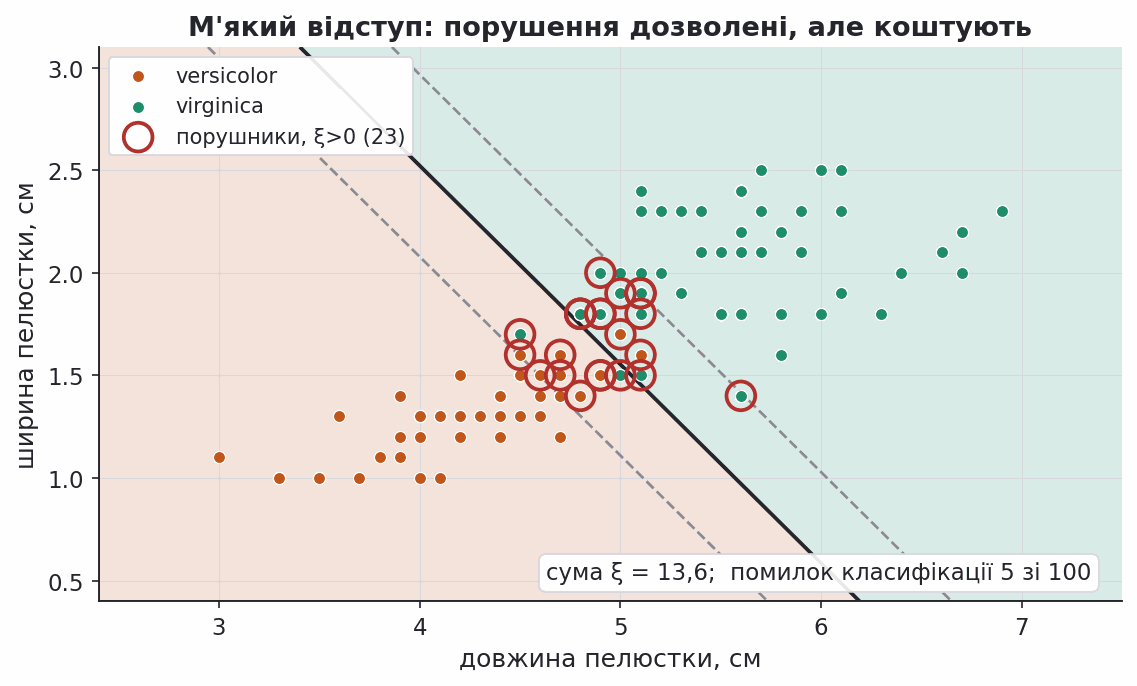
Друга пара сортів, versicolor проти virginica, ідеальної прямої не має: у зоні перекриття лежать квітки обох класів. Жорстка вимога
Soft-SVM послаблює вимогу: кожній точці дозволено порушити межу коридору, але за плату. На рисунку обведено 23 квітки, які залізли в коридор або перейшли на чужий бік; п'ять із них класифіковано неправильно. Решта 77 лежать за коридором і на межу не впливають.
Зверніть увагу: порушників 23, а помилок лише 5. Більшість «порушників» класифіковано правильно — вони просто підійшли до межі ближче, ніж на одиницю відступу. Це і є ціна ширшого коридору.
Слекові змінні вимірюють глибину порушення
Формально до кожного обмеження додається власна слекова змінна (slack variable)
Значення
Для рисунка вище сума всіх слеків становить 13,6 при ста спостереженнях. Параметр
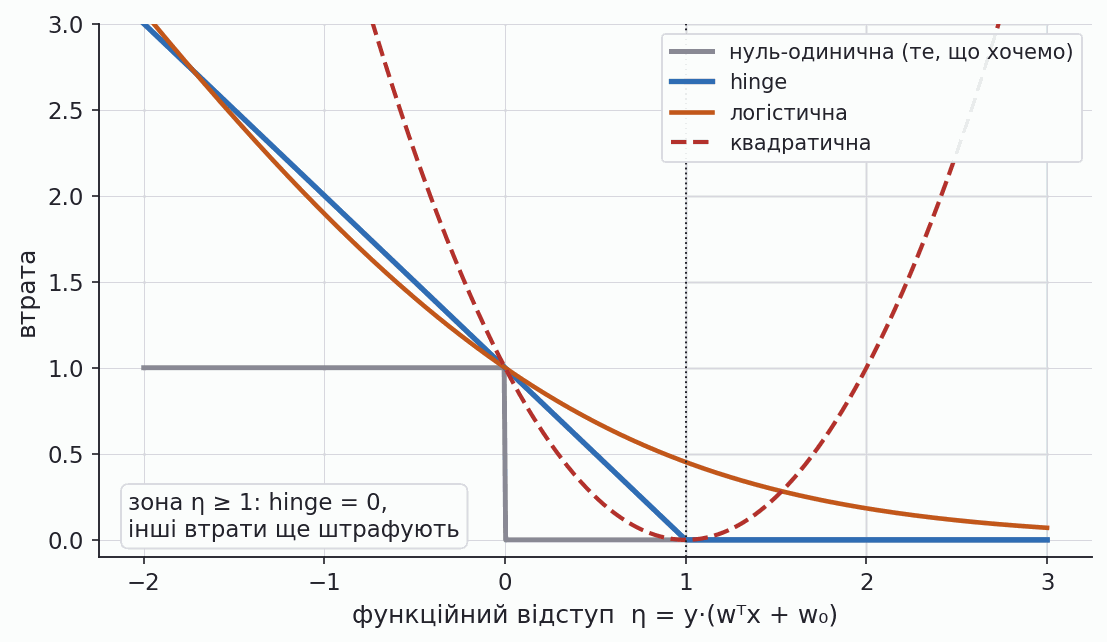
Hinge-втрата обнуляється, щойно точка впевнено правильна
Слекові змінні можна виключити з задачі. При фіксованих вагах оптимальне значення
На графіку добре видно, чим hinge відрізняється від сусідів. Квадратична втрата має мінімум у точці
Soft-SVM — це hinge-втрата плюс ridge-регуляризація
Після підстановки слеків задача набуває форми, знайомої з лекції 03: середня втрата плюс штраф за довжину вектора ваг.
Тобто SVM — це не окремий алгоритм із власною філософією, а звичайна мінімізація емпіричного ризику, у якій обрано конкретну функцію втрат. Регуляризатор тут виконує подвійну роботу: він і стримує ваги від розбігання, і, оскільки
Одна практична незручність: hinge має злам у точці
Параметр C — та сама задача в іншій параметризації
Бібліотеки записують soft-SVM інакше: штраф ставлять не перед нормою ваг, а перед сумою порушень.
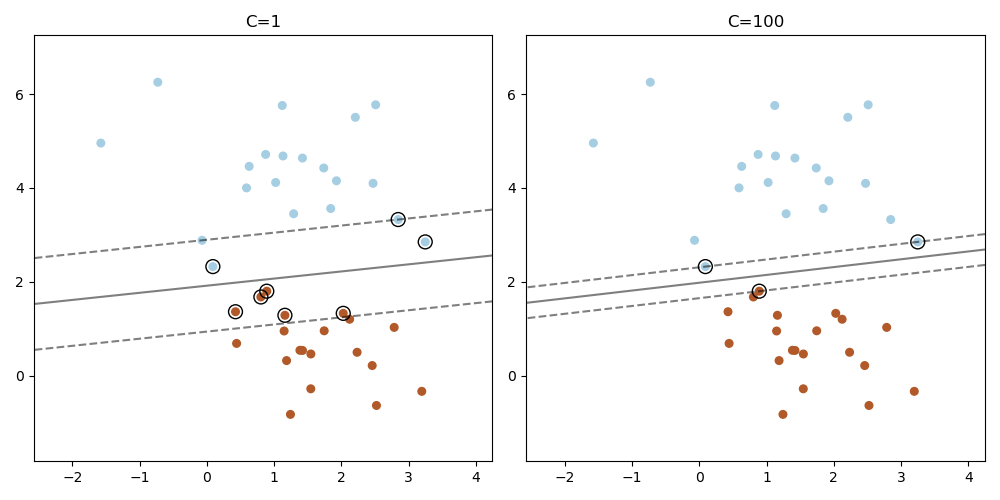
Це та сама задача: домноживши форму з попереднього розділу на C — слабка регуляризація, вузький коридор і мало порушень; мале C — сильна регуляризація, широкий коридор і багато порушників.
На рисунку — той самий набір даних при C=1 і C=100. Праворуч коридор помітно вужчий, а обведених опорних векторів менше: модель майже не дозволяє порушень і притискає межу до найближчих точок.
Джерело: scikit-learn · Plot the support vectors in LinearSVC
Вплив C на реальних даних: діагностика пухлин
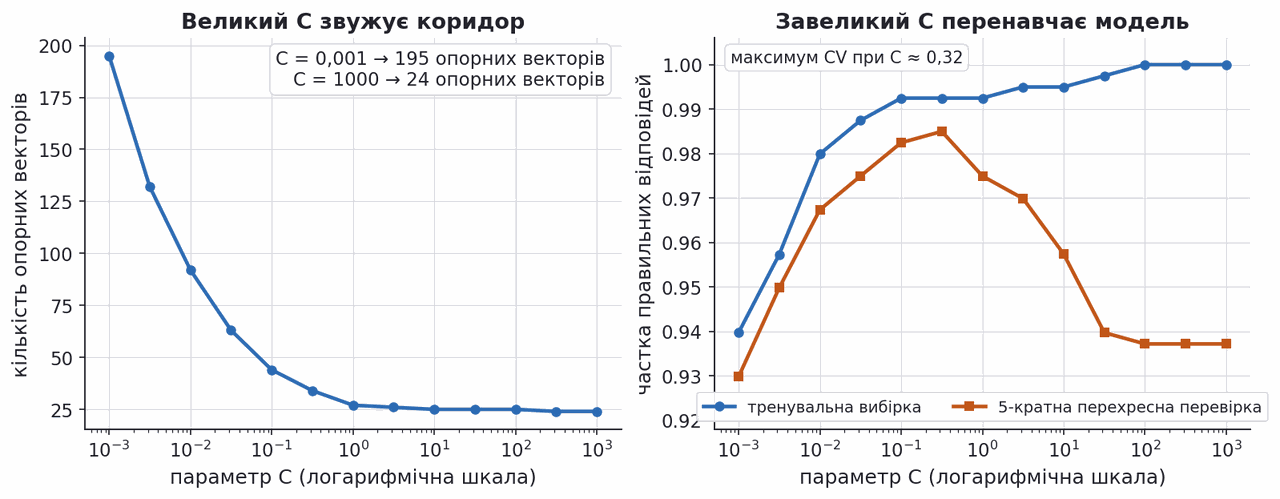
Перевіримо це на другому наборі лекції. Breast Cancer Wisconsin (Diagnostic): 569 пункційних біопсій, 30 числових ознак, обчислених із зображення (радіус, текстура, периметр, площа ядер клітин та інші), передбачаємо діагноз — доброякісна пухлина чи злоякісна. Навчальна частина — 398 спостережень, ознаки стандартизовано, ядро лінійне.
Ліва панель показує обіцяну залежність без винятків: при C=0,001 у розв'язку 195 опорних векторів із 398, при C=1000 — лише 24. Права панель додає те, чого не видно з геометрії: точність на навчальній вибірці зростає до одиниці, а на перехресній перевірці спершу піднімається до 0,985 при C≈0,32, а потім падає до 0,937. Це класичне перенавчання — надто вузький коридор запам'ятовує шум.
Джерело даних: UCI · Breast Cancer Wisconsin (Diagnostic)
Дисбаланс класів зсуває межу до меншого класу
Ще одна пастка, помітна саме в геометрії відступу. Якщо один клас представлено сотнями точок, а другий — десятками, сумарний штраф
На рисунку близько тисячі точок великого класу і сотня — рідкісного. Чорна лінія — звичайна SVM: вона проходить крізь рідкісний клас і віддає більшу його частину сусідові. Червона — та сама модель із class_weight="balanced", яка множить C для кожного класу на величину, обернену до його частоти. Її межа зсунута вглиб великого класу, і рідкісні точки нарешті опиняються на своєму боці.
Це та сама проблема, що й у лекції 05 при виборі порога, тільки розв'язується вона не після навчання, а всередині цільової функції.
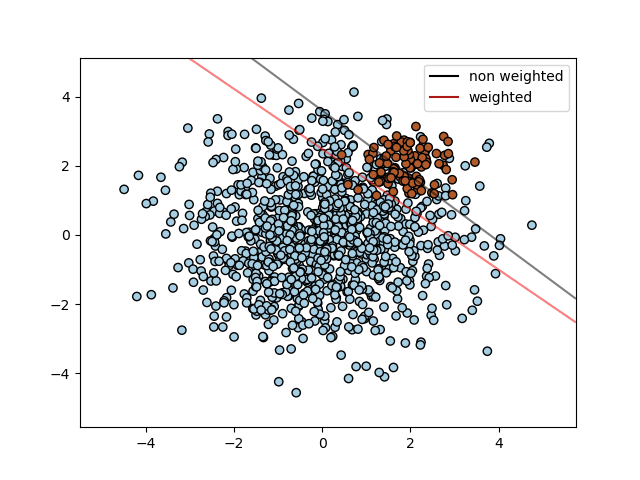
Джерело: scikit-learn · SVM: Separating hyperplane for unbalanced classes
Код: лінійна SVM з нуля на субградієнтному спуску
Двадцять п'ять рядків numpy, щоб було видно: всередині немає нічого, крім формули з попередніх розділів.
Вивід код запущено, вивід не редагувався
text
крок    0   цільова функція 1.0000
крок  500   цільова функція 0.0193
крок 1000   цільова функція 0.0132
крок 1500   цільова функція 0.0117
крок 2000   цільова функція 0.0117
На що дивитися: цільова функція падає з 1,0 до 0,0117 і після 1500 кроків уже не змінюється — спуск зійшовся.
Знайдений напрям SVC(kernel="linear", C=1/(lam*len(y))) і порівняти напрями, косинус між ними дорівнює 0,991 — тобто наші двадцять п'ять рядків знайшли практично ту саму гіперплощину, що й бібліотека.
Двоїста задача: ті самі ваги через змінні альфа
Первинну задачу можна переписати відносно нових змінних
Тут
Прочитайте останню формулу уважно: дані входять у задачу тільки через
Значення альфа розказує, де лежить точка
Оптимальне
| Положення точки | ||
|---|---|---|
| правильний бік, за коридором | ||
| точно на межі коридору | будь-яке з | |
| усередині коридору або на чужому боці |
Опорні вектори — це рівно точки з
Двоїста форма зручна ще й обчислювально: вона гладка й угнута, тому її розв'язують квадратичними солверами або координатним підйомом, без проблем зі зламом hinge. А розрідженість
Ознаки, яких немає в даних, можна дорахувати
Поки що межа завжди була прямою. Але прямою вона є лише в тому просторі, де ми працюємо, — а простір можна змінити.
Ліворуч — одновимірні дані, розмічені за правилом «близько до нуля — один клас, далеко — інший». Жоден поріг на прямій їх не розділить: обидва боки нуля змішані. Праворуч до кожної точки дописано другу координату
Функцію
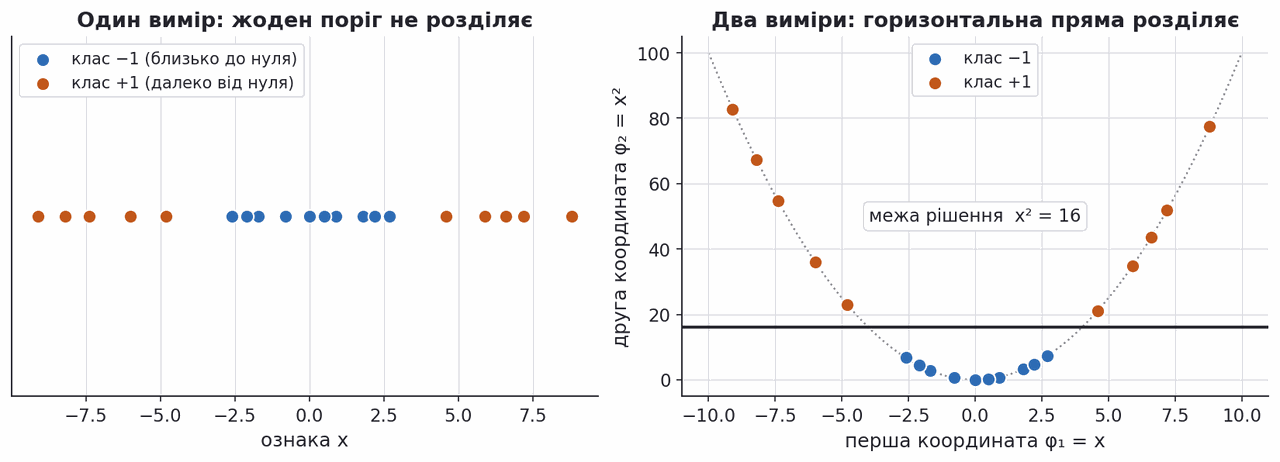
Той самий прийом у двох вимірах: підйом угору
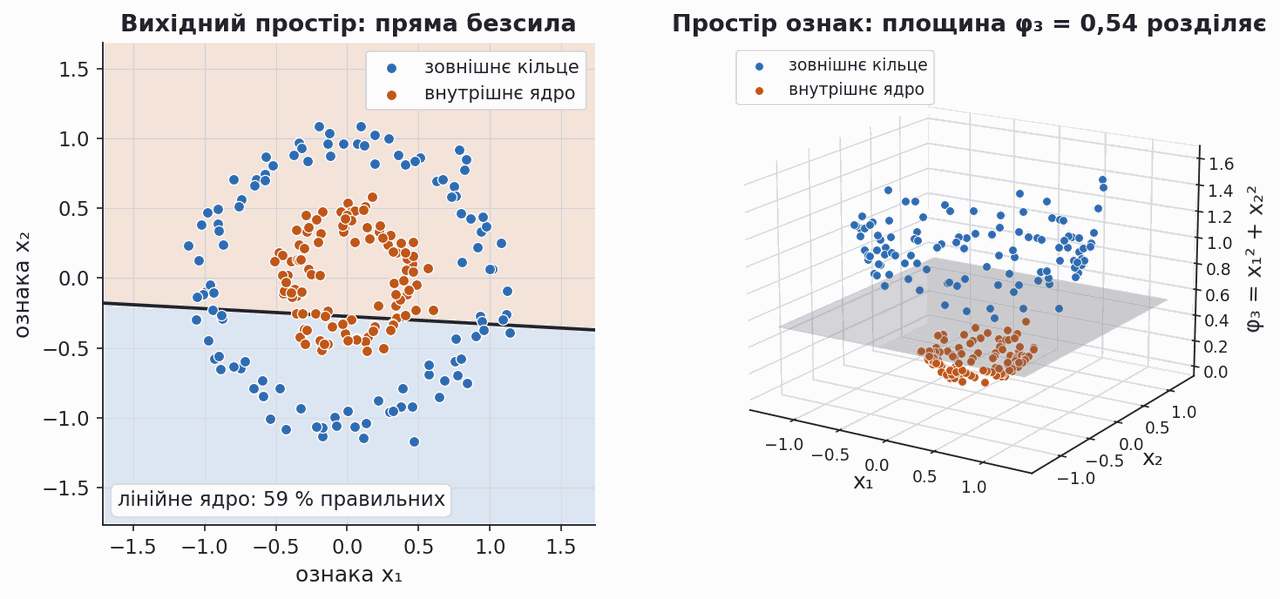
Той самий трюк працює й на реальніших формах. Ліворуч — 220 точок, згенерованих як два концентричні кільця (make_circles). Класи розділені ідеально, але не прямою: лінійна SVM дає 59 % правильних відповідей, тобто ледве краще за монетку.
Праворуч до кожної точки дописано третю координату
Проблема лише одна, і вона обчислювальна: у справжніх задачах потрібне відображення набагато більшої розмірності, і будувати його явно надто дорого.
Ядровий трюк: скалярний добуток без побудови ознак
Тут і спрацьовує головна ідея. Двоїста задача потребує не самих векторів ознак, а лише їхніх попарних скалярних добутків. Отже, якщо вміти рахувати добуток
Ядро (kernel) — це функція двох аргументів, що повертає таке саме число, як скалярний добуток у просторі ознак:
Вивід код запущено, вивід не редагувався
text
ядро напряму      : 25
phi(x), phi(x')   : [1.    2.828 4.   ] [9.    4.243 1.   ]
скалярний добуток : 25.0
На що дивитися: обидва шляхи дають 25: ядро обчислює той самий скалярний добуток, не будуючи тривимірних векторів.
Ліворуч — один скалярний добуток і піднесення до квадрата; праворуч — побудова двох тривимірних векторів. Для степеня
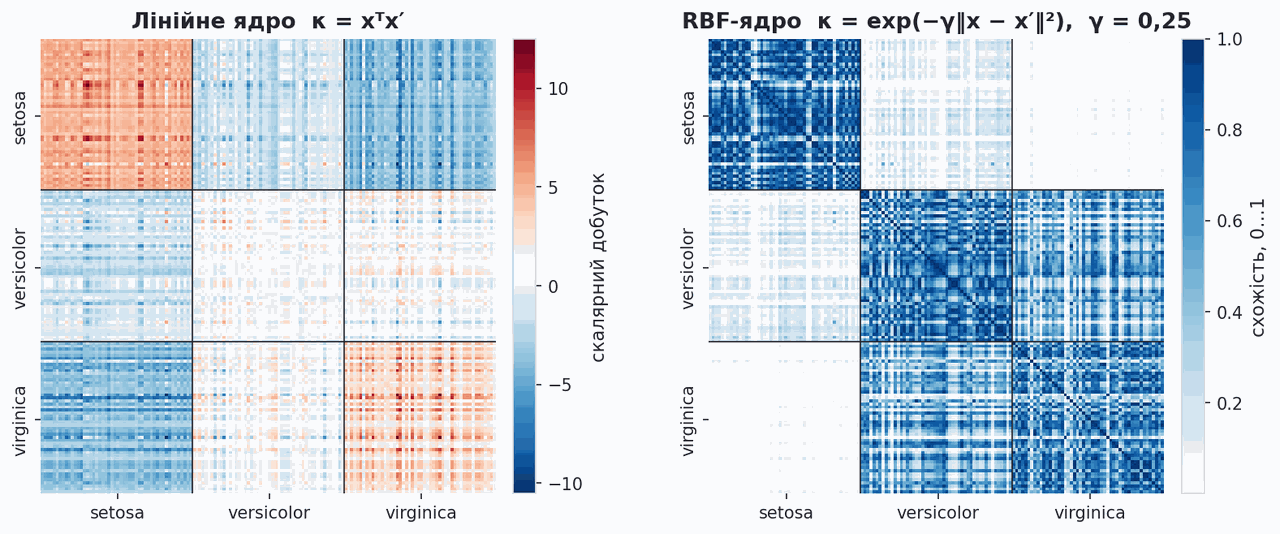
Матриця ядра — це таблиця схожості всіх з усіма
Ядро зручно уявляти як міру схожості. Матриця
На рисунку обидві матриці побудовані на всіх 150 квітках Iris за чотирма стандартизованими ознаками; спостереження впорядковано за сортом, тому блоки на діагоналі — це «свої зі своїми». Ліворуч лінійне ядро: значення можуть бути від'ємними, і зчитати структуру важче. Праворуч RBF-ядро: значення лежать у
Саме така блокова структура й дозволяє класифікатору працювати, ніколи не бачачи самих координат: достатньо знати, хто на кого схожий.
Не будь-яка функція схожості є ядром
Ядром може бути не всяка симетрична функція. Критерій дає умова Мерсера (Mercer's condition): функція
Контрприклад корисно тримати в голові. Візьмімо «схожість»
Нові ядра будують із наявних: якщо
Каталог ядер і простори, які вони задають
Три ядра покривають переважну більшість практичних задач.
| Ядро | Формула | Простір ознак |
|---|---|---|
| лінійне | вихідний, розмірність | |
| поліноміальне степеня | усі одночлени до степеня | |
| RBF (гаусове) | нескінченновимірний |
Поліноміальне ядро при
Ядра існують і для нечислових даних: string kernel вимірює схожість рядків за спільними підпослідовностями, і SVM працює з текстом, не перетворюючи його на вектор.
RBF-ядро: параметр gamma задає радіус впливу
RBF — ядро за замовчуванням у більшості бібліотек, тому його параметр варто розуміти точно. У scikit-learn замість gamma, і зв'язок такий:
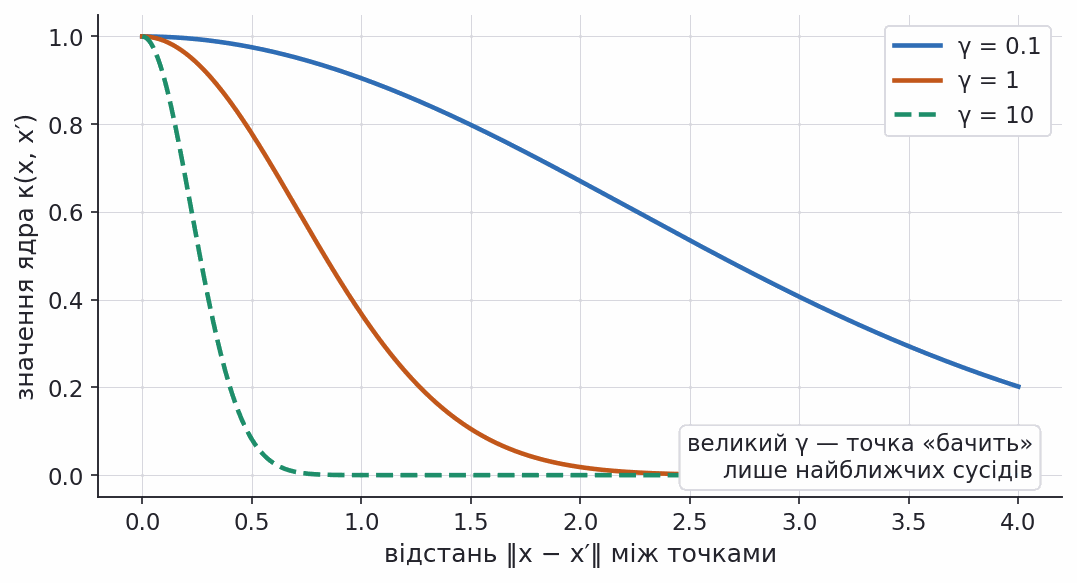
Графік показує, як швидко спадає схожість із відстанню. При
Звідси правило: завелике gamma — це перенавчання, замале — недонавчання. Значення gamma="scale" у scikit-learn обчислюється як
Що робить gamma — і що з цього виходить
Ліворуч саме ядро: як швидко спадає схожість двох точок із відстанню. Посередині — карта якості по всій сітці C × gamma, клітинки клікабельні. Праворуч — межа рішень на тих самих двох півмісяцях, що в коді лекції.
0,007схожість на відстані 1,0
90опорних векторів із 195
0,938точність на навчальних
0,905точність на відкладених
Поставте C = 1 і γ = 0,1: схожість на відстані 1,0 дорівнює 0,90 — кожна точка впливає далеко навколо себе, межа виходить майже прямою, і модель недонавчається: 0,877 на навчальних і 0,848 на відкладених. Тепер γ = 50: схожість падає практично до нуля, межа розпадається на острівці навколо окремих спостережень, навчальна точність злітає до 0,990, а відкладена лишається 0,886 — перенавчання видно просто в цих двох числах. Далі зафіксуйте γ = 0,5 і посуньте C: він керує не радіусом, а ціною порушення відступу, тому змінює межу інакше — і кількість опорних векторів разом із нею, від 116 при C = 0,1 до 38 при C = 100. Саме тому ці два параметри підбирають спільно, сіткою, а не по черзі.
Карта посередині показує це відразу для всіх двадцяти чотирьох пар. Світлі клітинки не збираються в одну точку, а лягають діагоналлю: C = 100 з gamma = 0,1 дає 0,933, C = 10 з gamma = 0,5 — найкращі 0,943, C = 1 з gamma = 0,5 — знову 0,933. Уздовж цієї смуги добуток C·gamma тримається приблизно сталим: більший радіус впливу компенсується суворішим штрафом. Клітинка C = 1, gamma = 0,5 — це рівно той рядок, який друкує код розділу про порівняння ядер: gamma="scale" на стандартизованих даних дорівнює 1/(2·1), тобто 0,5, і віджет дає ті самі 0,933 при 66 опорних векторах із 195. Зелений кружок стоїть на 0,943, але дві сусідні клітинки дають 0,933, а цілий стовпчик при gamma = 1 — по 0,924, і різниця між ними менша за розкид між фолдами. Практичний висновок той самий, що в тексті розділу: сітку беруть логарифмічну, а всередині світлої смуги за третій знак не воюють. Клацніть по кутах карти: лівий верхній (мале gamma, велике C) дає майже пряму межу з 53 опорними векторами, правий нижній (велике gamma, мале C) — 0,495, тобто чисте вгадування, і всі 195 навчальних точок стають опорними: модель запам'ятала кожну й не навчилася нічого.
Ядро задає форму межі, алгоритм не змінюється
У двоїстій задачі досить замінити
Сума йде тільки по опорних векторах, бо в решти
Рисунок показує чотири ядра на одних і тих самих даних. Лінійне дає пряму, поліноміальне — криву відповідного порядку, RBF — гладку межу довільної форми, сигмоїдне — химерну ламану, яка ілюструє, що не всяке ядро підходить будь-яким даним.
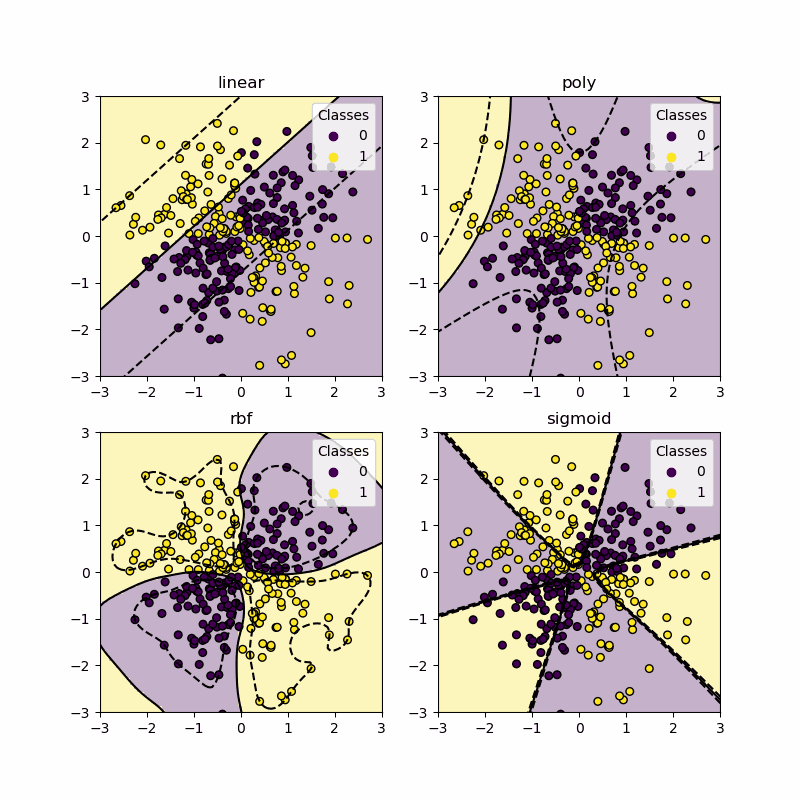
Джерело: scikit-learn · Plot classification boundaries with different SVM Kernels
Код: лінійне ядро проти RBF на двох півмісяцях
Порівняємо ядра там, де правильна відповідь відома заздалегідь: make_moons генерує два переплетені півмісяці, які прямою не розділити принципово.
Вивід код запущено, вивід не редагувався
text
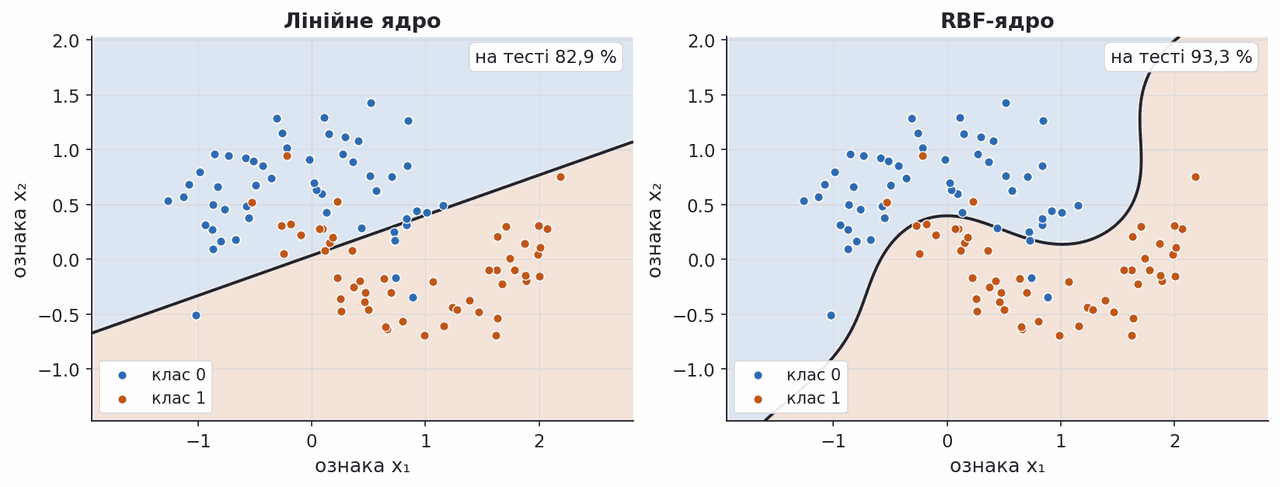
linear: точність на тесті 0.829, опорних векторів  71 із 195
   rbf: точність на тесті 0.933, опорних векторів  66 із 195
На що дивитися: RBF-ядро піднімає точність з 0,829 до 0,933, і опорних векторів йому знадобилося навіть менше — 66 проти 71.
Зміна одного рядка дала плюс десять відсоткових пунктів.
Джерело: scikit-learn · SVC
Результат на півмісяцях: пряма проти гладкої межі
Тепер подивимося на те саме очима. Ліворуч лінійне ядро чесно робить усе, що може: одна пряма, 82,9 % правильних відповідей і систематична помилка на «хвостах» обох півмісяців. Праворуч RBF-ядро огинає форму даних і дає 93,3 % на тих самих 105 тестових точках.
Помилки, що залишилися, зосереджені у вузькій зоні перетину півмісяців, де шум noise=0.22 фізично змішав класи. Це важливий орієнтир: ядро прибирає обмеження методу, але не прибирає шум у даних. Модель, яка розділила б і цю зону, просто запам'ятала б окремі точки.
Чотири варіанти SVM на одному наборі ірисів
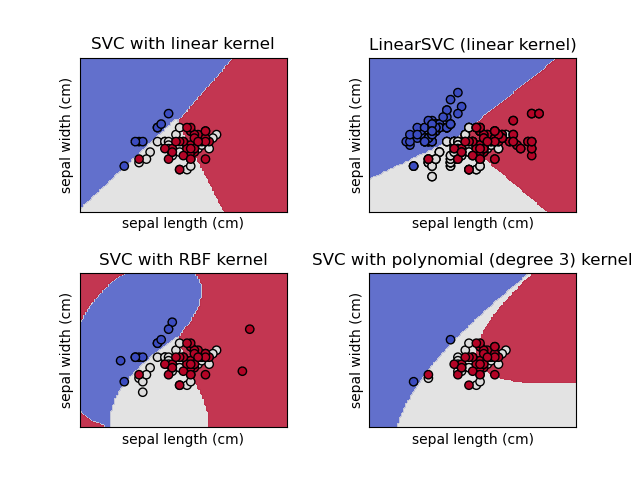
Повернімося до Iris, тепер уже з трьома класами (SVM робить це схемою «один проти одного», навчаючи класифікатор на кожну пару класів). Чотири панелі показують той самий набір і той самий алгоритм із різними налаштуваннями.
SVC(kernel="linear") і LinearSVC дають схожі, але не тотожні межі: перший розв'язує двоїсту задачу зі стандартною hinge-втратою, другий — первинну з квадратичною hinge і регуляризує ще й зсув. RBF-ядро дає плавно вигнуті межі, поліноміальне третього степеня — жорсткіші, майже кутові.
Практичний висновок: «SVM» — це не одна модель, а сімейство, і різниця між його членами буває більшою, ніж різниця між SVM і логістичною регресією.
Джерело: scikit-learn · Plot different SVM classifiers in the iris dataset
C і gamma працюють у парі, а не поодинці
Два параметри ядрової SVM не можна підбирати незалежно, бо вони частково компенсують один одного: жорсткіше ядро можна пригасити сильнішою регуляризацією.
Сітка показує це наочно. У верхньому ряду C замале — регуляризація давить модель незалежно від gamma, і межа майже плоска. У правому стовпці gamma завелике — модель обгортає кожну точку окремим острівцем, і це вже перенавчання, яке жодне C не рятує.
Робочі моделі зосереджені в середині діапазону, і жоден із двох параметрів не має «правильного» значення сам по собі: важлива тільки їхня комбінація. Саме тому підбирають їх разом, сіткою, а не по черзі.
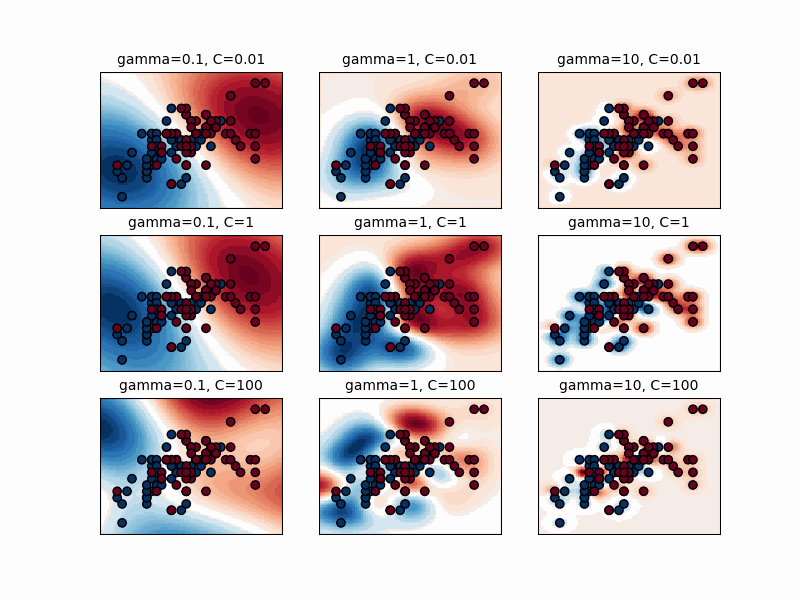
Джерело: scikit-learn · RBF SVM parameters
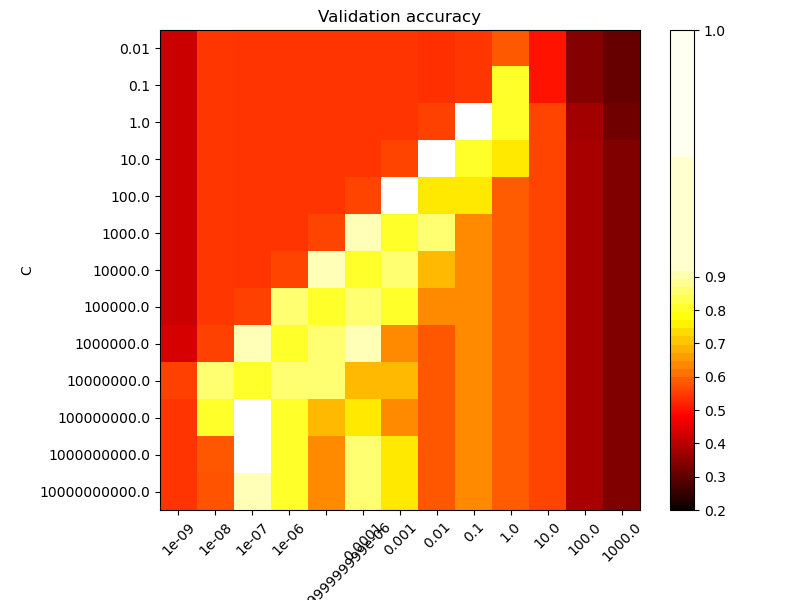
Карта якості показує діагональ, а не єдину точку
Той самий перебір, але замість меж рішення — точність перехресної перевірки для кожної пари значень. По горизонталі відкладено gamma, по вертикалі C, обидві шкали логарифмічні.
Світлі клітинки утворюються не в одній точці, а витягуються в діагональ: мале gamma з великим C дає приблизно ту саму якість, що велике gamma з малим C. Два праві стовпці — суцільно темні: при gamma порядку сотні модель обгортає кожну точку окремим острівцем і не узагальнює взагалі, і жодне C цього не виправляє.
Звідси два практичні правила. По-перше, шукати параметри слід логарифмічною сіткою — крок «×10», а не «+1». По-друге, всередині світлої смуги немає сенсу боротися за третій знак після коми: різниця між сусідніми клітинками менша за розкид між фолдами перехресної перевірки.
Код: підбір C і gamma на медичних даних
Повний робочий приклад на Breast Cancer: стандартизація всередині конвеєра, сітка по двох параметрах, п'ятикратна перехресна перевірка.
Вивід код запущено, вивід не редагувався
text
найкращі параметри: C = 100, gamma = 0.001
перехресна перевірка: 0.985
на тесті: 0.953
опорних векторів: 40
На що дивитися: крос-валідація дає 0,985, тест — 0,953, а все рішення тримається на 40 опорних векторах із 398 навчальних зразків.
Стандартизація стоїть усередині Pipeline не для краси: обчислена на всій вибірці, вона пропустила б інформацію про тест у навчання.
Результат на медичних даних і межі можливого
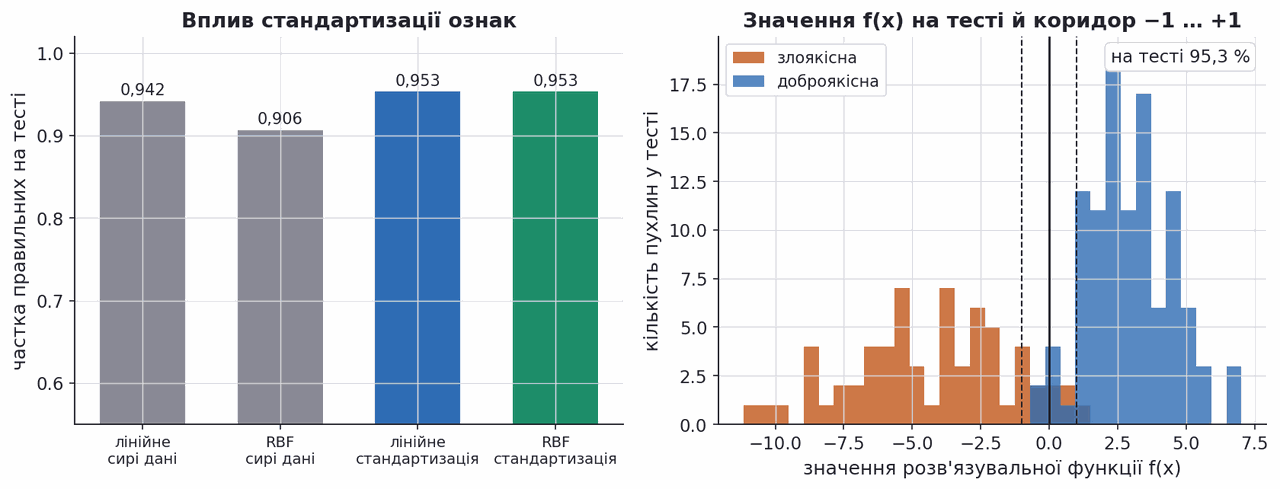
Ліва панель порівнює чотири конфігурації на тих самих 171 тестовій пухлині. Головний висновок несподіваний для тих, хто чекав чудес від ядра: стандартизація дала більше, ніж вибір ядра. Без неї RBF провалюється до 0,906, бо площа ядра клітини вимірюється сотнями, а гладкість контуру — сотими, і в евклідовій відстані чути лише першу ознаку.
Права панель показує розподіл значень розв'язувальної функції на тесті. Дві вертикальні штрихові лінії — межі коридору; всередині нього лежать саме ті пухлини, які стали опорними векторами. Розділення чисте: більшість спостережень далеко від нуля, і лише кілька потрапили в зону сумніву.
Підбір гіперпараметрів підняв перехресну перевірку до 0,985, але на тесті дав ті самі 0,953, що й налаштування за замовчуванням. На цих даних модель уже близька до стелі, і чесно це визнати корисніше, ніж полірувати сітку.
Теорема про представлення відкриває ядра для регресії
Ядровий трюк не є винаходом саме для SVM: він працює для будь-якої моделі з ridge-регуляризацією.
"For any loss function ℓ, and any minimizer w* of the regularized empirical risk, there exists α* ∈ ℝᴺ such that w* = Xᵀα*." — теорема про представлення (representer theorem), EPFL CS-433, лекція 07a
Українською: оптимальні ваги завжди є лінійною комбінацією навчальних точок, бо ортогональна до них компонента лише збільшує норму, не змінюючи прогнозів. Отже, будь-яку таку модель можна переписати через
Перша коштує
KRR і SVR: одна крива, різна ціна
Той самий прийом дає два різні методи регресії. Kernel ridge regression мінімізує квадратичну втрату й тому використовує всі точки. Support vector regression (SVR) замінює її на
На рисунку обидві моделі навчено на зашумленій синусоїді: криві практично збігаються, але червоні кружки — опорні вектори SVR, і їх помітно менше, ніж точок. На нашому запуску з 400 точок KRR дала MSE 0,171 за 0,24 с, SVR — 0,177 за 0,35 с, використавши 95 точок. Обмін чіткий: KRR навчається швидше, SVR дає компактнішу модель, бо вартість її прогнозу зростає з кількістю опорних векторів, а не всієї вибірки.
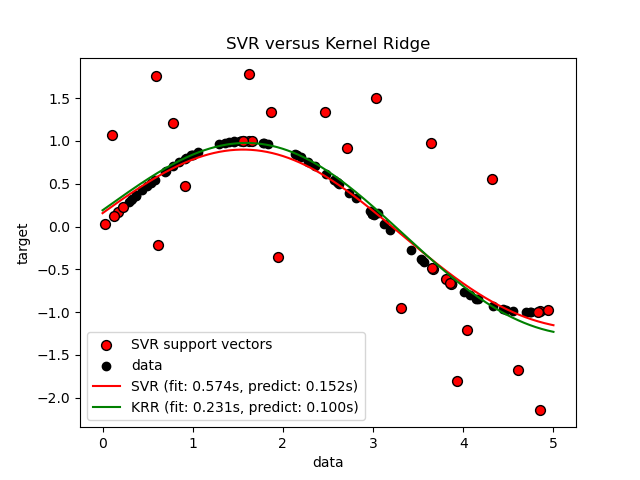
Джерело: scikit-learn · Comparison of kernel ridge regression and SVR
Наближення ядра рятує на великих вибірках
Матриця ядра має розмір
Вихід парадоксальний: побудувати відображення
На рисунку три моделі на наборі рукописних цифр у проєкції на дві головні компоненти: точне RBF-ядро та два наближення зі ста компонентами. Межі рішень майже не відрізняються.
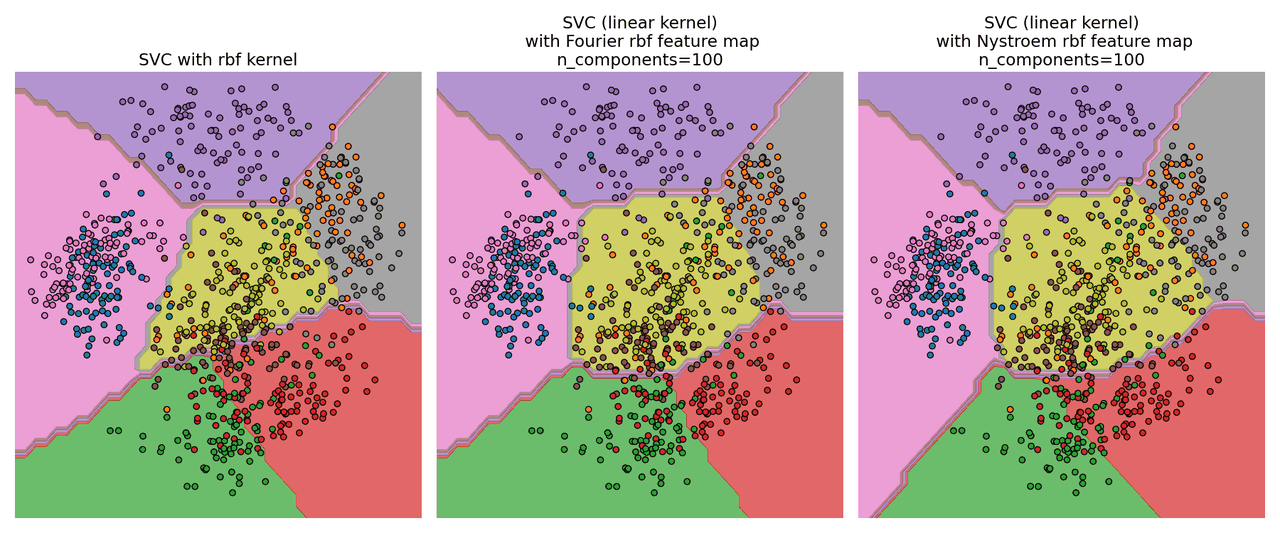
Джерело: scikit-learn · Explicit feature map approximation for RBF kernels
HAR: на семи тисячах спостережень наближення ще не потрібне
Перш ніж заміняти ядро наближенням, варто перевірити, чи вже треба. Візьмімо Human Activity Recognition — набір із лабораторної: 10 299 записів з акселерометра смартфона, 561 ознака, шість дій.
Вивід код запущено, вивід не редагувався
text
модель           навчання, с  точність
точне RBF-ядро           1.9    0.9848
Нюстрем 300              0.8    0.9618
Нюстрем 2000             6.5    0.9767
На що дивитися: на семи тисячах записів точне ядро найточніше, а наближення виграє в часі лише зі 300 компонентами — і платить за це точністю.
Результат несподіваний для тих, хто чув правило «ядро не масштабується»: на 7209 навчальних записах точне ядро навчається за неповні дві секунди й дає найкращу точність, 0,985. Наближення зі 300 компонентами вдвічі швидше, але втрачає два відсоткові пункти; із 2000 компонентами воно вже повільніше за точне ядро й усе одно поступається йому.
Висновок практичний: наближення — не «краща версія» ядра, а обмін точності на час, і братися за нього має сенс лише тоді, коли час справді став проблемою. Сім тисяч спостережень — ще не той випадок.
Квадратична стіна: де саме ламається точне ядро
Щоб побачити межу, потрібен набір, на якому вона настає: MiniBooNE, 130 064 події детектора нейтрино, 50 ознак. Навчаємо на підвибірках зростаючого розміру.
Вивід код запущено, вивід не редагувався
text
     N  ядро, с  точність ядра  Нюстрем  матриця, ГБ
  2000      0.1         0.7194   0.8766          0.0
  5000      0.2         0.8619   0.8813          0.2
 10000      0.9         0.8793   0.8877          0.8
 20000      3.6         0.8824   0.8913          3.2
На що дивитися: дивіться на стовпці часу й пам'яті: вибірка зросла вдесятеро, час ядра — у десятки разів, а матриця ядра на 20 000 зразках займає вже 3,2 ГБ.
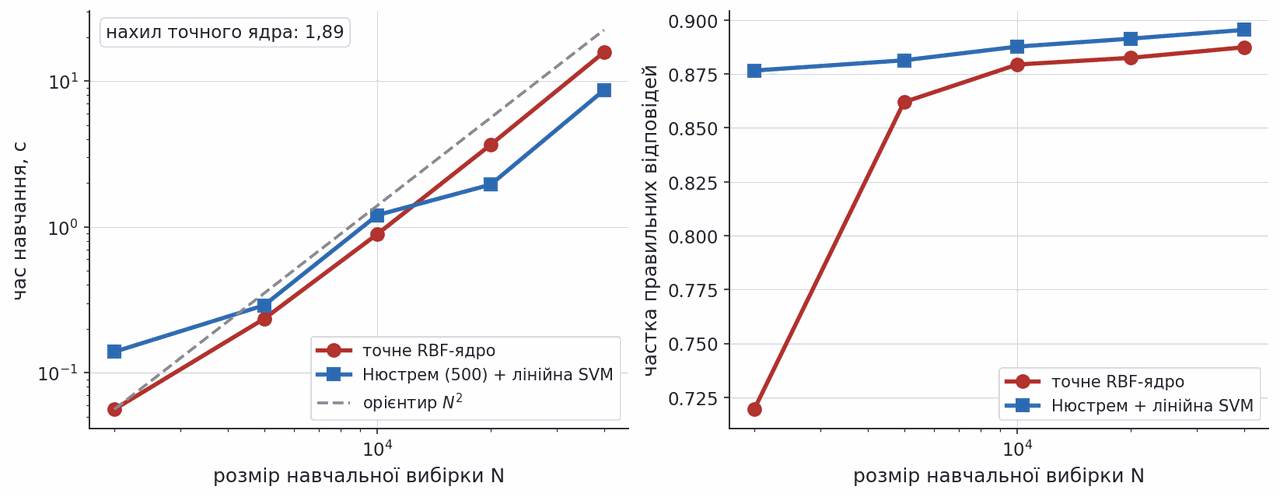
Час точного ядра росте так: 0,1 с при двох тисячах, 0,2 при п'яти, 0,9 при десяти, 3,6 при двадцяти. Вибірка зросла вдесятеро — час у тридцять шість разів. На рисунку той самий вимір продовжено до 40 000 і показано в подвійному логарифмічному масштабі: нахил дорівнює 1,89, тобто обіцяна квадратична залежність не процитована, а виміряна. Наближення на тому ж відрізку дорожчає помітно повільніше й при цьому не програє в точності: 0,895 проти 0,887 на найбільшій вибірці.
Абсолютні секунди залежать від машини, тож порівнювати варто нахили. Що від машини не залежить — пам'ять: матриця ядра при 40 000 спостережень зайняла б 12,8 ГБ, при 130 000 — 135 ГБ. Бібліотека не тримає її цілком, а перераховує через кеш, і саме тому час росте квадратично, а не впирається в пам'ять одразу.
Обмеження методу опорних векторів
Метод має чіткі межі застосовності, і краще знати їх заздалегідь.
Вартість зростає як куб від кількості спостережень. Матриця ядра
Обов'язкова стандартизація. Відступ вимірюється евклідовою відстанню, тому ознака з більшим числовим розмахом заглушує решту. Ми бачили це на медичних даних: 0,906 проти 0,953 на тих самих ознаках.
Два гіперпараметри без замовчувань. C і gamma треба підбирати перехресною перевіркою на кожному новому наборі даних; універсально правильних значень не існує.
Немає ймовірностей. SVM віддає відстань до межі, а не ймовірність класу. Перетворення (калібрування Платта) можливе, але потребує додаткової перехресної перевірки й помітно уповільнює навчання.
Втрачається інтерпретованість. У лінійному ядрі коефіцієнти ще можна прочитати; у RBF модель — це набір опорних векторів і схожостей, і пояснити конкретне рішення стає важко.
Підсумок лекції
Максимальний відступ — це вибір найнадійнішої з нескінченної кількості роздільних гіперплощин. Задача «максимізувати відступ» тотожна задачі «мінімізувати
Soft-SVM — це ERM з hinge-втратою і ridge-регуляризацією. Слекові змінні вимірюють глибину порушення, а параметр C = 1/(λN) керує компромісом між шириною коридору й кількістю допущених помилок.
Розв'язок розріджений. Модель зберігає лише опорні вектори; викидання решти даних не змінює межі — ми перевірили це з точністю до
Двоїста задача залежить від даних лише через матрицю попарних скалярних добутків — і саме ця властивість відкриває ядровий трюк.
Ядро дає нелінійність задарма. Заміна
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекції 06a (SVM) і 07a (ядра)
- UBC CPSC 340 — лекція 21
- Stanford CS229 — розділ 5
Статті та підручники
- Cortes C., Vapnik V. Support-vector networks (1995)
- Schölkopf B., Herbrich R., Smola A. A generalized representer theorem. COLT, 2001
- Bishop C. Pattern Recognition and Machine Learning — розділи 6–7
- Hastie T. та ін. The Elements of Statistical Learning — розділ 12
Документація й дані