Тема
Лекція 12 · Механізм уваги та трансформери
Згорткова мережа з минулої лекції зв'язує сусідні пікселі. Сьогодні розберемо архітектуру, у якій будь-які два елементи послідовності зв'язані напряму, за один крок — і саме на ній працюють сучасні мовні моделі.
Зміст лекції
Лекція будує трансформер з одного механізму, додаючи по одній деталі за раз.
- Чому послідовності важкі. Рекурентна мережа забуває початок; згорткова бачить лише окіл.
- Увага як зважене середнє. Запити, ключі, значення і формула scaled dot-product attention.
- Самоувага. Наскрізний числовий приклад, масштабування, причинна маска, кілька голів.
- Позиційне кодування. Чому увага не знає порядку слів і як це виправляють.
- Блок трансформера і повна архітектура. Залишкові зв'язки, нормалізація, енкодер і декодер.
- Мовні моделі. Навчання передбаченням наступного слова, авторегресивна генерація, обмеження.
Перші два блоки пояснюють, звідки взявся механізм; третій і четвертий доводять його до робочого стану; п'ятий збирає архітектуру, шостий показує, що з неї виросло.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чому шлях між далекими елементами послідовності в рекурентній мережі коштує
кроків, а в самоуваги — один; - записати формулу scaled dot-product attention і розшифрувати всі позначення;
- порахувати ваги уваги вручну для короткої послідовності;
- пояснити, навіщо оцінки діляться на
, і що буде без цього; - побудувати причинну маску і сказати, де саме вона застосовується;
- пояснити, навіщо потрібні кілька голів уваги;
- показати, чому самоувага не розрізняє порядок токенів, і як його додає позиційне кодування;
- описати блок трансформера і назвати, що робить кожен його підблок;
- розрізнити режими енкодера, декодера та енкодера-декодера і сказати, для чого кожен;
- реалізувати самоувагу з нуля на PyTorch і візуалізувати матрицю ваг.
Задача: на вході послідовність, на виході теж
Досі один об'єкт давав один прогноз. Тепер вхід є послідовністю змінної довжини, і задачі бувають двох типів.
Розмітка (tagging) вимагає прогнозу для кожного елемента: частина мови для кожного слова. Прогнози не є незалежними — щоб визначити частину мови, треба дивитися на сусідів.
Перетворення послідовності в послідовність (sequence-to-sequence) дає послідовність іншої довжини: переклад, стислий переказ, підпис до зображення.
Обидві задачі розв'язує та сама конструкція: перетворити кожен елемент на контекстуалізоване подання (contextualized representation) — вектор, який ураховує решту послідовності, — і поставити зверху лінійну модель.
"[A Transformer] iteratively transforms a sequence of non-contextualized representations into a sequence of contextualized representations. Mixes information between sequence elements via self-attention." — EPFL CS-433, лекція 09a
Джерело: EPFL CS-433 Machine Learning
Рекурентна мережа забуває початок послідовності
Класичний спосіб обробити послідовність — рекурентна мережа: стан оновлюється по одному елементу,
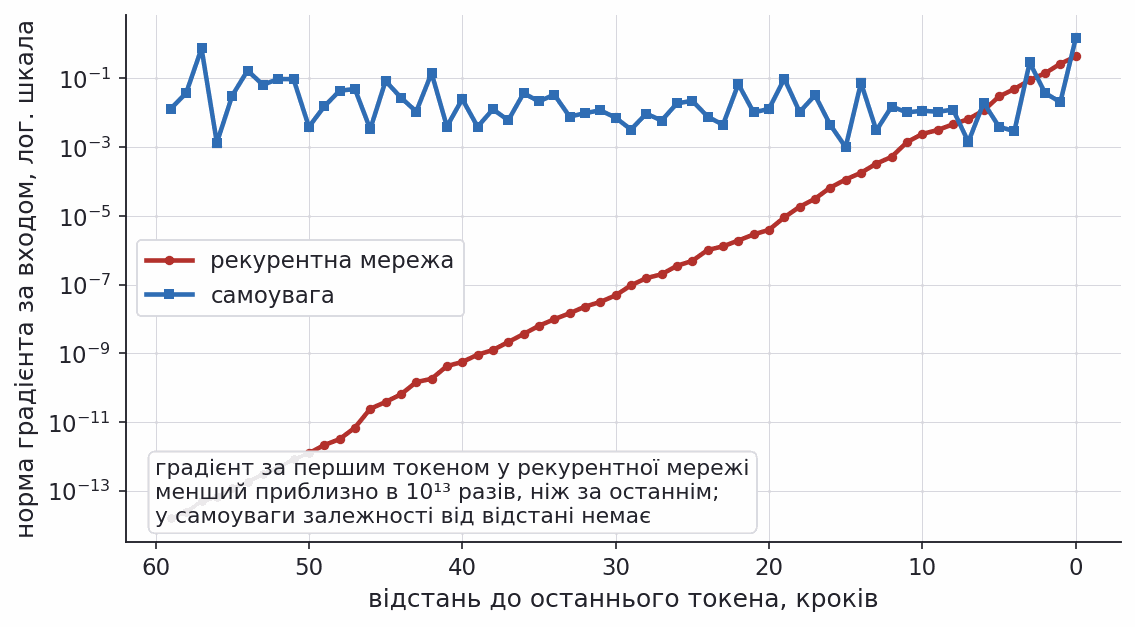
Виміряймо це прямо. На рисунку — норма градієнта виходу останнього кроку за кожним входом, для послідовності з 60 елементів. У рекурентної мережі градієнт спадає монотонно з відстанню і на першому елементі приблизно на тринадцять порядків менший, ніж на останньому. Для самоуваги залежності від відстані немає взагалі: вага першого токена така сама за природою, як вага сусіднього.
Гейтові варіанти, LSTM і GRU, послаблюють це згасання спеціальними вентилями пам'яті, але не усувають самої причини — послідовної обробки.
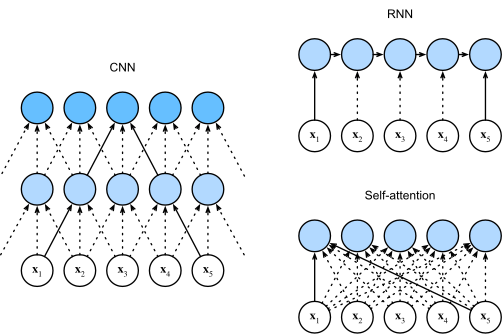
Три способи зв'язати елементи послідовності
Порівняймо архітектури за одним критерієм: скільки кроків потрібно, щоб інформація з одного елемента дійшла до іншого.
Згортка зв'язує лише окіл шириною
Джерело: Dive into Deep Learning · Self-Attention and Positional Encoding
Складність трьох типів шарів
Те саме порівняння в числах — таблиця з оригінальної статті про трансформер, у позначеннях курсу:
| Тип шару | Складність шару | Послідовних операцій | Найдовший шлях між елементами |
|---|---|---|---|
| Самоувага | |||
| Рекурентний | |||
| Згортковий |
Читати треба два останні стовпці разом. Самоувага платить квадратом за довжину, але виграє двічі: між будь-якими двома токенами один крок, тож нічого не забувається, і немає послідовної залежності, тож усе рахується паралельно на GPU. Рекурентна мережа дешевша за один шар, але змушена робити
Джерело: Vaswani A. та ін., Attention Is All You Need, NIPS 2017, таблиця 1
Ціна квадратичної складності на практиці
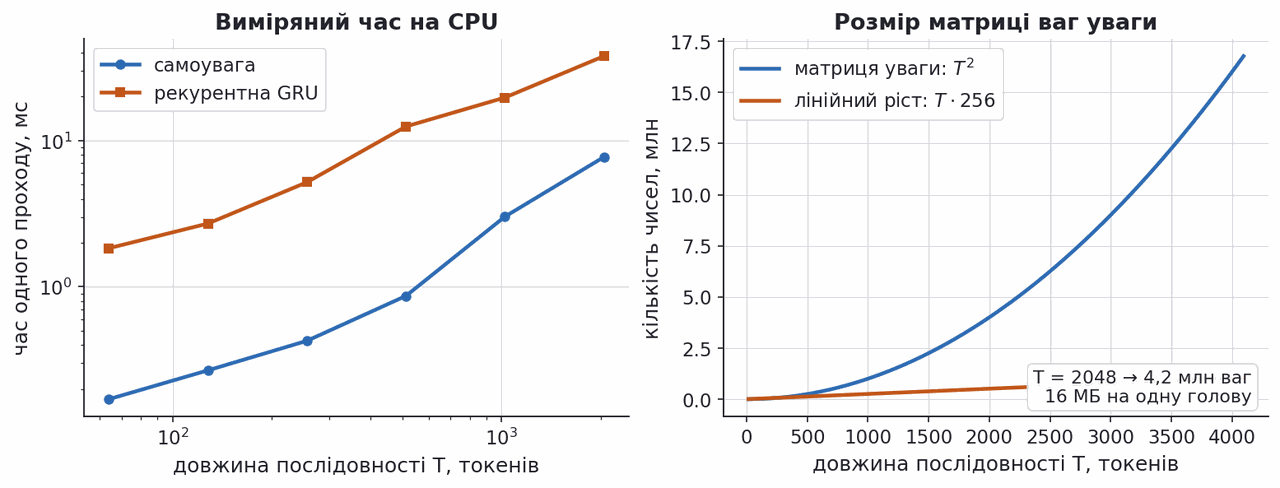
Перевірмо обидві сторони на практиці. Ліворуч — виміряний час одного проходу на цьому комп'ютері. Попри квадратичну складність, самоувага виявляється швидшою за рекурентну GRU на всіх довжинах: при
Праворуч — те, за що доводиться платити. Матриця ваг уваги має розмір
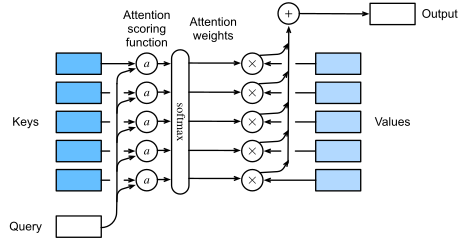
Увага — це зважене середнє з навченими вагами
Механізм влаштований простіше, ніж здається. Кожен вихідний вектор — це зважене середнє всіх вхідних:
Ваги
Уся суть у тому, звідки беруться ваги. Вони не є параметрами моделі й не фіксовані — вони обчислюються з самих даних для кожної конкретної послідовності. Тому одне й те саме слово в різних реченнях дістане різний контекст.
Джерело: Dive into Deep Learning · Attention Scoring Functions
Запит, ключ і значення
Ваги беруться з подібності двох векторів, і саме тут з'являється термінологія, запозичена з баз даних.
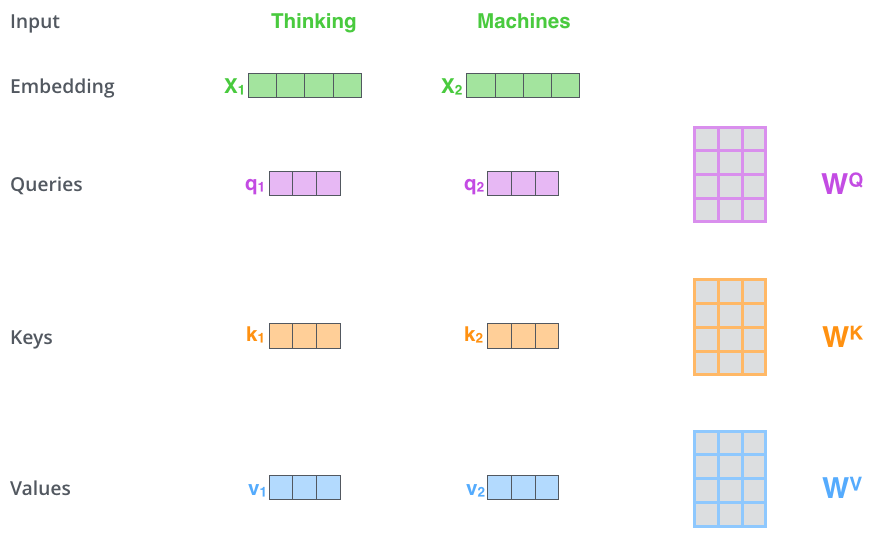
Для кожного токена обчислюють три вектори, множачи його подання на три навчувані матриці. Запит (query)
Вага
Формула scaled dot-product attention
Подібність вимірюють скалярним добутком, ділять на корінь із розмірності й пропускають через softmax:
| Позначення | Значення |
|---|---|
| довжина послідовності в токенах | |
| розмірність подання токена, у статті позначена | |
| запит вихідного токена | |
| сира оцінка подібності (score) | |
| масштабування, що тримає дисперсію оцінок близько одиниці | |
| вага уваги; softmax береться по кожному рядку окремо |
Матричний запис компактніший і саме він реалізований у бібліотеках:
Крок за кроком на двох токенах
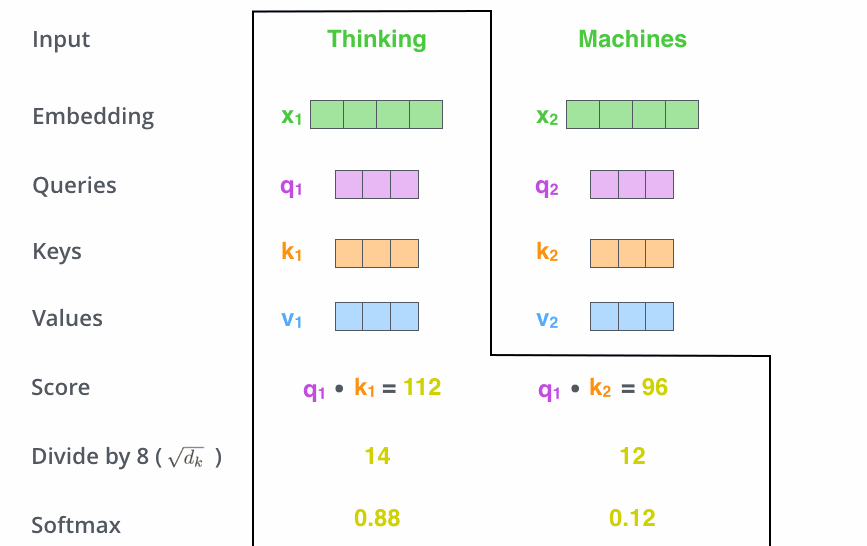
Розгляньмо, як це виглядає на реченні «Thinking Machines», коли ми обчислюємо подання першого слова.
Для обох слів будують запити, ключі та значення. Оцінки — це скалярні добутки запиту першого слова з обома ключами: 112 із власним ключем і 96 із ключем другого слова. Обидві оцінки діляться на 8 (це
Останній крок: кожне значення множиться на свою вагу, і результати додаються. Подання слова «Thinking» на 88 % складається з нього самого і на 12 % — із сусіда.
Матричний запис: три множення замість циклу
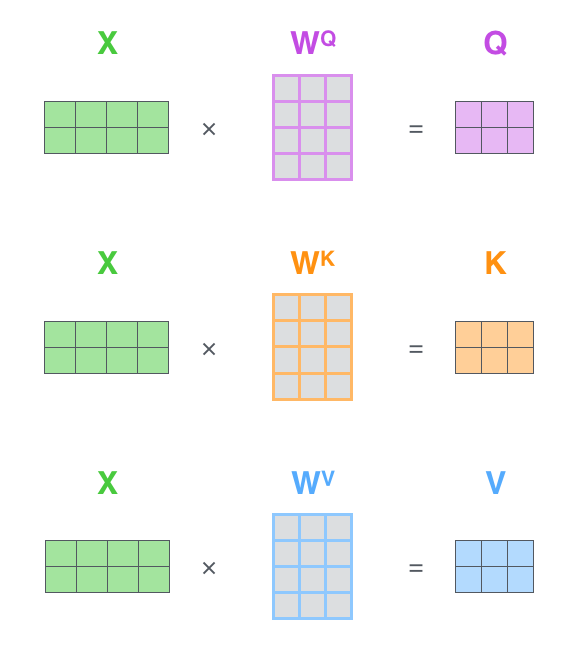
Робити це по одному токену незручно й повільно. На практиці всю послідовність складають у матрицю
Матриці
Слово «само-» в назві самоувага (self-attention) означає рівно те, що всі три проєкції зроблено з одного й того самого
Увесь шар самоуваги одним виразом
Підставивши проєкції у формулу уваги, отримуємо весь шар як один рядок:
Розміри легко перевірити:
Звідси ж видно і вартість: матриця
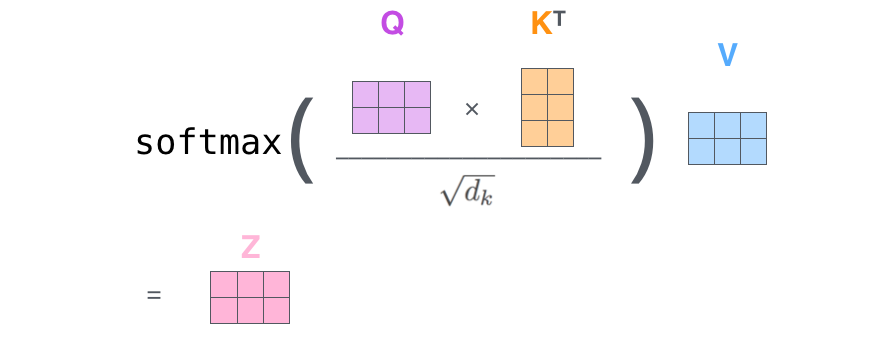
Наскрізний приклад: «кіт п'є молоко»
Порахуймо все на трьох токенах із
Ліва панель — оцінки
Права панель — результат
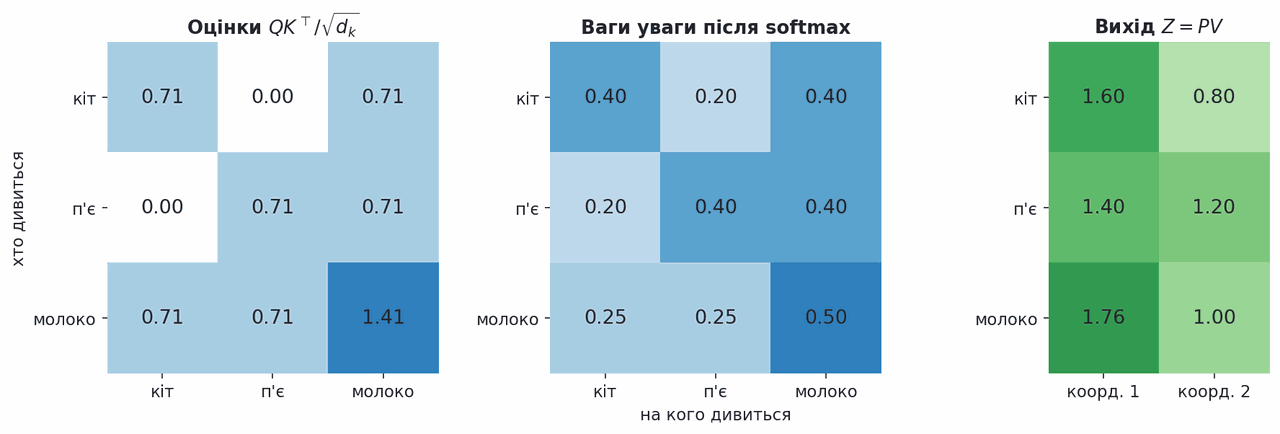
Увага на трьох токенах, число за числом
Той самий приклад, що на рисунку: три токени, dk = 2. Оберіть токен і посуньте його вектори — оцінки, ваги після softmax і вихід перерахуються тут-таки за формулою розділу.
| кіт | п'є | молоко | |
|---|---|---|---|
| кіт | 0,71 | 0,00 | 0,71 |
| п'є | 0,00 | 0,71 | 0,71 |
| молоко | 0,71 | 0,71 | 1,41 |
| кіт | п'є | молоко | |
|---|---|---|---|
| кіт | 0,40 | 0,20 | 0,40 |
| п'є | 0,20 | 0,40 | 0,40 |
| молоко | 0,25 | 0,25 | 0,50 |
| 1-ша | 2-га | ентропія | |
|---|---|---|---|
| кіт | 1,60 | 0,80 | 1,52 |
| п'є | 1,40 | 1,20 | 1,52 |
| молоко | 1,76 | 1,00 | 1,50 |
За замовчуванням тут числа з рисунка: найбільша оцінка 1,41 стоїть у «молока» на самого себе, «кіт» розподіляє увагу як 0,40 / 0,20 / 0,40, а його вихід дорівнює (1,60; 0,80) — уже не власне значення (1; 0), а суміш усіх трьох. Це і є контекстуалізоване подання, порахувати яке можна на папері за хвилину. Три речі варто побачити руками. Перше: оберіть «молоко» і збільште його першу координату до 3 — оцінка на самого себе злетить, softmax стягне на нього майже всю увагу (0,99), а ентропія рядка впаде з 1,50 біта до 0,08 при максимально можливих 1,58. Друге: вимкніть ділення на √dk і подивіться на ваги «кота»: 0,40 / 0,20 / 0,40 перетворюються на 0,42 / 0,16 / 0,42. Оцінки виросли всього в 1,41 раза, а розподіл уже помітно гостріший — і саме це псує навчання, коли dk дорівнює не 2, а 64. Третє: змініть лише значення V, не чіпаючи запитів і ключів, — ваги не зрушать зовсім, а вихід зміниться. Увага вирішує, звідки брати, а не що саме брати.
Код: самоувага з нуля на PyTorch
Уся формула — чотири рядки. Маска знадобиться в наступних розділах.
Вивід код запущено, вивід не редагувався
text
ваги уваги:
 tensor([[0.4000, 0.2000, 0.4000],
        [0.2000, 0.4000, 0.4000],
        [0.2500, 0.2500, 0.5000]])
вихід:
 tensor([[1.6000, 0.8000],
        [1.4000, 1.2000],
        [1.7600, 1.0000]])
На що дивитися: ваги уваги й вихід збігаються з ручним розрахунком: «кіт» розподілив увагу як 0,4 / 0,2 / 0,4 і отримав вектор (1,6; 0,8) — суміш значень усіх трьох токенів.
У робочому коді використовують torch.nn.functional.scaled_dot_product_attention — та сама операція, але з оптимізованою реалізацією і без явного зберігання матриці
Джерело: PyTorch · scaled_dot_product_attention
Ділення на корінь із розмірності рятує softmax
Ділення на
На рисунку — розподіл ваг уваги одного запиту по 24 ключах при випадковій ініціалізації,
Наслідок практичний. У зоні насичення softmax градієнти майже нульові, тому модель, що стартувала з гострого розподілу, довго не може з нього вийти. Масштабування дає на старті майже рівномірну увагу — і швидшу збіжність.
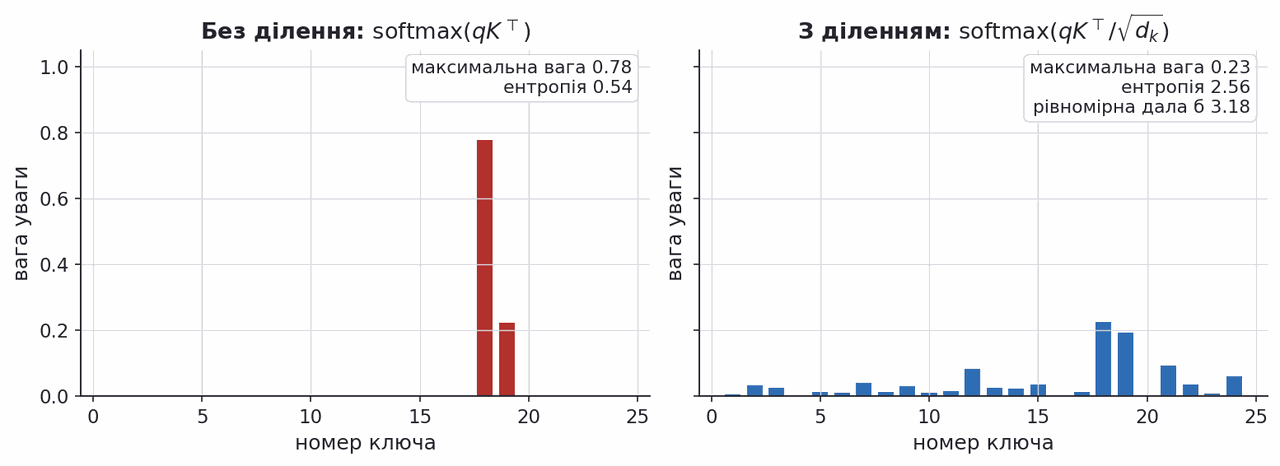
"For large values of
, the dot products grow large in magnitude, pushing the softmax into regions with extremely small gradients." — Vaswani та ін., 2017, розділ 3.2.1
Джерело: Attention Is All You Need
Ваги уваги в навченій моделі справді осмислені
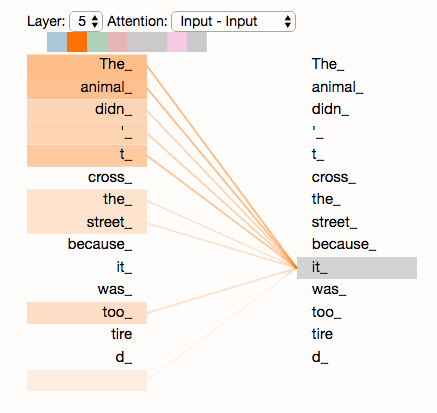
Дотепер ми дивилися на ваги при випадковій ініціалізації. Ось як вони виглядають у навченому трансформері.
Речення: «The animal didn't cross the street because it was too tired». Слово «it» — займенник, і щоб зрозуміти його, модель має вирішити, до чого він належить: до тварини чи до вулиці. На рисунку показано, куди дивиться подання слова «it» у п'ятому шарі енкодера: найбільша вага припадає на «The animal».
Ніхто не позначав цю відповідність у даних. Модель навчалася лише передбачати слова, і потрібний зв'язок утворився сам, бо він допомагає передбачати.
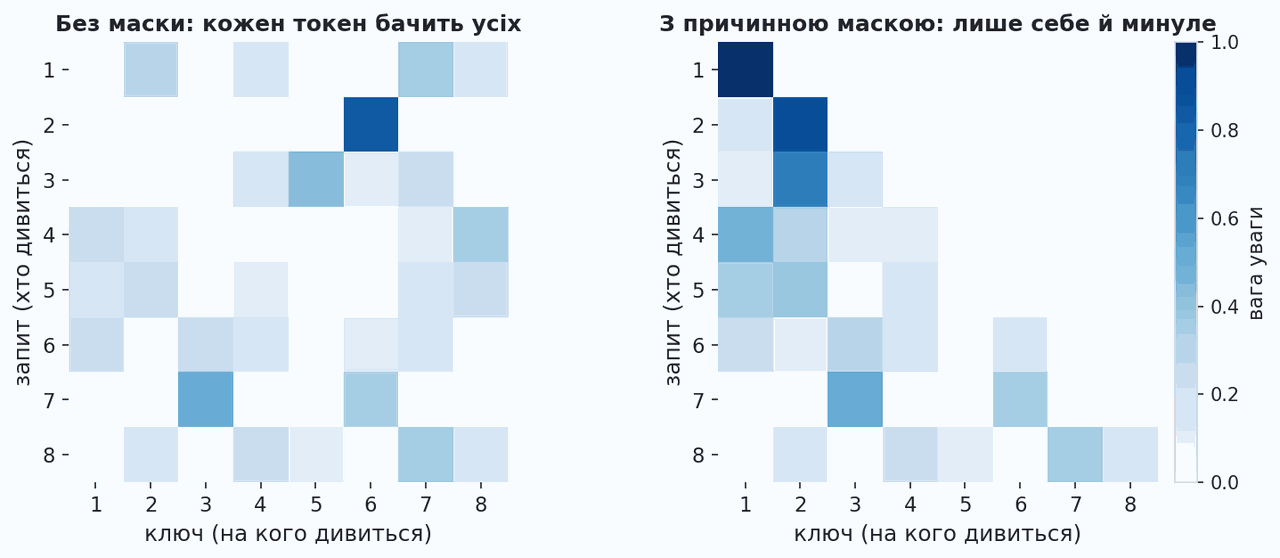
Причинна маска забороняє дивитися в майбутнє
Коли модель учиться передбачати наступне слово, вона не має права бачити відповідь. Тому в декодері увагу обмежують: токен
Технічно це робиться додаванням маски до softmax:
Мінус нескінченність, а не нуль:
Кілька голів дивляться на різні речі
Одна матриця ваг задає один патерн уваги, а в реченні водночас важливі кілька різних зв'язків: узгодження підмета з присудком, до чого належить займенник, який час дієслова.
Розв'язок прямий: обчислити кілька незалежних механізмів уваги паралельно. Кожна голова (head)
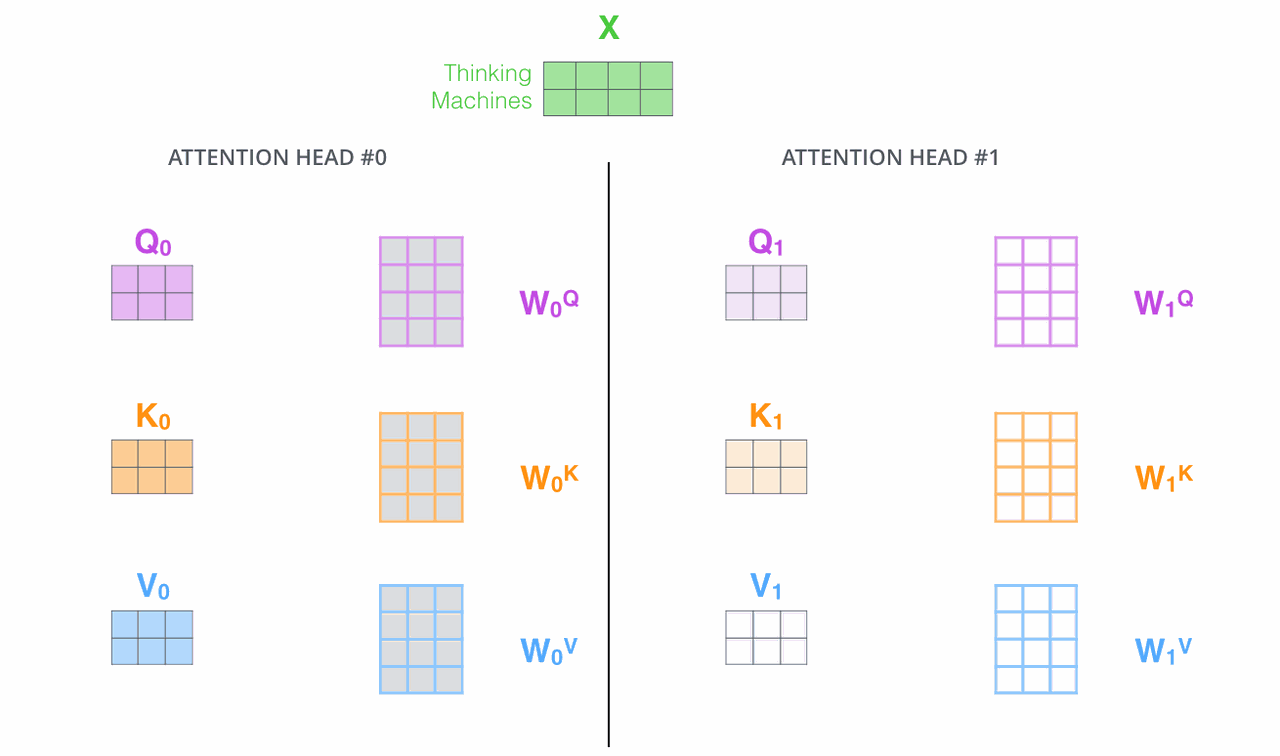
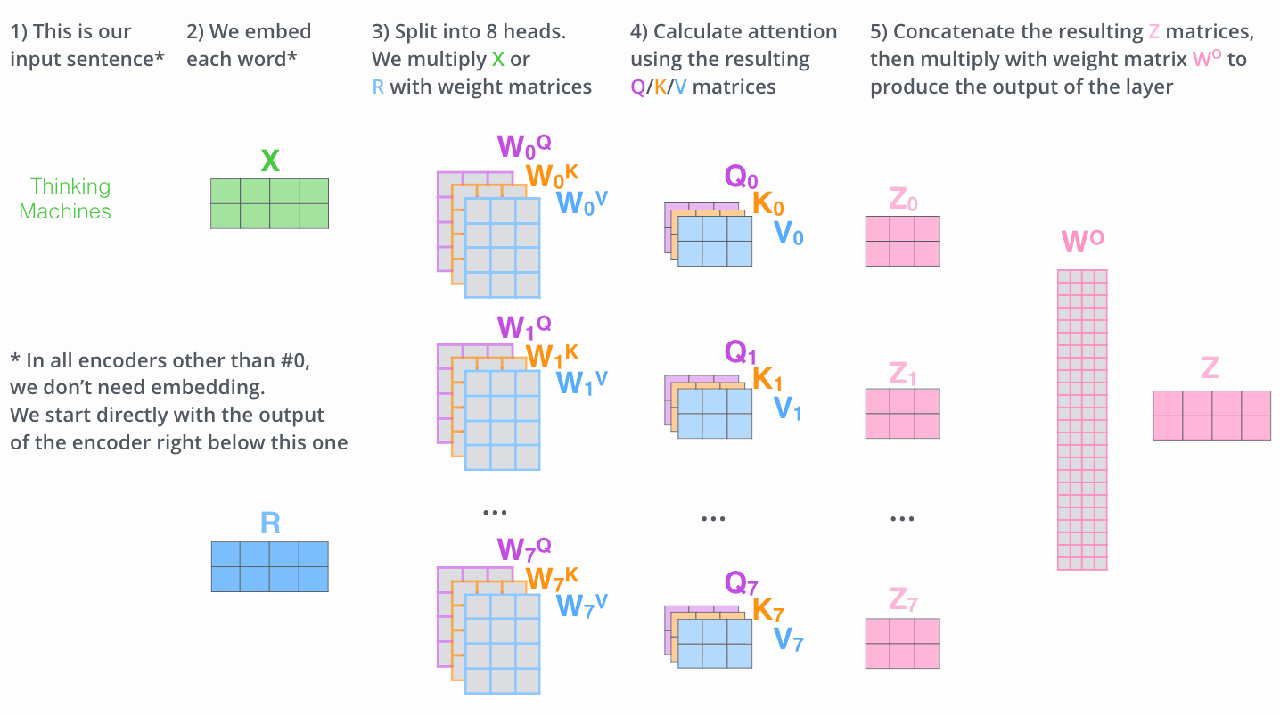
Голови склеюються і повертаються в розмірність D
Голови працюють паралельно, кожна дає свій вихід
Розмірність голови беруть як
Код: багатоголова увага з бібліотеки
Писати руками це не доводиться: у PyTorch багатоголова увага — готовий шар. Прапорець average_attn_weights=False потрібен, щоб отримати ваги кожної голови окремо, а не їхнє середнє.
Вивід код запущено, вивід не редагувався
text
вихід: (1, 10, 64) · ваги уваги: (1, 8, 10, 10)
сума першого рядка ваг: 1.0000
На що дивитися: вихід має ту саму форму, що й вхід, ваги — окрема матриця 10 × 10 для кожної з 8 голів, і кожен рядок ваг у сумі дає одиницю.
Форма ваг читається так: одна послідовність, 8 голів, і для кожної матриця 10 × 10 «кожен токен на кожного». Сума першого рядка дорівнює одиниці — це той самий softmax по рядках. Вихід має ту саму форму, що й вхід, тому такі блоки можна ставити один на одного.
Джерело: PyTorch · nn.MultiheadAttention
Самоувага не розрізняє порядок слів
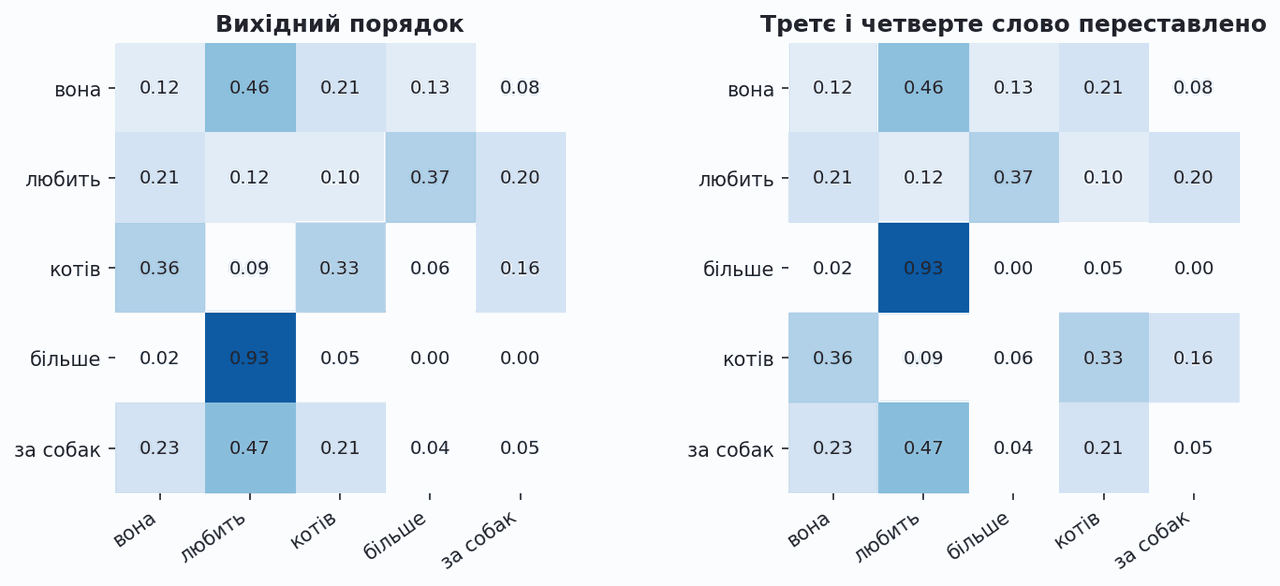
У механізму є принципова вада. Переставмо два слова місцями: усі скалярні добутки збережуться, softmax береться по рядках — і вихід просто переставиться так само, як вхід. Формально для будь-якої матриці перестановки
На рисунку — ваги уваги для п'ятислівного речення до і після перестановки третього й четвертого слова. Матриця праворуч є точною перестановкою матриці ліворуч: ті самі числа, переставлені рядки й стовпці. Перевірка на векторах виходу дає розбіжність
Для мови це неприйнятно: «вона любить котів більше за собак» і «вона любить собак більше за котів» складаються з однакових слів, але означають протилежне.
Позиційне кодування додає моделі відчуття порядку
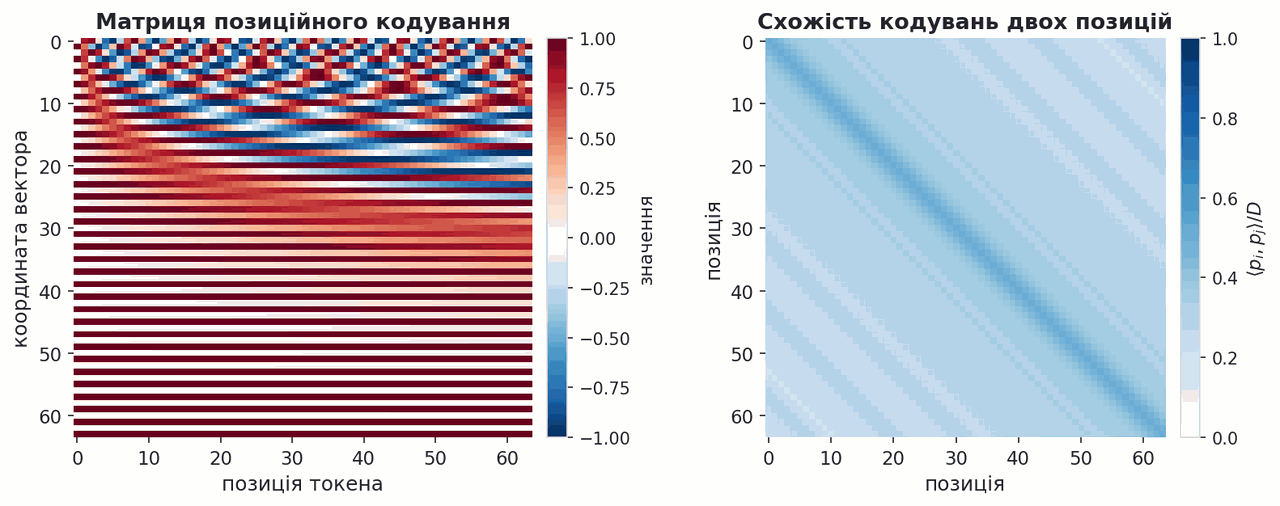
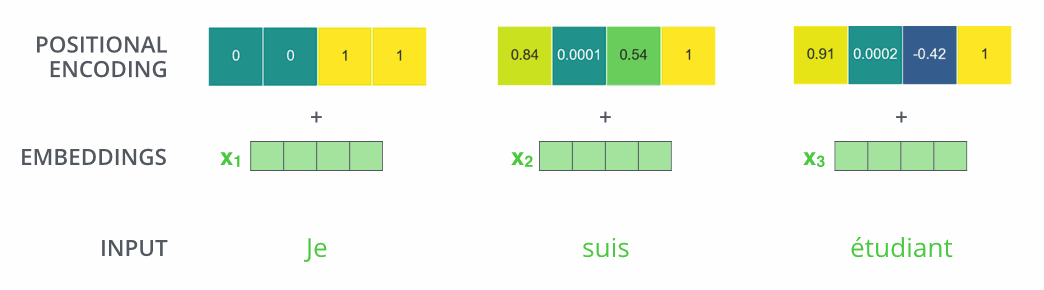
Оскільки сам механізм порядку не бачить, інформацію про позицію додають прямо у вхідні вектори. Найпростіший варіант — навчувана матриця позицій. Оригінальна стаття натомість використала фіксовані синусоїди різної частоти:
Ліва панель — уся матриця кодування для 64 позицій і 64 координат. Верхні координати змінюються швидко, нижні повільно: разом вони кодують позицію так само, як розряди двійкового числа.
Права панель пояснює, навіщо саме синусоїди. Схожість кодувань двох позицій плавно спадає з відстанню: для самої позиції вона 0,5, для сусідньої 0,483, а через двадцять позицій уже 0,295. Модель отримує не просто мітку «це позиція 20», а й придатну для узагальнення міру відстані. Автори зазначають, що навчувані й синусоїдні кодування дали майже однакові результати, але синусоїди дозволяють працювати з довшими послідовностями, ніж бачила модель.
Чим позиції відрізняються одна від одної
Матриця рахується просто тут, за формулою вище. Кожен рядок — вектор однієї позиції, кожен стовпець — своя частота: ліві стовпці міняються швидко, праві майже сталі.
кодування: рядок — позиція, стовпець — вимір
схожість кодування позиції 10 з усіма іншими
1,00сама з собою
0,97із сусідньою
0,66через десять позицій
64чисел на позицію
≈ 0розбіжність після перестановки двох токенів
6 × 8токенів і вимірів у перевірці
нікодування додано до вкладень
Пік схожості стоїть рівно на обраній позиції й спадає з відстанню — саме тому модель може вивести «наскільки далеко» один токен від іншого, хоча сама увага порядку не бачить. Посуньте позицію: форма кривої їде за нею, не змінюючись, бо скалярний добуток двох кодувань залежить тільки від різниці позицій. Зменште D до восьми — частот стає замало, і далекі позиції починають виглядати схожими; це і є причина, чому розмірність кодування беруть такою самою, як розмірність вкладення.
Друга частина вставки перевіряє те, заради чого кодування й вигадали. Кнопка «сама увага» рахує самоувагу на шести токенах, потім міняє місцями третій і четвертий і порівнює результат із переставленим виходом. Різниця дорівнює нулю з точністю машинної арифметики: увага справді не бачить порядку, і це властивість архітектури, а не наслідок навчання. У лекції той самий дослід на PyTorch дає 1,2·10⁻⁷ — розбіжність більша лише тому, що там float32, а тут подвійна точність. Тепер натисніть «увага + позиційне кодування». Розбіжність перестає бути нулем — на цих числах 0,076. Причина в тому, що кодування прив'язане до позиції, а не до токена: переставивши слова, ми лишили кодування на місці, і входи справді змінилися. Саме це й потрібно — так модель дізнається, що «вона любить котів більше за собак» не те саме, що «вона любить собак більше за котів».
Позиційне кодування просто додається до вкладень
Механіка гранично проста: вектор позиції має ту саму розмірність, що й вектор токена, і вони додаються покоординатно. Далі мережа працює з сумою, не розділяючи, де що.
Може здатися дивним, що дві різні речі складаються в один вектор. Але розмірність
Блок трансформера: увага, MLP і два обходи
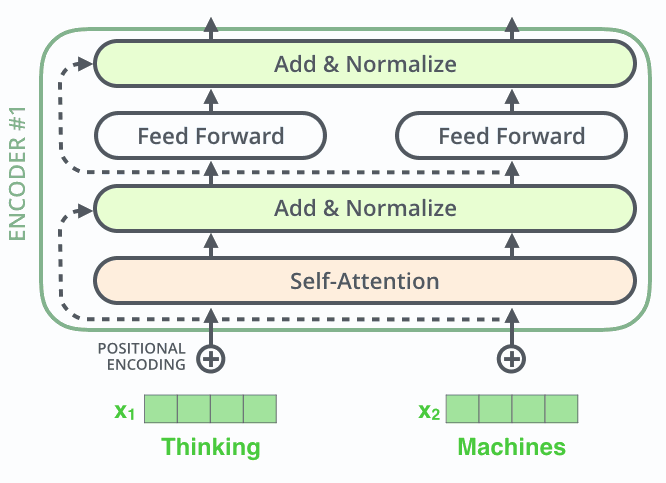
Тепер зберімо блок. Він складається з двох підблоків, кожен обгорнутий залишковим зв'язком і нормалізацією:
Залишкові зв'язки — ті самі, що в ResNet із минулої лекції; без них глибокий стек блоків не навчається. Пошарова нормалізація (layer normalization) стандартизує кожен вектор токена по його координатах — на відміну від пакетної, вона не залежить від інших зразків у батчі, що зручно для послідовностей різної довжини.
Сучасні моделі ставлять нормалізацію на початок залишкової гілки (pre-LN), як у формулі вище; в оригінальній статті 2017 року вона стояла після додавання:
Увага змішує між токенами, MLP — усередині токена
Два підблоки роблять принципово різні речі, і це варто запам'ятати як одне речення.
| Підблок | Що змішує | Формула | Параметри |
|---|---|---|---|
| Самоувага | інформацію між токенами | ||
| MLP | інформацію всередині кожного токена |
MLP застосовується до кожного токена незалежно й однаково — це та сама маленька мережа, прогнана по всіх позиціях. Внутрішня розмірність зазвичай учетверо більша за
Отже, увага збирає контекст, а MLP його обробляє. Стек із
Повна архітектура трансформера
Ось усе разом. Ліва половина — енкодер: вкладення, позиційне кодування і
Права половина — декодер. У ньому три підблоки замість двох. Перший — маскована багатоголова увага, щоб не підглядати в майбутнє. Другий — увага енкодер-декодер: запити беруться з декодера, а ключі та значення — з виходу енкодера, тобто декодер «читає» закодований вхід. Третій — той самий FFN.
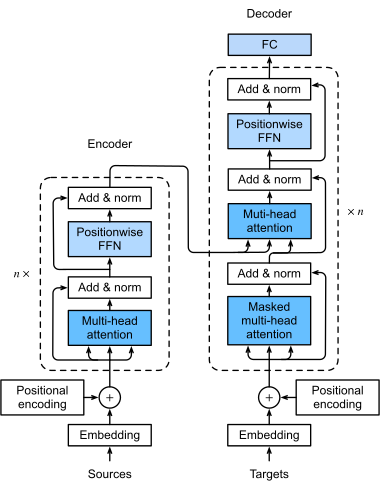
Джерело: Dive into Deep Learning · The Transformer Architecture
Стек блоків і потік даних у перекладі
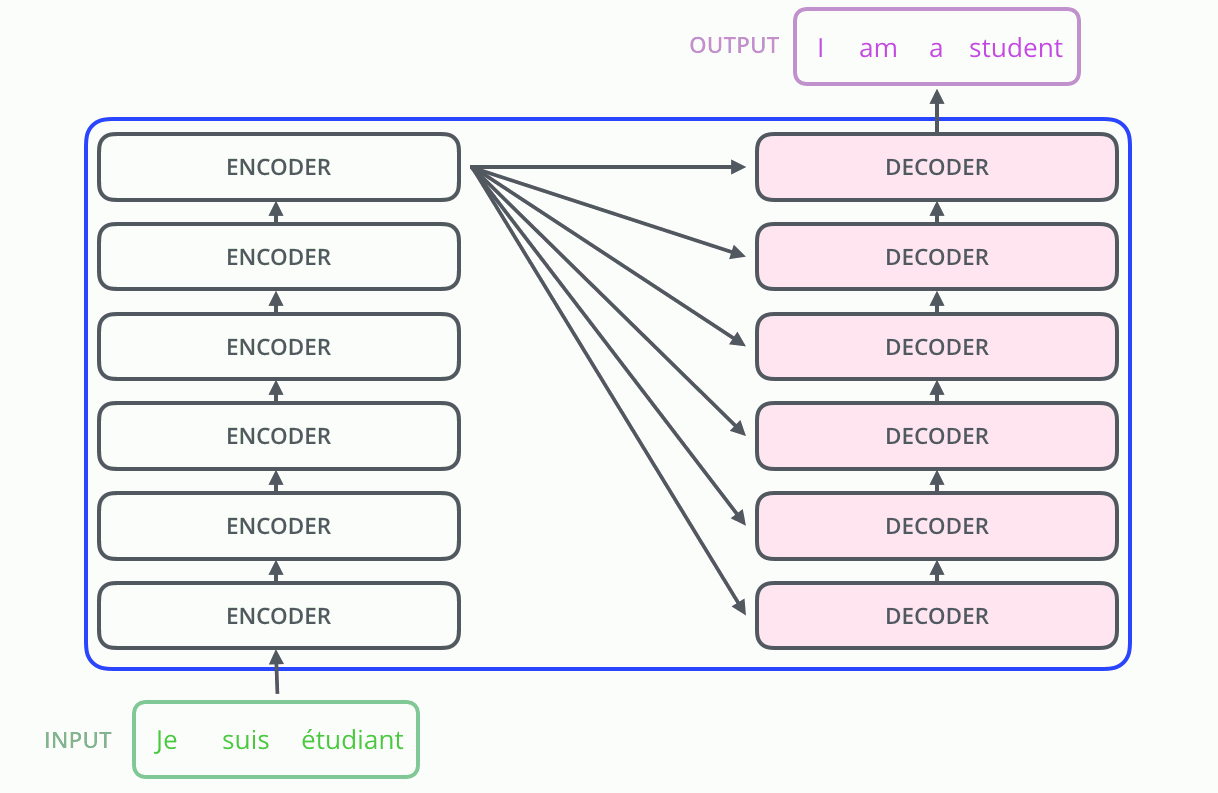
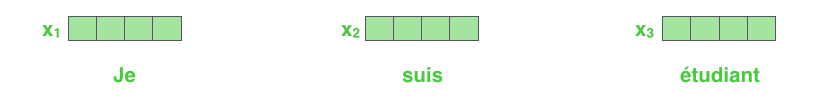
Та сама архітектура з іншого боку. Речення «Je suis étudiant» проходить крізь шість енкодерів; вихід останнього подається в усі шість декодерів, і ті породжують переклад по слову. Важлива деталь: блоки не діляться вагами — однакова будова, різні параметри, тож кожен наступний працює з дедалі абстрактнішими поданнями, як шари згорткової мережі.
Три способи вживати трансформер
Із тих самих блоків збирають три різні моделі, і вибір визначається задачею.
| Режим | Задачі | Як працює | Маскування |
|---|---|---|---|
| Лише енкодер | розмітка, класифікація тексту | усі токени обробляються одночасно, вихід фіксованого розміру | без маски: кожен бачить усіх |
| Лише декодер | генерація тексту, ChatGPT | авторегресивно: породити токен, дописати до входу, повторити | причинна маска |
| Енкодер-декодер | переклад, стислий переказ | спершу закодувати весь вхід, потім декодувати токен за токеном | маска лише в декодері |
Оригінальний трансформер був енкодером-декодером, бо його будували для перекладу; сучасні великі мовні моделі — переважно чисті декодери.
Чотири підходи до однієї задачі класифікації текстів
Курс збудував трансформер із нуля — і на цьому зазвичай зупиняються. Але справжня робота починається з чужої попередньо навченої моделі, тож порівняймо чесно. Задача: чотири категорії 20 Newsgroups, 2341 навчальний і 1558 тестових документів, звичайний процесор.
Вивід код запущено, вивід не редагувався
text
мішок слів: 0.9134На що дивитися: проста лінійна модель на мішку слів правильно класифікує 91,34 % тестових повідомлень — з цим числом порівнюватимемо трансформери в таблиці нижче.
| Підхід | Параметрів | Точність | Час навчання |
|---|---|---|---|
| мішок слів + логістична регресія | 20 тис. | 0,9134 | 0,5 с |
| наш трансформер із нуля | 1,5 млн | 0,6701 | 35 с |
| донавчений bert-tiny | 4,4 млн | 0,8646 | 13 с |
| донавчений distilbert | 67 млн | 0,9134 | 284 с |
Читайте таблицю знизу вгору. Донавчений distilbert із шістдесяти семи мільйонів параметрів після п'яти хвилин навчання дає рівно ту саму точність, що мішок слів за півсекунди. Трансформер, навчений із нуля на цих же двох тисячах документів, програє обом на двадцять пунктів.
Висновок не «трансформери не потрібні», а «модель обирають під обсяг даних і природу задачі». Категорії тут різняться самою лексикою: слова «orbit», «hockey» і «graphics» майже не перетинаються, а мішок слів саме лексику й міряє. Трансформер виграє там, де вирішує порядок і контекст — заперечення, іронія, довгі залежності, — і там, де документів не дві тисячі, а мільйони. На цій задачі його перевагу просто нема на чому показати, і чесніше це визнати, ніж підганяти висновок під моду.
Токен — це не завжди слово
Перш ніж мережа щось побачить, текст треба перетворити на числа. Це робить токенізатор: він ріже рядок на шматки зі свого фіксованого словника — часто це частини слів. Наприклад, «Transformers are awesome!» перетворюється на сім токенів, кожен зі своїм номером у словнику.
Далі номер токена замінюється рядком матриці вкладень
Той самий підхід працює і поза текстом. Зображення ріжуть на клаптики 16 × 16 пікселів, розгортають кожен у вектор довжини 768 і множать на спільну матрицю вкладень — виходить послідовність, з якою трансформер працює так само, як зі словами. Звідси й гасло «токенізуй усе»: одна архітектура для тексту, зображень і звуку.
Мовна модель учиться передбачати наступний токен
Найдивовижніше в сучасних мовних моделях — те, наскільки простим є їхнє навчання. Це звичайна багатокласова класифікація, де кількість класів дорівнює розміру словника.
Візьмімо рядок «The sun is shining, the weather is …». Кожному токену приписуємо мітку — токен, що йде за ним. Модель пропускає рядок крізь стек блоків із причинною маскою, бере контекстуалізоване подання кожної позиції, множить на матрицю розміру
Маска тут не деталь реалізації, а умова коректності: без неї модель, передбачаючи слово
Генерація: передбачити, дописати, повторити
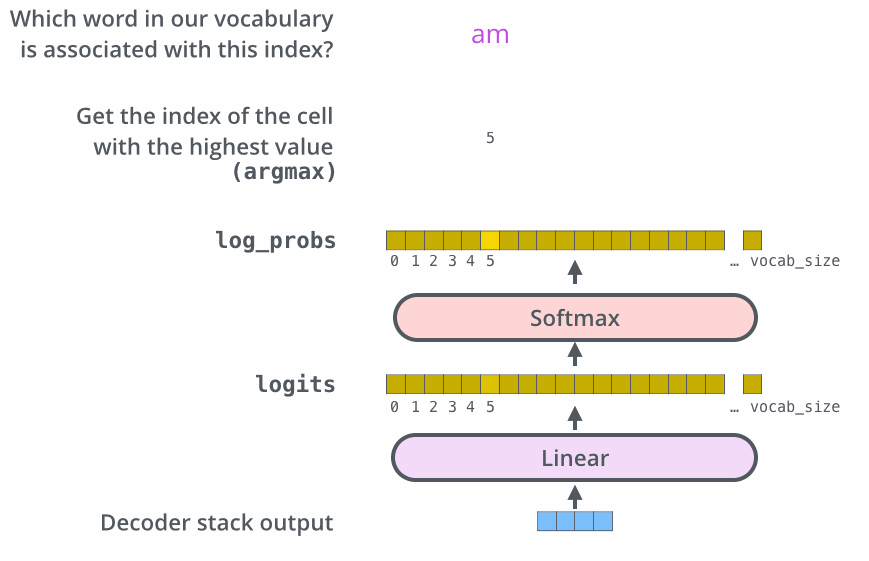
Навчену модель запускають у зворотний бік. Подання останнього токена множиться на матрицю виходу, softmax перетворює логіти на розподіл над словником, з нього беруть наступний токен — і дописують його до входу:
Далі все повторюється з подовженою послідовністю. Такий режим називають авторегресивним (autoregressive), і саме він дозволяє видавати відповіді довільної довжини: модель зупиняється тоді, коли сама породжує спеціальний токен кінця.
Вибір із розподілу, а не завжди найімовірнішого токена, — це те, що робить відповіді різними за однакового запиту.
Без кешу кожен новий токен перераховує всю відповідь заново
Цикл із попереднього розділу описано правильно, але рахувати так не можна. Дописавши токен, ми подаємо на вхід усю послідовність — і модель заново обчислює ключі та значення для всіх попередніх токенів, хоча вони не змінилися. Вартість генерації
Ліки називаються KV-кеш: ключі та значення кожного шару зберігають і дописують по одному вектору за крок.
Вивід код запущено, вивід не редагувався
text
модель: 4 блоки по 128 вимірів, параметрів 1 445 876На що дивитися: модель не навчена — нижче нас цікавить лише обсяг обчислень, а не якість тексту; понад третину з 1 445 876 параметрів займає таблиця позицій на 4096 місць.
Вивід код запущено, вивід не редагувався
text
64 нові токени з кешем і без кешу: ті самі
токенів  без кешу, с  з кешем, с   виграш   кеш, МБ
    128         0.24        0.09     2.6×      0.56
    512         1.93        0.61     3.2×      2.13
   1024         6.67        1.49     4.5×      4.23
На що дивитися: спершу перевірка, що кеш не змінює жодного токена; далі дивіться на стовпець «виграш»: він зростає з довжиною відповіді, бо без кешу кожен крок заново перераховує всю послідовність.
На нашій моделі з чотирьох блоків по 128 вимірів пришвидшення зростає разом із довжиною: ×2,6 на 128 нових токенах, ×3,2 на 512 і ×4,5 на 1024. Це не константа, а саме те, чого й слід чекати: без кешу вартість росте кубічно, з кешем — квадратично.
Плата — пам'ять. Кеш займає
Код: маленький трансформер, який учиться відтворювати послідовність
Зберімо все в працюючу модель. Задача навмисно проста: на вході вісім випадкових цифр, роздільник, і ті самі вісім цифр; модель має відтворити другу половину. Розв'язати її можна лише навчившись дивитися на потрібну позицію в першій половині — тобто саме увагою.
Вивід код запущено, вивід не редагувався
text
параметрів: 27659
крок  20: втрата 1.3729, точність 82.9 %
крок  90: втрата 0.0000, точність 100.0 %
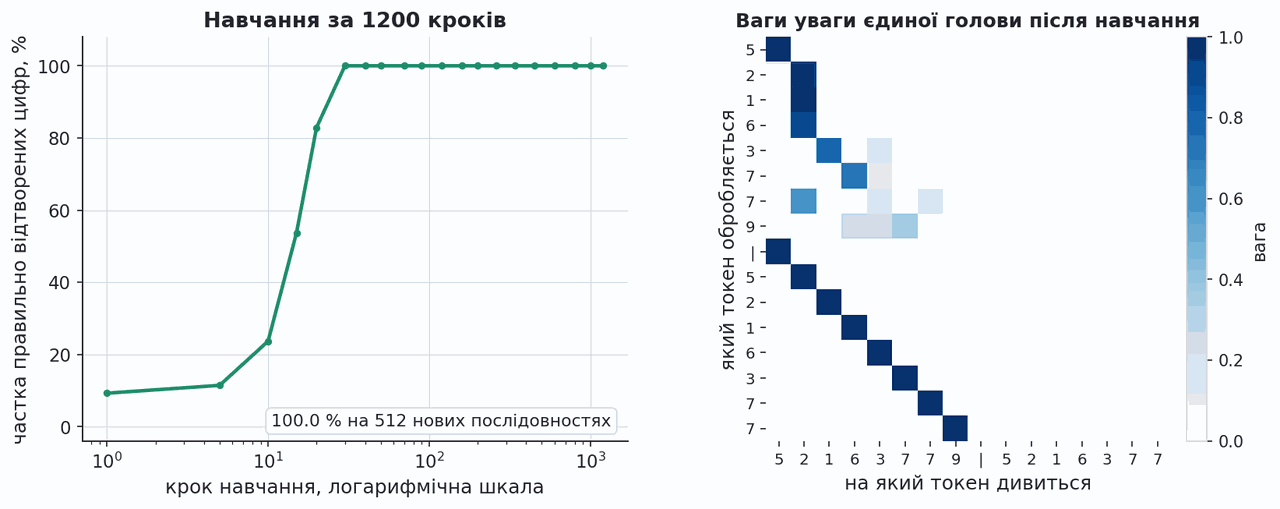
На що дивитися: за 20 кроків точність сягає 82,9 %, а до 90-го втрата падає до нуля й модель відтворює 100 % цифр у нових послідовностях.
Навчання займає секунди.
Що саме вивчила єдина голова уваги
Тепер найцікавіше — подивитися, як модель це зробила. Ліворуч крива навчання: за перші два десятки кроків точність стрибає з випадкових 10 % до 82,9 %, до дев'яностого кроку виходить на 100 %.
Праворуч — матриця ваг уваги на конкретній послідовності. Вище діагоналі матриця порожня — працює причинна маска. І чітко видно рівну похилу смугу: кожна позиція другої половини дивиться рівно на одну позицію першої, зсунуту так, щоб узяти саме ту цифру, яку треба вивести наступною. Позиція 12, наприклад, дивиться на позицію 4.
Мережа не отримувала жодних вказівок про структуру задачі. Вона знайшла потрібний патерн уваги сама — і це той самий тип механізму, який у великих моделях відповідає за копіювання імен, дат і цитат із контексту.
Числа оригінальної статті
Щоб мати відчуття масштабу, ось конфігурації з роботи «Attention Is All You Need» — вона вийшла на конференції NIPS 2017 (сучасну назву NeurIPS цій конференції дали пізніше).
| Гіперпараметр | Base | Big |
|---|---|---|
| Блоків у енкодері та декодері | 6 | 6 |
| 512 | 1024 | |
| Голів | 8 | 16 |
| 64 | 64 | |
| Внутрішня розмірність MLP | 2048 | 4096 |
| Dropout | 0,1 | 0,3 |
| Параметрів | 65 млн | 213 млн |
| BLEU, WMT 2014 англійська → німецька | 27,3 | 28,4 |
Навчання йшло на восьми GPU NVIDIA P100: base — 100 тисяч кроків приблизно за 12 годин, big — 300 тисяч кроків за три з половиною доби. За мірками 2017 року це був недорогий експеримент, і саме доступність відтворення пришвидшила поширення архітектури.
Джерело: Vaswani A. та ін., Attention Is All You Need, NIPS 2017
Обмеження трансформерів
Квадратична вартість за довжиною. Матриця
Потрібно дуже багато даних. Трансформер не має вбудованих припущень про структуру входу: ні локальності згортки, ні порядку рекурентної мережі. Свободу доводиться оплачувати даними, тому на малих вибірках згорткова мережа часто виграє.
Порядок доводиться повідомляти окремо. Позиційне кодування — це латка, і поводиться вона по-різному на послідовностях, довших за ті, що були під час навчання.
Впевнені хибні відповіді. Модель оптимізує правдоподібність продовження, а не істинність. Звідси вигадані факти й слабка багатокрокова логіка.
Ваги уваги — не пояснення. Висока вага не доводить причинного впливу: це підказка для аналізу, а не інтерпретація.
Підсумок лекції
Увага — це зважене середнє, ваги якого обчислюються з даних. Запит шукає, ключ відповідає, значення переноситься; softmax по рядку робить із оцінок розподіл.
Формула вміщується в один рядок:
Головна перевага — прямий шлях. Між будь-якими двома токенами один крок, тому нічого не забувається; у рекурентної мережі градієнт за першим токеном виявився меншим на тринадцять порядків. Ціна — матриця
Самоувага не бачить порядку — це доводиться перестановкою, і виправляється додаванням позиційного кодування до вкладень.
Блок трансформера робить дві різні речі: увага змішує інформацію між токенами, MLP — усередині кожного токена; залишкові зв'язки й нормалізація дозволяють ставити такі блоки десятками.
Мовна модель — це класифікатор наступного токена з причинною маскою, і вся генерація зводиться до повторення одного кроку.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекція 09a про трансформери
- UBC CPSC 340 — лекція 34: від LSTM до уваги
- Stanford CS231n — лекція про увагу й трансформери
Стаття, з якої все почалося
- Vaswani A. та ін. Attention Is All You Need, NIPS 2017
Пояснення й підручники
- J. Alammar. The Illustrated Transformer
- Dive into Deep Learning — розділ з кодом
- L. Weng. Attention? Attention!
Код і документація
- PyTorch · nn.MultiheadAttention
- A. Karpathy. nanoGPT — мінімальна реалізація GPT