Тема
Лекція 10 · Нейронні мережі та зворотне поширення
У лекції 05 ми закінчили softmax-регресією і побачили, що її можна намалювати як мережу з одного шару. Сьогодні поставимо між входом і виходом ще один шар — і подивимось, що це змінює. Робочий матеріал: 70 000 рукописних цифр MNIST.
Зміст лекції
Лекція проходить шлях від однієї лінійної моделі до мережі, яка вчить ознаки сама.
- Від нейрона до мережі. Логістична регресія як один нейрон, її стеля на реальних даних і те, навіщо потрібен прихований шар.
- Будова мережі. Шари, ваги, функції активації, ширина і глибина.
- Виражальна сила. Теорема про універсальну апроксимацію, її доведення картинкою і її справжні межі.
- Зворотне поширення. Прямий прохід, ланцюгове правило, рекурсія сигналів похибки і чисельна перевірка градієнта.
- Навчання на практиці. Ініціалізація, затухання градієнтів, крок навчання, розмір батчу, момент і Adam.
- Результат і його читання. Криві навчання, матриця похибок, помилки моделі та навчені шаблони.
Кожен блок відповідає на питання, яке залишив попередній: спершу з'ясуємо, чого бракує лінійній моделі, потім побудуємо мережу, доведемо, що вона достатньо виразна, навчимося рахувати її градієнт і аж тоді запустимо навчання.
Чого ви навчитеся
Після цієї лекції ви зможете:
- пояснити, чому стек лінійних шарів без нелінійності залишається лінійною моделлю;
- записати прямий прохід повнозв'язної мережі і порахувати кількість її параметрів;
- обрати функцію активації і пояснити вибір через графік її похідної;
- сформулювати теорему про універсальну апроксимацію разом із її обмеженнями;
- вивести рекурсію зворотного поширення і пояснити, чому вона коштує стільки ж, скільки прямий прохід;
- перевірити власну реалізацію градієнта скінченними різницями;
- навчити багатошаровий перцептрон на MNIST у PyTorch і прочитати його криві навчання;
- пояснити вплив ініціалізації, кроку навчання, розміру батчу й моменту на результат.
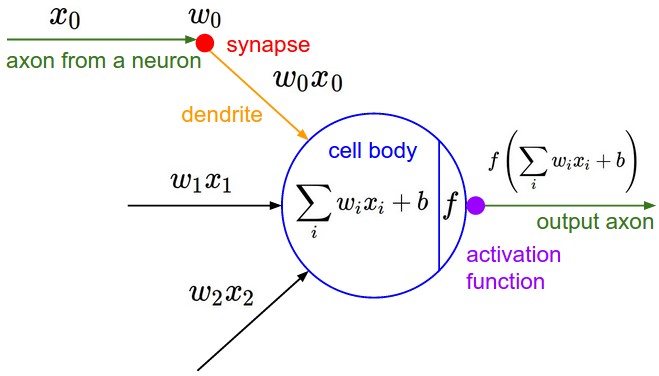
Логістична регресія — це один нейрон
Почнемо з того, що вже знайоме. Логістична регресія бере ознаки
Нове тут лише слово:
Дані лекції: рукописні цифри MNIST
MNIST — 70 000 зображень рукописних цифр розміром 28×28 пікселів у відтінках сірого: 60 000 для навчання й 10 000 для тесту. Кожен піксель стає окремою ознакою, тому вхід моделі — вектор із 784 чисел. Передбачаємо, яка саме цифра від 0 до 9 зображена.
Ми ділимо офіційну тренувальну частину на 50 000 зразків для навчання і 10 000 для валідації, а офіційні 10 000 тестових чіпаємо лише наприкінці. Пікселі стандартизуємо: ділимо на 255, віднімаємо середнє 0,1307 і ділимо на стандартне відхилення 0,3081.
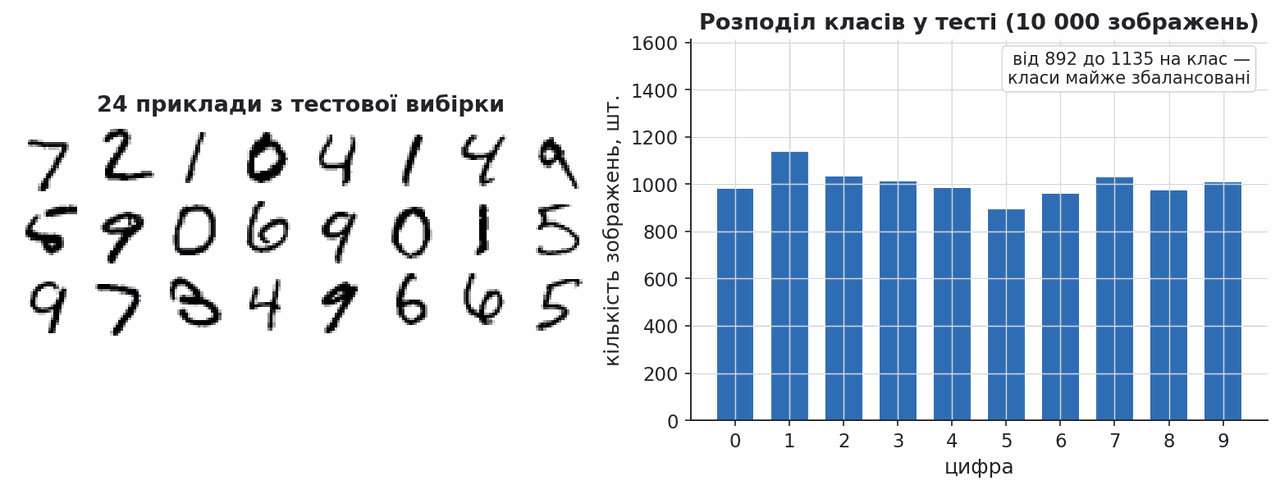
Джерело даних: OpenML · mnist_784
Базова лінія: лінійна модель на всьому MNIST
Перш ніж будувати мережу, треба знати, що дає найпростіша модель. Мультиноміальна логістична регресія з лекції 05 має тут 7 850 параметрів: по 784 ваги й один зсув на кожен із десяти класів.
Вивід код запущено, вивід не редагувався
text
ітерацій до збіжності: 657
частка правильних на тесті: 0.9224
На що дивитися: планка лінійної моделі — 92,24 % правильних відповідей на тесті; кожна наступна мережа лекції має її перевершити.
Інакше кажучи, це 776 помилок на 10 000 зображень. Це число ми пам'ятатимемо до кінця лекції.
Лінійна модель має один шаблон на клас
Чому 92 %, а не більше. Ваги лінійної моделі можна перерисувати назад у форму зображення 28×28 — і тоді видно, що модель вивчила: рівно один усереднений шаблон на кожну цифру. Червоне означає «цей піксель свідчить за клас», синє — «проти».
Такий шаблон працює, поки цифра написана «як усі». Але сімка з рискою і сімка без риски — це два різні розташування чорнила, а шаблон у моделі один, і він мусить бути компромісом між ними. Збільшити кількість шаблонів у межах лінійної моделі неможливо: у неї рівно один вектор ваг на клас.
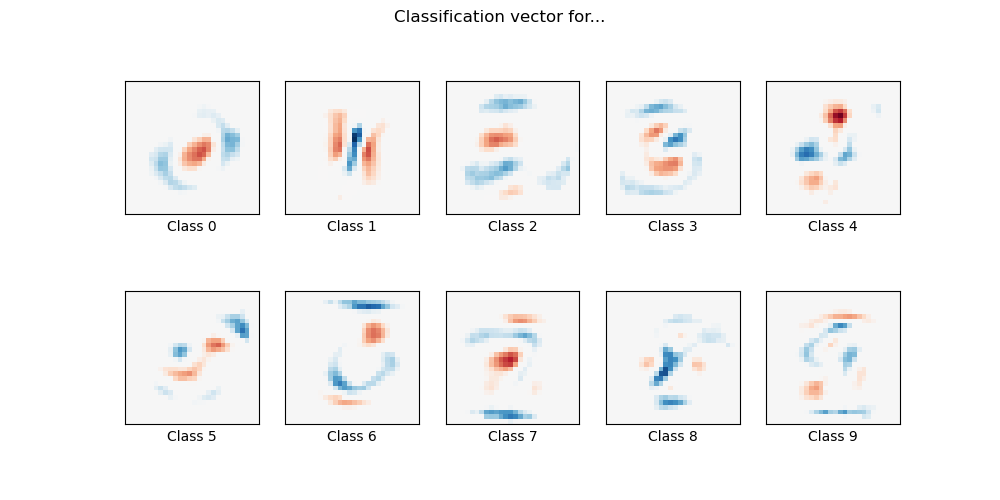
Джерело: scikit-learn · MNIST classification using multinomial logistic + L1
Два лінійні шари поспіль дають один лінійний
Напрошується просте рішення: поставити один лінійний шар за іншим. Нехай перший шар обчислює
Добуток двох матриць — знову матриця. Скільки б лінійних шарів ми не поставили, уся конструкція згортається в одну лінійну модель із тією самою виражальною силою і тим самим одним шаблоном на клас. Кількість параметрів зросла, можливості — ні.
"Important: φ is non-linear — otherwise we can only represent linear functions." — EPFL CS-433, лекція 07b
Отже, між шарами обов'язково має стояти нелінійна функція. Саме вона перетворює стек матриць на щось нове.
Прихований шар згинає межу рішення
Подивимось на цей ефект у двох вимірах, де межу рішення видно очима. Дані згенеровано як два переплетені півмісяці — задача, у якій жодна пряма не дає доброго розділення.
Ліворуч логістична регресія: вона проводить пряму й помиляється на 11,5 % точок, бо кінці півмісяців неминуче потрапляють не на свій бік. Праворуч мережа з одним прихованим шаром на 32 нейрони з активацією ReLU: та сама вихідна логістична одиниця, але тепер вона працює не з сирими
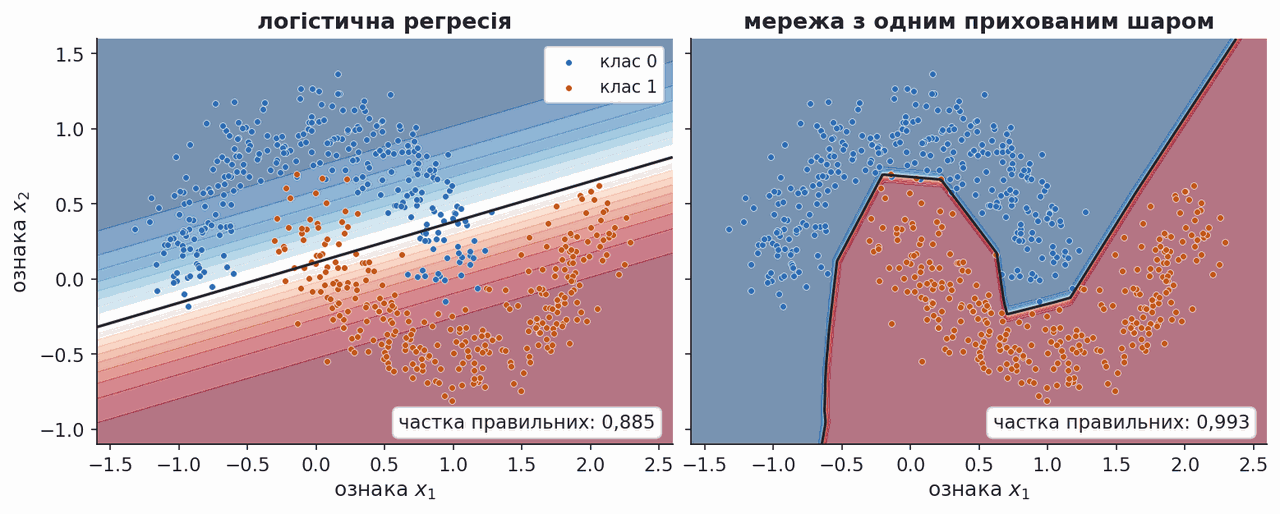
Ключова думка: останній шар мережі залишився лінійним класифікатором. Змінилося те, у якому просторі він працює.
Багатошаровий перцептрон: будова мережі
Багатошаровий перцептрон (multilayer perceptron, MLP) складається з вхідного шару, одного або кількох прихованих шарів (hidden layers) і вихідного шару. Мережу називають повнозв'язною (fully connected), коли кожен вузол шару з'єднаний з усіма вузлами попереднього.
Прихований шар не має власної мітки в даних: ми ніде не вказуємо, що саме він мусить обчислювати. Значення його нейронів визначаються тільки тим, що з ними зручно робити наступному шару, — звідси й назва.
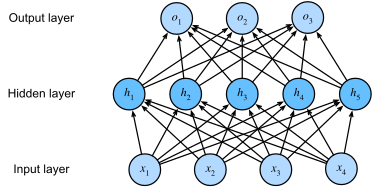
Один шар мережі — одна формула
Шар
| Позначення | Значення |
|---|---|
| вхід мережі; для MNIST — 784 стандартизовані пікселі | |
| передактивації шару | |
| активації шару | |
| матриця ваг і вектор зсувів шару | |
| ширина шару, тобто кількість нейронів у ньому | |
| кількість прихованих шарів; вихідний має номер |
У курсі буквою
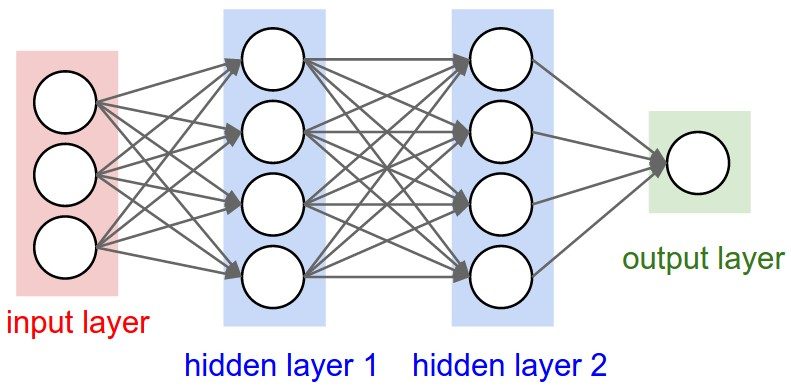
Глибина: кілька прихованих шарів підряд
Прихованих шарів може бути більше одного. Кожен наступний працює з ознаками, які побудував попередній, і будує з них складніші.
Ціна глибини — параметри. Для мережі з входом розмірності
Функції активації та їхні похідні
Три класичні активації: сигмоїда
Похідна активації входить множником у кожен крок ланцюгового правила. У сигмоїди вона не перевищує
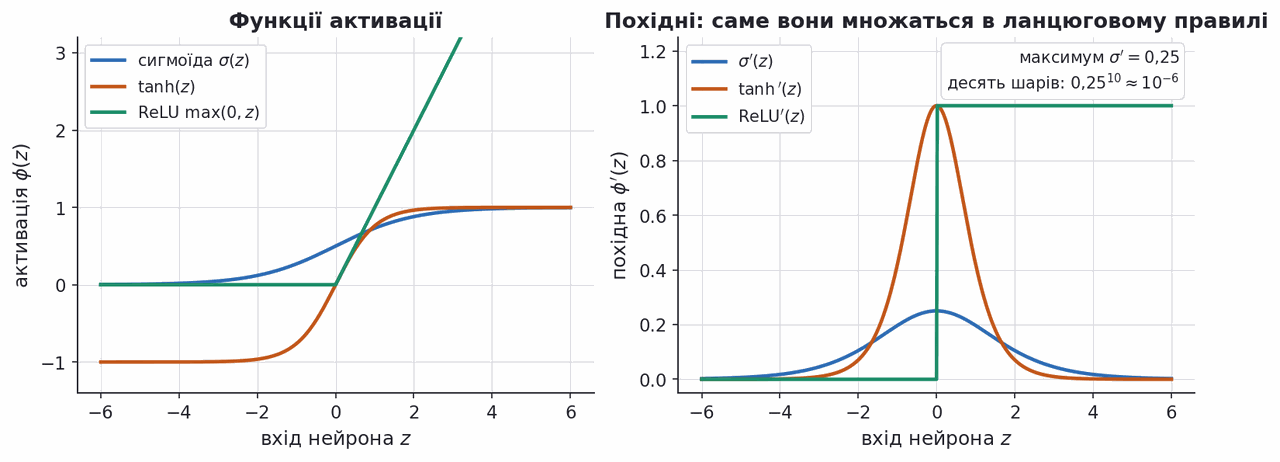
Сьогодні за замовчуванням беруть ReLU, а в трансформерах — її гладку родичку GELU,
Чому похідна активації важливіша за саму активацію
Ліва панель — самі функції, права — їхні похідні. Похідна входить множником у кожен крок ланцюгового правила, тому в глибокій мережі перемножується сама на себе стільки разів, скільки шарів.
функція φ(z)
похідна φ′(z)
| активація | φ′(z) у точці | множник після 10 шарів |
|---|---|---|
| сигмоїда | 0,0701 | 2,9 · 10⁻¹² |
| tanh | 0,0266 | 1,8 · 10⁻¹⁶ |
| ReLU | 1,0000 | 1,0000 |
0,113множник на один шар
1,2 · 10⁻¹⁹після двадцяти шарів по 256
0,088σ за He: множник рівно 1
Друга половина вставки — про те, з чого мережа починає. Для шару з 256 входами стандартне відхилення сигналу множиться на σ·√(n/2) за шар, тож усе вирішує геометрична прогресія. Поставте σ = 0,01: множник 0,113, і через двадцять шарів від сигналу лишається 10⁻¹⁹ — той самий порядок, що дає прямий вимір на такій мережі, 3,5·10⁻²⁰ (оцінка дисперсійна, тож збігається за порядком, а не до цифри). Поставте σ = 0,2 — і сигнал навпаки виростає в мільйони разів. Між цими двома катастрофами є рівно одне значення, за якого множник дорівнює одиниці: σ = √(2/n) = 0,088, та сама ініціалізація He з розділу вище. Тепер видно, що вона не «вдалий емпіричний вибір», а єдиний розв'язок рівняння σ·√(n/2) = 1.
Поставте z = 0 — це найкраще, що може дати сигмоїда: похідна рівно 0,25, і вже через десять шарів множник падає до 10⁻⁶. Це і є зникаючий градієнт: перші шари майже не отримують сигналу. У ReLU на додатному боці похідна дорівнює одиниці, тому множник лишається одиницею на будь-якій глибині — але зсуньте z у від'ємну зону, і вона стане строго нулем: нейрон «помирає» і більше не навчається. GELU згладжує цей злам, тому її беруть у трансформерах.
Ширина прихованого шару керує складністю межі
Скільки нейронів класти в прихований шар — це рішення про складність моделі, і воно має ту саму природу, що й вибір степеня полінома в лекції 03.
На рисунку одна й та сама двовимірна задача розв'язана мережами з трьома, шістьма і двадцятьма прихованими нейронами. Три нейрони дають майже пряму межу й недонавчання: модель не встигає за формою даних. Двадцять нейронів вирізають окремі острівці навколо поодиноких точок — це вже перенавчання. Шість дають розумний компроміс.
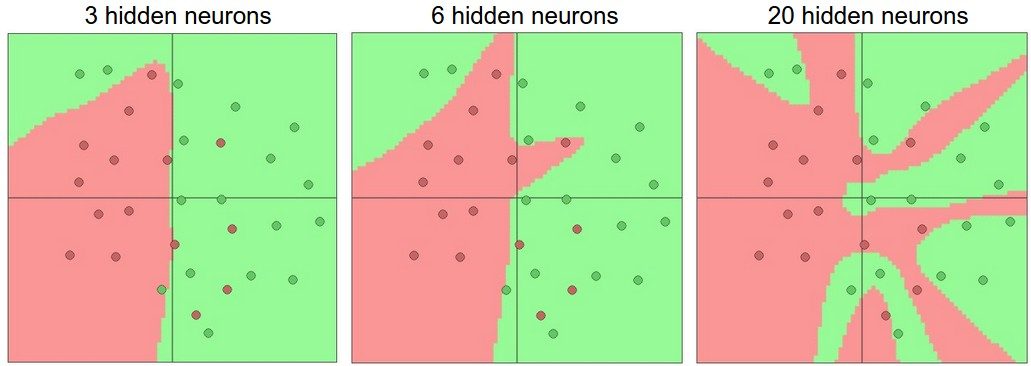
Важлива практична поправка: ширину рідко обмежують заради узагальнення. Ефективніше взяти шар із запасом і стримати його регуляризацією — до цього ми повернемось наприкінці лекції.
Джерело: Stanford CS231n · Neural Networks Part 1
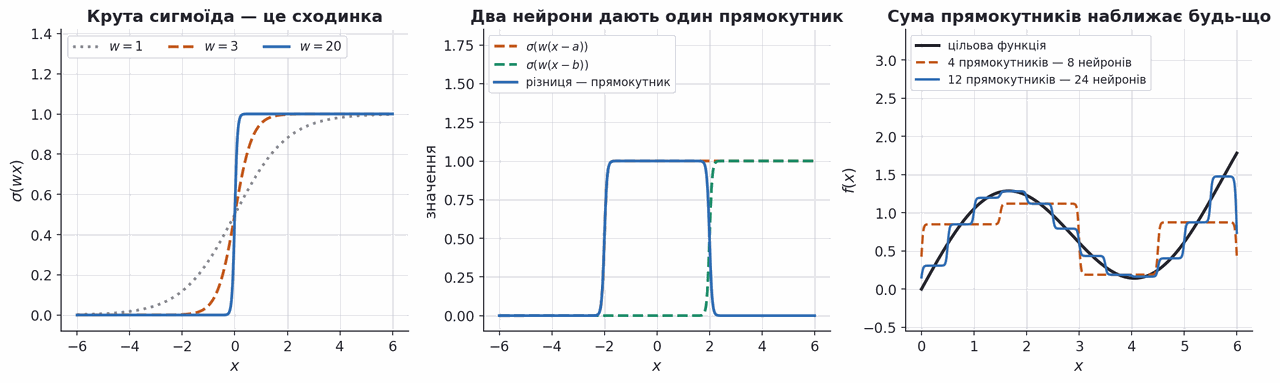
Універсальна апроксимація: доведення картинкою
Наскільки складну функцію здатна відтворити мережа з одним прихованим шаром. Відповідь дає побудова з трьох кроків, яку можна просто намалювати.
Крок перший. Сигмоїда
Крок другий. Різниця двох сходинок, зсунутих у точки
Крок третій. Будь-яку неперервну функцію на відрізку можна наблизити сумою прямокутників — це звичайна сума Рімана. Отже,
Теорема Барона про виражальну силу
Побудову вище можна зробити точною оцінкою. Нехай
Тут
Читається формула так. Похибка спадає як
Джерело результату: A. R. Barron, Universal approximation bounds for superpositions of a sigmoidal function, IEEE Trans. Inf. Theory, 1993.
Мережа з ReLU — це ламана лінія
З ReLU замість сигмоїди картина ще прозоріша. Кожен нейрон
Ліва панель показує внески восьми прихованих нейронів окремо, права — їхню суму поверх цільової кривої. Мережу навчено на 400 точках, шість зламів потрапили всередину показаного відрізка, середньоквадратична похибка становить 0,0070.
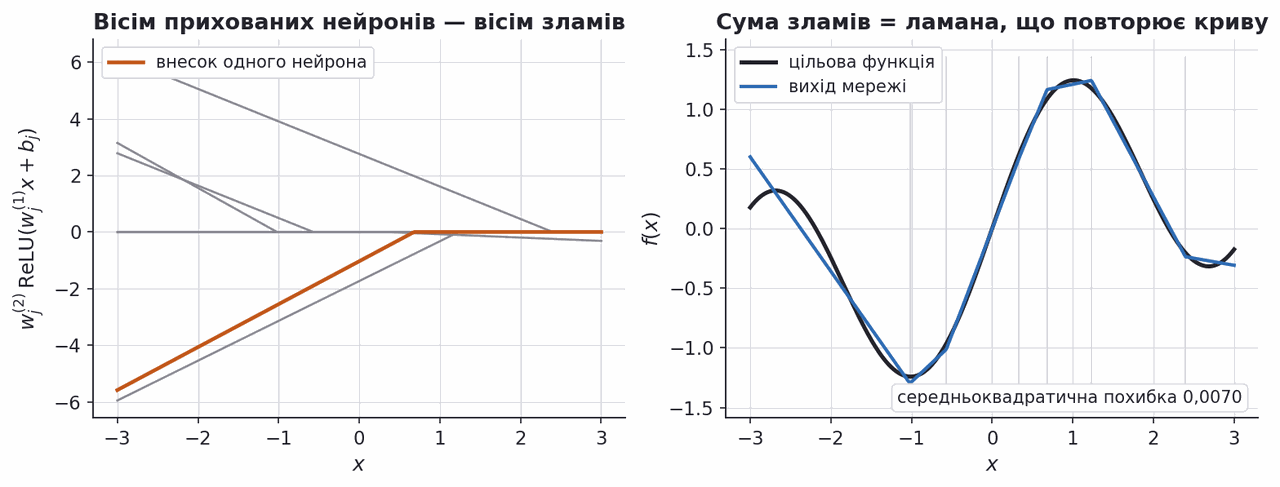
Оскільки будь-яку неперервну функцію на відрізку можна рівномірно наблизити кусково-лінійною, звідси випливає та сама універсальність — але вже з рівномірною, а не середньоквадратичною похибкою.
Межі теореми про універсальну апроксимацію
Теорему часто цитують як доказ всемогутності мереж. Насправді вона стверджує значно менше, і три застереження варто знати напам'ять.
Розмір мережі мусить рости з кількістю даних. Мережа фіксованого розміру універсальним апроксиматором не є: щоб похибка прямувала до нуля, кількість нейронів має зростати разом із обсягом вибірки. Тобто мережа поводиться як непараметрична модель, а не як компактна формула.
Теорема нічого не каже про навчання. Вона гарантує, що потрібні ваги існують, і мовчить про те, чи знайде їх градієнтний спуск за розумний час.
Теорема нічого не каже про узагальнення. Вона обмежує інтегральну похибку наближення відомої функції на заданій області. У реальній задачі ми цієї функції не знаємо, маємо скінченну вибірку з неї — і питання, як модель поводитиметься на нових точках, лишається тим самим, яким займалася лекція 03.
Саме тому глибина на практиці корисніша за ширину: глибокі мережі досягають тієї самої точності зі значно меншою кількістю параметрів, а отже потребують менше даних.
| Теорема гарантує | Теорема не гарантує |
|---|---|
| потрібна мережа існує | що градієнтний спуск її знайде |
| одного прихованого шару досить | що ширина буде розумною — вона може зростати експоненційно |
| наближення на компакті | поведінку за межами області, де були дані |
| наближення самої функції | що узагальнення буде добрим на нових даних |
Практичний наслідок один: теорема пояснює, чому мережі варто пробувати, і нічого не каже про те, як їх навчати. Усе інше в цій лекції — саме про друге.
Прямий прохід: від пікселів до ймовірностей
Прямий прохід (forward pass) — послідовне обчислення всіх
Останній шар мережі й функція втрат залежать від задачі, а все, що до них, лишається незмінним. Позначимо
| Задача | Прогноз | Функція втрат |
|---|---|---|
| Регресія, | ||
| Бінарна класифікація, | ||
Для MNIST працює третій рядок — softmax із перехресною ентропією, точно той самий, що в лекції 05. Мережа змінила не вихід, а те, що подається на його вхід. У другому рядку мітки записані як
Навчання мережі — невипукла задача
У лекції 05 функція втрат логістичної регресії виявилася опуклою, і це давало залізну гарантію: градієнтний спуск із будь-якої початкової точки приходить у той самий єдиний мінімум. Для мережі ця гарантія зникає.
Втрати мережі опуклі за вагами останнього шару, якщо решту зафіксувати. Але одночасно за всіма вагами задача невипукла, і пошук глобального мінімуму в загальному випадку NP-складний. Практика тим не менш працює: градієнтний спуск стабільно знаходить локальні мінімуми, якість яких на реальних задачах виявляється цілком прийнятною. Теоретичного пояснення цьому досі немає — це одне з відкритих питань галузі.
Один позитивний факт усе ж є. Додавши до мережі прямий зв'язок від входу до виходу й занулівши ваги прихованого шару, дістаємо рівно розв'язок логістичної регресії: клас функцій мережі містить лінійну модель. Але чи знайде конкретний запуск щось не гірше — не гарантовано: при завеликому кроці спуск здатен і збільшити втрати.
Зворотне поширення: ланцюгове правило з пам'яттю
Щоб зробити крок спуску, потрібні похідні втрат за всіма 203 530 параметрами. Наївне застосування ланцюгового правила до кожної ваги окремо перераховувало б ті самі проміжні добутки тисячі разів.
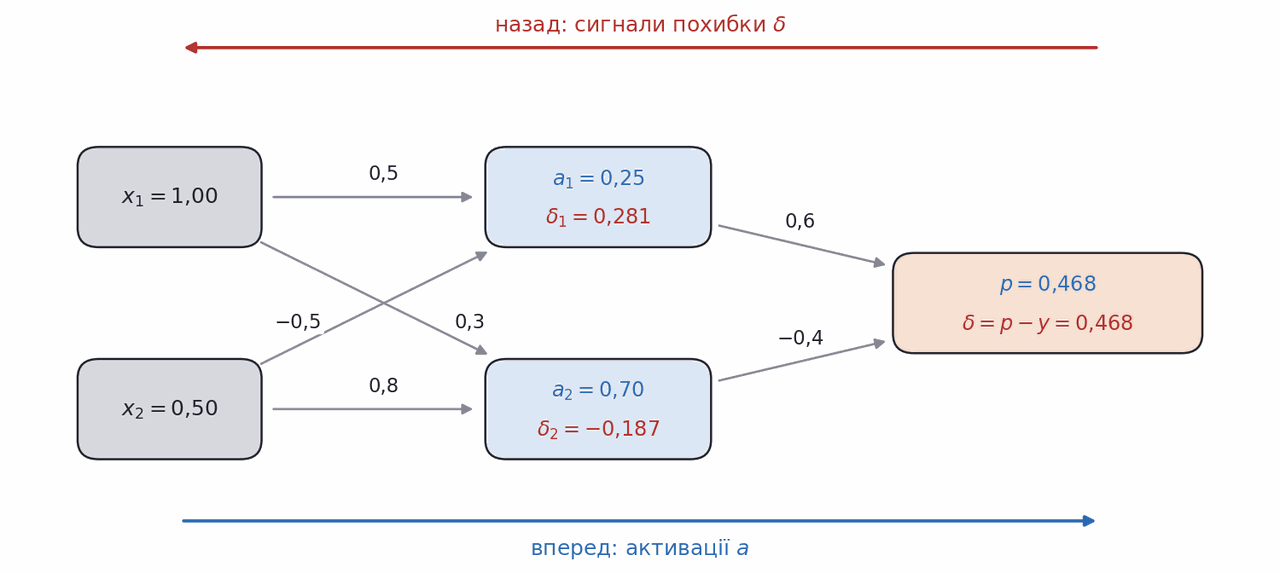
Зворотне поширення (backpropagation) — це те саме ланцюгове правило, але з перевикористанням проміжних обчислень. Ключова величина — сигнал похибки нейрона
На рисунку мережа 2-2-1 з активацією ReLU і сигмоїдою на виході. Синім показано прямий прохід зі входу
Рекурсія назад і три похідні
Алгоритм складається з трьох формул. Спершу сигнал похибки на виході — для softmax із перехресною ентропією він має знайому форму «прогноз мінус мітка»:
Далі сигнал біжить назад, шар за шаром, домножуючись на транспоновану матрицю ваг і на похідну активації (
І нарешті самі похідні, заради яких усе робилося:
Зворотний прохід коштує
Зворотний прохід по мережі 2-2-1
Та сама мережа й ті самі ваги, що в коді розділу. Клацніть будь-який нейрон — і побачите його сигнал похибки δ та похідні всіх ваг, які в нього входять. Усе рахується тут за трьома формулами вище.
Правильна відповідь y
вихідний нейрон
z = -0,1300 · p = σ(z) = 0,4675
δ = p − y = 0,4675 − 0 = 0,4675
∂L/∂w₁ = δ · a₁ = 0,1169
∂L/∂w₂ = δ · a₂ = 0,3273
∂L/∂b = δ = 0,4675
0,4675прогноз p
0,6303втрати до кроку
0,3879втрати після кроку η = 0,5
0,4675δ на виході
За замовчуванням тут ті самі числа, що друкує код розділу: p = 0,4675, втрати 0,6303, а після одного кроку спуску — 0,3215 і 0,3879. Клацніть прихований нейрон: його δ дорівнює вазі до виходу, помноженій на δ виходу й на похідну ReLU. Саме тому сигнал похибки й називають сигналом — він справді тече назад тим самим графом, тільки в інший бік. Тепер зсуньте x₁ у мінус. Один із прихованих нейронів почервоніє: його z стало від'ємним, ReLU′ дорівнює нулю, і всі похідні його ваг обнулилися. На одному прикладі це тимчасово, але якщо так стається на всіх — нейрон мертвий назавжди, і саме цей механізм дає 227 із 256 у розділі 32.
Код: autograd підтверджує ручний розрахунок
Числа з попередніх розділів легко перевірити. PyTorch будує обчислювальний граф автоматично, а backward() проходить його тим самим алгоритмом.
Вивід код запущено, вивід не редагувався
text
p = 0.4675   втрати = 0.6303
dL/dW1 = [[0.2805, 0.1403], [-0.187, -0.0935]]
dL/dW2 = [0.1169, 0.3273]
після кроку: p = 0.3215   втрати = 0.3879
На що дивитися: градієнти autograd збігаються з ручним розрахунком на схемі, а один крок спуску знижує втрати з 0,6303 до 0,3879.
Один крок спуску з
Код: мережа з нуля на numpy
Тепер повний цикл без жодної бібліотеки глибокого навчання: мережа 64–32–10 на наборі Digits — 1797 рукописних цифр у форматі 8×8, тобто вдванадцятеро менше пікселів, ніж у MNIST, і навчання за частку секунди. У цих рядках видно всі формули з попередніх розділів.
Вивід код запущено, вивід не редагувався
text
втрати до навчання: 2.8176
втрати після 400 кроків: 0.0175
частка правильних на тесті: 0.9756
На що дивитися: втрати падають із 2,8176 до 0,0175 за 400 кроків, і мережа без жодної бібліотеки правильно розпізнає 97,56 % тестових цифр.
Чотири рядки в тілі циклу — це і є весь backprop.
Код: перевірка градієнта скінченними різницями
Реалізація градієнта вручну — найпоширеніше джерело мовчазних помилок: мережа навчається, але гірше, ніж могла б. Перевірка проста. Похідну можна оцінити чисельно, і якщо аналітична формула правильна, два числа мають збігтися з точністю до похибки округлення.
Вставимо перевірку перед циклом навчання, використавши forward і loss із попереднього розділу.
Вивід код запущено, вивід не редагувався
text
найбільша відносна розбіжність: 4.85e-07На що дивитися: розбіжність близько 5·10⁻⁷ лежить у межах похибки скінченних різниць, тож ручний backprop правильний; помилка у формулі дала б розбіжність від 10⁻² і більше.
Два правила, без яких перевірка нічого не варта: рахувати в подвійній точності float64 і брати центральну різницю — однобічна дає похибку порядку
Аналітичний градієнт збігається з чисельним
Результат перевірки на 120 випадкових вагах обох шарів. Ліва панель: кожна точка — одна вага, по горизонталі аналітичний градієнт, по вертикалі чисельний. Усі точки лежать на діагоналі, найбільша відносна розбіжність становить
Права панель пояснює, чому крок float64 припадає приблизно на
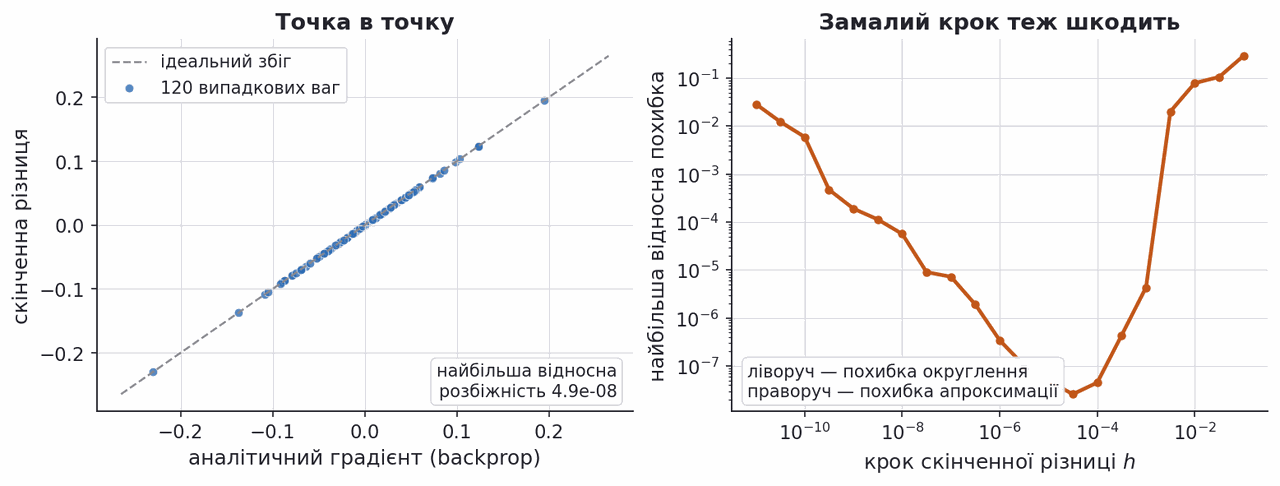
Орієнтир для практики: відносна розбіжність порядку
Код: та сама мережа через PyTorch
У робочому коді градієнти ніхто не виписує вручну. PyTorch запам'ятовує кожну операцію над тензорами й будує обчислювальний граф, а loss.backward() проходить його зворотним ходом — тим самим алгоритмом, який ми щойно написали руками.
Вивід код запущено, вивід не редагувався
text
частка правильних на тесті: 0.9711На що дивитися: PyTorch дає 97,11 % проти 97,56 % у реалізації з нуля — різниця лише від іншого порядку батчів.
Це та сама модель і той самий алгоритм, просто градієнт тепер рахує бібліотека.
Джерело: PyTorch · Autograd
Ініціалізація ваг задає долю глибокої мережі
Нулями ініціалізувати мережу не можна: усі нейрони шару отримають однаковий градієнт і назавжди залишаться копіями одне одного. Ваги беруть випадковими, і питання лише в масштабі.
Експеримент на рисунку: випадковий вхід проходить через двадцять шарів ReLU ширини
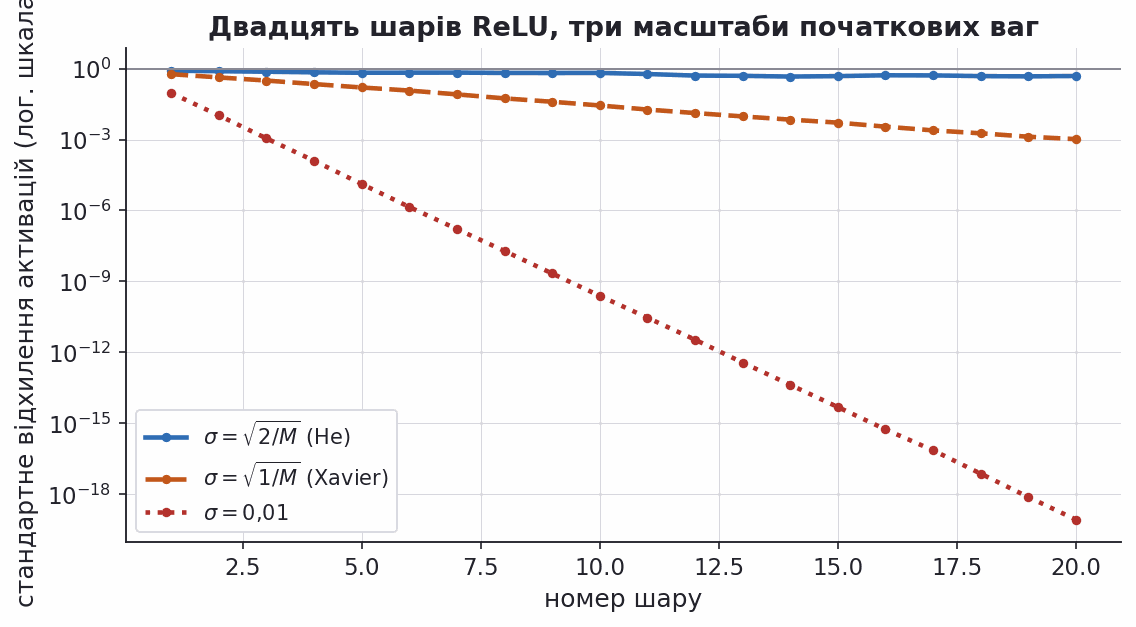
Двійка в чисельнику компенсує те, що ReLU обнуляє приблизно половину входів. Це дисперсійна оцінка: вона припускає незалежні ваги з нульовим середнім, симетричний розподіл передактивацій і досить широкий шар. Джерело: K. He et al., Delving Deep into Rectifiers, CVPR 2015.
Затухання і вибух градієнтів
Та сама проблема, але на зворотному ході. Кожен крок рекурсії домножує сигнал похибки на
На рисунку один зворотний прохід через мережу з десяти прихованих шарів ширини 64. Із сигмоїдою норма градієнта в першому шарі становить
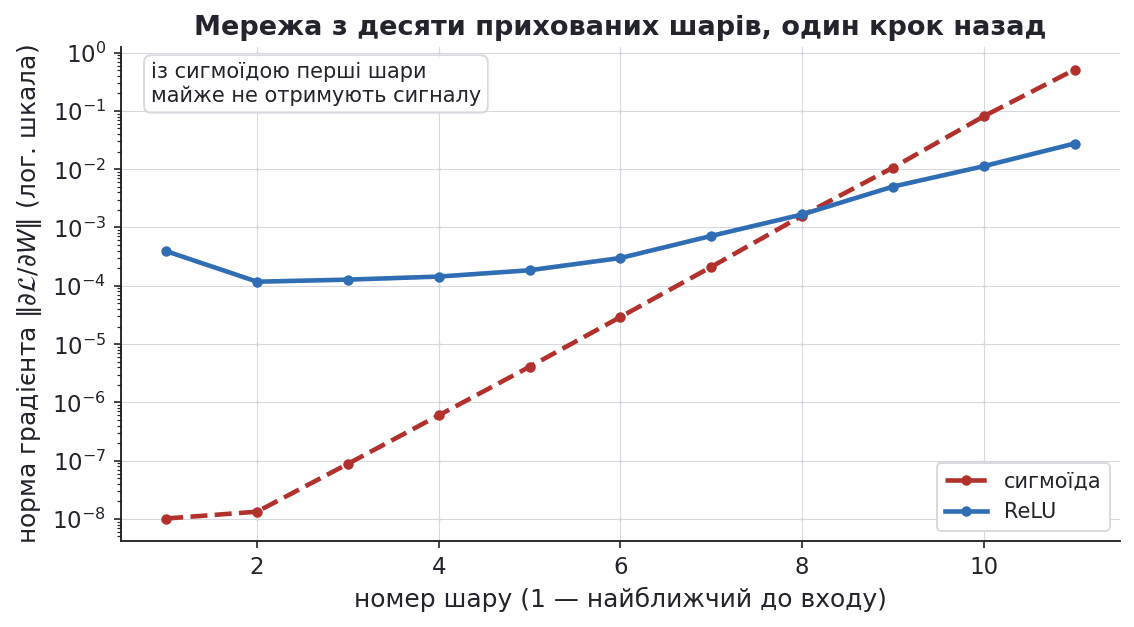
Ліки відомі й діють разом: ненасичувані активації, акуратна ініціалізація, шари нормалізації та прямі зв'язки в обхід шарів. Останні два інструменти детально розберемо в лекції 11.
Код: MNIST у PyTorch від початку до кінця
Усе разом: дані, модель, цикл навчання, оцінювання. Мережа 784–256–10 з активацією ReLU, стохастичний градієнтний спуск із кроком 0,1 і міні-батчами по 128 зразків.
Вивід код запущено, вивід не редагувався
text
епоха  1   валідація 0.9467
епоха  2   валідація 0.9627
епоха  3   валідація 0.9695
епоха  4   валідація 0.9734
епоха  5   валідація 0.9748
епоха  6   валідація 0.9762
епоха  7   валідація 0.9741
епоха  8   валідація 0.9767
епоха  9   валідація 0.9759
епоха 10   валідація 0.9784
епоха 11   валідація 0.9787
епоха 12   валідація 0.9801
епоха 13   валідація 0.9784
епоха 14   валідація 0.9788
епоха 15   валідація 0.9793
тест: 0.9806
На що дивитися: валідаційна точність швидко росте лише перші п'ять епох, далі коливається біля 0,98; тест, 0,9806, не гірший за валідацію, тож перенавчання немає.
Усі п'ятнадцять епох відпрацювали на звичайному процесорі за кілька секунд — жодного графічного прискорювача для задачі такого розміру не потрібно.
Криві навчання на MNIST
Числа з попереднього розділу зручніше читати графіком. Ліва панель — перехресна ентропія по епохах, права — частка правильних відповідей; сірою пунктирною лінією показано базову логістичну регресію.
Мережа переганяє лінійну модель уже після першої епохи: 94,67 % проти 92,39 % на тій самій валідаційній вибірці. Після п'ятнадцяти епох валідаційна точність становить 97,93 %, тестова — 98,06 %. Кількість помилок на тесті впала з 776 до 194, тобто вчетверо.
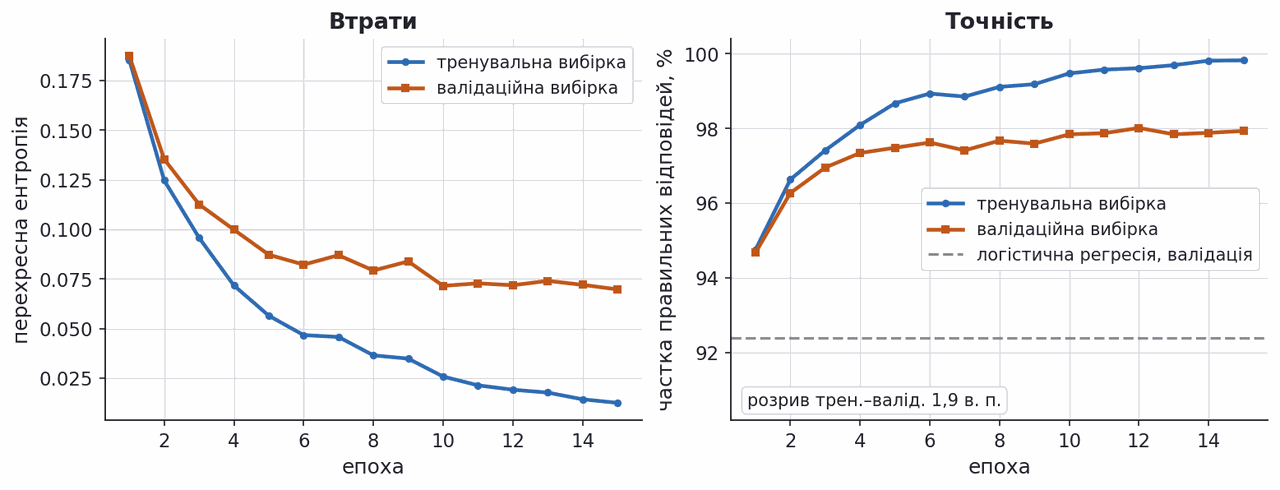
Тренувальні втрати спадають до 0,0126 (міряно на перших 10 000 навчальних зразків), валідаційні застигають близько 0,07 і далі не рухаються — модель вичавила з цієї архітектури майже все. Розрив між кривими становить 1,9 відсоткового пункту.
Розрив між тренуванням і валідацією
Форма пари кривих — головний діагностичний інструмент під час навчання, і читати її треба так.
Криві йдуть поруч і обидві високі — модель у балансі; якщо є час і дані, можна брати більшу мережу.
Тренувальна росте, валідаційна відстає — перенавчання. Що більший розрив, то сильніше модель запам'ятовує окремі зразки замість закономірностей.
Валідаційна пішла вниз — модель почала псуватися; найдешевша реакція — рання зупинка на найкращій епосі.
Обидві криві низькі — недонавчання: замалий крок, замало епох або замала мережа.
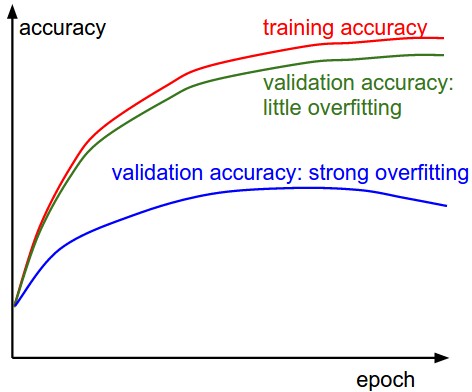
Наш розрив у 1,9 в. п. — це нижня частина шкали: мережа на 203 тисячі параметрів запам'ятала тренувальні цифри майже повністю, але на нових помиляється лише трохи частіше.
Джерело: Stanford CS231n · Neural Networks Part 3
ReLU вимикає нейрони назавжди — рахуємо скільки
Про ReLU у попередніх розділах сказано, що вона «може вимикати нейрони назавжди». Порахуймо, скільки саме — на нашій мережі з 256 нейронів прихованого шару, після навчання, на всій тестовій вибірці.
Вивід код запущено, вивід не редагувався
text
SGD  lr=0.1    точність 0.9763 · мертвих   0/256 · нулів 0.493
SGD  lr=1.0    точність 0.7426 · мертвих 227/256 · нулів 0.995
SGD  lr=3.0    точність 0.1173 · мертвих 252/256 · нулів 1.000
Adam lr=0.001  точність 0.9768 · мертвих   7/256 · нулів 0.574
Adam lr=0.01   точність 0.9612 · мертвих 119/256 · нулів 0.971
На що дивитися: з кроком 1,0 і більше вимикається більшість нейронів і точність обвалюється; Adam зі звичайним кроком 10⁻³ втрачає лише 7 нейронів, а з 10⁻² — уже 119.
При звичному кроці 0,1 мертвих нейронів немає жодного. Але варто збільшити крок до 1,0 — і 227 із 256 нейронів не активуються на жодному з десяти тисяч тестових зображень; точність падає з 0,976 до 0,743. При кроці 3,0 мертвих уже 252, і мережа вгадує навмання.
Найцікавіше — рядки з Adam. При рекомендованому кроці
Чотири поломки, які виглядають однаково на кривій
Читання двох кривих — діагностика для випадку, коли навчання вже працює. Насправді мережа частіше просто не вчиться, і на графіку це щоразу виглядає однаково — горизонтальною лінією. Ось чотири різні причини з числами й першою перевіркою.
| Симптом | Причина | Число з нашої мережі | Перевірити першим |
|---|---|---|---|
| втрата росте, а не спадає | крок завеликий | при η = 30 втрата 5,05, при η = 100 — 43,7 | зменшити крок удесятеро |
| втрата застигає високо, точність 0,74 | мертві нейрони | при η = 1,0 не активуються 227 із 256 | частку нулів на виході ReLU: тут 0,995 замість 0,49 |
| плато з першої ж епохи | сигнал не доходить | при σ = 0,01 std активацій падає з 0,275 до 3,5·10⁻²⁰ на 20-му шарі | надрукувати std активацій по шарах |
| навчальна 1,000, тестова 0,893 | даних замало для місткості | розрив росте з 0,071 до 0,107 і не зменшується | додати дані або регуляризацію, а не шари |
Головне тут — що всі чотири рядки на кривій навчання виглядають схоже, а лікуються протилежним. Тому діагностику починають не з графіка, а з трьох чисел: втрата на перших ста оновленнях, частка нулів на виході ReLU і std активацій по шарах.
Матриця похибок: цифри, які мережа плутає
Одне число точності приховує структуру помилок. Матриця похибок показує її повністю: рядок — справжня цифра, стовпець — прогноз мережі, колір передано в логарифмічній шкалі, щоб рідкісні помилки не зникали на тлі діагоналі.
Із 194 помилок дві найчастіші пари ділять перше місце по дев'ять випадків: четвірка, прочитана як дев'ятка, і сімка, прочитана як двійка. Далі йдуть двійка як вісімка (вісім випадків) і зворотна пара дев'ятка як четвірка (сім). Це не випадковість, а властивість самого письма: коли верхня петля четвірки замикається, від дев'ятки її вже майже не відрізнити.
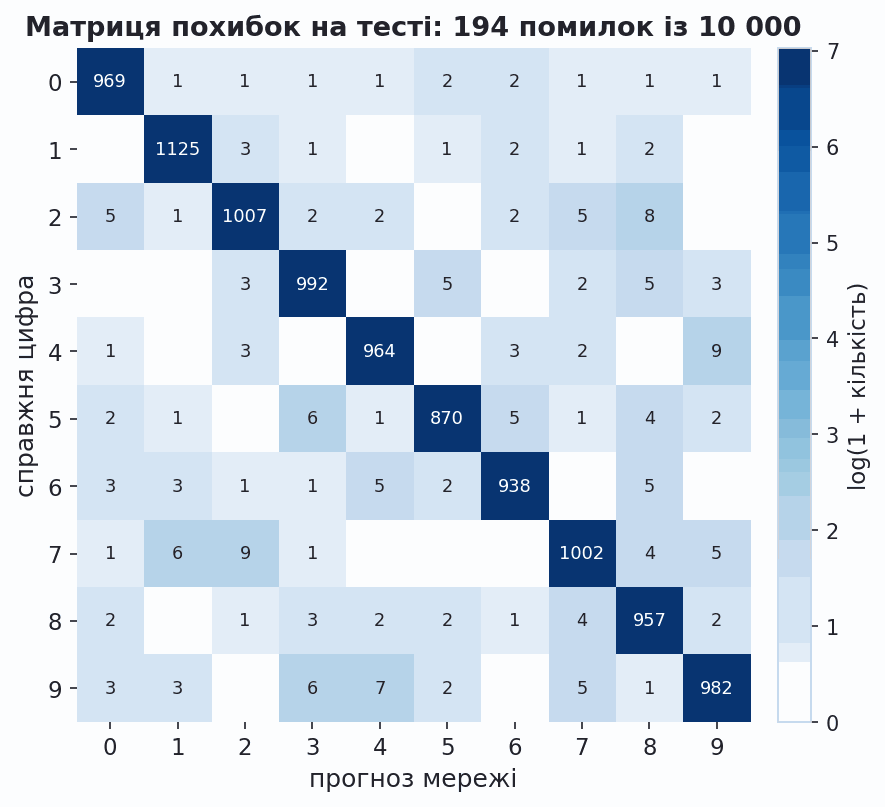
Практичний висновок: якщо ціна помилок різна для різних цифр, дивитись треба сюди, а не на загальну точність.
Помилки, у яких мережа була впевнена
Найкорисніші для розуміння моделі — не просто помилки, а помилки з високою впевненістю. Тут зібрано десять тестових зображень, на яких мережа дала хибний клас із найбільшою ймовірністю.
Частина з них — справді неоднозначні написання, які й людина прочитає по-різному. Але частина цілком розбірлива, і мережа помиляється на них з упевненістю від 0,98 до 1,00. Це прямий наслідок того, що softmax дає ймовірності, які не калібровані: висока ймовірність тут означає «далеко від межі рішення», а не «модель має рацію».
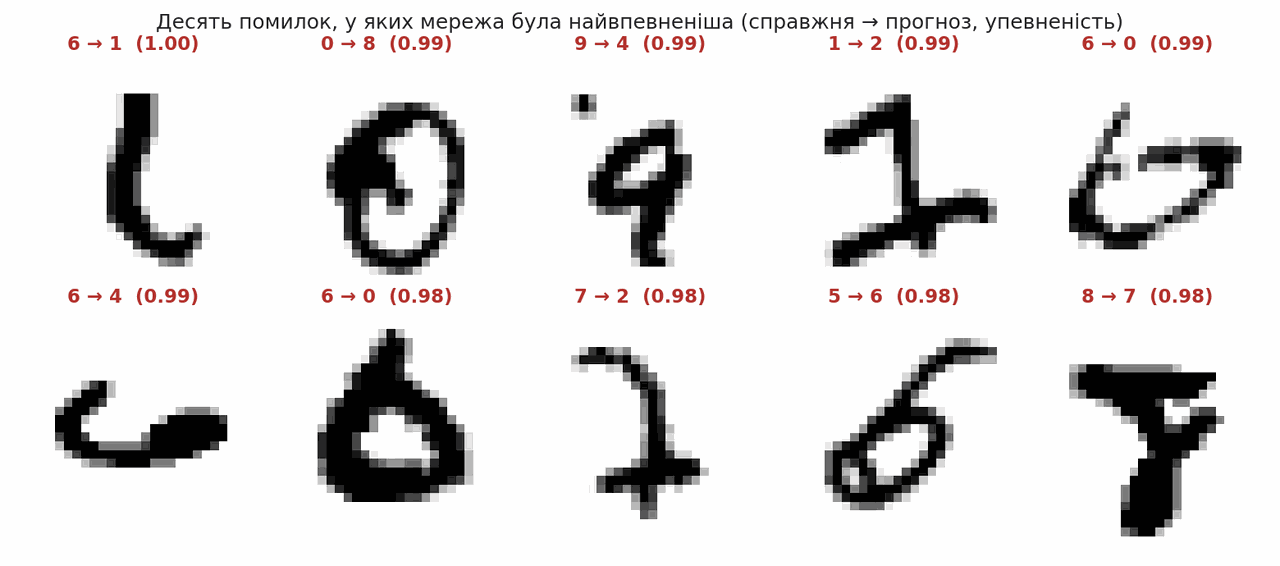
Для практики це важливо. Якщо систему використовують у сценарії з відмовою від відповіді, поріг упевненості треба калібрувати окремо на валідаційній вибірці, а не довіряти сирому виходу softmax.
Навчені шаблони першого шару
Ваги першого шару мають ту саму розмірність, що й вхідне зображення, тому їх можна намалювати як картинки 28×28 і побачити, які ознаки мережа побудувала сама.
Порівняйте з шаблонами логістичної регресії з початку лекції. Там було десять усереднених цифр — по одній на клас. Тут кожен нейрон реагує на локальний фрагмент чорнила: похилий штрих, дугу, замкнену петлю, порожню область. Жоден із них не є «цифрою» — це частини, з яких вихідний шар складає цифри.
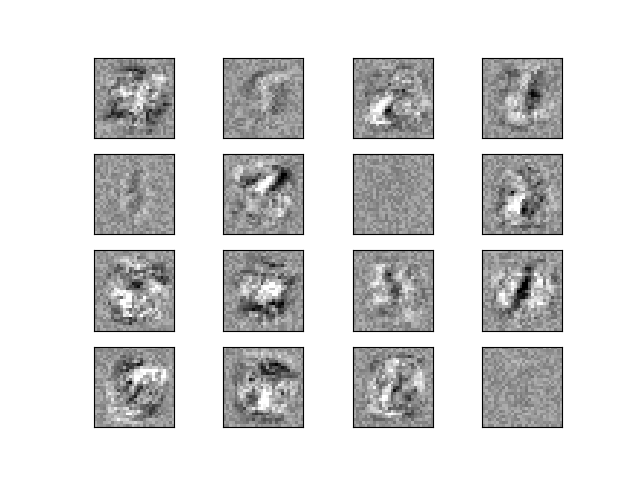
Саме це мали на увазі, коли казали, що мережа — це навчений екстрактор ознак плюс лінійний класифікатор. Помітьте також, що шаблони не завжди інтерпретовні: частина нейронів виглядає як шум, і це нормально.
Джерело: scikit-learn · Visualization of MLP weights on MNIST
Швидкість навчання на реальному прогоні
У лекції 02 вплив кроку навчання ми бачили на схемі. Тепер той самий ефект на живому прогоні: три однакові мережі, три значення
При
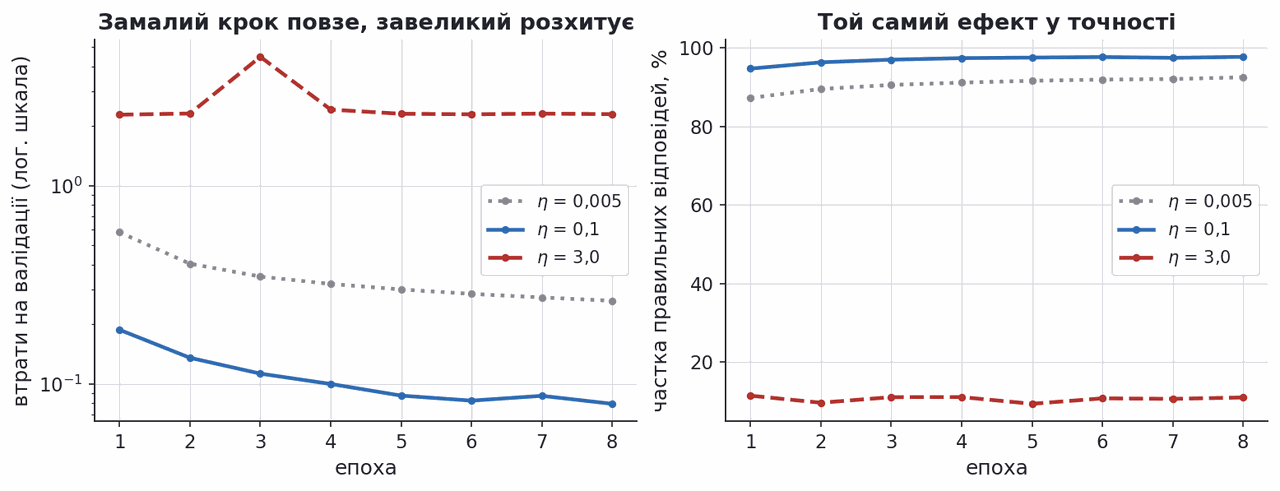
Практичне правило: підбирати
Розмір міні-батчу: точність проти часу
Розмір батчу керує компромісом між якістю оцінки градієнта і кількістю кроків. Три прогони по шість епох із кроком
| Батч | Оновлень за епоху | Точність |
|---|---|---|
| 16 | 3125 | 97,71 % |
| 128 | 391 | 97,62 % |
| 1024 | 49 | 94,26 % |
Великий батч найдешевший за часом і водночас найгірший за результатом: точний градієнт не компенсує того, що кроків стало вдесятеро менше.
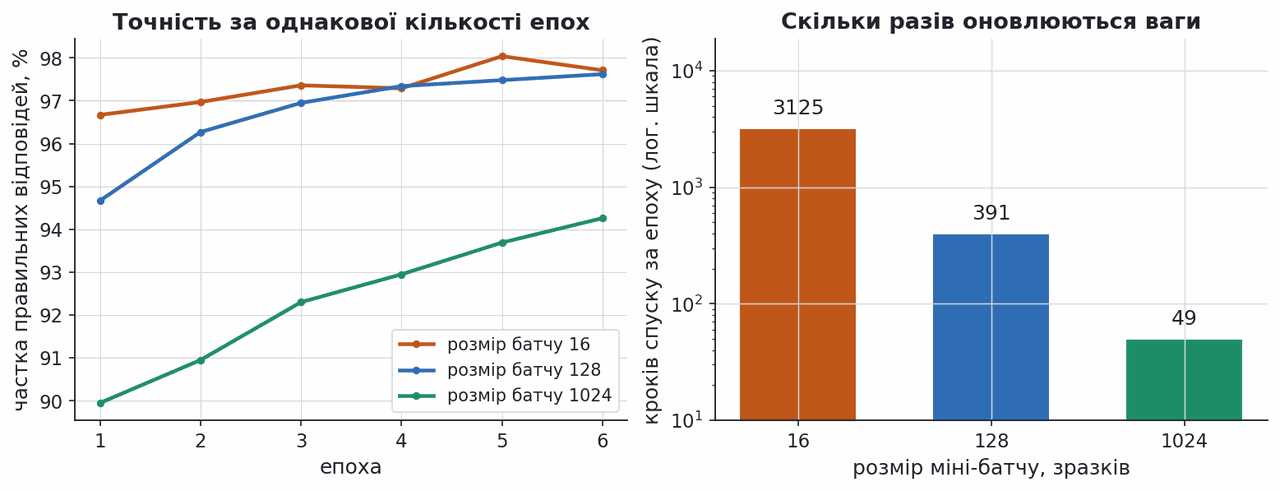
Ці два параметри пов'язані: збільшивши батч, крок навчання зазвичай теж збільшують, інакше модель просто недонавчиться за ту саму кількість епох. Типовий вибір для задач такого масштабу — від 32 до 256.
Момент і Adam прискорюють спуск
Чистий стохастичний спуск робить крок строго проти поточного градієнта і тому зигзагує в «ярах» функції втрат. Момент (momentum) накопичує ковзне середнє градієнтів і рухається за ним, гасячи коливання поперек яру й розганяючись уздовж:
Adam іде далі й підбирає власний масштаб кроку для кожного параметра окремо, спираючись на ковзні середні градієнта та його квадрата.
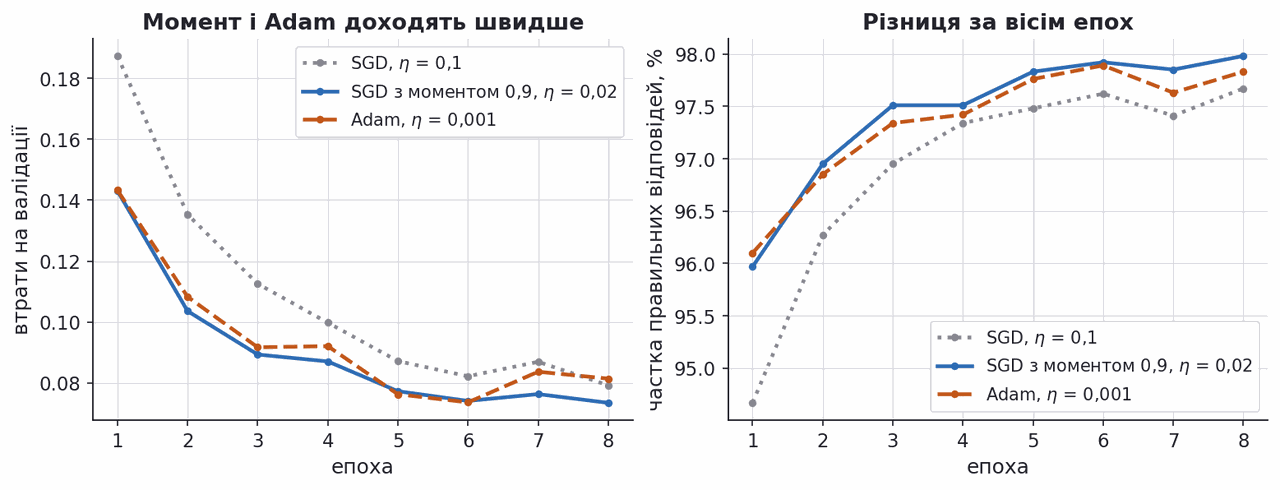
За вісім епох на MNIST: чистий SGD дав 97,67 %, момент — 97,98 %, Adam — 97,83 %, причому обидва прискорені методи перетнули позначку 97 % на епоху раніше за чистий SGD. Зверніть увагу на крок: при
AdamW і розклад кроку: те, що беруть сьогодні
Adam був фінальною точкою десять років тому. Сучасний стандарт — AdamW, у якому спад ваг відокремлено від адаптивного кроку, і розклад кроку, який поступово зменшує
Вивід код запущено, вивід не редагувався
text
SGD  lr 0,1       тест 0.9806 · 97 % на епосі 4
Adam  lr 1e-3     тест 0.9774 · 97 % на епосі 3
AdamW lr 1e-3     тест 0.9759 · 97 % на епосі 3
AdamW + косинус   тест 0.9815 · 97 % на епосі 3
На що дивитися: адаптивні методи на епоху раніше доходять до 97 %, але найкращий тест дає лише AdamW із косинусним розкладом — 0,9815.
Результат вартий уваги, бо він не той, якого чекають. Голий AdamW дає 0,9759 — гірше за звичайний SGD із його 0,9806. Adam теж програє: 0,9774. І лише AdamW разом із косинусним розкладом кроку виходить наперед: 0,9815.
Мораль подвійна. Адаптивні методи справді швидші на старті — усі три перетинають 97 % на третій епосі проти четвертої в SGD. Але швидкість на старті не те саме, що якість наприкінці, і саме розклад кроку перетворює AdamW із «гірше за SGD» на «краще за SGD». Тому в сучасних рецептах вони йдуть парою, і згадувати AdamW без розкладу — те саме, що назвати половину рецепта.
Регуляризація згладжує межу рішення
Мережа на 203 тисячі параметрів проти 50 тисяч зображень — модель свідомо надлишкова, і без стримування вона запам'ятовує шум. Найпростіший інструмент той самий, що в лекції 03: штраф weight_decay оптимізатора.
На рисунку одна й та сама архітектура з трьома значеннями
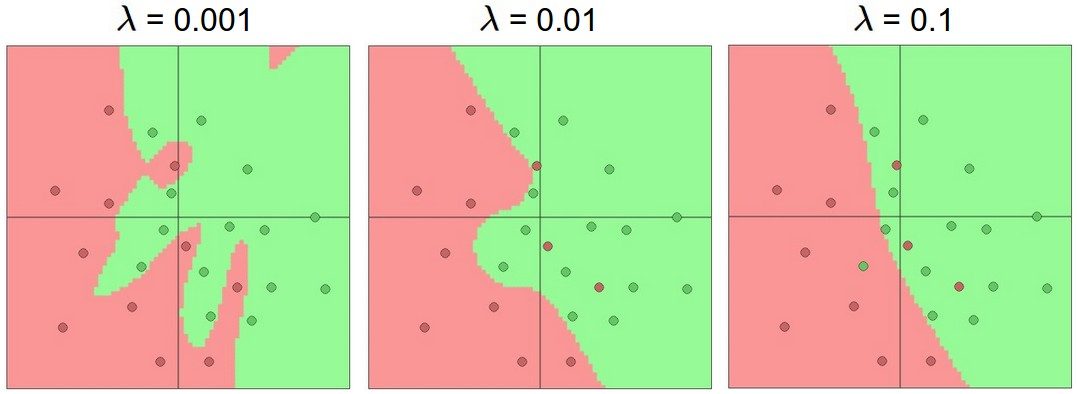
Для мереж є ще два дієві прийоми, яких немає в лінійних моделях: рання зупинка на найкращій епосі та dropout — випадкове вимикання частини нейронів під час навчання. Dropout і шари нормалізації докладно розберемо в лекції 11.
Джерело: Stanford CS231n · Neural Networks Part 1
Обмеження нейронних мереж
Мережа дала 98,06 % там, де лінійна модель дала 92,24 %. За це доведеться платити, і рахунок варто знати наперед.
Оптимізація без гарантій. Задача невипукла, результат залежить від ініціалізації, кроку навчання й порядку батчів. Два запуски того самого коду з різними зернами дадуть різні моделі.
Гіперпараметрів багато. Ширина, глибина, активація, крок, розмір батчу, оптимізатор, регуляризація — і всі вони взаємопов'язані. Час на підбір часто перевищує час на саме навчання.
Дані й обчислення. Наша мережа має вчетверо більше параметрів, ніж тренувальних зображень; на менших вибірках вона програє градієнтному бустингу з лекції 06.
Інтерпретованість утрачено. Коефіцієнт логістичної регресії читається як внесок ознаки. Ваги прихованого шару здебільшого не інтерпретовні, а ймовірності на виході softmax не калібровані.
Просторова структура ігнорується. Розгортаючи 28×28 у вектор із 784 чисел, ми викидаємо інформацію про сусідство пікселів. Зсув цифри на кілька пікселів — уже інший вхід. Це виправляють згорткові мережі з лекції 11.
Підсумок лекції
Нелінійність — єдине, що відрізняє мережу від лінійної моделі. Без неї стек шарів згортається в одну матрицю; з нею останній шар лишається лінійним класифікатором, але працює у просторі ознак, який мережа побудувала сама.
Виражальна сила доведена, але обмежена в формулюванні. Теорема Барона гарантує похибку
Зворотне поширення — ланцюгове правило з перевикористанням. Сигнал похибки
Навчання визначається дрібницями. Масштаб початкових ваг, крок, розмір батчу й вибір оптимізатора змінюють результат від 11 % до 98 % на тих самих даних.
Мережа 784–256–10 дала на MNIST 98,06 % проти 92,24 % у лінійної моделі — 194 помилки замість 776.
Джерела й додаткові матеріали
Курси
- EPFL CS-433 — лекції 07b і 08a
- UBC CPSC 340 — лекції 29–30
- Stanford CS231n
Підручники
- Goodfellow, Bengio, Courville. Deep Learning, розділ 6
- Dive into Deep Learning, розділ 5
Статті
- Barron A. R. Universal approximation bounds for superpositions of a sigmoidal function. IEEE Trans. Inf. Theory 39(3), 1993
- He K. et al. Delving Deep into Rectifiers. CVPR, 2015
Документація й дані